
一、从"看懂画面"到"驱动业务"的质变飞跃
当人工智能的浪潮从实验室的Demo玩具蜕变为生产引擎,视觉语言模型的角色早已不再是简单的"看图说话"。企业需要的,是能读懂扫描合同、解析报表图表、感知UI界面、分析长视频内容、甚至驱动代码生成的全能型智能体。正是在这一产业变革的浪尖上,通义千问Qwen3系列旗舰视觉‑语言基座模型——Qwen3‑VL‑Plus横空出世,以碾压级的综合能力重新定义了多模态AI的天花板。
想深入了解Qwen3‑VL‑Plus的全部技术细节与实时动态,欢迎访问阿里云百炼大模型服务平台页面,一手资料尽在掌握。
二、模型定位:旗舰视觉基座,全能多模态核心
Qwen3‑VL‑Plus是通义千问Qwen3家族中当之无愧的"视觉王牌"。它原生支持文本、图片、视频三大输入模态,输出为精准文本内容,采用思考模式与非思考模式混合融合设计——无需切换模型,即可兼顾复杂多步推理与简单场景快速响应,宛如一位既能深度思辨又能闪电作答的全能智者。
其上下文窗口高达262,144 token(256K),可同时承载海量图文混合内容:大段文本资料、多张扫描文档截图、报表图片、长视频解析帧序列与字幕文本,一气呵成,跨图片、跨页面关联对比分析,信息召回稳定性显著优于传统视觉模型。
更多模型规格与实时参数对比,请登录阿里云百炼大模型服务平台页面查阅。
三、核心能力:六大维度,全面碾压
1. 文档扫描件识别与OCR精准提取
Qwen3‑VL‑Plus原生具备强悍的中文OCR能力,面对倾斜、轻微模糊、带水印的扫描文档,依旧可以稳定提取文字与版式结构。传统OCR工具需要大量后处理的工作,在这里一笔勾销。无论是法务合同、财务报表还是档案卷宗,一张图片送入,条款、数据、风险要点统统归位。
2. 图表数据提取与报表解析
从照片格式报表到截图图表,模型能精准提取表格数值、梳理数据逻辑、完成归纳整理。面向财务分析场景,批量读取多页报表截图,综合研判一气呵成。
3. UI界面感知与交互逻辑梳理
在OSWorld视觉智能体权威测试集取得行业顶尖水准——仅凭一张截图,模型就能理解桌面界面元素,规划点击、输入等操作指令,展现出真实环境交互的硬核实力。面向产品开发,批量读取UI原型截图即可输出产品需求文档。
4. 超长视频内容分析
原生支持超长视频解析,在LVBench长视频理解基准中,面对长时间视频素材可精准定位关键时间节点、提取核心事件信息,长时序多模态信息处理能力令人生畏。教学视频、会议录屏、影视素材,皆可深度剖析。
5. 视觉驱动代码生成
从UI截图到前端代码,从图表到可视化方案,Qwen3‑VL‑Plus打通了"视觉输入→代码输出"的完整链路,结合Function Calling函数调用,实现从理解到执行的闭环。
6. 企业级全套能力兼容
结构化输出、上下文缓存、批量推理、Function Calling——全套企业级能力原生支持,既可直接交互体验,也能通过标准化API集成到业务系统。
欲了解各能力的深度技术拆解,请访问阿里云百炼大模型服务平台页面。
四、技术底座:三重优化,铸就性能壁垒
Qwen3‑VL‑Plus在底层技术上针对视觉编码、跨模态对齐、长序列处理做了系统性优化:
| 技术维度 | 核心突破 |
|---|---|
| 视觉编码 | 强化空间感知与细节保留,跨图信息召回稳定性大幅提升 |
| 跨模态对齐 | 文本-图像-视频统一表征空间,图文融合理解更精准 |
| 长序列处理 | 256K token上下文窗口+优化编码器,告别"读到后面忘前面" |
在公开评测中,DocVQA文档问答高分、中文混合语种OCR表现突出、MMBench通用视觉评测与MathVision视觉数学评测均成绩斐然。传统视觉模型在大量图片、长视频帧输入后容易细节遗忘、表格错乱、逻辑断裂,Qwen3‑VL‑Plus依托优化后的跨模态编码器与序列处理机制,将这些痛点逐一击破。
更多底层技术文档与架构白皮书,均可在阿里云百炼大模型服务平台页面查阅下载。
五、应用场景:从法务到媒体,全面覆盖
| 行业场景 | 具体应用 | 核心价值 |
|---|---|---|
| 法务与档案 | 读取扫描PDF、拍照合同,条款提取、风险梳理、多版本比对 | 省去人工逐页审阅,效率倍增 |
| 财务分析 | 解析照片报表、截图图表,数据提取归纳 | 数据驱动决策,精准无误 |
| 产品开发 | 批量UI原型截图→交互逻辑梳理→需求文档 | 缩短产品迭代周期 |
| 媒体业务 | 解析教学视频、会议录屏+字幕→纪要、知识点梳理 | 内容资产化,知识沉淀 |
所有这些场景的落地实践与行业解决方案,都能在阿里云百炼大模型服务平台页面找到详尽指引。
六、上下文缓存:智能体工作流的"省引擎"
为降低多轮多模态对话与视觉智能体工作流的推理开销,Qwen3‑VL‑Plus原生支持上下文缓存机制。系统提示词、固定业务规则、公共参考素材等静态前缀内容,开启缓存后只执行一次预填充运算,后续多轮对话直接复用,不再重复计算图像与文本特征。有效减少token消耗、降低接口响应延迟,尤其适合长时间不间断运行的视觉自动化工作流。
七、API实战:三分钟跑通你的第一个调用
以下是基于OpenAI兼容接口的Python调用示例,即刻上手:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

resp = client.chat.completions.create(
model="qwen3-vl-plus",
messages=[
{
   "role": "system", "content": "你是专业多模态文档分析助手,严格基于图片与文本输入输出结论,禁止编造不存在信息。"},
{
   "role": "user", "content": [
{
   "type": "text", "text": "识别这份扫描文档,提取表格数据,梳理文档当中的风险要点。"},
{
   "type": "image_url", "image_url": {
   "url": "https://example.com/document_scan.png"}}
]}
],
max_tokens=8192,
temperature=0.3,
top_p=0.8,
stream=False,
extra_body={
   "enable_context_cache": True}
)
print(resp.choices[0].message.content)
配套curl命令行,方便快速调试:
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model":"qwen3-vl-plus",
"messages":[{"role":"user","content":[
{"type":"text","text":"解析图片文档,提取表格数据"},
{"type":"image_url","image_url":{"url":"https://example.com/document_scan.png"}}
]}],
"max_tokens":8192,
"temperature":0.3,
"extra_body":{"enable_context_cache":true}
}'
完整的API文档与更多代码示例,请移步阿里云百炼大模型服务平台页面。
八、如何开通使用:新用户福利满满
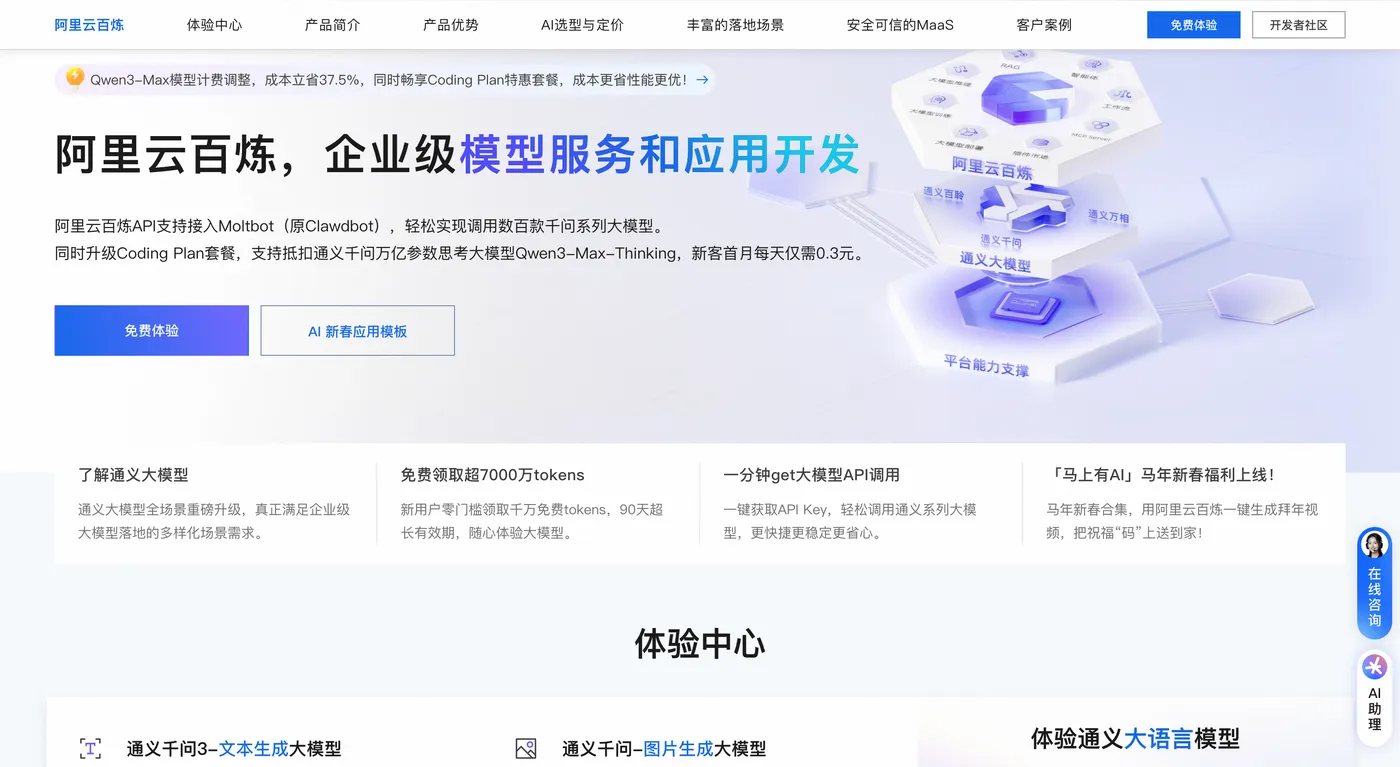
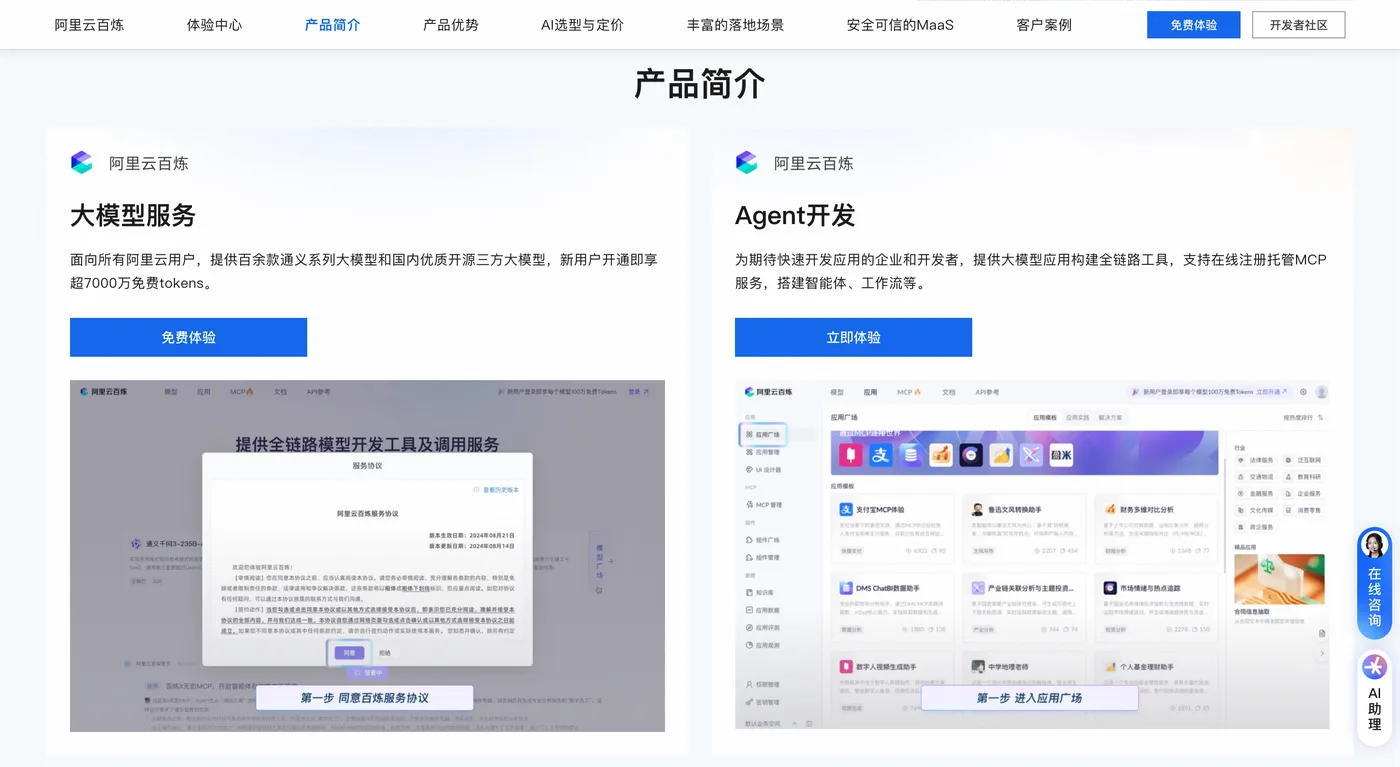
阿里云百炼是可视化平台,DashScope是底层API服务,百炼调用的正是DashScope的模型能力。现在登录阿里云百炼大模型服务平台页面,即可一键开通:
- ✅ 新用户专享:开通即送超7000万Tokens(约等于100万次Qwen‑Turbo调用),有效期90天
- ✅ 额外赠送:100张图像生成 + 50秒视频生成额度
- ✅ 灵活计费:按量付费、Token Plan订阅、Coding Plan、资源包多种方案可选
- ✅ 三步上手:官网登录 → 选择模型体验/API调用/Agent构建 → 获取免费额度即可开干
九、结语
Qwen3‑VL‑Plus不是一个简单的"看图模型",而是一座从视觉感知到业务理解再到可执行输出的完整桥梁。它以256K超长上下文为翼、以MoE混合专家架构为骨、以原生全模态融合为魂,为文档数字化、视觉智能体自动化、前端开发辅助、媒体内容分析、图纸报表解析等海量专业场景提供了一把锋利的钥匙。
现在就登录阿里云百炼大模型服务平台页面,领取你的免费额度,开启AI赋能之旅!


