
摘要:Kafka 是 Structured Streaming 事实上的第一搭档,但"能用"和"用好"之间隔着一整条读写路径。本文把集成实现拆到字段级:依赖接入与流批两套入口;订阅三式与读出的七列固定结构;位点语义的三个易错点(流批默认不同、恢复不看 startingOffsets、时间戳定位的优先级);读侧四个调优旋钮与 failOnDataLoss 的误报场景;写侧的 key 路由三规则与 at-least-once 应对;安全与多集群的 delegation token 机制;最后是三个高频生产问题的定位路径。读完你能回答:为什么改了 startingOffsets 没生效、重复消费该在哪端去重、迁移集群要动几个配置。
关键词:Structured Streaming, Spark, Kafka 集成, startingOffsets, consumer group, delegation token, 数据倾斜, 分区路由, 重复消费
一、接入第一步:依赖与两套入口
<dependency>
  <groupId>org.apache.spark</groupId>
  <artifactId>spark-sql-kafka-0-10_2.12</artifactId>
  <version>3.5.9</version>
</dependency>
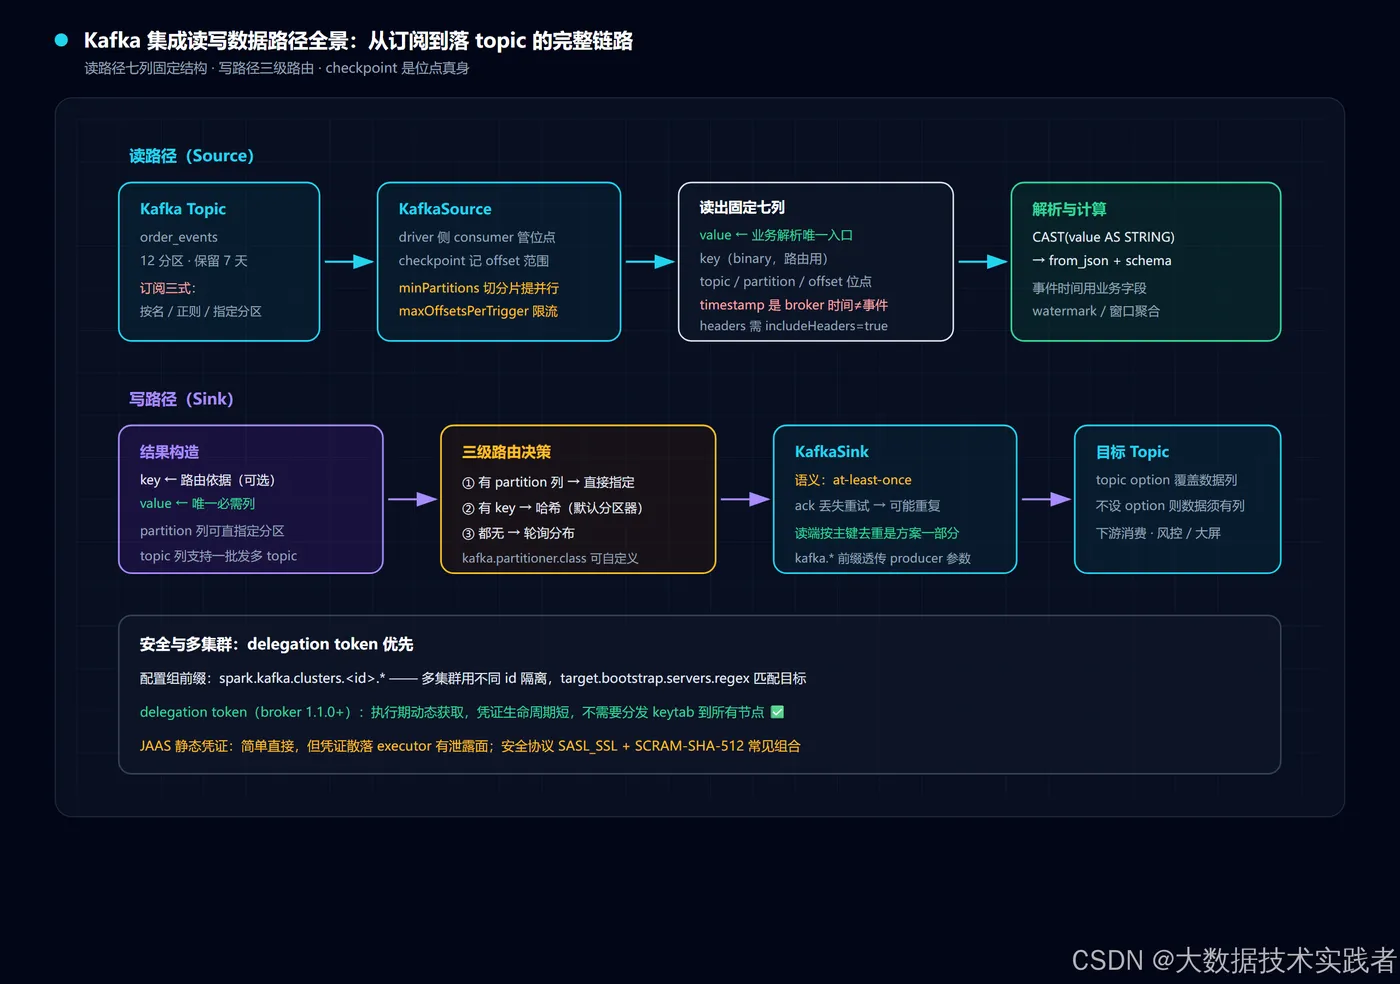
依赖引入后即有两套入口:流式读 spark.readStream.format("kafka")(无界、持续消费)与批式读 spark.read.format("kafka")(有界、指定范围处理完即停)。两套入口共享同一批 option,但默认行为不同(下一节展开)——批式入口是补数、对账、回刷历史的利器,别只会用流式那一半。
二、订阅与数据结构:先弄清读出来的是什么
2.1 订阅三式
.option("subscribe", "topic1,topic2")        // ① 按名订阅多个
.option("subscribePattern", "order_.*")      // ② 正则匹配(新 topic 自动纳入)
.option("assign", """{"topic1":[0,1,2]}""")  // ③ 精确到分区
三选一:常规多 topic 用 ①;动态扩容的埋点流用 ②(新增 topic 不用改代码);只想消费个别分区(比如按分区做了业务隔离)用 ③。
2.2 读出的固定七列
| 列 | 类型 | 说明 |
|---|---|---|
| key | binary | 消息键,常用于路由 |
| value | binary | 消息体,业务解析的唯一入口 |
| topic / partition / offset | string/int/long | 位点三元组 |
| timestamp | timestamp | 消息时间戳(broker 侧) |
| headers | array | 需 includeHeaders=true(默认 false) |
第一行代码永远是 CAST(value AS STRING) 再 from_json。注意 timestamp 是 broker 写入时间,不是业务事件时间——事件时间口径要用自己的字段。
三、位点语义:三个最容易踩的坑
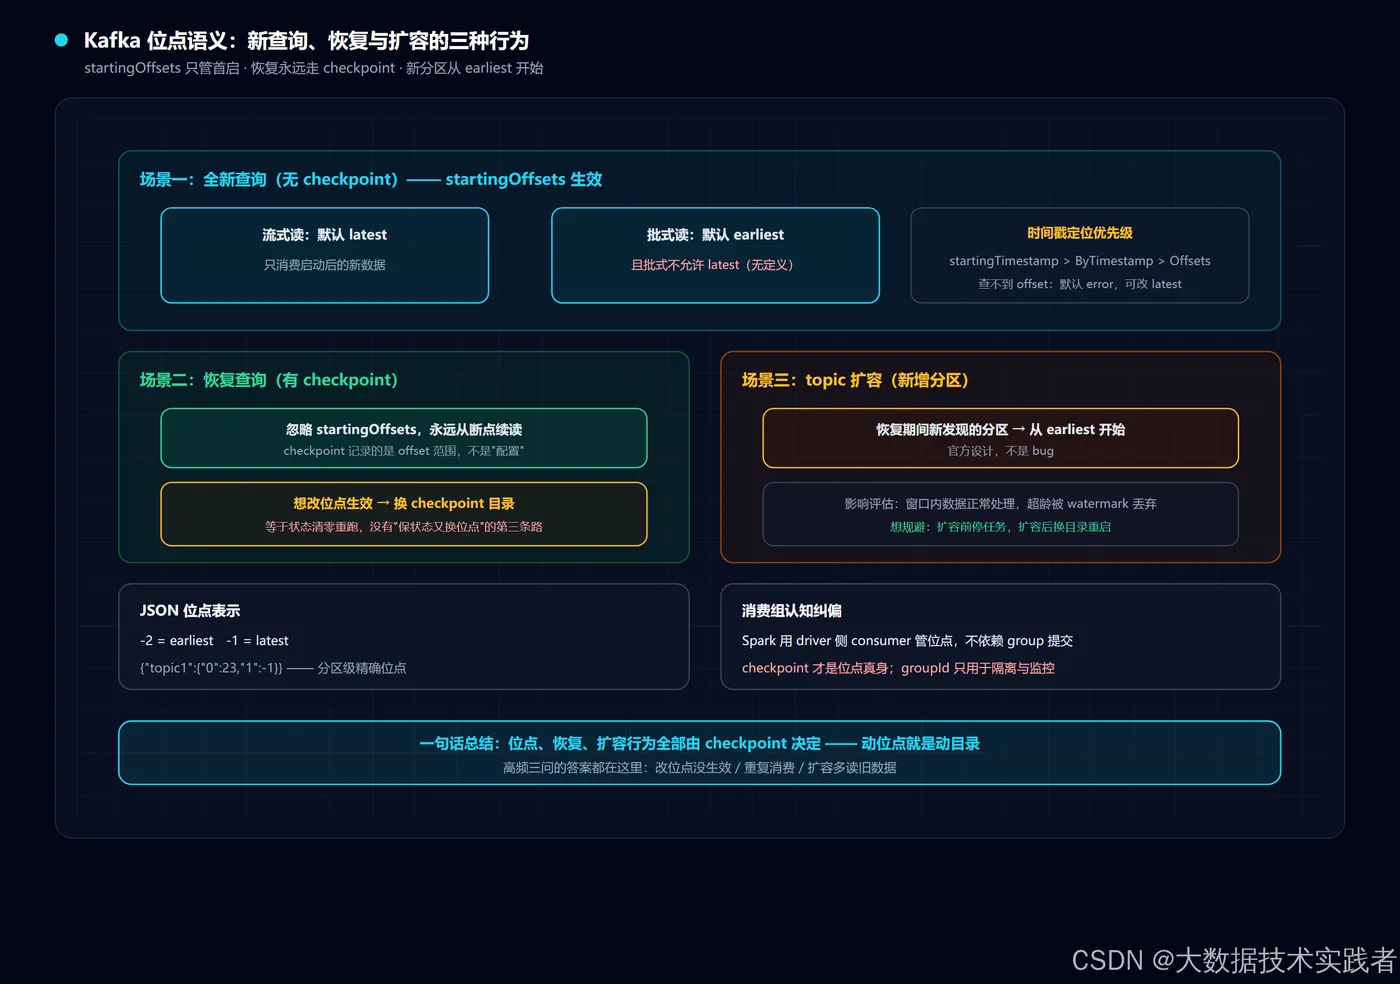
坑一:流批默认不同。 流式 startingOffsets 默认 latest(只消费启动后的新数据),批式默认 earliest(全量)。且批式不允许 latest——"读最新一批然后停"在批语义下无定义。
坑二:恢复不看 startingOffsets。 从 checkpoint 恢复时永远从断点续读,startingOffsets 只在新查询首次启动时生效。重启后想换位点?唯一的正解是换 checkpoint 目录(等于丢状态重跑)。恢复期间新发现的分区从 earliest 开始——这个细节在 topic 扩容时会突然"多消费一批旧数据",别当成 bug。
坑三:时间戳定位有优先级。 startingTimestamp > startingOffsetsByTimestamp > startingOffsets,同时设置时按此序生效。时间戳定位要求 Kafka 0.10.1.0+,且 broker 查不到匹配 offset 时的行为由 startingOffsetsByTimestampStrategy 决定(默认 error,可改 latest)。JSON 位点表示里 -2 是 earliest、-1 是 latest。
四、读侧调优:四个旋钮与一个开关
.option("minPartitions", "12")             // ① 并行度
.option("maxOffsetsPerTrigger", "80000")   // ② 限流
.option("minOffsetsPerTrigger", "10000")   // ③ 保活下限
.option("maxTriggerDelay", "15m")          // ④ ③的等待上限
.option("failOnDataLoss", "true")          // ⑤ 默认 true
① 默认 topicPartition:Spark 分区 = 1:1;设大于 topic 分区数会把大分区切小片提高并行度,但它是提示值——实际任务数"约等于"设定。② 限流量按各分区积压量比例分配(不是平均分),防首批打爆。③④ 成对使用:数据不足下限时最多等 15 分钟再触发,避免小流量场景批空转。⑤ 默认 true:offset 越界(topic 被删、保留期清理)直接失败。注意可能是误报——确认丢失区间可离线补齐后再设 false。
消费组管理要点:Spark 用 driver 侧的 consumer 管理位点(不依赖 consumer group 提交),checkpoint 才是位点的真身;groupId 主要用于隔离与监控展示,别指望改它来"重置位点"。
五、写侧:路由三规则与 at-least-once
result.selectExpr(
  "CAST(province AS STRING) AS key",      // ① key 决定分区
  "to_json(struct(*)) AS value"
).writeStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092")
  .option("topic", "gmv_result")          // ② topic 可选
  .start()
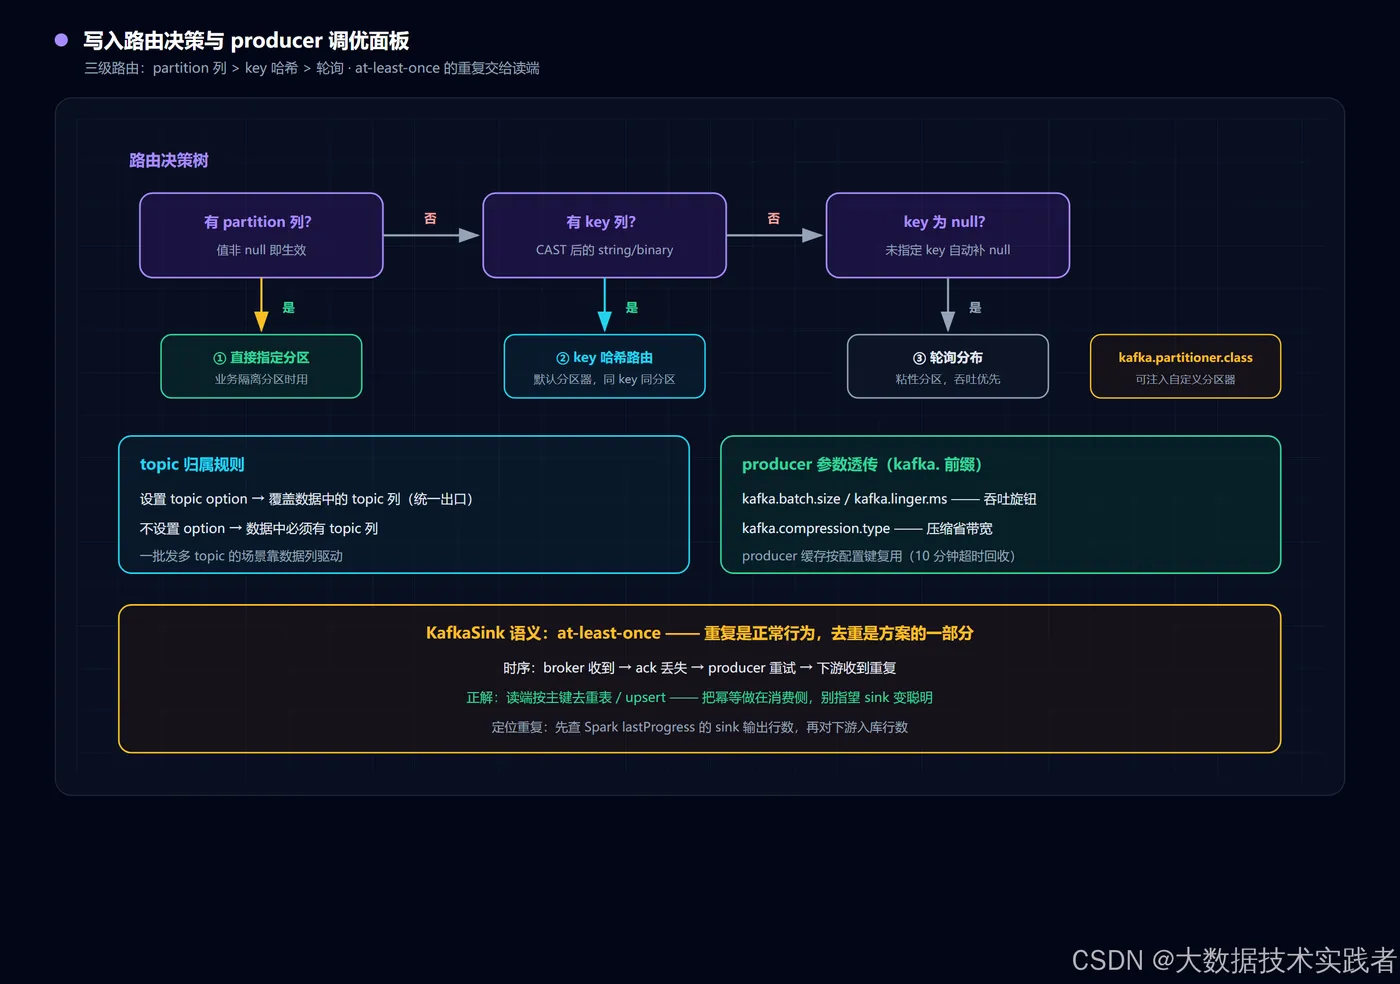
路由三规则:有 partition 列就直接指定分区;没有则按 key 哈希(producer 默认分区器,可用 kafka.partitioner.class 自定义);key 也为 null 时轮询。② topic option 会覆盖数据中的 topic 列;不设置则数据里必须有 topic 列(一批发多 topic 的场景)。
producer 参数透传用 kafka. 前缀(如 kafka.batch.size)。语义上 Kafka sink 是 at-least-once:broker 收到但 ack 丢失会重试产生重复。正确姿势是读端按主键去重,把去重当作方案的一部分而不是补丁。
六、安全与多集群
# 集群标识 + 参数前缀:spark.kafka.clusters.<id>.*
spark.kafka.clusters.prod.auth.bootstrap.servers=kafka-prod:9092
spark.kafka.clusters.prod.security.protocol=SASL_SSL
spark.kafka.clusters.prod.sasl.token.mechanism=SCRAM-SHA-512
spark.security.credentials.kafka.enabled=true
认证有两条路:JAAS 配置直连(静态凭证)与 delegation token(broker 1.1.0+,执行期动态获取,避免凭证散落在 executor 上)。多集群场景用 <id> 区分配置组,target 匹配用 target.bootstrap.servers.regex。生产建议优先 delegation token——凭证生命周期短、不需要分发 keytab 到所有节点。
七、三个高频生产问题
Q1:改了 startingOffsets 为什么没生效? 因为这是恢复查询,恢复永远走 checkpoint。想让新位点生效 → 换 checkpoint 目录 → 接受状态清零重跑。没有"保状态又换位点"的第三条路。
Q2:下游收到重复数据谁的问题? 大概率是 sink 侧重放(ack 丢失重试),这是 at-least-once 的正常行为。定位顺序:先查 Spark 侧 lastProgress 的 sink 输出行数,再查下游入库行数——两边都多才是重放,只有下游多要查自己的消费逻辑。修复在读端:按主键去重表或 upsert。
Q3:topic 扩容后突然多消费一批旧数据? 恢复期间新发现的分区从 earliest 开始(官方设计)。影响评估:新分区里的旧数据若在窗口/watermark 覆盖内会被正常处理,超龄数据被 watermark 丢弃。想完全规避:扩容前先停任务、扩容后换目录重启,或者接受这一批并核对结果。
八、总结
- 两套入口记两件事:流批
startingOffsets默认不同(latest vs earliest),批式不允许 latest; - 订阅三式各归其位:按名/正则/指定分区,动态扩容选正则;
- 读出七列只有 value 是业务入口,timestamp 是 broker 时间不是事件时间;
- 位点三坑:恢复不看 startingOffsets、新分区从 earliest 开始、时间戳定位有优先级(timestamp > byTimestamp > offsets);
- 调优四旋钮:minPartitions 提并行(提示值)、maxOffsetsPerTrigger 比例限流、minOffsets+maxTriggerDelay 防空转、failOnDataLoss 误报先确认再关;
- 写侧路由三规则(partition 列 > key 哈希 > 轮询),topic option 覆盖数据列;at-least-once 的重复交给读端主键去重;
- 安全优先 delegation token,多集群用
spark.kafka.clusters.<id>.*配置组隔离; - 三个高频问题的共同答案:checkpoint 是位点的真身——位点、恢复、扩容行为全部由它决定,动位点就是动目录。


