
摘要:同样是流处理,风控、CDC 入湖、IoT 监控给出的答案截然不同。本文横向分析三个真实形态的案例:实时风控要的是流-流 Join——两条流各自带 watermark、间隔时间做 Join 条件、状态上限约等于两个 watermark 之和;CDC 入湖的死穴是乱序与重复——binlog 的 op 类型决定 upsert 语义,而 Exactly-Once 要靠 merge 键而非引擎承诺;IoT 会话监控的钥匙是 session window——会话由事件之间的 gap 动态划分,没有固定窗口边界,配 watermark 实现自动关闭。三个案例覆盖了状态管理、幂等写入、动态窗口三大核心命题,每个都有"为什么这么选"的推导过程。
关键词:Structured Streaming, Spark, 流流 Join, CDC, binlog, session window, 会话窗口, Watermark, 实时风控, IoT 监控
一、为什么是这三个案例
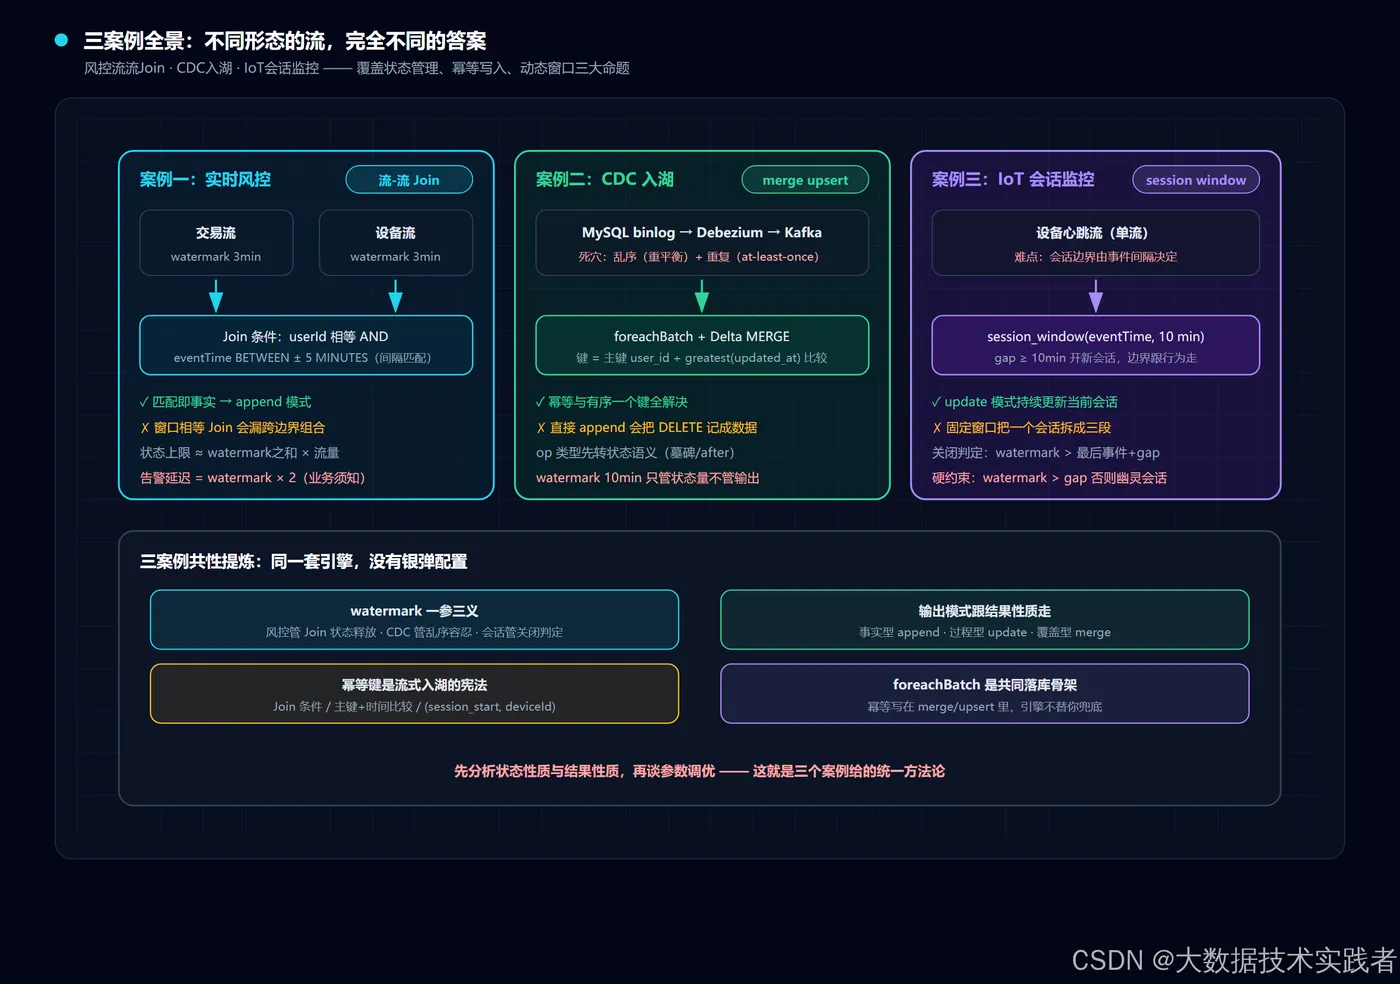
挑案例的标准是形态差异最大化:同一套引擎,三类问题,答案几乎不重叠。
| 维度 | 案例一 实时风控 | 案例二 CDC 入湖 | 案例三 IoT 会话监控 |
|---|---|---|---|
| 数据特征 | 两条独立事件流 | 单条 binlog 流 | 单条设备上报流 |
| 核心操作 | 流-流 Join | merge upsert | session window 聚合 |
| 状态性质 | 有界(watermark 控制) | 无状态转换 | 动态边界(gap 划分) |
| 最大难点 | 双流时间对齐 | 乱序 + 重复消费 | 会话不关闭 |
| 输出语义 | append(匹配即出) | merge(幂等覆盖) | update(会话中持续更新) |
二、案例一:实时风控——流-流 Join 的时间对齐
2.1 问题形态
交易流(转账、支付)与设备流(登录、设备指纹)是两条独立的 Kafka 流。风控规则要求:一笔交易发生前后 5 分钟内的设备事件构成“交易上下文”,用于判断是否异地登录 + 大额转账的组合风险。
2.2 核心写法
val txns = spark.readStream.format("kafka")
  .option("subscribe", "transactions").load()
  .select(/* 解析 */).withWatermark("eventTime", "3 minutes")

val devices = spark.readStream.format("kafka")
  .option("subscribe", "device_events").load()
  .select(/* 解析 */).withWatermark("eventTime", "3 minutes")

val risk = txns.join(devices,
  expr("""
    devices.userId = txns.userId AND
    devices.eventTime BETWEEN
      txns.eventTime - INTERVAL 5 MINUTES AND
      txns.eventTime + INTERVAL 5 MINUTES
  """))
2.3 关键决策分析
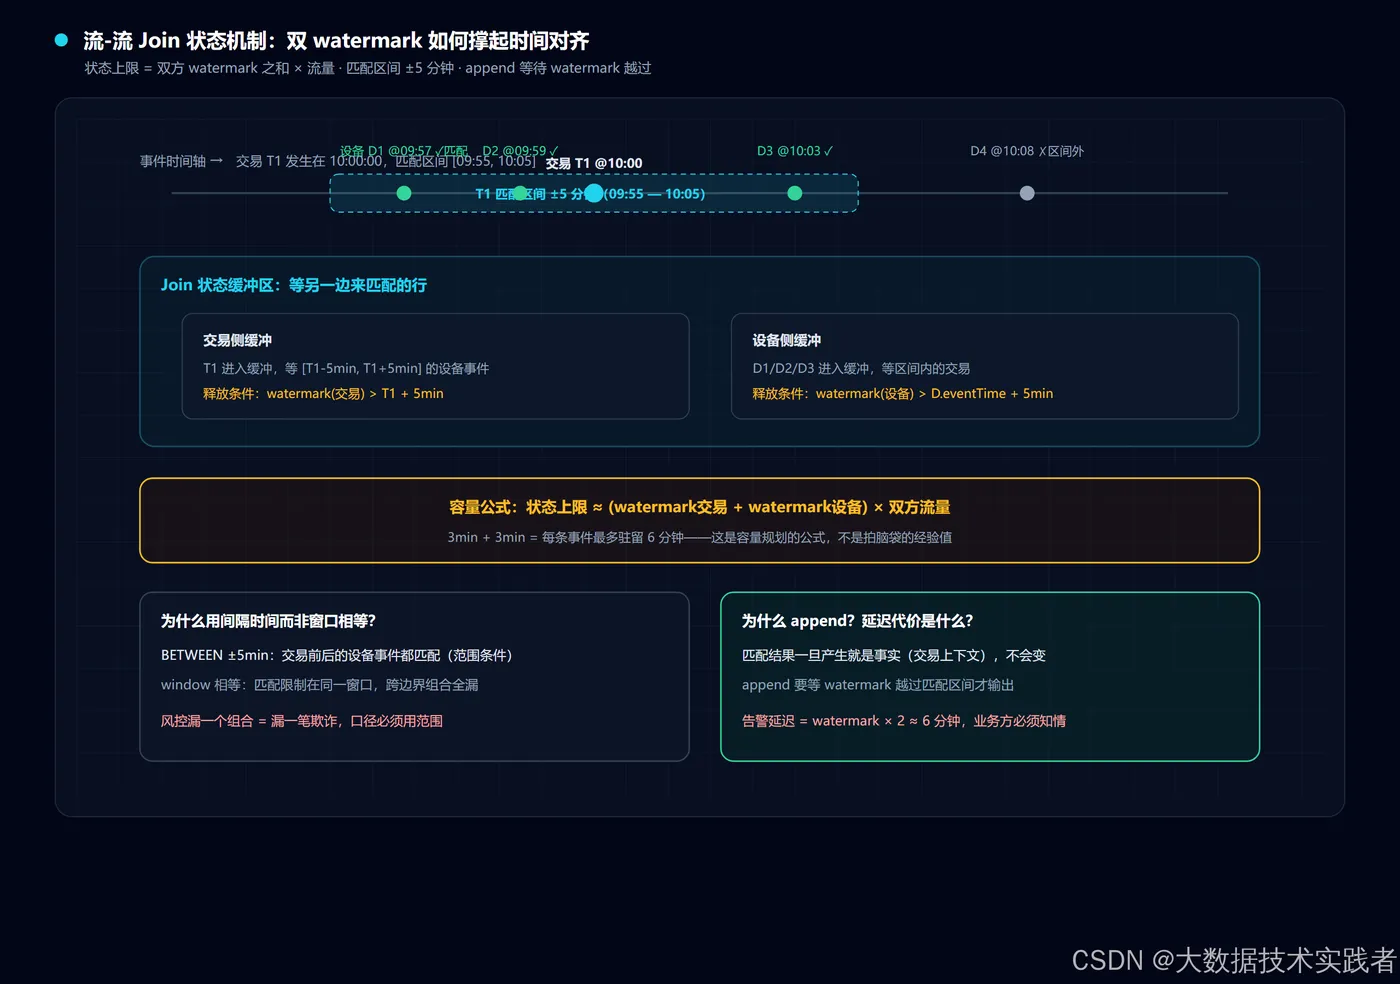
为什么两条流都要 watermark? 流-流 Join 的状态是“等另一边匹配”的缓冲行。没有 watermark,缓冲无限膨胀;有了 watermark,引擎才能判定“这条交易 5 分钟内不会再有设备事件来了”并释放状态。状态上限 ≈ 两流 watermark 之和 × 流量——这是容量规划的公式,不是经验值。
为什么用间隔时间而不是窗口相等? eventTime BETWEEN ... AND ... 是范围条件 Join,交易前后的设备事件都能匹配上;如果用 window(txns.eventTime) = window(devices.eventTime) 会把匹配限制在同一个窗口内,跨窗口边界的组合全部漏掉。风控场景漏一个组合 = 漏一笔欺诈。
输出模式为什么是 append? 匹配结果一旦产生就是事实(交易上下文),不会因为后续数据改变——append 语义天然匹配。代价是结果要等 watermark 越过匹配区间才落地,风控告警延迟 = watermark × 2。这个延迟业务方必须知情,否则“实时风控”的预期就会落空。
三、案例二:CDC 入湖——乱序与重复的幂等解法
3.1 问题形态
MySQL binlog 经 Debezium 进 Kafka,要求在湖里维护一张与源表最终一致的镜像表。两个死穴:乱序(同一主键的多条变更可能因分区重平衡乱序到达)与重复(Kafka at-least-once + 任务重启重放)。
3.2 核心写法
binlogStream
  .withWatermark("eventTime", "10 minutes")     // ① 迟到边界
  .writeStream
  .foreachBatch { (batchDF, batchId) =>
    DeltaTable.forPath(spark, "s3a://lake/user_mirror")
      .as("t")
      .merge(batchDF.as("s"), "t.user_id = s.user_id")   // ② 幂等键
      .whenMatchedUpdate(
        Map("balance" -> coalesce(col("s.balance"), col("t.balance")),
            "updated_at" -> greatest(col("s.updated_at"), col("t.updated_at"))))
      .whenNotMatchedInsertAll()
      .execute()
  }
  .option("checkpointLocation", "hdfs://nn:8020/chk/cdc")
  .start()
3.3 关键决策分析
为什么 merge 键是 user_id 而不是 binlog offset? offset 只能去重“同一批重放”,挡不住“乱序后的旧值覆盖新值”。merge 键用主键 + greatest(updated_at) 比较:乱序到达的旧变更在 whenMatchedUpdate 时被比较逻辑拒绝,幂等性和有序性一个键全解决。这是 CDC 入湖最重要的一条设计。
为什么 op 类型不直接落表? binlog 里的 INSERT/UPDATE/DELETE 三类事件,直接 append 会把 DELETE 也记成一行数据。正确做法是在 merge 前把事件转成状态语义:DELETE 转成 whenMatchedDelete 或墓碑标记,UPDATE 拆 before/after 取 after。转换逻辑放在 foreachBatch 内做批处理,比在流上做 flatMap 更好测试。
为什么 watermark 设 10 分钟这么大? CDC 的乱序主要来自分区重平衡与 Debezium 快照,实测 p99 乱序 6 分钟。这里 watermark 不影响输出时机(merge 是 update 语义),只影响状态里留多少待比较行——留足乱序窗口,最终一致性就有保障。
四、案例三:IoT 会话监控——session window 的动态边界
4.1 问题形态
海量设备心跳上报,要求按“使用会话”统计:设备停止上报 gap 超过 10 分钟即认为会话结束,输出每个会话的时长与消息数。难点:会话边界由事件之间的间隔决定,不是时钟切片。
4.2 核心写法
heartbeats
  .withWatermark("eventTime", "15 minutes")     // ① 会话关闭的钥匙
  .groupBy(
    session_window($"eventTime", "10 minutes"), // ② gap 划分会话
    $"deviceId")
  .agg(count("*").as("msgs"),
       max($"eventTime").as("session_end"))
  .writeStream
  .outputMode("update")                         // ③ 会话中持续更新
  .foreachBatch(upsertSessionStore _)
  .start()
4.3 关键决策分析
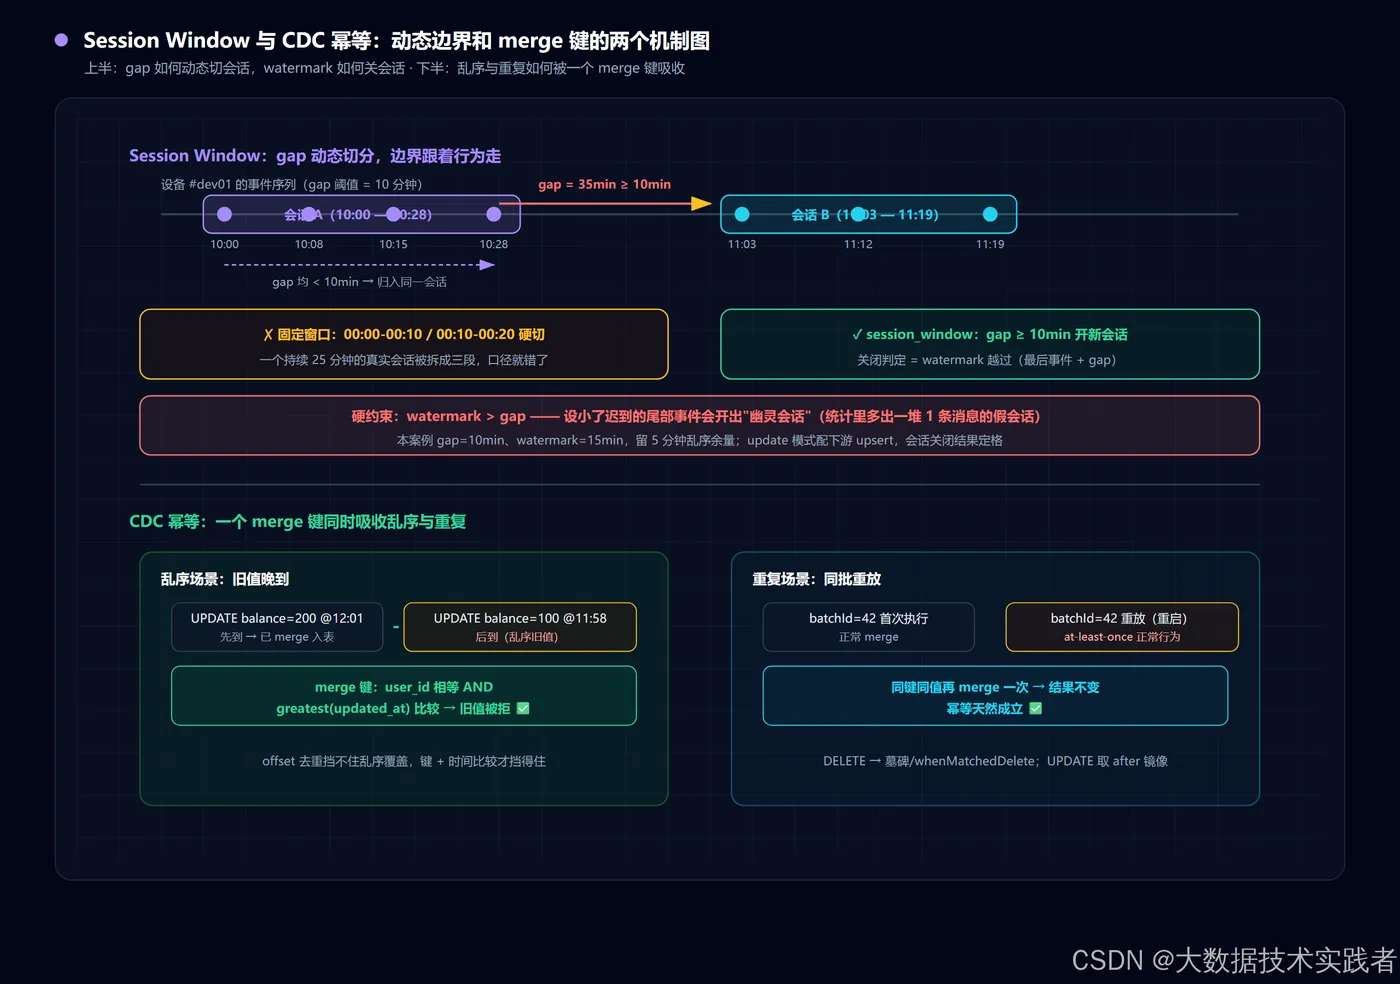
为什么 session window 而不是固定窗口? 固定窗口把 00:00-00:10、00:10-00:20 切开,一个持续 25 分钟的真实会话被拆成三段。session window 按 gap 动态划分:gap < 10 分钟归入同一会话,gap ≥ 10 分钟开新会话——边界跟着行为走,统计口径才对。
为什么 watermark 要大于 gap? 会话关闭的判定是“watermark 越过(最后一条事件时间 + gap)”。watermark 设 15 分钟(> gap 10 分钟)给乱序留余量;设得太小,迟到的尾部事件会开出一个“幽灵会话”,统计里多出一堆 1 条消息的假会话。watermark > gap 是会话场景的硬约束。
为什么输出模式是 update? 会话在关闭前每来一条事件就更新一次(消息数 +1、结束时间后移),大屏要看的是“当前会话进行到哪了”;append 要等会话关闭才能出结果,监控就失去了实时性。update 配下游 upsert,会话关闭后结果定格,一条会话一条记录。
五、三案例的共性提炼
- watermark 的角色随场景变:风控里管 Join 状态释放、CDC 里管乱序容忍、会话里管关闭判定——同一个参数,三种语义,取值逻辑完全不同;
- 输出模式跟着结果性质走:事实型结果(匹配即定)用 append、过程型结果(持续变化)用 update、幂等覆盖型用 merge——先问结果会不会变,再选模式;
- 幂等键是流式入湖的宪法:风控靠 Join 条件天然幂等、CDC 靠主键 + 时间比较、会话靠 (session_start, deviceId)——键选错,重放一次全乱;
- foreachBatch 是三案例共同的落库骨架:无论下游是 MySQL 还是 Delta,批内拿到 DataFrame + batchId 后,幂等逻辑都写在 merge/upsert 里,引擎不替你兜底。
六、总结
- 流-流 Join 的三大件:双流各带 watermark、间隔时间做条件、append 出事实;容量公式 = watermark 之和 × 流量,风控延迟 = watermark × 2 要提前告知业务;
- CDC 入湖的宪法:merge 键 = 主键 + 时间比较,幂等与有序一个键全解决;op 类型先转状态语义再落表;
- 会话窗口的硬约束:watermark > gap,否则幽灵会话;update 模式配下游 upsert,会话关闭结果定格;
- 三案例证明:Structured Streaming 没有银弹配置——同一套引擎、三类问题、三套答案,先分析状态性质与结果性质,再谈参数调优。

