
摘要:Kafka Sink 是"结果回流下游"的标配出口,但写出一条生产级链路要过五关:列契约(value 必需、key 决定路由、topic 可选);producer 调优(batch/linger/compression 三个吞吐旋钮与 acks 的取舍);at-least-once 语义下读端幂等的完整方案(去重表/upsert/版本号三式);死信队列与多 topic 分发两个高阶模式;schema 演进不让下游崩的兼容性规则。本文把这五关逐一拆开,每关都给"为什么"与可抄配置,最后附监控指标与高频问题速查。
关键词:Structured Streaming, Spark, Kafka Sink, producer 调优, 幂等消费, 死信队列, schema 演进, 回流链路, at-least-once
一、定位:Kafka Sink 在链路里管什么
流计算的结果有三种归宿:落仓(File/Delta)、进库(MySQL/ES)、回流 MQ 给下游实时消费——最后一种就是 Kafka Sink 的领地。它的角色是"解耦器":大屏、风控、推荐各取所需,谁也不直接依赖计算任务。
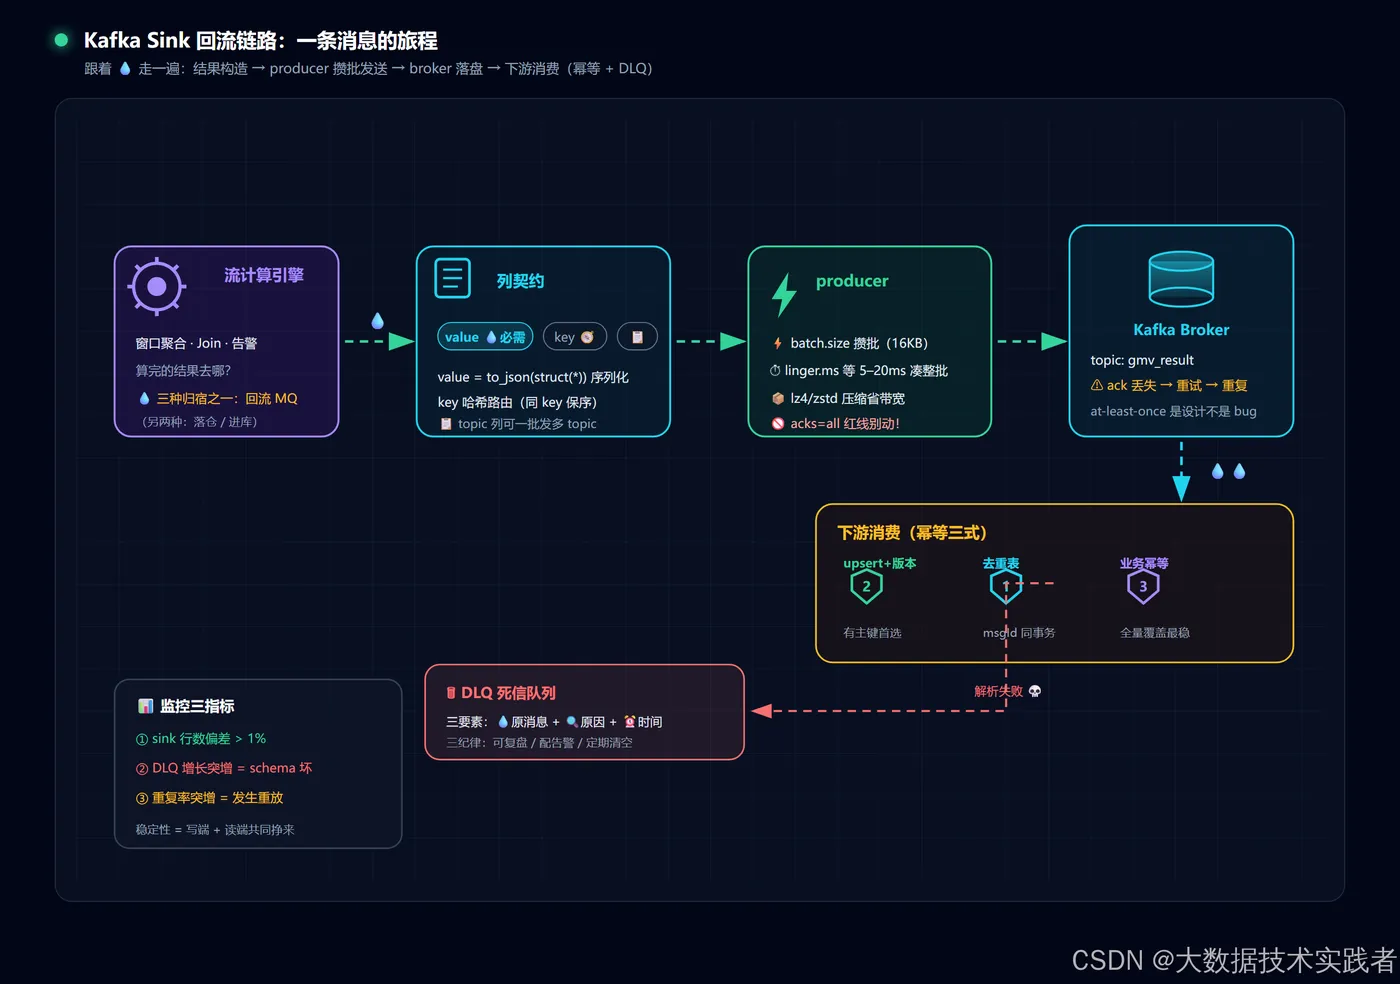
先立一个认知:Kafka Sink 的写入语义是 at-least-once——broker 收到但 ack 丢失时 producer 会重试,下游可能收到重复。这不是缺陷是设计,方案的一部分在读端(第四节展开)。
二、列契约:写什么、怎么路由
result.selectExpr(
  "CAST(province AS STRING) AS key",       // ① 路由依据
  "to_json(struct(*)) AS value"            // ② 唯一必需列
).writeStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092")
  .option("topic", "gmv_result")           // ③ 可选出口
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-sink")
  .start()
三条契约规则:① key 为 null 时自动补 null 列,有值则按哈希路由(同 key 进同分区,保序);② value 是唯一必需列(string/binary),序列化在 DataFrame 侧完成——to_json(struct(*)) 是最常用的一行;③ topic option 会覆盖数据中的 topic 列;不设置则数据必须有 topic 列(一批发多 topic 的场景靠它)。
另有 partition 列可直指定分区(优先级最高),headers 列需 sink 侧 includeHeaders=true。路由优先级:partition 列 > key 哈希 > 轮询。
三、producer 调优:吞吐三旋钮与 acks 取舍
KafkaSink 内部是标准 Kafka producer,参数用 kafka. 前缀透传。调优先抓四个:
| 参数 | 默认 | 作用 | 建议 |
|---|---|---|---|
kafka.batch.size |
16KB | 单批字节数 | 大消息体调大,配合 linger |
kafka.linger.ms |
0 | 攒批等待 | 5–20ms 换吞吐,延迟敏感保持 0 |
kafka.compression.type |
none | 压缩 | lz4/zstd 省带宽,CPU 换网络 |
kafka.acks |
all | 确认级别 | 保持 all,别为吞吐降到 1 |
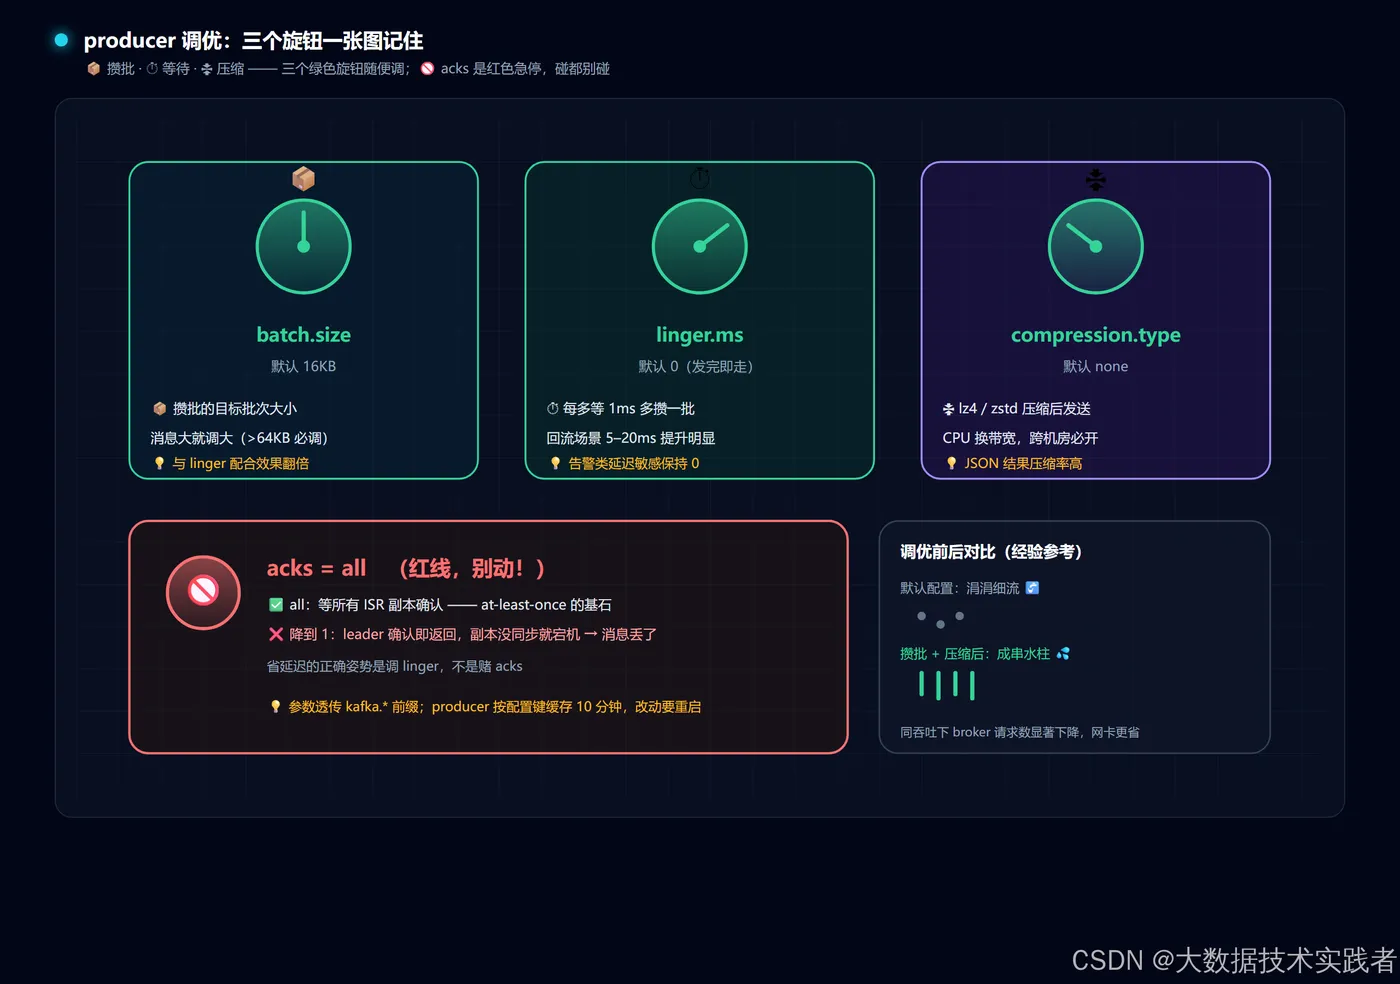
两个实践认知:acks=all 别动——它是 at-least-once 语义的基石,降到 1 省的是延迟、赌的是丢数据;linger 是延迟换吞吐的旋钮——每多等 1ms 就多攒一批,回流场景通常能接受 10ms 级延迟,吞吐提升明显。producer 实例按配置键缓存复用(默认 10 分钟超时回收),所以透传参数的改动要重启任务才生效。
四、at-least-once 的另一半:读端幂等方案
写端保证了"至少一次",重复就必然发生。完整的幂等方案在消费侧,三式按优先级选:
式一:去重表(通用)。 消费端先把 messageId 写入去重表(Redis SET / 数据库唯一索引),命中即跳过:
-- 消费伪代码:写业务与写去重同事务
INSERT INTO dedup(msg_id) VALUES(?)   -- 重复则违反唯一约束 → 跳过本条
INSERT INTO business(...) VALUES(...)
式二:upsert 语义(下游是库)。 消息带主键 + 版本/时间戳,消费走 ON DUPLICATE KEY UPDATE 且只接受更新的版本——重复消息被版本比较拒绝,与 CDC 入湖的 merge 键同构。
式三:业务幂等(天然可重放)。 计数类用"全量覆盖"代替"增量累加":消息体直接带最新值,消费端无脑覆盖,重复消费结果不变。
选型顺序:有主键选式二,无主键选式一,能改上游设计就式三。式三最优雅——把幂等做进数据模型,比做进消费代码更稳。
五、两个高阶模式:DLQ 与多 topic 分发
模式一:死信队列(DLQ)。 回流的消息下游解析失败怎么办?在消费侧把解析失败/超限的消息转发到 topic_dlq,主流程不中断:
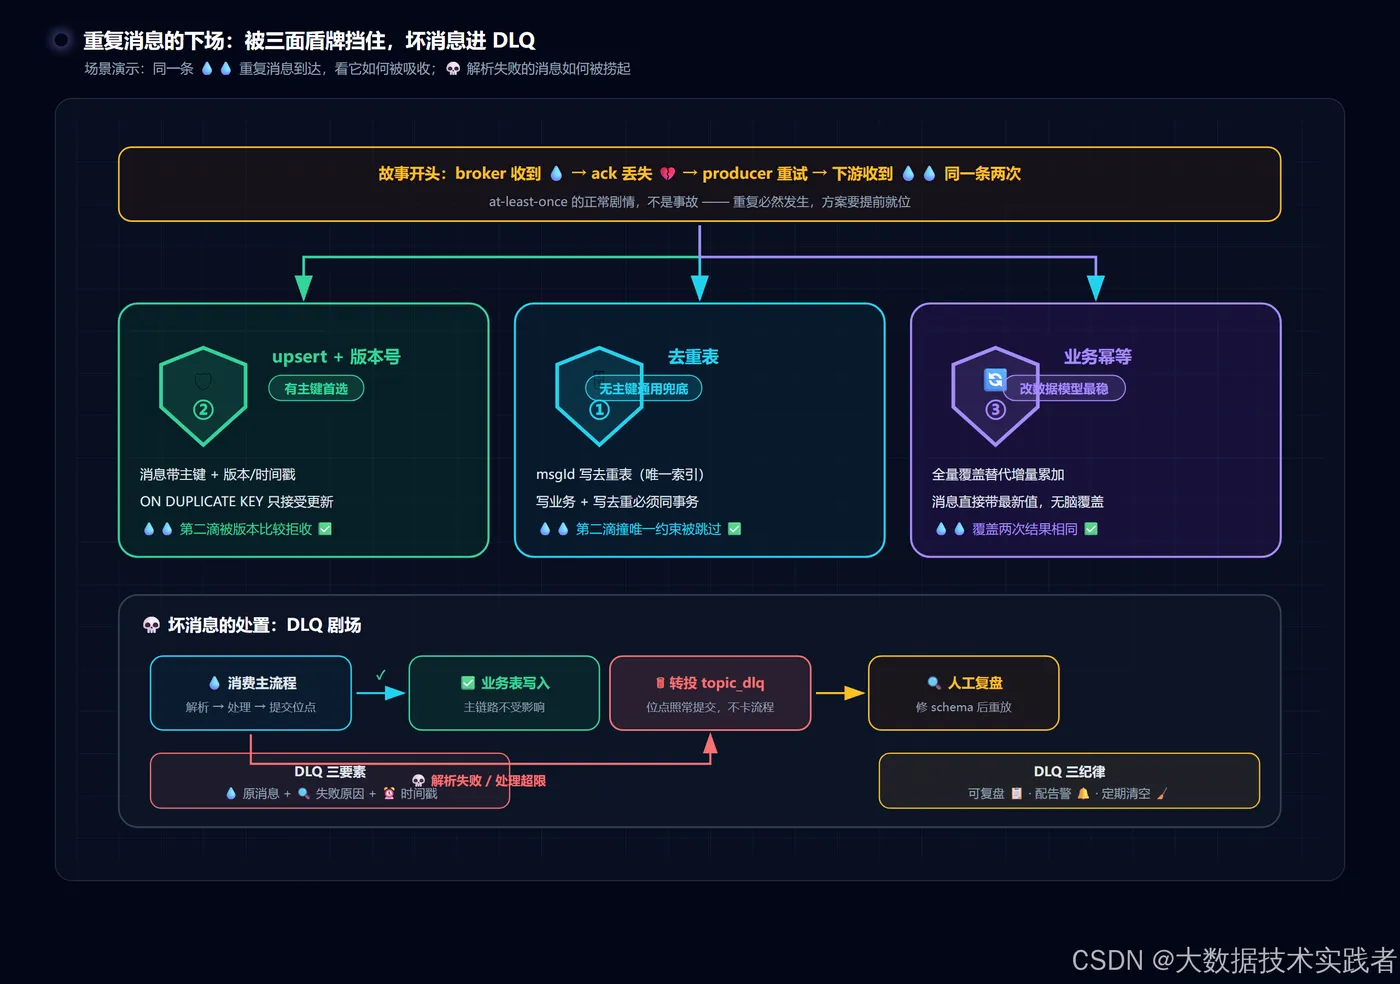
DLQ 三条纪律:死信要带原始消息 + 失败原因 + 时间戳三要素,否则不可复盘;DLQ 要配告警(增长率异常说明上游 schema 坏了);定期复盘清空,别当垃圾场。
模式二:多 topic 分发。 一批结果按规则发往不同 topic——数据里带 topic 列即可,sink 不设 topic option:
result.withColumn("topic",
  when($"risk_level" === "high", "alert_immediate")
  .otherwise("metrics_normal"))
  .writeStream.format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092")
  .start()   // 不设 topic,走数据列
注意各 topic 的分区数与保留策略要按下游 SLA 分别规划,别一套配置打天下。
六、schema 演进:不让下游崩
value 是 JSON 时,加字段是安全操作(下游忽略未知字段),删字段/改类型是破坏性变更。三条规则:只加不删;类型变更走"加新列废弃旧列"的双写过渡;大版本变更切新 topic(gmv_result_v2)而不是原地改。配 DLQ 监控,schema 破坏会在第一时间暴露(解析失败率飙升)。
七、监控:盯三个指标
| 指标 | 来源 | 告警条件 | 说明 |
|---|---|---|---|
| sink 输出行数 | lastProgress.sink.numOutputRows | 与批处理行数偏差 > 1% | 写入侧健康度 |
| DLQ 增长率 | DLQ topic 消费位点 | 突增 | schema 坏了 / 数据异常 |
| 下游重复率 | 消费端去重命中数 | 突增 | 重放发生,查 checkpoint 日志 |
八、总结
- Kafka Sink 的列契约三规则:value 唯一必需、key 决定路由、topic option 覆盖数据列;路由优先级 partition > key 哈希 > 轮询;
- producer 调优抓四个参数:batch/linger 攒批、compression 省带宽、acks=all 是语义基石别动;参数透传改动要重启生效;
- at-least-once 的一半在写端、一半在读端:幂等三式按"有主键 upsert > 去重表 > 业务幂等"选,能改数据模型最稳;
- DLQ 三要素(原始消息+原因+时间戳)三纪律(可复盘/配告警/定期清);多 topic 分发靠数据列驱动,各 topic 按下游 SLA 独立规划;
- schema 只加不删,类型变更双写过渡,大变更切新 topic;
- 盯 sink 行数偏差、DLQ 增长、重复率三个指标——回流链路的稳定性是写读两端共同挣来的。
