
做系统稳定性时,重试几乎是绕不开的配置。网络抖一下,重试。数据库超时,重试。消息确认失败,重试。
看起来很合理。
问题是,重试不是免费的。它会增加请求数量,会延长故障持续时间,还可能把一次失败变成重复写入、请求风暴,最后把原本还能自愈的系统推向雪崩。
所以,真正该问的不是“要不要重试”,而是:
这次失败,重试之后真的更可能成功吗?
一、最危险的误区:失败了就再来一次
假设有一个商品库存服务,数据库因为连接池耗尽,响应时间从几十毫秒涨到了几秒。
上游服务调用一次,超时。
于是它自动重试。
重试请求再次打到库存服务。数据库更忙,继续超时。上游再重试一次。
如果系统里有网关、业务服务和消息消费者,每一层都各自配置了 3 次重试,一次原始请求可能被放大成几十次甚至更多。
这还没算定时任务、补偿任务和人工重放。
结果呢,故障本身只需要几秒钟恢复,重试流量却让下游持续处在高压状态。数据库越来越慢,上游越来越急,更多请求进入重试队列。
这不就拉胯了么?
重试本来是为了给系统争取恢复时间,最后却变成了持续施压。
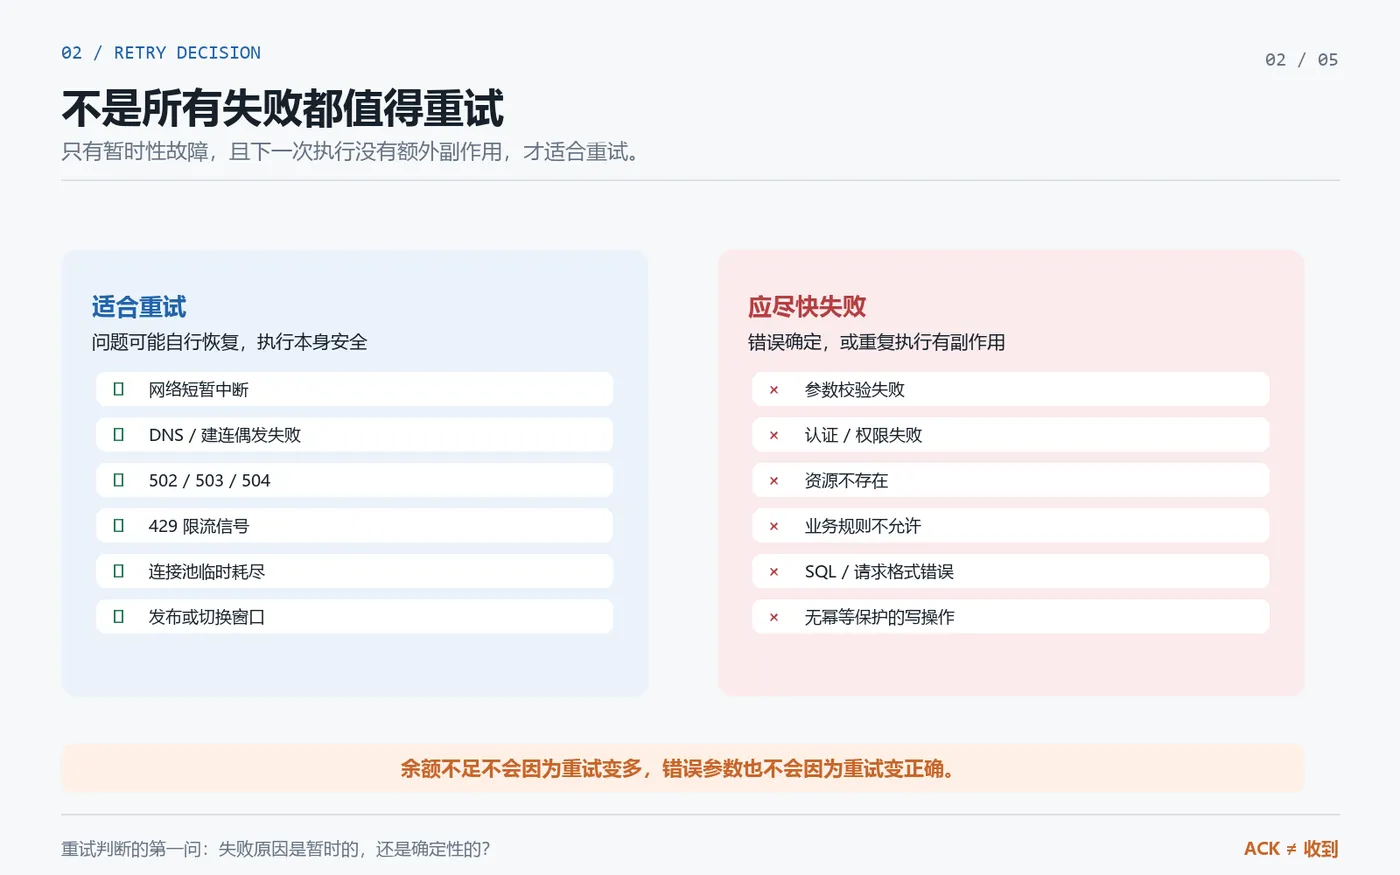
二、哪些失败适合重试?
不是所有错误都值得重试。判断标准可以简单一点:
失败原因是暂时的,且下一次请求不会造成额外副作用,才适合重试。
1. 比较适合重试的情况
- 网络连接被短暂中断;
- DNS 或连接建立阶段偶发失败;
- 下游返回 502、503、504;
- 服务明确返回限流信号,例如 429;
- 数据库连接池临时耗尽;
- 消息确认阶段连接断开;
- 依赖服务正在发布或短暂切换。
这些错误有一个共同点:问题可能会自行恢复。
但“可能恢复”不等于“立刻重试”。如果下游现在已经过载,马上再打一次,只会让它更难恢复。
2. 更适合立即失败的情况
- 参数校验失败;
- 身份认证失败;
- 权限不足;
- 资源不存在;
- 业务规则明确不允许;
- SQL 或请求格式错误;
- 数据版本冲突,且没有冲突解决策略;
- 同一个不可重复执行的写操作没有幂等保护。
比如余额扣减接口返回“余额不足”,你重试 10 次,余额也不会突然变多。
再比如用户名格式错误,重试只是把错误重复提交给服务端。这个时候应该尽快返回明确错误,而不是把线程、连接和队列都占住。
三、固定间隔,看起来简单,实际很容易撞车
最基础的重试策略是固定间隔:
失败后等待 1 秒
第 2 次失败后等待 1 秒
第 3 次失败后等待 1 秒
这个策略的问题是,所有请求的节奏都一样。
假设某个下游服务在 10:00:00 出现故障,1000 个请求同时失败。它们在 10:00:01 一起重试,还是失败。然后 10:00:02 再一起重试。
这不是恢复,是排队冲锋。
更常见的做法是指数退避:
第 1 次重试:等待 1 秒
第 2 次重试:等待 2 秒
第 3 次重试:等待 4 秒
第 4 次重试:等待 8 秒
它能明显降低短时间内的请求密度。
但只使用指数退避还不够。如果所有请求都按照同一套时间表等待,它们仍然会在 1 秒、2 秒、4 秒这些时间点集中发起。
所以还需要加抖动,也就是给等待时间增加一个随机范围:
实际等待时间 = 指数退避时间 + 随机抖动
例如本来准备等待 4 秒,可以让请求在 3 到 5 秒之间随机发起。
这样不同请求会被打散,不会在同一时刻再次撞到下游。
四、写操作能不能重试,关键看幂等
读请求重试通常比较容易理解。写请求就麻烦多了。
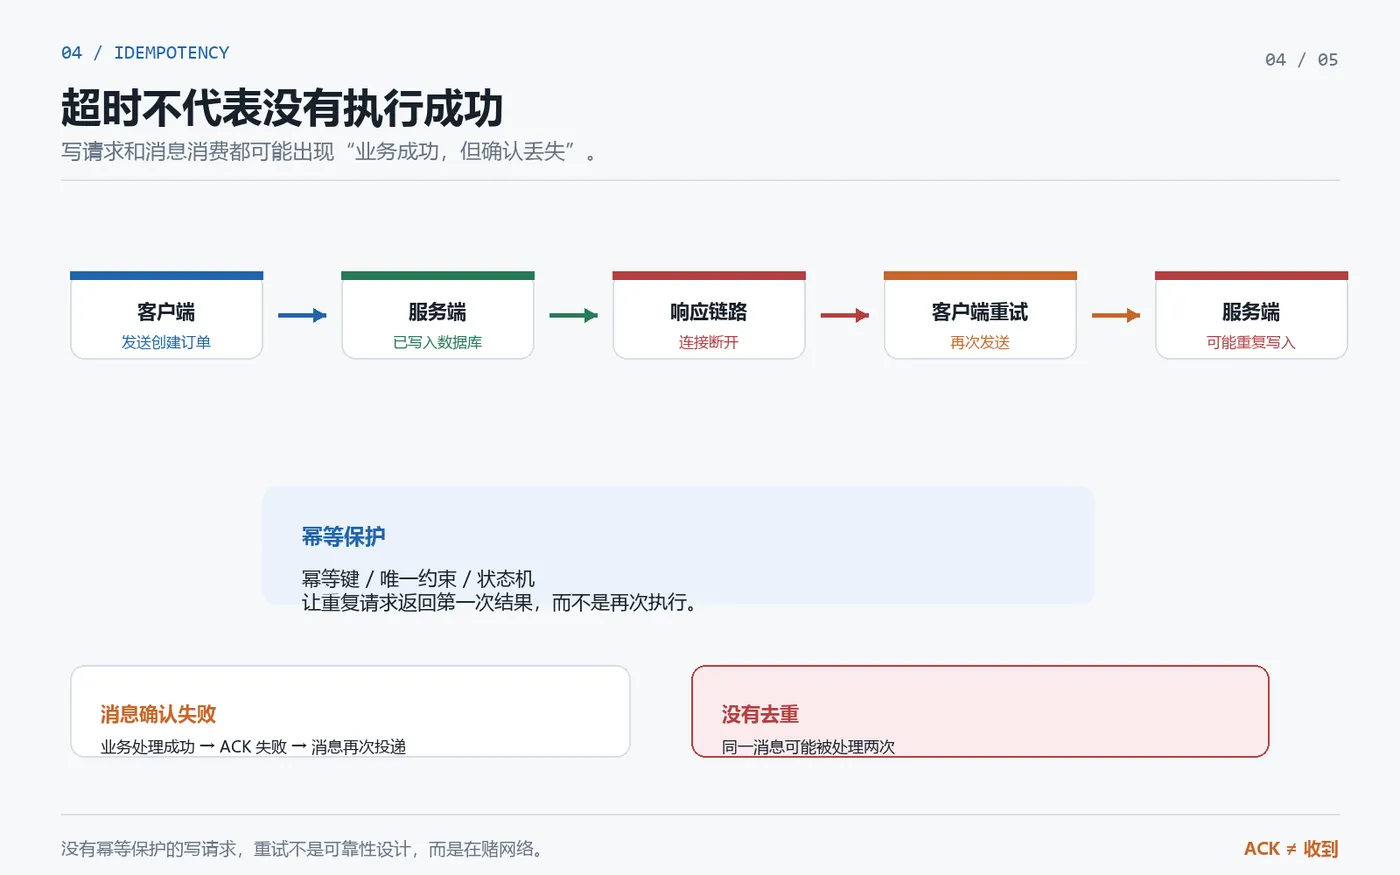
因为超时并不代表服务端没有执行成功。
客户端发起创建订单请求,服务端已经写入数据库,但响应还没返回,网络连接断了。客户端只看到一个超时,于是再次发送创建订单请求。
如果没有幂等控制,最后可能出现两个订单。
支付、扣库存、发优惠券、创建任务,都有类似风险。
常见的幂等方式有三类
1. 幂等键
客户端为同一个业务动作生成唯一请求号,例如:
order_id = 202610210001
idempotency_key = pay_202610210001
服务端收到请求后,先检查这个幂等键是否处理过。
如果已经处理过,就直接返回第一次处理的结果,不再重复执行。
2. 唯一约束
把业务上不能重复的字段设置成唯一键。
例如一个用户对同一商品只能有一条有效收藏记录,就可以使用:
unique(user_id, product_id)
这样即使请求被重复发送,数据库也能挡住第二次写入。
当然,数据库报唯一冲突后,业务层要能识别这是“已经成功过”,而不是把它当成普通失败。
3. 状态机限制
给业务动作设计明确状态。
例如订单只能从:
待支付 → 已支付 → 已发货
向前推进。
如果订单已经是“已支付”,再次收到支付成功通知时,就不应该重复扣款,而应该返回当前状态。
这部分不能只靠客户端自觉。客户端可能超时、重启,也可能因为网络问题重复发送。幂等保护必须尽量放在服务端。
五、消息确认失败,不代表消息没处理
消息系统里有一个很容易被忽略的场景。
消费者收到消息后,已经完成了业务处理,但在发送确认之前,连接断了。
消息队列认为这条消息没有被确认,于是再次投递。
如果消费者没有去重,同一条消息就会被处理两次。
这不是消息系统“重复发错了”,而是消费过程本身就可能出现:
业务处理成功
确认消息失败
消息再次投递
所以消息消费者不能只依赖“消费成功后确认”这一个动作。常见做法包括:
- 使用消息唯一 ID 做消费去重;
- 在本地记录已经处理过的消息;
- 对关键写操作增加唯一约束;
- 给重复消费设计安全返回;
- 超过最大重试次数后进入死信队列。
死信队列不是垃圾桶。
它应该保留失败原因、原始消息、重试次数、最后一次错误和时间信息。否则消息进去了,后面没人知道为什么失败,也没办法判断能不能人工补偿。
六、重试次数不是越多越好
很多系统喜欢把重试次数配置成 3 次、5 次,甚至更多。
但“最大重试次数”只是一个参数,不是完整策略。
至少还需要考虑三个限制:
1. 总截止时间
一个请求不能因为多次重试一直占着线程。
比如接口的整体截止时间是 10 秒,那么所有重试、等待和网络调用都必须在这 10 秒内完成。
2. 重试预算
对同一个依赖服务,要限制重试流量占全部请求的比例。
如果某个服务当前有 1000 个请求,其中 900 个都来自重试,说明系统已经不是在正常工作了。
这个时候继续重试,收益通常很低,风险却很高。
3. 最大退避时间
指数退避必须设置上限。
否则一次持续故障可能让请求等待几十分钟,调用方线程、连接和任务状态都会被长期占用。
真正可控的策略应该类似这样:
最多重试 3 次
总耗时不超过 10 秒
等待时间指数增长
每次加入随机抖动
超过截止时间立即失败
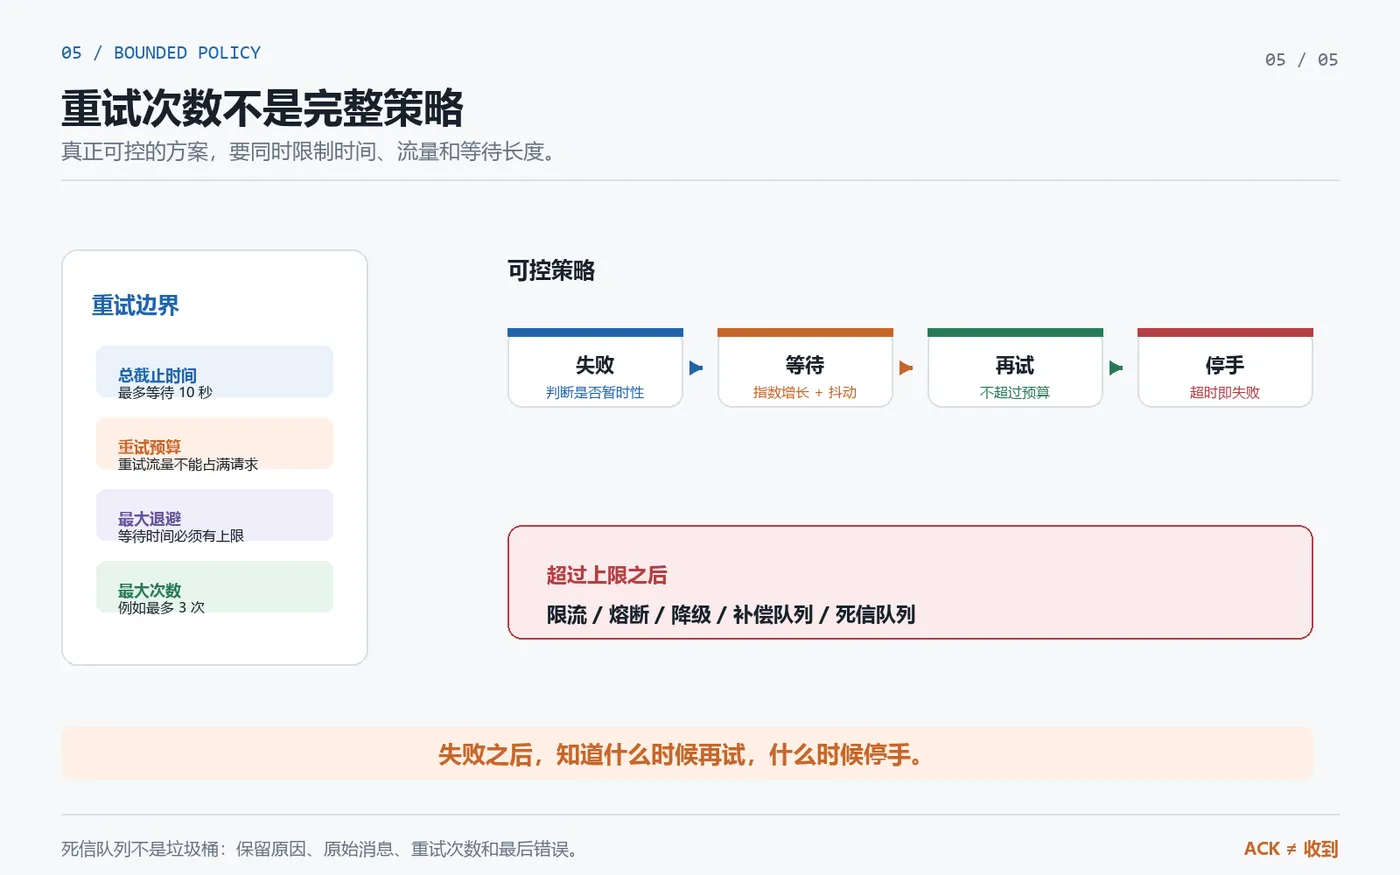
必要时,还需要结合限流、熔断和降级。下游已经明确不可用时,先减少请求,比不断重试更有价值。
七、一个故障场景:同样的下游故障,结果可能完全不同
假设商品详情服务依赖一个数据库集群。
某天数据库主节点发生切换,持续 8 秒无法正常响应。
方案 A:固定间隔重试
每个请求失败后每隔 1 秒重试,最多重试 5 次。
结果:
- 大量请求在同一时间点重新打到详情服务;
- 详情服务继续占用连接等待数据库;
- 数据库恢复后,先接收到一大批积压请求;
- 应用线程和连接池同时承压;
- 部分请求最终超时,重试又从上游重新开始。
数据库虽然恢复了,应用却没有恢复。
方案 B:指数退避加抖动
请求失败后,等待时间逐步增加,并加入随机抖动。超过总截止时间后直接返回可识别的失败结果。
结果:
- 重试请求被分散到不同时间;
- 数据库恢复后不会瞬间被打满;
- 一部分请求可以在下游恢复后成功;
- 另一部分请求及时失败,由上层降级或进入补偿队列;
- 故障影响范围被控制在一个明确的时间窗口内。
这里的差别,不是“有没有重试”。
而是有没有给下游留恢复时间,有没有控制重试流量,有没有判断请求是否还能安全执行。
八、重试策略应该先回答这 6 个问题
给接口加重试前,我一般会先问:
- 这个错误是暂时性的,还是确定性的?
- 请求再次执行,会不会产生重复写入?
- 服务端能不能通过幂等键识别同一个业务动作?
- 重试会不会进一步增加下游压力?
- 整个请求最多允许等待多久?
- 超过重试上限后,失败结果交给谁处理?
如果这 6 个问题没有答案,先别急着把重试次数改成 5 次。
尤其是写操作。没有幂等保护的写请求,重试不是可靠性设计,而是在赌网络到底什么时候断。
结尾
重试的价值,是给暂时性故障留出恢复空间。
它的风险,是让每一个失败请求都继续占用系统资源。
固定间隔可能造成同步冲锋。指数退避可以降低压力,抖动可以避免请求再次撞车。幂等键解决重复写入,死信队列承接最终失败,截止时间和重试预算则负责把影响范围锁住。
所以,重试不是“失败后再来一次”这么简单。
它决定了系统遇到故障时,是慢慢恢复,还是越救越乱。
真正稳定的系统,不是永远不失败。
而是失败之后,知道什么时候再试,什么时候停手。

