前面我们学习了 Elasticsearch集群异常状态(RED、YELLOW)原因分析 ,了解到了当集群发生主分片无法上线的情况下,集群状态会变为RED,此时相应的RED索引读写请求都会受到严重的影响。
背景
- 前面我们学习了 Elasticsearch集群异常状态(RED、YELLOW)原因分析 ,了解到了当集群发生主分片无法上线的情况下,集群状态会变为RED,此时相应的RED索引读写请求都会受到严重的影响。
- 这里我们将介绍在实际使用中,极端场景下ES集群异常崩溃且无法恢复的一种情况。
问题
业务突然不可用,持续收到报错:
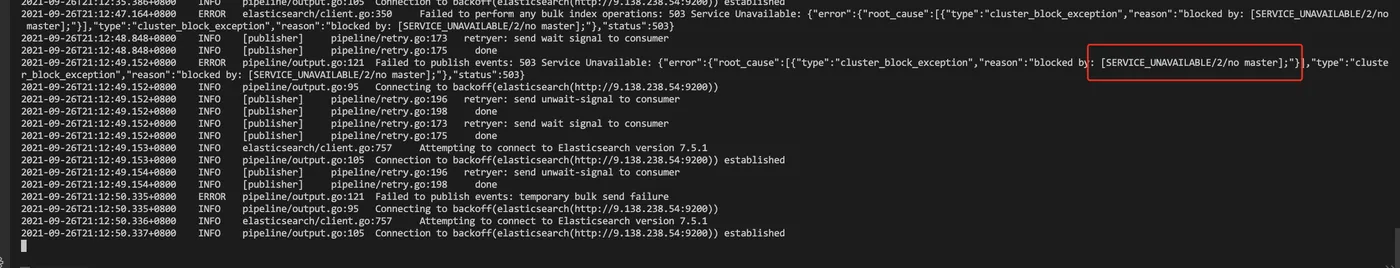
通过观察集群日志,发现ES集群始终处于无主状态,无法自我恢复:
Caused by: ClusterBlockException[blocked by: [SERVICE_UNAVAILABLE/2/no master];]
        at org.elasticsearch.cluster.block.ClusterBlocks.globalBlockedException(ClusterBlocks.java:158)
        at org.elasticsearch.cluster.block.ClusterBlocks.globalBlockedRaiseException(ClusterBlocks.java:144)
        at org.elasticsearch.action.bulk.TransportBulkAction.executeBulk(TransportBulkAction.java:204)
        at org.elasticsearch.action.bulk.TransportBulkAction.doExecute(TransportBulkAction.java:151)
        at org.elasticsearch.action.bulk.TransportBulkAction.doExecute(TransportBulkAction.java:71)
        at org.elasticsearch.action.support.TransportAction.doExecute(TransportAction.java:149)
        at org.elasticsearch.action.support.TransportAction.execute(TransportAction.java:137)
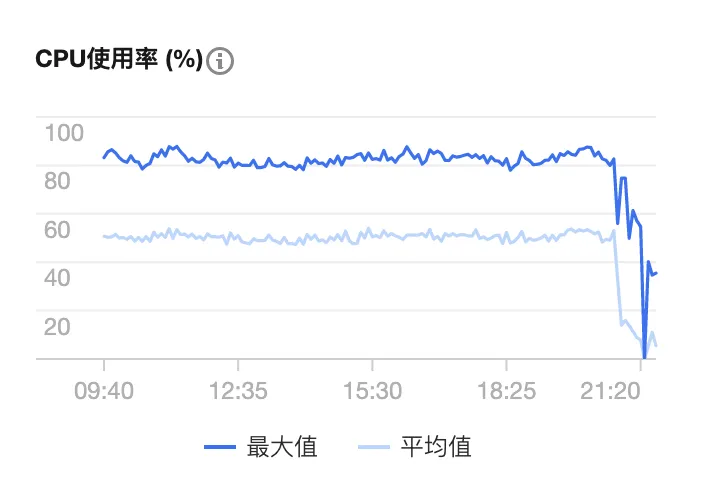
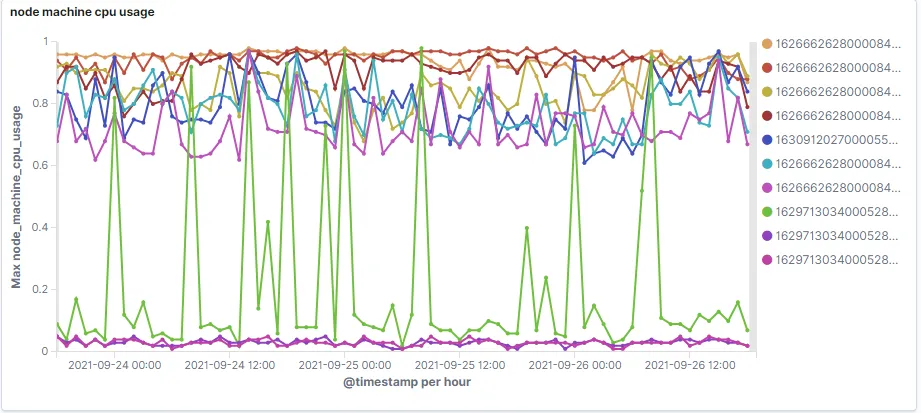
观察监控发现集群崩溃前,CPU使用率始终处于瓶颈状态。
解决过程
一:重启集群并切断流量(无效)
当我们发现集群已经彻底崩溃,为了让集群可以尽快恢复,第一时间对集群做了一次全量重启,然后切断了集群的请求流量:
[root@sh ~]# curl -s -H 'Content-Type: application/json' -XPUT localhost:9200/_all/_settings -d '
{

  "index.blocks.read": true,
  "index.blocks.write": true
}'
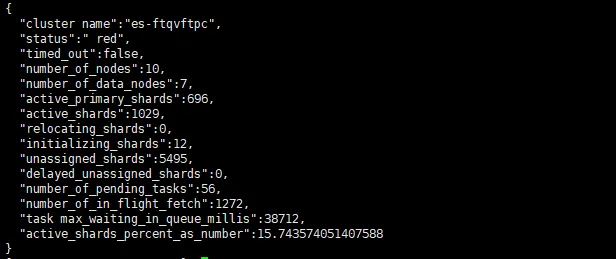
重启后观察到集群在正常恢复:
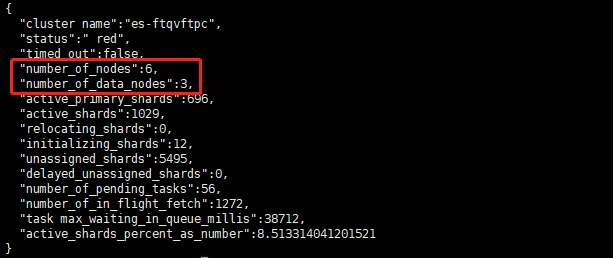
但是好景不长,没一会节点又掉线了:
于是我们紧急采集下一步行动。
二:开启异步落盘(无效)
进一步观察,发现集群的master节点使用的是HDD机械盘。这个会导致节点启动后元数据同步刷盘效率非常低,会使元数据变更卡住较长时间。虽然偶尔能选出主,但因元数据变更超时很快就失主了。于是我们进行如下变更:
[root@sh ~]# curl -s -H 'Content-Type: application/json' -XPUT localhost:9200/_cluster/settings -d '
{

    "persistent":{

        "cluster.metadata.async_write.enable":true,
        "cluster.metadata.master_async_write.enable":true
    },
    "transient":{

        "cluster.metadata.async_write.enable":true,
        "cluster.metadata.master_async_write.enable":true
    }
}'
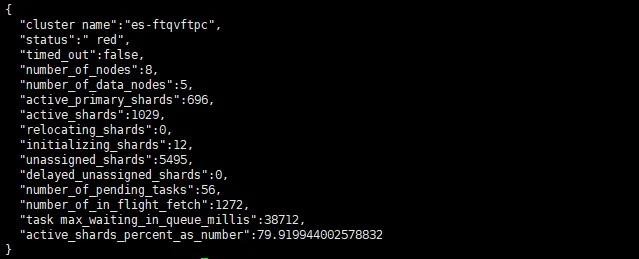
这个操作做过之后,可以明显发现恢复的过程相对稳定一些,但还是会发生节点离线:
只好继续下一个方案。
三:延长发现主节点的间隔时间(无效)
通过以上的现象来看,很像是社区讨论的节点被踢出后,反复join/left的问题:#67873。
描述的问题是,在节点偶发元数据更新过程中,部分节点因 lagging 被踢出,而被踢出后,又因反复left/join无法加入集群,则需要手动重启。lag的原因是数据节点元数据应用过程中,因recovery占有分片Engine读锁导致长时间卡住。于是我们再进行一下如下变更:
discovery.find_peers_interval: 5s
将这个参数在集群各节点config/elasticsearch.yml进行配置,然后重启节点。
通过观察,发现集群比之前更稳定了一些,但依旧会发生离线:
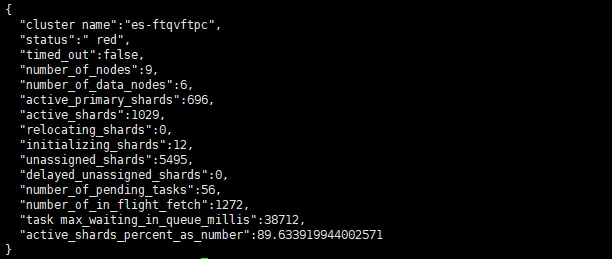
不再拖延时间,我们决定深入分析一下。
四:水落石出
抓取火焰图进行分析,发现性能消耗在findAlias上:
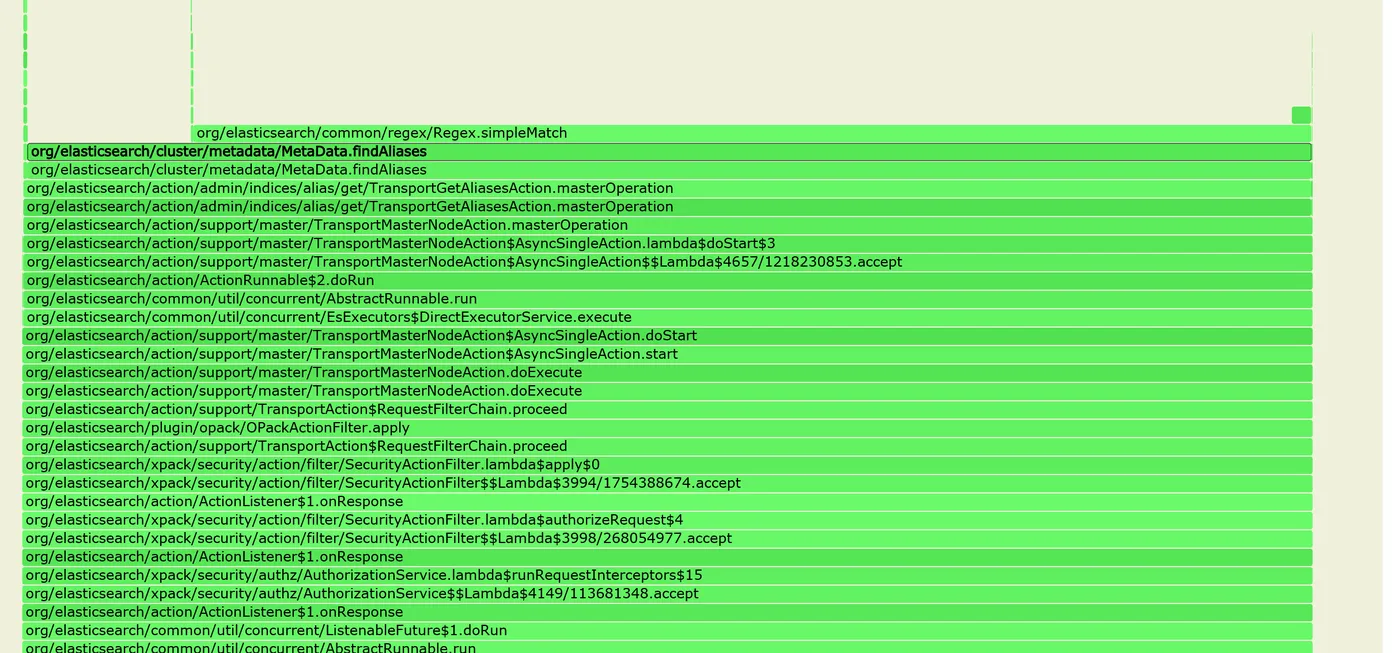
master一旦被选举出来,就会被这个alias查找把cpu打满,我们怀疑集群应该是建了异常多的alias。经过确认,果然创建大量的别名:
[root@sh ~]# curl -s -XGET localhost:9200/_cat/aliases | wc -l
109661
[root@sh ~]# curl -s -XGET localhost:9200/_cat/templates | wc -l
40597
叹为观止,10万多个别名,4万多个模式,这简直就是一个灾难。由于内部索引写入也会触发别名查找,我们紧急设置一下集群级别只读:
[root@sh ~]# curl -s -XPUT localhost:9200/_cluster/settings
{

    "persistent":{

        "cluster.blocks.read_only_allow_delete":true
    },
    "transient":{

        "cluster.blocks.read_only_allow_delete":true
    }
}
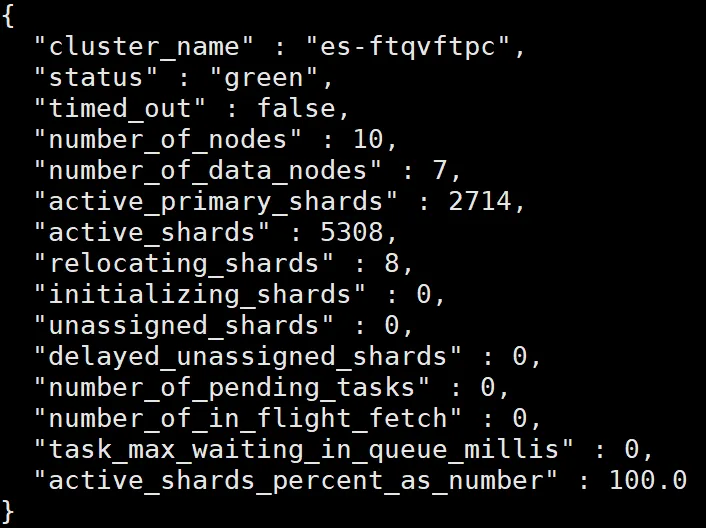
紧接着我们紧急联系了业务同学,了解到业务是将ID设置为索引的别名,造成了有大量别名的产生,而又不定期进行清理,最终导致有庞大的alias量级。经过推动,业务通过脚本进行别名的删除,降低了大批别名后,集群恢复正常:
findAlias原理及问题根因:
匹配的过程是通过将别名字符串切分成多个区间子串进行匹配,业务的别名也是比较长,一个别名切分成几十上百个区间,上万的别名就很多了。且master处理任务是单线程的,也可以看到是部分cpu100%。
后续观察
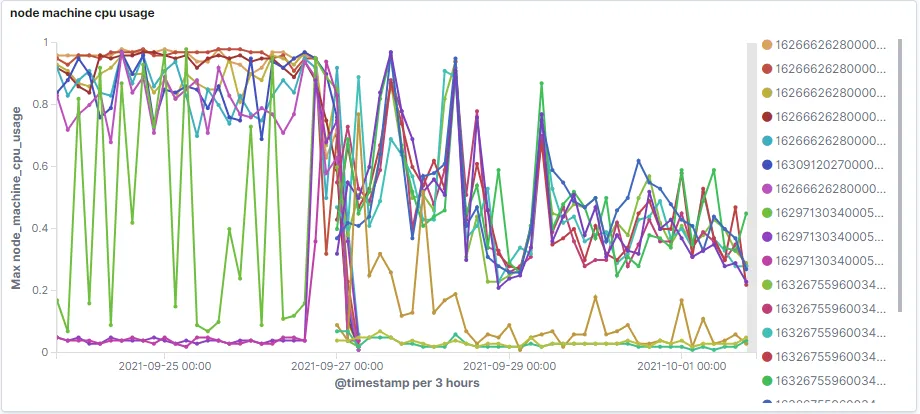
持续观察了一段时间,从那天业务清理过别名之后,集群的CPU使用率就没再居高不下: