摘要:Structured Streaming 的 API 面看似只是"批处理 API 加个流式入口",实际由五个对象各司其职:SparkSession 开门、DataStreamReader 定义读入、DataFrame 承载计算、DataStreamWriter 决定写出、StreamingQuery 管生命周期。本文沿"读 → 算 → 写 → 管"主线把五个对象的常用方法过一遍,讲清哪些 API 流批一致(select/filter/join)、哪些是流式专属(withWatermark、outputMode、Trigger 四种模式)、哪些操作流上不可用(limit、distinct、多聚合链);再用一段完整实现把五个对象串成一条可跑的 GMV 流,覆盖 Trigger 选择的代价权衡、StreamingQuery 的启停查监控闭环,以及一个高频报错(checkpoint 相同 + 查询不同)的根因。
关键词:Structured Streaming, Spark, DataStreamReader, DataStreamWriter, StreamingQuery, Trigger, withWatermark, API, 微批处理
一、API 地图:五个对象,各司其职
先把整张 API 面压成五个对象,后面逐个展开:
| 对象 | 职责 | 入口/方法 | 一句话 |
|---|---|---|---|
| SparkSession | 环境与入口 | spark.readStream / spark.streams |
开门的人 |
| DataStreamReader | 定义源与 schema | format/option/schema/load |
怎么读 |
| DataFrame | 承载计算 | select/filter/join/groupBy |
算什么 |
| DataStreamWriter | 定义输出 | outputMode/format/option/trigger/start |
怎么写 |
| StreamingQuery | 生命周期管理 | start/stop/status/lastProgress |
怎么管 |
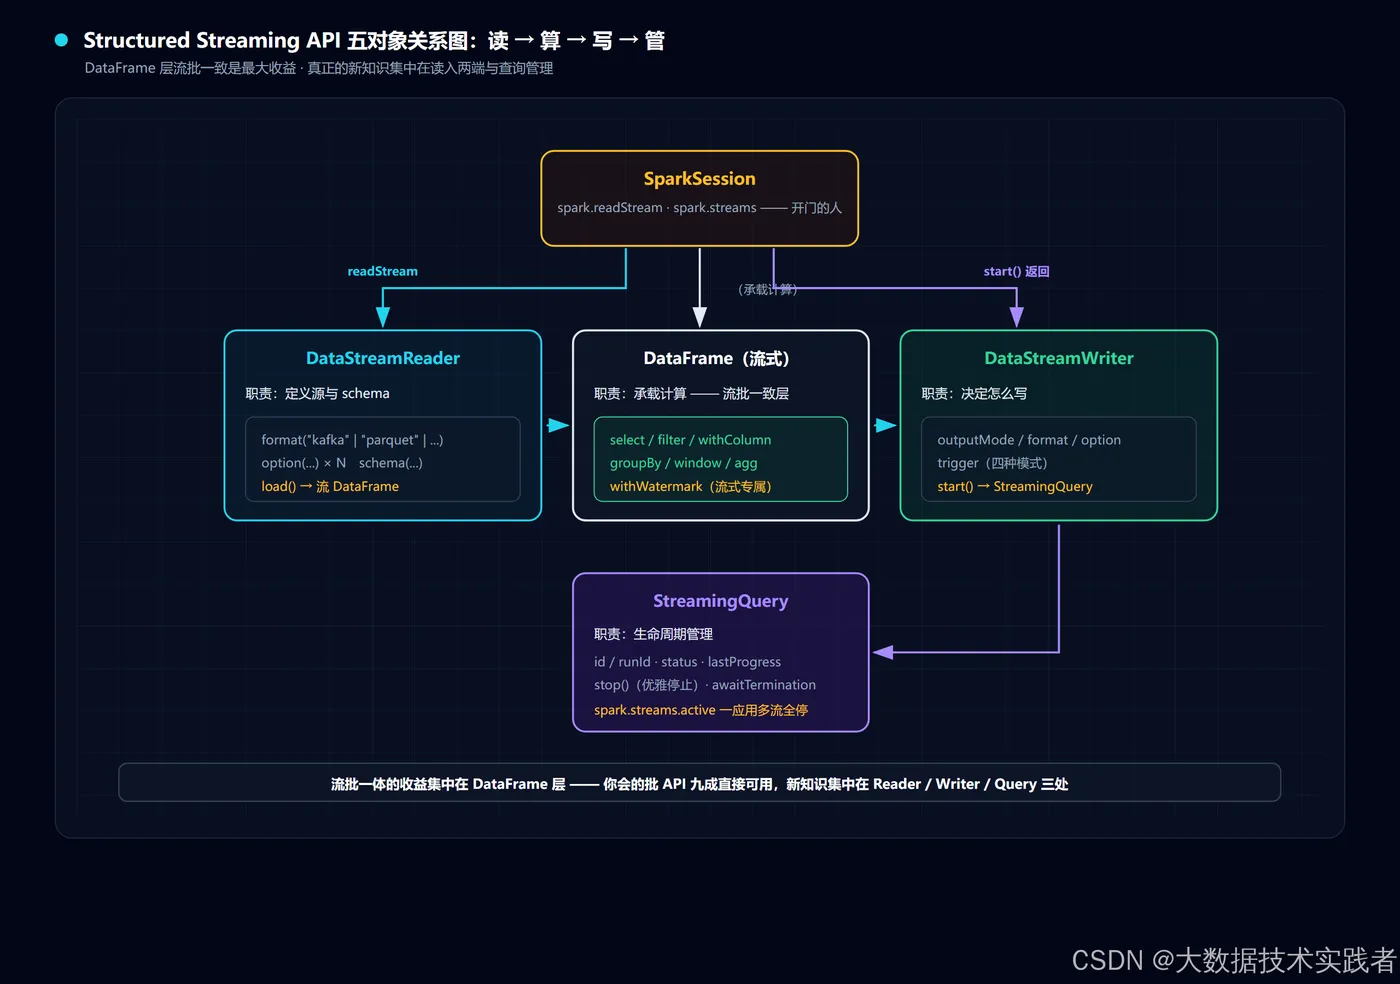
关键认知:DataFrame 上的绝大多数操作流批一致——这是"流批一体"的直接收益,你会的批 API 九成直接可用。真正需要新学的是读入两端(Reader/Writer)与查询管理(StreamingQuery)。
二、DataStreamReader:读的四种定义
val orders = spark.readStream                 // ① 入口
  .format("kafka")                            // ② 源类型
  .option("kafka.bootstrap.servers", "broker1:9092")
  .option("subscribe", "order_events")
  .option("maxOffsetsPerTrigger", "80000")    // ③ 选项
  .load()                                     // ④ 生成流 DataFrame
四段式结构 readStream → format → option → load 是所有源的统一范式。两个必记点:schema 必须显式指定(流式没有"先扫全量推 schema"的机会,File 源不指定直接报错);option 键因源而异(Kafka 的 subscribe、File 的 maxFilesPerTrigger),但都挂在同一个 option 链上。
三、核心算子:三类行为要分清
DataFrame 层的算子按"流上可用性"分三类:
第一类:完全一致。 select / filter / withColumn / drop 等纯投影过滤,写法和批处理一模一样,无任何心理负担。
第二类:流式语义增强。
orders
  .withWatermark("eventTime", "2 minutes")     // ① 迟到阈值
  .groupBy(window($"eventTime", "1 minute", "30 seconds"), $"province")
  .agg(sum("amount").as("gmv"))                // ② 事件时间窗口聚合
① withWatermark 是流式专属,必须在聚合前调用且时间列与聚合列一致,它同时管丢数、状态释放与输出时机。② window 窗口聚合天然支持,但输出模式的选择会影响结果落地方式(append 等窗口关、update 出中间态)。
第三类:流上不可用或受限。 limit 无界流没有"前 N 条"概念(排序依赖 complete 模式下的聚合后排序);distinct 要换 dropDuplicates(它用 state 代管去重键);多个有状态算子链式叠加目前不支持(聚合后再聚合会报错)。遇到这些操作别硬写,先想"引擎要为它维护什么状态"——想不清就说明这个 API 在流上没有定义。
四、DataStreamWriter:写的四个决定
gmv.writeStream
  .outputMode("update")                        // ① 输出模式
  .format("console")                           // ② Sink 类型
  .option("truncate", "false")
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv")  // ③ 容错位点
  .trigger(Trigger.ProcessingTime("30 seconds"))  // ④ 触发节奏
  .start()                                     // 启动并返回 StreamingQuery
①~④ 对应四个决定:写什么模式(append/update/complete)、写到哪里(File/Kafka/foreachBatch)、位点记在哪(checkpointLocation 是必选项,不配启动即报错)、多久写一次(Trigger)。
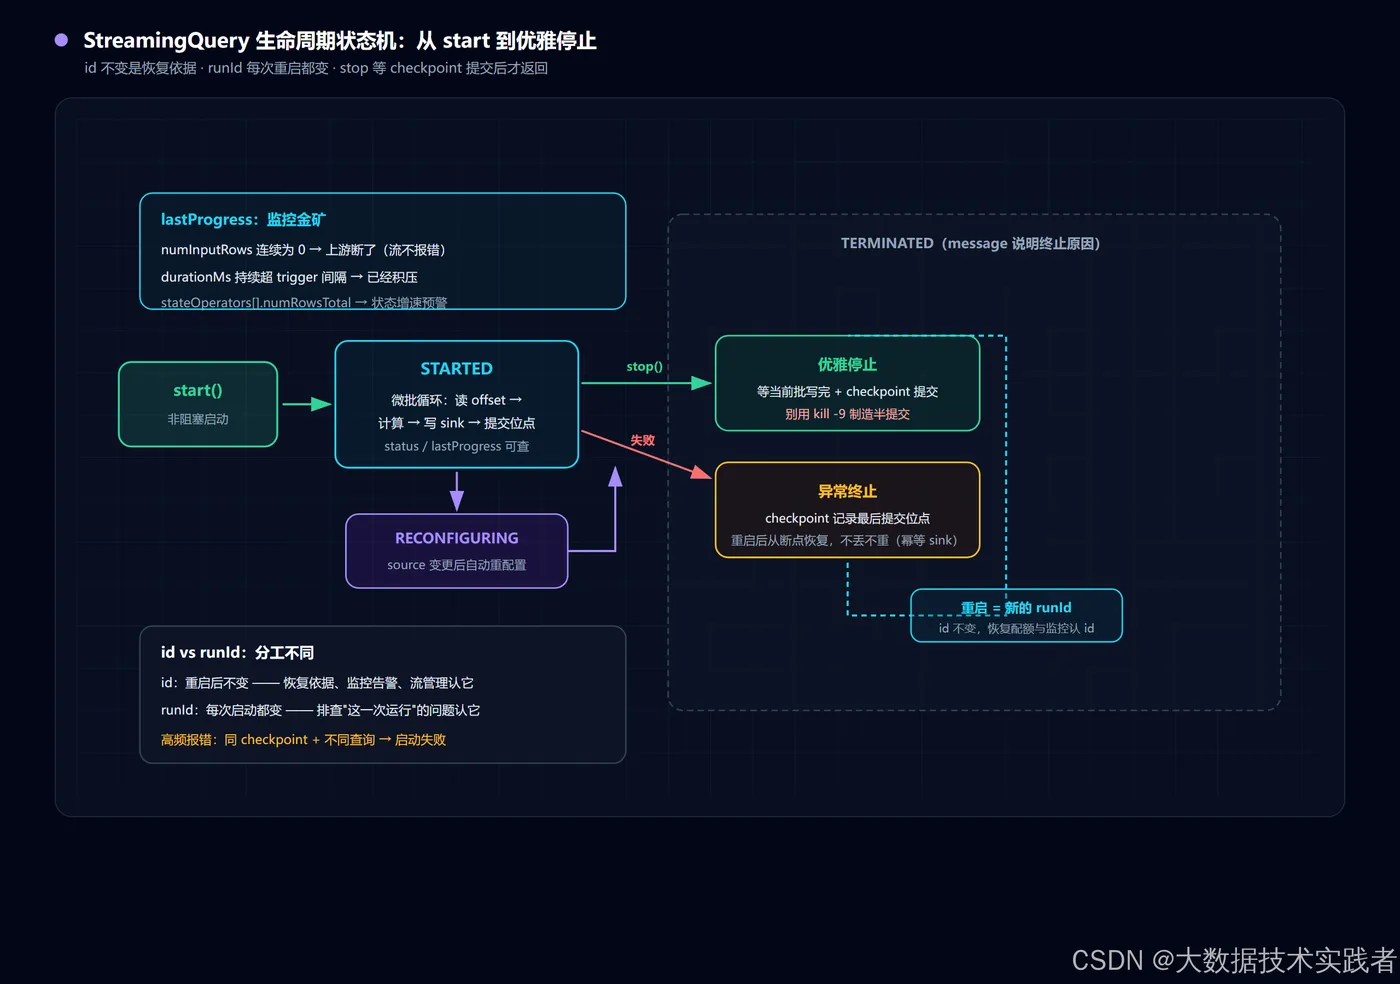
Trigger 有四种,行为与代价差异明显:
| Trigger | 行为 | 延迟 | 语义 | 适用 |
|---|---|---|---|---|
| 未指定(默认微批) | 上一批结束立刻开下一批 | ~100ms | exactly-once | 大多数场景 |
| ProcessingTime(interval) | 固定间隔触发 | 间隔决定 | exactly-once | 稳态控速 |
| AvailableNow | 处理完现有积压即停 | 批式 | exactly-once | 定时补数/准实时 |
| Continuous(interval) | 连续处理 | ~1ms | at-least-once | 极低延迟(限 map 类) |
Continuous 是唯一 at-least-once 的模式,且只支持 map 类算子 + Kafka/Rate 源的白名单组合——评估时先对白名单再上车。
五、StreamingQuery:生命周期与监控
start() 返回的 StreamingQuery 是后续管理的把手:
val query = gmv.writeStream /* ... */ .start()

query.id            // 唯一 ID(重启后不变,恢复依据)
query.runId         // 本次启动的运行 ID(每次重启都变)
query.status        // 当前状态与触发信息
query.lastProgress  // 最近的批进度(输入行数、处理时长、source/sink 指标)
query.stop()        // 优雅停止(等 sink flush + checkpoint 提交)

spark.streams.active.foreach(_.stop())   // 一个应用多流时全停
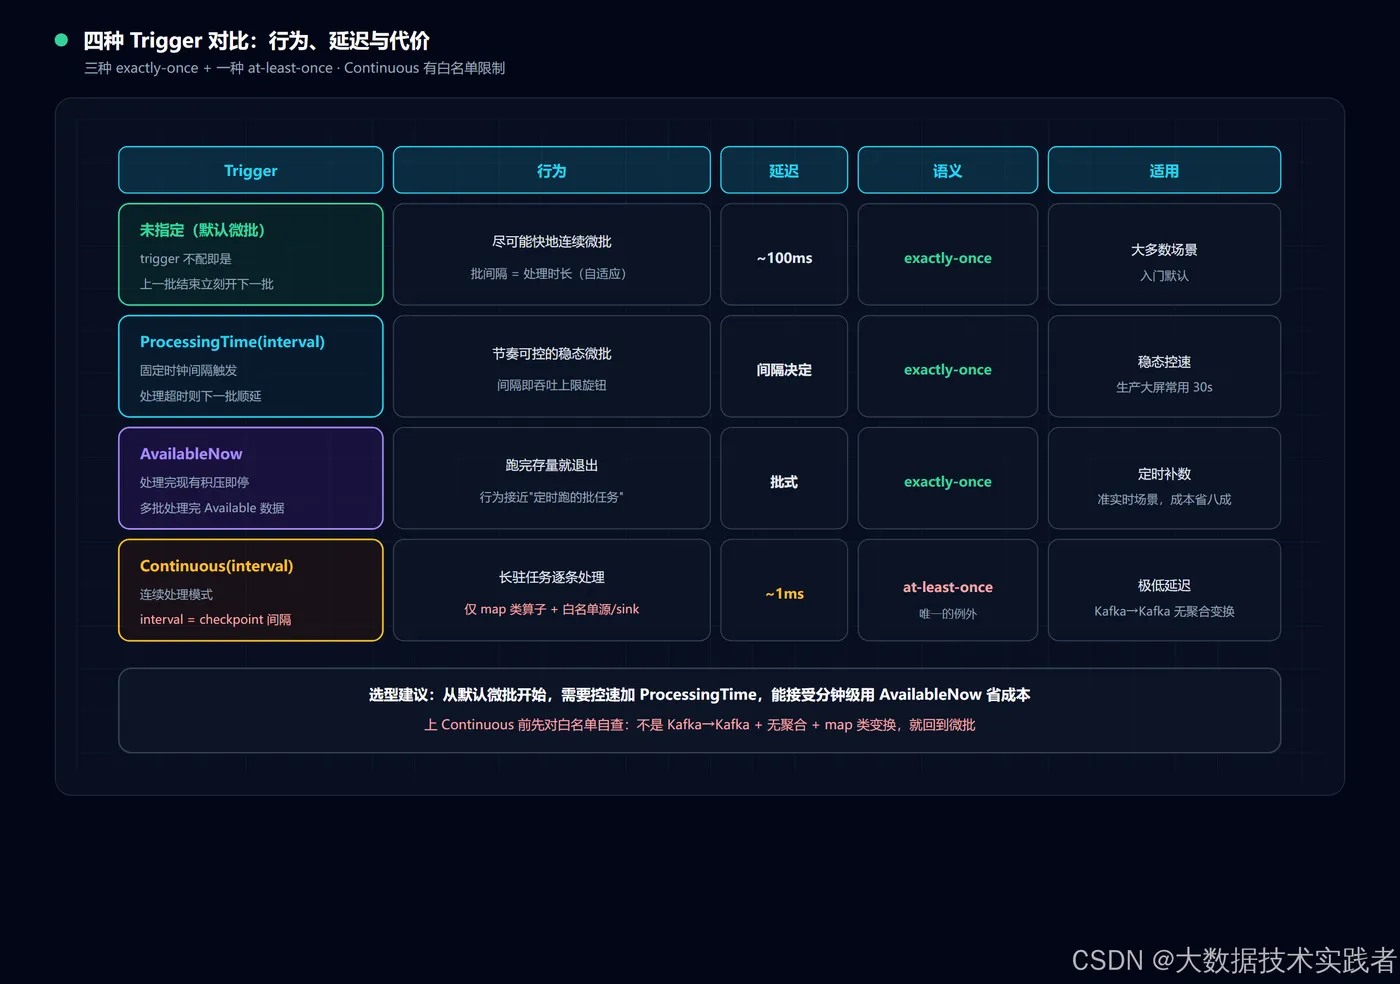
三条实践纪律:stop 是优雅停止,会等当前批写完并提交 checkpoint,别用 kill -9 制造半提交状态;id 与 runId 分工不同,恢复配额/监控告警认 id,排查本次运行问题认 runId;lastProgress 是监控数据源,numInputRows 连续为 0 = 上游断了,durationMs 持续超 trigger 间隔 = 已经积压。
高频报错:同一个 checkpoint 目录被两个不同查询使用时,启动直接失败(检测到逻辑计划变更)。根因:checkpoint 绑定的是"这条查询的逻辑计划",不是"这个目录"。排查顺序:是不是复用了旧目录?是不是改了算子/分区数?修复就是换新目录,别想着"清掉重跑能保状态"——状态与计划是一体的。
六、完整实现:五对象串成一条流
把五个对象按"读 → 算 → 写 → 管"拼起来,这就是生产任务的骨架:
import org.apache.spark.sql.Trigger
import org.apache.spark.sql.functions._

val spark = SparkSession.builder().appName("GmvApp").getOrCreate()

// 1. 读:DataStreamReader
val orders = spark.readStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092")
  .option("subscribe", "order_events")
  .option("maxOffsetsPerTrigger", "80000")
  .load()
  .select(from_json($"value".cast("string"), orderSchema).as("o"))
  .select($"o.orderId", $"o.amount", $"o.province", $"o.eventTime")

// 2. 算:DataFrame 流式算子
val gmv = orders
  .withWatermark("eventTime", "2 minutes")
  .groupBy(window($"eventTime", "1 minute"), $"province")
  .agg(sum("amount").as("gmv"))

// 3. 写:DataStreamWriter
val query = gmv.writeStream
  .outputMode("update")
  .foreachBatch(upsertMysql _)              // 幂等落库
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-1m")
  .trigger(Trigger.ProcessingTime("30 seconds"))
  .start()

// 4. 管:StreamingQuery
query.awaitTermination()
四段各两行到六行,但每一段都对应一个对象的完整职责。生产与 demo 的差距不在骨架而在细节:限流参数、watermark 取值、幂等写法、trigger 间隔——这些在前几篇案例里已经展开,本篇的骨架就是把它们装进去的容器。
七、总结
- API 面由五个对象构成:SparkSession(门)、DataStreamReader(读)、DataFrame(算)、DataStreamWriter(写)、StreamingQuery(管),流批一体的收益集中在 DataFrame 层;
- 读入四段式
readStream → format → option → load,schema 必须显式、option 因源而异; - 算子分三类:投影过滤完全一致、withWatermark/window 是流式增强、limit/distinct/多聚合链在流上没有定义——判断标准是"引擎要为它维护什么状态";
- 写出四个决定:模式、Sink、checkpoint(必配)、Trigger;四种 Trigger 里 Continuous 是 at-least-once 且有白名单限制,其余三种 exactly-once;
- StreamingQuery 的 stop 是优雅停止,id/runId 分工不同,lastProgress 是监控金矿;
- 最常见报错"checkpoint 冲突"的本质:checkpoint 绑定逻辑计划——改了查询就换目录,这是流式开发的肌肉记忆。