
Structured Streaming Sink 种类与案例:选错输出端,前面全白干
摘要:一条流计算得再对,写出去的那一步错了就全盘皆输。本文把 Structured Streaming 的输出端一次讲透:先用"支持模式 + 容错语义"两张底牌给六个 Sink 建坐标;再图解三种输出模式在聚合查询下的真实行为差异(append 的延迟输出、update 的持续更新、complete 的全量重写);然后逐个过案例——File sink 分区写湖、Kafka sink 回流投递、Console/Memory 调试双件套的正确用法、foreachBatch 万物皆可写的骨架与幂等三式(唯一索引 / MERGE 键 / batchId 事务);最后给出一张生产选型速查表。所有语义均经官方文档核验。
关键词:Structured Streaming, Spark, Sink, Output Mode, foreachBatch, foreach, 幂等写入, Kafka Sink, File Sink, Exactly-Once
一、先看两张底牌:模式支持 + 容错语义
评估一个 Sink 只需要问两个问题:支持哪些输出模式?容错语义是什么?
| Sink | 支持模式 | 容错 | 生产可用 | 典型场景 |
|---|---|---|---|---|
| File | 仅 append | ✅ checkpoint+原子写 | ✅ | 明细落湖、归档 |
| Kafka | 三种全支持 | at-least-once | ✅ | 结果回流 MQ |
| foreach | 三种全支持 | 取决于实现 | ⚠️ 简单场景 | 逐行写外部系统 |
| foreachBatch | 三种全支持 | at-least-once + 自建幂等 | ✅ 主力 | JDBC/Delta/多端分发 |
| Console | 三种全支持 | ❌ | 仅调试 | 本地开发 |
| Memory | append / complete | ❌ | 仅调试 | 单测断言 |
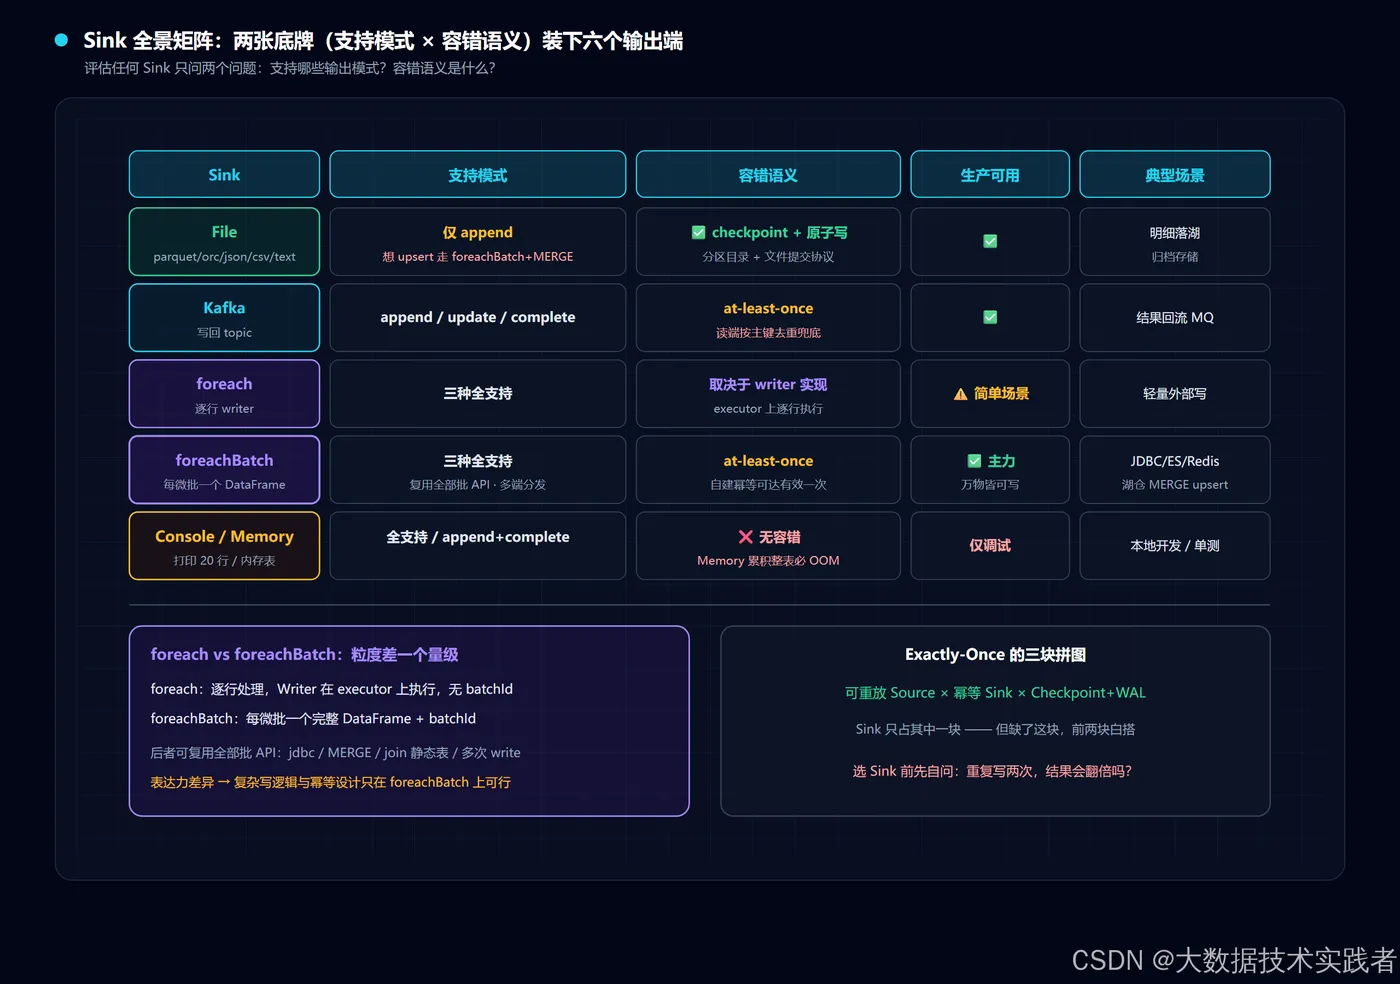
两个容易忽略的点:Memory sink 会把整张 Result Table 累积在内存里,跑久了必 OOM,官方定位就是调试;foreach 与 foreachBatch 的粒度完全不同——前者逐行(executor 上执行)、后者每微批一个完整 DataFrame(driver 侧拿到 batchId),后者能复用全部批 API,表达力差一个量级。
二、输出模式:同一个查询,三种行为
输出模式决定"每个 trigger 往 Sink 写什么",很多人栽在没分清这三种行为上:
append:只写"自上次 trigger 以来新追加到 Result Table 的行"。配聚合时有个关键约束——引擎必须确认"这行不会再变"才输出,所以窗口结果要等 watermark 越过窗口结束才落地(输出延迟 = watermark 延迟)。
update:写"自上次 trigger 以来发生变化的行"。窗口没关就持续输出中间结果,大屏场景(MySQL upsert)用它,因为业务要的是"现在累计多少"而不是"最终多少"。
complete:全量重写整个 Result Table。只适合小结果集(比如全局 TopN 状态不大时);且它不清理聚合状态,状态随 key 基数无限涨,配 watermark 也救不了。
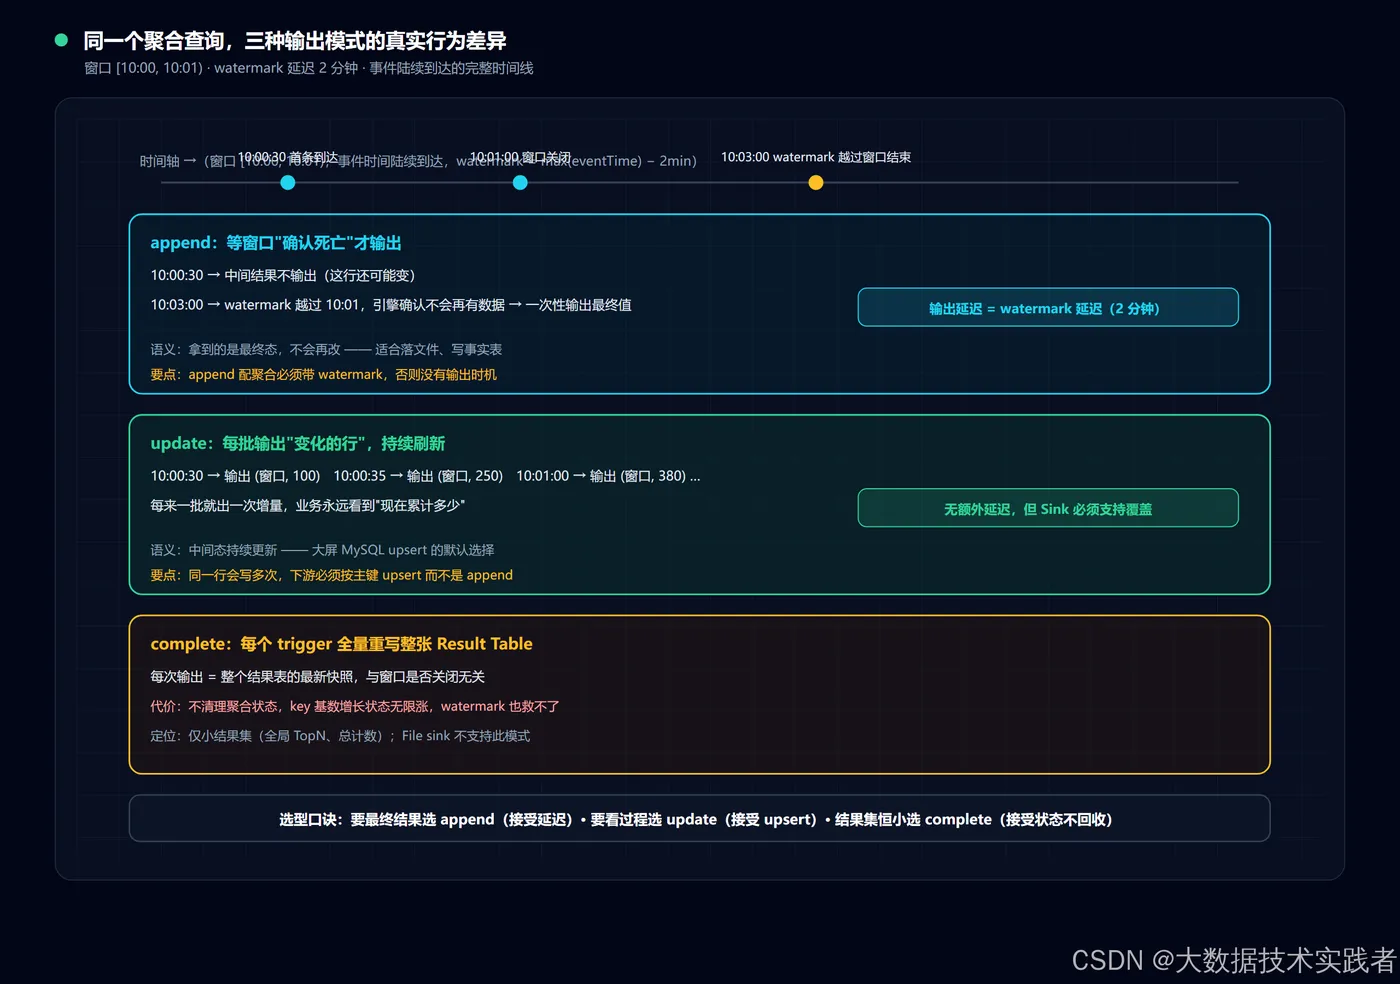
一句话选型:要最终结果选 append(接受延迟),要看过程选 update(接受 upsert 复杂度),结果集恒小选 complete(接受状态不回收)。
三、案例 A:File sink 落湖——只会 append 不是缺陷是设计
result.writeStream
  .outputMode("append")                    // ① File sink 唯一支持的模式
  .format("parquet")                       // ② 五种格式可选
  .option("path", "s3a://lake/gmv_1m")
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-sink")
  .partitionBy("dt", "province")           // ③ 分区写,下游查询裁剪
  .trigger(Trigger.ProcessingTime("5 minutes"))  // ④ 长 trigger 防小文件
  .start()
① 是硬约束:File sink 只支持 append,想 upsert 就换路(foreachBatch + MERGE)。③ 分区列的值直接变成目录结构,下游按 dt/province 裁剪扫描量。④ 是小文件问题的关键旋钮——trigger 越短文件越多,5 分钟一批配合下游定期 compaction 是常见稳态。
这个案例的典型翻车:trigger 设 10 秒,一天产出 8640 个小文件,Hive 元数据爆炸、查询 planning 变慢。修复路径就两步:拉长 trigger + 分区合并任务。
四、案例 B:Kafka sink 回流——at-least-once 的正确姿势
result.writeStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092")
  .option("topic", "gmv_result")           // ① topic 可选
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-kafka")
  .start()
// 写入前必须准备好两列:
// key   → 分区路由(可选)
// value → 消息体(必需,string/binary)
① topic 配置会覆盖数据中的 topic 列;不配置则数据里必须有 topic 列。必需列只有 value,key 不给就自动补 null。
语义上要有清醒认知:Kafka sink 是 at-least-once——broker 收到但 ack 丢失时 producer 重试会产生重复。官方给的解法是消费端按主键去重,而不是指望 sink 变聪明。所以回流场景的完整方案 = 写端配 checkpoint + 读端建去重表,两端配合才有"有效一次"。
五、案例 C:调试双件套——Console 与 Memory 的正确打开方式
// Console:每个微批打印约 20 行到 stdout,本地开发第一站
df.writeStream.format("console").option("truncate", "false").start()

// Memory:累积到内存表,可 spark.sql 直接查,适合单测断言
df.writeStream.format("memory").queryName("gmv_view").start()
spark.sql("SELECT * FROM gmv_view WHERE province = 'ZJ'")
两条纪律:不上生产(无容错,Memory 还会 OOM);跑完就 stop(query.awaitTermination() 换成 Thread.sleep(ms) + query.stop() 的调试节奏)。Memory 的正确用途是单元测试——写几批数据、SQL 断言结果、停查询,整个生命周期在测试方法内闭环。
六、案例 D:foreachBatch 万物皆可写——骨架与幂等三式
外部系统没有原生 sink 时(MySQL、ES、Redis……),foreachBatch 是唯一正解。骨架:
result.writeStream
  .outputMode("update")
  .foreachBatch { (batchDF: DataFrame, batchId: Long) =>
    writeMysql(batchDF)      // 端 1:大屏
    writeDelta(batchDF)      // 端 2:离线
    writeKafka(batchDF)      // 端 3:回流
  }
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-fb")
  .start()
前提必须内化:同 batchId 失败恢复时可能重执行(at-least-once)。三种幂等写法对应三类外部系统:
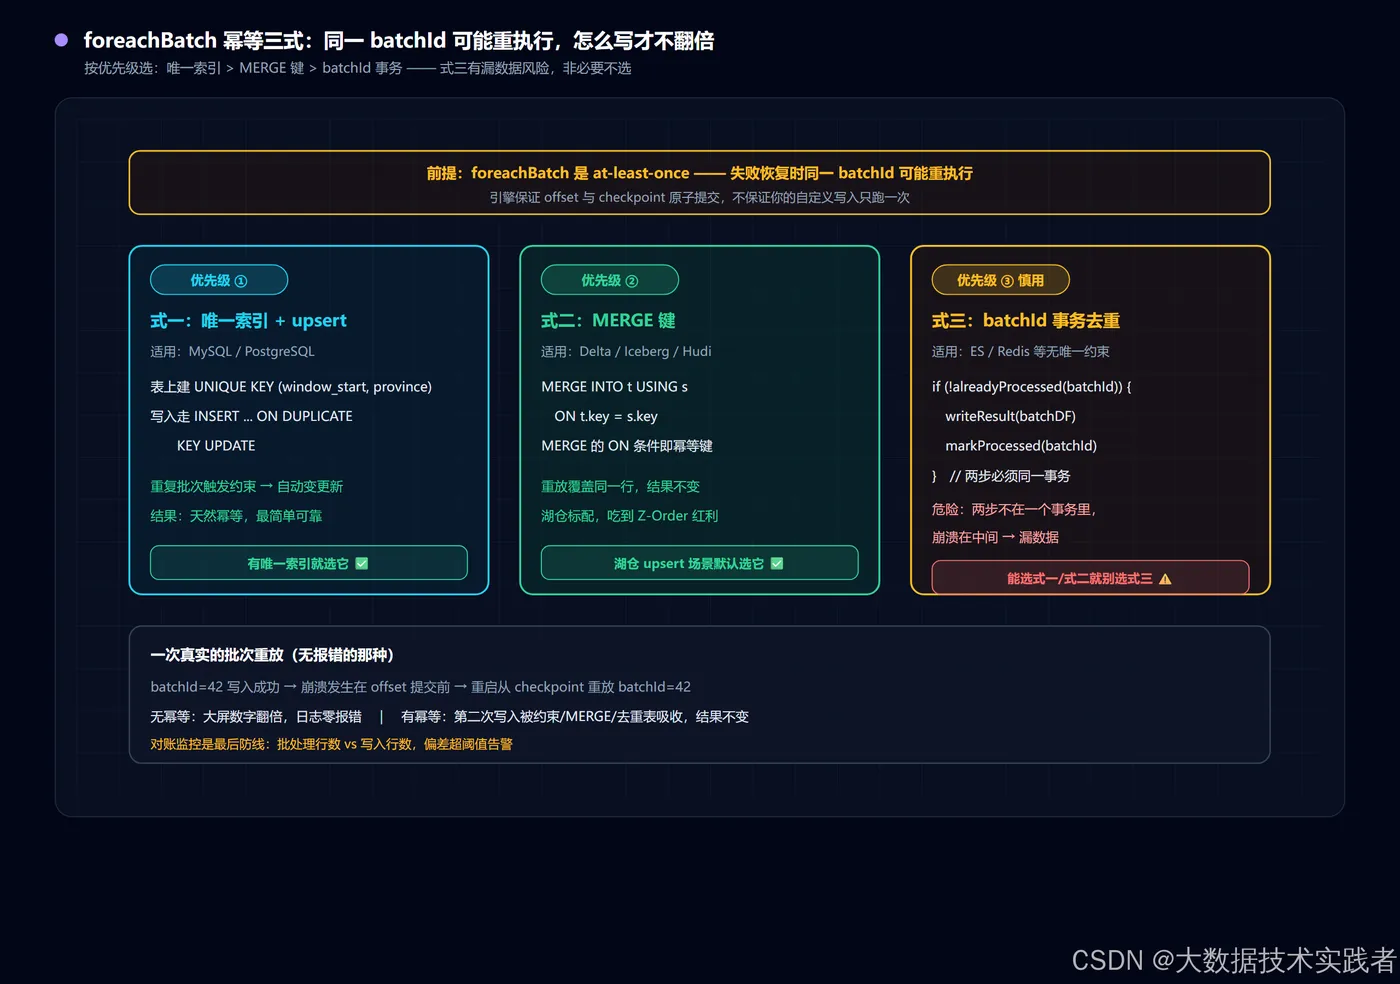
式一:唯一索引 + upsert(MySQL/PG)。表上 UNIQUE KEY (window_start, province),写入走 INSERT ... ON DUPLICATE KEY UPDATE,重复批次触发约束自动变更新。最简单可靠,有唯一索引就选它。
式二:MERGE 键(Delta/Iceberg/Hudi)。MERGE ON 的条件就是幂等键,重放覆盖同一行结果不变。湖仓场景标配,还能吃到 Z-Order/Compaction 红利。
式三:batchId 事务去重(无唯一约束的系统,如 ES/Redis)。先把 batchId 写入去重表(与业务写入同事务),重放时查表跳过:
if (!alreadyProcessed(batchId)) {
  writeResult(batchDF)
  markProcessed(batchId)     // 必须与上一行同一事务
}
式三最通用也最危险——两步不在一个事务里,崩溃在中间就会漏数据。能选式一/式二就别选式三。
七、生产选型速查
| 需求 | 推荐 | 关键动作 |
|---|---|---|
| 明细/结果落湖 | File sink | 分区写 + 长 trigger + 定期合并 |
| 结果回流 MQ | Kafka sink | 读端按主键去重 |
| 写 MySQL/ES/Redis | foreachBatch | 幂等三式按序选 |
| 湖仓 upsert | foreachBatch + MERGE | MERGE 条件即幂等键 |
| 大屏实时刷新 | update 模式 + foreachBatch | 唯一索引 + upsert |
| 本地调试 | Console / Memory | 跑完即停,不上生产 |
八、总结
- 评估 Sink 记两张底牌:支持模式 × 容错语义,六个 Sink 一张矩阵装下;
- 输出模式看行为差异:append 等窗口关(延迟换最终态)、update 出中间态(配 upsert sink)、complete 全量重写(仅小结果集);
- File sink 只会 append 是设计不是缺陷,小文件问题靠"长 trigger + 分区 + 合并"三件套;
- Kafka sink 天生 at-least-once,读端去重是方案的一部分而不是补丁;
- foreachBatch 是"万物皆可写"的主力,但同 batchId 可能重执行——幂等三式按优先级选:唯一索引 > MERGE 键 > batchId 事务,最后一式有漏数据风险,非必要不选;
- Exactly-once 从来不是 Sink 单方面给的:可重放源 × 幂等 Sink × checkpoint,三块都在才算数。
