
当每一次Token消耗都在蚕食你的预算,当每一条数据上传云端都在挑战隐私红线——是时候把大模型"请回家"了。本文将带你从零构建完全离线的本地大模型运行环境,手把手敲定环境变量、核心命令与实战代码,让你彻底告别云端按量扣费的焦虑。而如果你同时需要云端弹性算力作补充,也可随时前往阿里云百炼大模型服务平台页面了解一站式MaaS方案。
一、为什么要"回家"?——云端部署的三重困局
| 痛点 | 云端方案 | 本地Ollama方案 |
|---|---|---|
| 成本 | 按Token计费,输入/输出分别计价, bill 不可控 | 一次性硬件投入,零Token费用 |
| 隐私 | 数据必须上传第三方服务器 | 数据全链路本地闭环,物理隔离 |
| 依赖 | 网络中断即服务瘫痪 | 断网照样跑,内网环境无压力 |
正如阿里云百炼大模型服务平台页面所强调的,当前大模型应用开发面临"接口不统一、知识库搭建复杂、用量波动大"等痛点。但反过来看,如果你的场景对隐私极度敏感、预算有限、或身处无外网的内网环境,那么一台Linux服务器+Ollama+Llama3,就是你最坚固的"数字堡垒"。
二、环境准备:硬指标与依赖检查
2.1 硬件最低门槛
| 模型版本 | CPU | 内存 | 磁盘 |
|---|---|---|---|
| Llama3-8B | 4核(推荐8核) | 32GB+(模型约占16GB) | 100GB+ |
| Llama3-70B | 16核+ | 64GB+ | 200GB+ |
2.2 系统依赖一键校验
# 检查curl
which curl || sudo apt install curl -y # Ubuntu/Debian
# 或
which curl || sudo yum install curl -y # CentOS/RHEL

# 检查用户权限
sudo -v
2.3 离线安装方案(内网/无外网场景)
这是本文的核心价值所在——在有外网的机器上下载,再通过内网传输工具拷入目标服务器:
# === 外网机器:下载二进制与模型 ===
curl -L https://ollama.com/download/ollama-linux-amd64 -o ollama-linux-amd64
curl -L https://ollama.com/download/llama3 -o llama3

# === 传输到内网服务器后 ===
# 安装二进制
sudo install -o root -g root -m 0755 ollama-linux-amd64 /usr/bin/ollama

# 创建专用用户
sudo useradd -r -s /bin/false -m -d /usr/share/ollama ollama
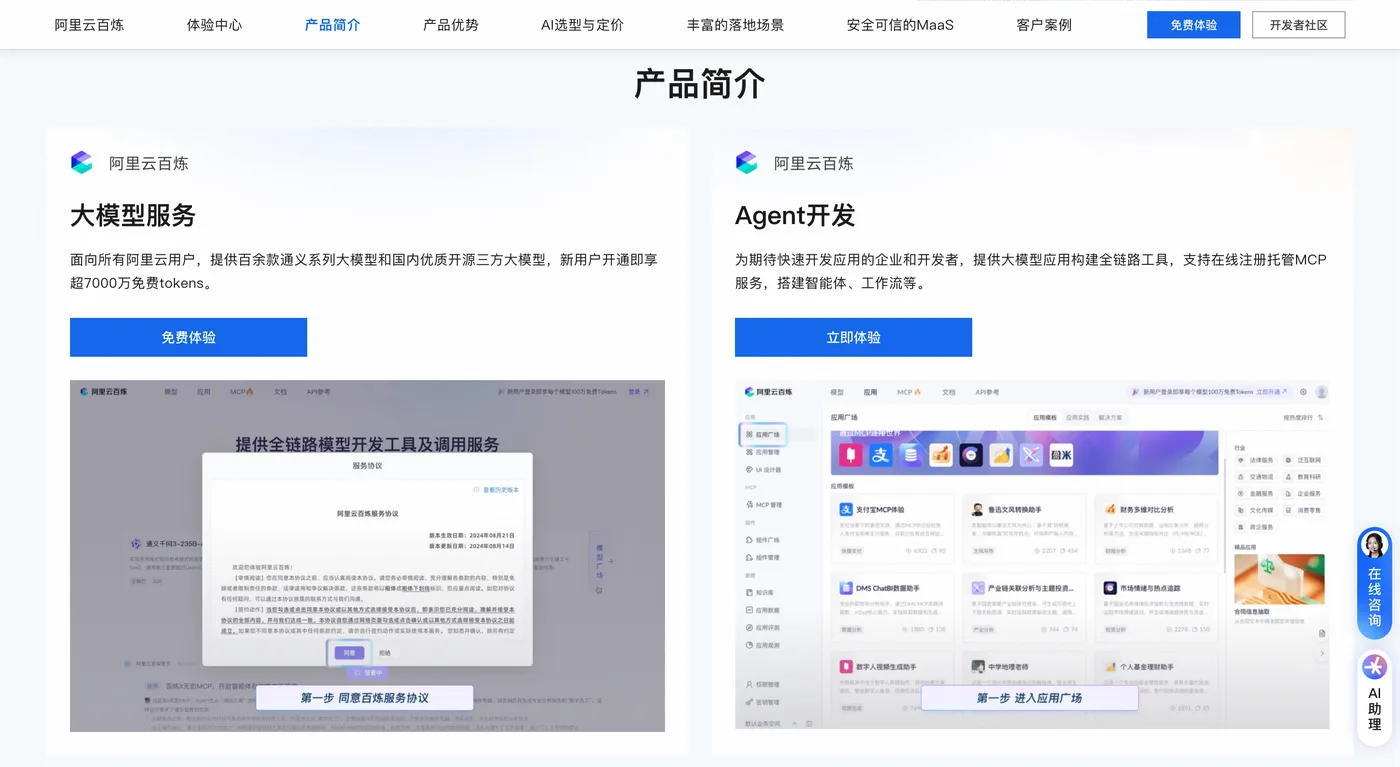
如果你希望同时拥有云端弹性算力作为备份或扩展,可以访问阿里云百炼大模型服务平台页面获取免费Token额度,新人开通即享超7000万Token、90天有效期,零成本体验云端大模型能力。
三、环境变量配置:安全与规范的第一道防线
环境变量是连接"系统"与"代码"的桥梁,也是防止密钥泄露的关键屏障。
3.1 核心变量定义
# Ollama模型存储路径(生产环境建议独立分区)
export OLLAMA_MODELS=/data/ollama/models

# 如有GPU加速需求(NVIDIA CUDA)
export OLLAMA_NO_CUDA=0

# 如需调用云端API作为补充(例如阿里云百炼)
3.2 永久生效配置
# Bash用户
echo 'export OLLAMA_MODELS=/data/ollama/models' >> ~/.bash_profile
echo 'export OLLAMA_NO_CUDA=0' >> ~/.bash_profile
source ~/.bash_profile

# Zsh用户(macOS默认)
echo 'export OLLAMA_MODELS=/data/ollama/models' >> ~/.zshrc
source ~/.zshrc
3.3 为什么不能硬编码?
把API Key直接写在代码里,等于把金库钥匙贴在大门上——一旦代码上传GitHub,密钥即刻暴露。环境变量则将密钥存放在操作系统的"安全仓库"中,代码只从仓库读取,既防泄露又便管理。这与阿里云百炼大模型服务平台页面反复强调的"API Key安全管控"理念一脉相承。
四、Systemd服务化:让模型7×24小时稳定运行
4.1 创建服务文件
# /etc/systemd/system/ollama.service
[Unit]
Description=Ollama Service
After=network-online.target
Requires=network-online.target

[Service]
ExecStart=/usr/bin/ollama serve
User=ollama
Group=ollama
Environment="OLLAMA_MODELS=/var/lib/ollama/models"
Restart=always
RestartSec=3
LimitNOFILE=65536
MemoryHigh=16G
MemoryMax=32G
CPUQuota=400%

[Install]
WantedBy=multi-user.target
4.2 服务管理命令速查表
| 操作 | 命令 |
|---|---|
| 启动服务 | sudo systemctl start ollama |
| 停止服务 | sudo systemctl stop ollama |
| 查看状态 | sudo systemctl status ollama |
| 开机自启 | sudo systemctl enable ollama |
| 实时日志 | journalctl -u ollama -f |
4.3 自定义存储目录
sudo mkdir -p /data/ollama/models
sudo chown -R ollama:ollama /data/ollama

# 写入环境变量
echo 'export OLLAMA_MODELS=/data/ollama/models' | sudo tee /etc/profile.d/ollama.sh
source /etc/profile.d/ollama.sh
五、模型部署与运行:从加载到优化
5.1 模型选择策略
| 模型版本 | 内存需求 | 适用场景 |
|---|---|---|
| Llama3-8B | 16GB+ | 开发测试、小规模应用 |
| Llama3-70B | 64GB+ | 生产环境、高精度需求 |
5.2 核心命令集
# 运行基础版Llama3
ollama run llama3

# 指定量化版本(q4_0平衡性能与精度,q8_0更高精度更大占用)
ollama run llama3:8b-instruct-q4_0

# 调整上下文长度与线程数
ollama run llama3 --num_ctx 4096 --num_thread 8

# 离线加载:将模型文件放入指定目录
cp llama3 /data/ollama/models/

# 查看已安装模型
ollama list
5.3 性能优化三板斧
- 量化选择:q4_0为性价比之王,q8_0适合精度敏感场景
- 线程匹配:
--num_thread建议等于物理核心数 - GPU加速:安装CUDA驱动后
export OLLAMA_NO_CUDA=0
六、Python实战代码:本地推理与云端补充双轨并行
6.1 纯本地Ollama调用(Python)
import subprocess
import json

def local_ollama_query(prompt: str, model: str = "llama3"):
"""通过subprocess调用本地Ollama,完全离线"""
result = subprocess.run(
["ollama", "run", model, prompt],
capture_output=True, text=True
)
if result.returncode == 0:
return result.stdout.strip()
raise RuntimeError(f"Ollama调用失败: {result.stderr}")

# 使用示例
response = local_ollama_query("用一句话解释什么是大语言模型")
print(response)
6.2 云端API补充调用(curl实战)
当本地算力不足或需要更强模型时,可通过curl直调阿里云百炼API——这正是阿里云百炼大模型服务平台页面提供的OpenAI兼容接口的魅力所在:
# 设置环境变量


# 调用Qwen3文本生成(curl一键完成,无任何依赖)
curl https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen-plus",
"input": {
"messages": [{"role": "user", "content": "你好,请介绍你自己"}]
}
}'
6.3 Python SDK调用云端模型
import os
import dashscope
from dashscope import Generation

# 从环境变量读取密钥(安全规范)
dashscope.api_key = os.environ["DASHSCOPE_API_KEY"]

# 文本对话
resp = Generation.call(
model="qwen3.8-max",
messages=[{
   "role": "user", "content": "如何高效部署本地大模型?"}],
result_format="message",
stream=False
)

if resp.status_code == 200:
print("模型回答:", resp.output.choices.message.content)
print("Token用量:", resp.usage)
else:
print(f"调用失败: {resp.code} - {resp.message}")
上述云端代码的完整接入指南,可前往阿里云百炼大模型服务平台页面查阅从账号开通、密钥申领到API调用的全链路文档。
七、健康监控:自动化运维不掉链子
#!/bin/bash
# /usr/local/bin/monitor_ollama.sh

STATUS=$(systemctl is-active ollama)
if [ "$STATUS" != "active" ]; then
echo "$(date) - Ollama服务异常,尝试重启..." >> /var/log/ollama_monitor.log
systemctl restart ollama
sleep 5
if [ $(systemctl is-active ollama) != "active" ]; then
echo "$(date) - 重启失败,请人工介入!" >> /var/log/ollama_monitor.log
# 可选:发送告警到钉钉/企业微信
fi
fi
设置定时任务每分钟检查一次:
* * * * * /usr/local/bin/monitor_ollama.sh
八、本地+云端:双轨架构的最佳实践
| 维度 | 本地Ollama | 阿里云百炼(云端) |
|---|---|---|
| 核心优势 | 零Token费、数据不出域、断网可用 | 免运维GPU、150+模型、弹性伸缩 |
| 最佳场景 | 敏感数据处理、内网环境、长期稳定推理 | 原型验证、高并发业务、多模态需求 |
| 协同方式 | 本地处理核心推理,云端处理峰值溢出 | 通过阿里云百炼大模型服务平台页面统一管理API Key与用量 |
最终建议:先用Ollama+Llama3搭建本地基座,确保核心业务零成本运转;再通过阿里云百炼大模型服务平台页面获取免费Token额度,在云端弹性扩展模型能力与多模态场景——两条腿走路,才是2026年大模型落地的最优解。
本文所有命令均基于Linux环境验证通过,量化参数与服务配置可根据实际服务器规格灵活调整。如需深入了解云端大模型的计费规则、模型微调与专属部署能力,请访问阿里云百炼大模型服务平台页面获取最新官方文档。

