
亿级向量的成本压力,为什么先落在内存上
全内存索引适合追求极致查询性能的业务。原文使用 BioASQ 10M、Cohere 768D 10M 数据集,展示了性能型实例 AUTO INDEX 在 TopK=10 和 TopK=100 下的表现,并给出了以每月 1,000 美元为基准的对比。它说明,选择索引时需要同时比较吞吐、召回率与预算。
数据从千万条增长到亿级,内存需求会随数据和索引规模增加。内存在系统成本中占比较高,如果继续按全内存方式扩容,预算往往也要随之提高。原文以十倍数据增长说明这种压力,实际账单仍取决于向量维度、量化方式、索引结构和实例配置。
磁盘索引把主要数据放到 SSD,再用内存承载检索需要的紧凑表示和结构,从而减少对大容量内存的依赖。DiskANN 便是这一路线的代表。阿里云 Milvus 在容量型集群、容量型单机实例的 AUTO INDEX 中提供了 EAGLE 的相关优化,让亿级向量能够在容量型资源配置上获得更好的检索效率。
第一笔账,包月价格比参测竞品低约25%~76%
原文的 Laion 100M 测试使用 1 亿条向量。阿里云方案选择单机容量型 32CU 实例,计算费用目录价为 6,752 元/月。下面这张图给出了它与五款商业化竞品参测配置的价格对比。
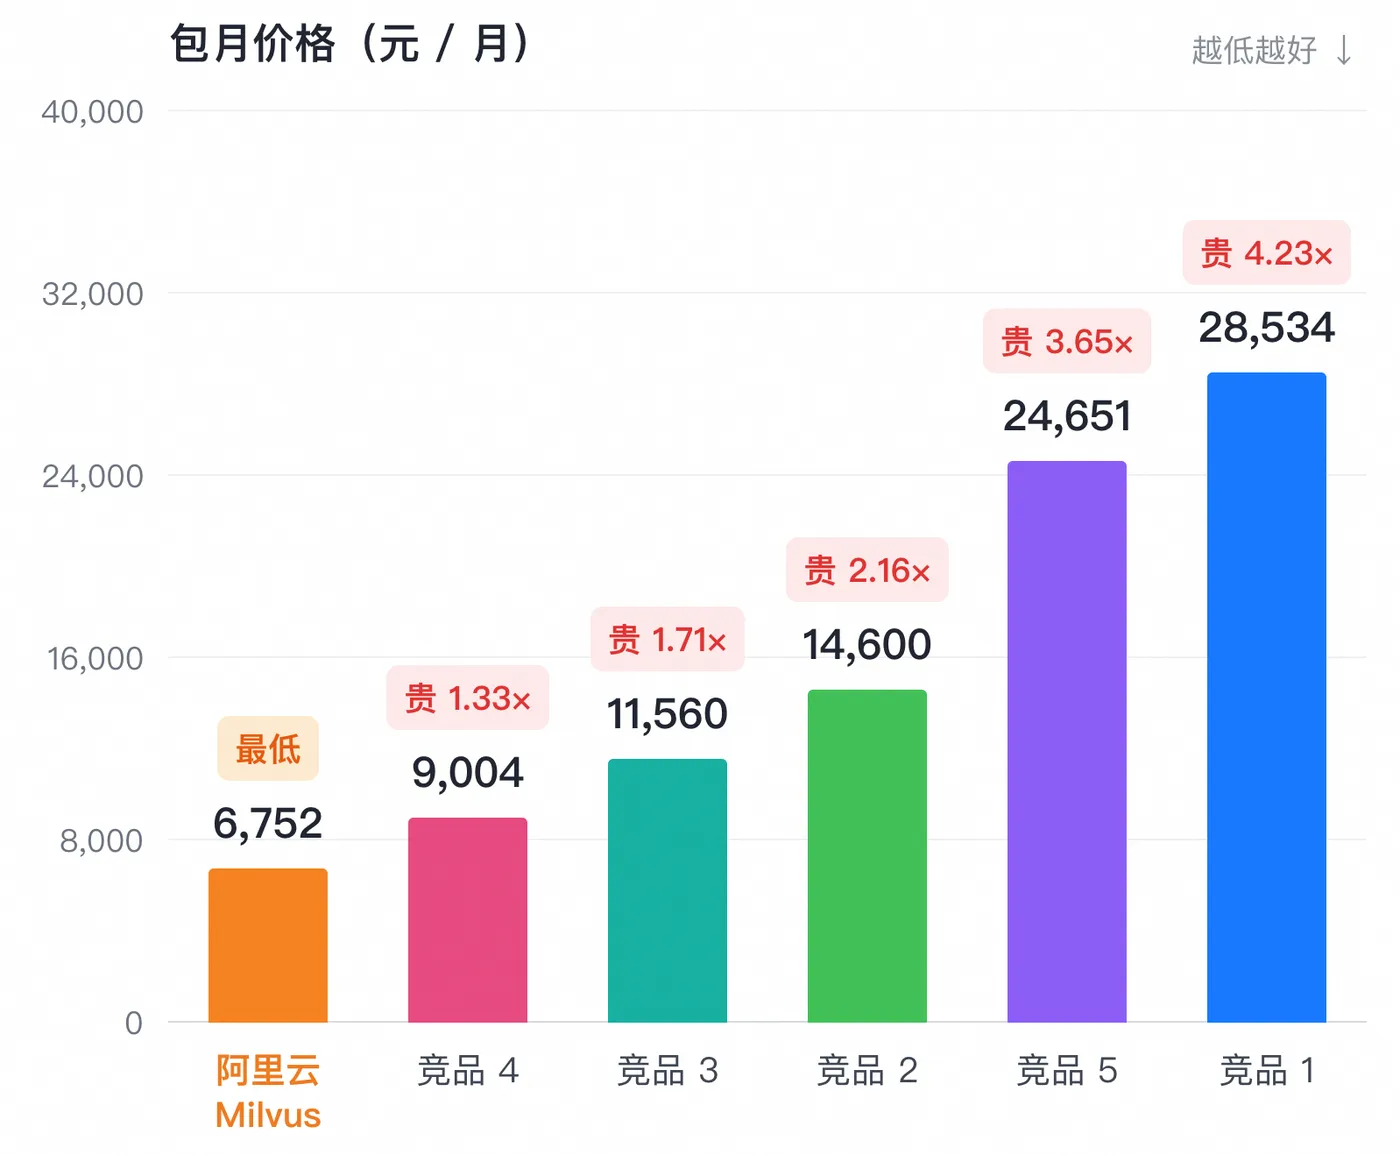
图1 原文包月价格对比,单位为元/月。竞品名称沿用原文匿名编号。
参测方案 |
图示包月价格(元/月) |
价格约为阿里云方案的倍数 |
选择阿里云方案每月少支出(元) |
相对该竞品节省比例 |
阿里云 Milvus |
6,752 |
1.00 |
0 |
基准 |
竞品4 |
9,004 |
1.33 |
2,252 |
25.0% |
竞品3 |
11,560 |
1.71 |
4,808 |
41.6% |
竞品2 |
14,600 |
2.16 |
7,848 |
53.8% |
竞品5 |
24,651 |
3.65 |
17,899 |
72.6% |
竞品1 |
28,534 |
4.23 |
21,782 |
76.3% |
即使与图中价格最接近的竞品4相比,阿里云方案每月也少支出 2,252 元,约低 25%。与竞品1相比,每月差额为 21,782 元,约低 76.3%。若把这份月费差额按 12 个月作简单预算折算,差额分别约为 2.7 万元和 26.1 万元;这里未计入年付折扣和价格变化。
这些差额对应图中参测配置的价格。它们能用于理解本次测试的预算差异,不能直接替代所有生产规格、地域或采购方式下的报价。
第二笔账,每万元月成本可得QPS最高约为竞品34倍
单看月费,还无法判断一套检索系统值不值得买。月费更低,如果吞吐也更低,业务仍然可能需要购买更多资源。把月费和吞吐放在一起,才能看到同一份预算实际支撑的查询能力。
原文采用的指标为每万元月成本可得 QPS,计算方式为 QPS ÷ 月成本(元)× 10,000。数值越高,表示单位预算对应的查询吞吐越高。
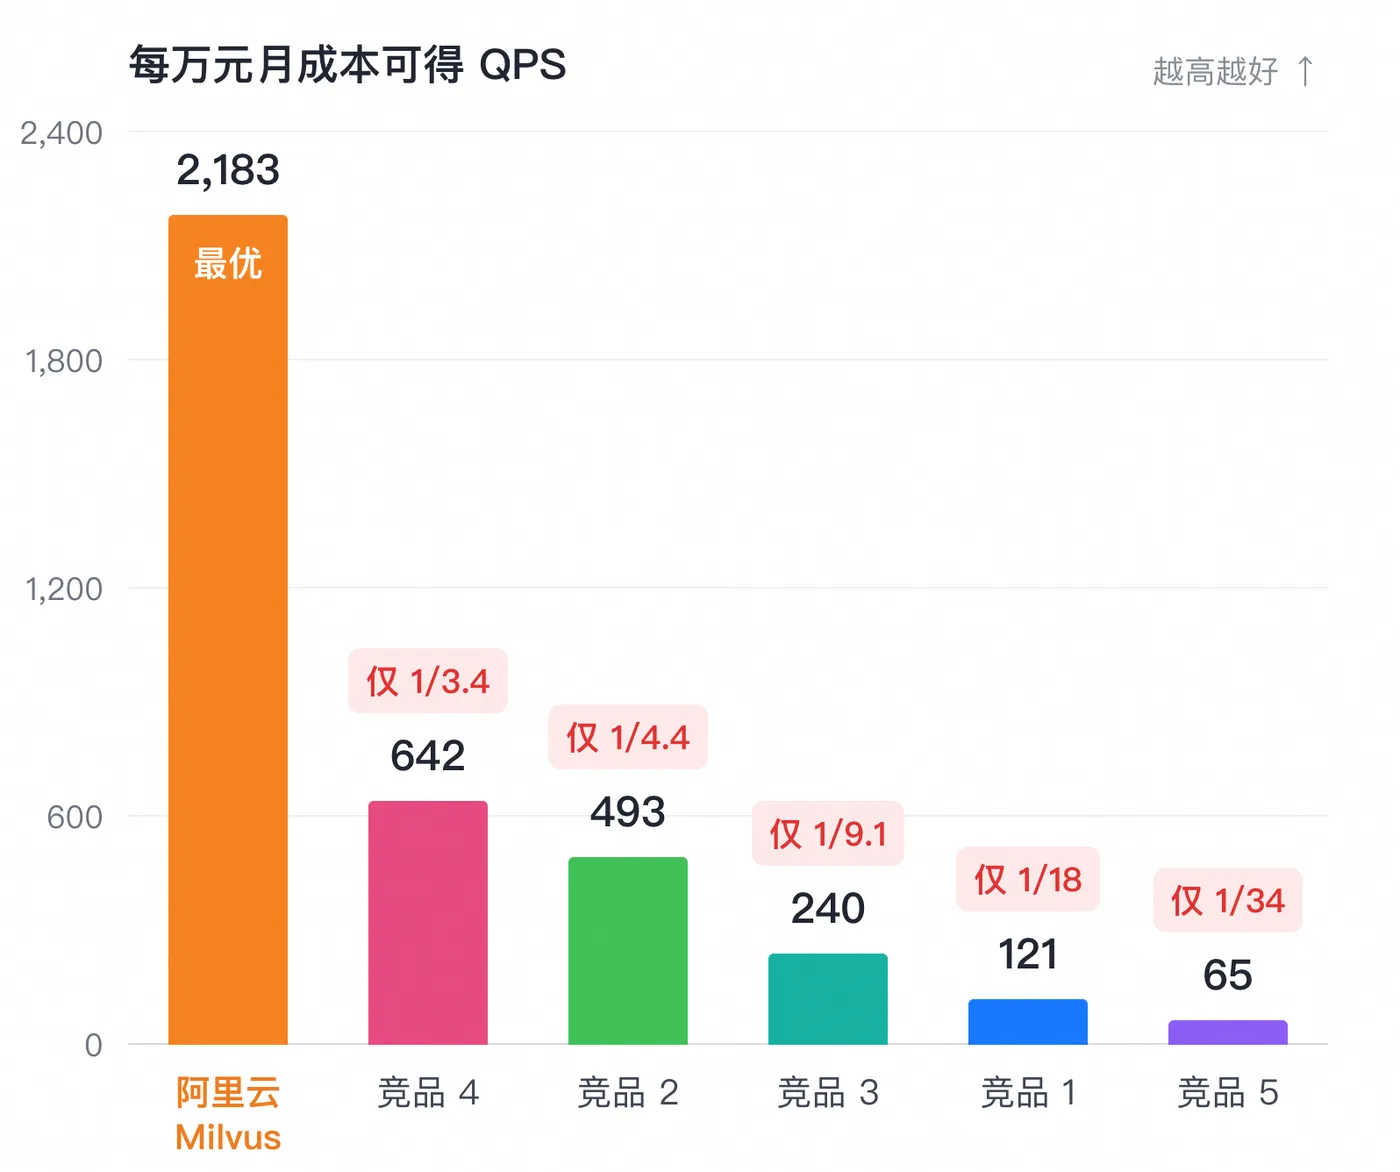
图2 原文每万元月成本可得 QPS 对比。它是按月成本归一化的吞吐指标,并非购买任意金额资源后的线性扩容承诺。
参测方案 |
图示每万元月成本可得 QPS |
阿里云方案约为该方案的倍数 |
阿里云 Milvus |
2,183 |
1.0 |
竞品4 |
642 |
3.4 |
竞品2 |
493 |
4.4 |
竞品3 |
240 |
9.1 |
竞品1 |
121 |
18.0 |
竞品5 |
65 |
33.6,约34 |
阿里云 Milvus 的单位预算吞吐,与图中最接近的竞品4相比约为 3.4 倍,与竞品5相比约为 34 倍。这里的“最高约34倍”,具体指本次测试中每万元月成本可得 QPS 的比值。
这项优势来自价格和吞吐两端。Laion 100M、TopK=100 测试中,阿里云 Milvus 的实际吞吐为 1,474.5 QPS,五款竞品约为 159.0~720.1 QPS。阿里云方案以更低的图示月费获得了更高的吞吐,两项因素共同拉大了性价比差距。
原图对归一化数值作了取整,本文沿用图示数字,倍数取近似值。每万元月成本可得 QPS 也不等同于每万次请求费用,后者还取决于实际请求量、资源利用率和完整账单。
EAGLE怎样把磁盘索引做得更省、更快
磁盘索引的资源优势,需要查询效率来支撑。EAGLE 将 DiskANN 与 RaBitQ 量化结合,并优化图结构的布局,从内存占用和磁盘访问两方面减少查询开销。
量化让内存里的向量表示更紧凑。EAGLE 使用 1 bit、4 bit 等量化方式;以 FP32 的每维 32 bit 为参照,1 bit 编码的向量表示体积可压到约 1/32,4 bit 编码则约为 1/8。这是向量表示本身的理论体积比例,整台实例还需要索引、缓存及其他运行内存。
图结构布局优化则改善磁盘访问的局部性,让原本分散的随机读尽量集中为更连续的读取。一次检索需要等待的磁盘访问减少,SSD 的性能也就更容易转化成有效吞吐。
原文引用了此前磁盘索引优化相对开源实现的结果,吞吐提升 20 倍以上,P99 延迟降至原来的 1/10 以下,QueryNode 内存进一步减少 29%,召回率保持在 98% 以上。这组数据说明了内核优化的收益,比较对象是开源实现;前面“约3.4~34倍”的比较对象则是商业化参测竞品,两组结果属于不同测试口径。
对成本而言,紧凑的向量表示可以减轻内存需求,磁盘访问优化可以提高单套资源的查询吞吐。具体能缩减多少生产资源,仍应按业务的延迟、召回率和峰值负载验证。
原文还强调,EAGLE 在兼容 Milvus 开源生态的基础上优化。已有 Milvus 用户可以围绕熟悉的生态评估容量型方案,减少改用另一套技术体系所需的适配工作;原文未提供迁移与适配成本的量化结果。
低成本也要守住召回率,百万TopK同样有价值
性价比需要建立在检索质量之上。在原文 Laion 100M、TopK=100 测试中,阿里云 Milvus 的召回率为 98.56%,高于五款参测竞品的约 94.48%~97.27%。这份结果同时给出了较低月费、较高吞吐和较高召回率。
大 TopK 则关系到另一类任务。提取训练集、测试集等场景,一次需要返回的结果可能达到百万级。原文在 TopK=1,000,000 时,阿里云 Milvus 的召回率为 97.53%,P99 为 3.53 秒;两款可完成测试的竞品,召回率分别为 96.16% 和 91.01%,P99 分别为 4.92 秒和 3.59 秒。
相对其中一款竞品,阿里云方案的召回率高 6.52 个百分点。在百万条目标近邻的口径下,相当于约多找回 6.52 万条结果;相对两款竞品,P99 延迟最高低约 28%。其余参测竞品未能在该 TopK 下完成查询。
原文说明,大 TopK 优化通过 collection 属性开关开启,无需重建索引、无需重新加载,也不影响小 TopK 性能。对于同时承担在线查询和大批量结果提取的业务,这减少了切换检索方式时的索引重建与加载工作。原文没有量化这部分运维费用,不能据此再叠加一个成本降幅。
怎样判断这份性价比是否适合自己的业务
原文使用开源基准工具 Zilliz VectorDBBench。阅读这些数字时,需要保留它们的测试条件。常规 TopK=100 的 QPS 使用 80 并发;P99 串行延迟在 1 连接、单线程条件下独立测量,阿里云结果为 9.6 毫秒,不能把它与 1,474.5 QPS 当成同一并发运行同时取得的成绩。原图还注明,竞品3的 QPS 来自充分预热状态,其冷启动首次查询耗时为 17.6 秒。
评估自己的业务时,可以沿用原文提出的检查方法。
- 用暴力检索得到的真实近邻计算召回率,避免用近似答案自我验证。
- 同一阶段的召回率、QPS、参数与并发保持一致;独立测量的延迟单独标注。
- 对齐数据集、维度、TopK、索引类型、搜索参数、引擎版本、实例规格及副本数。
- 在不同规模与负载下复测,并记录缓存命中、预热和冷启动条件。
- 将计算、存储及其他适用费用放进完整预算,再判断满足业务要求的资源配置。
在本文引用的亿级向量测试里,EAGLE 磁盘索引已经展示了清楚的预算优势。阿里云还在原文中预告了面向十亿级以上向量的分层存储型集群路线。这属于后续规划,本文的 6,752 元/月和最高约 34 倍结论,均来自已经展示的容量型实例测试。
最后
向量检索"能用就行"的时代结束了,接下来的竞争,是在召回率不退让的前提下,把性能和成本同时逼到极限。而在比谁更强之前,要理解向量检索的三角形:吞吐、召回率、成本。当我们把框架和算法优化到极致的情况下,在向量检索三角形上结合自己的业务选择最合适的产品,才是明智之举。
内存装得下的时候最快,内存装不下的时候还是最快,这是阿里云 Milvus Eagle 1.0 内核交出的答案,我们把它放在这里,也把尺子放在这里,欢迎大家来实测重现。

