AI会写更多代码后,测试工程师要把价值放在哪里?

简介: 本文探讨AI时代测试工程师的核心价值迁移:从执行脚本转向定义成功标准、识别同源错误、评估发布风险与构建独立证据。能力重心转向指挥Agent、批判性审查输出、坚守技术判断,而非比拼提示词数量。

image.png

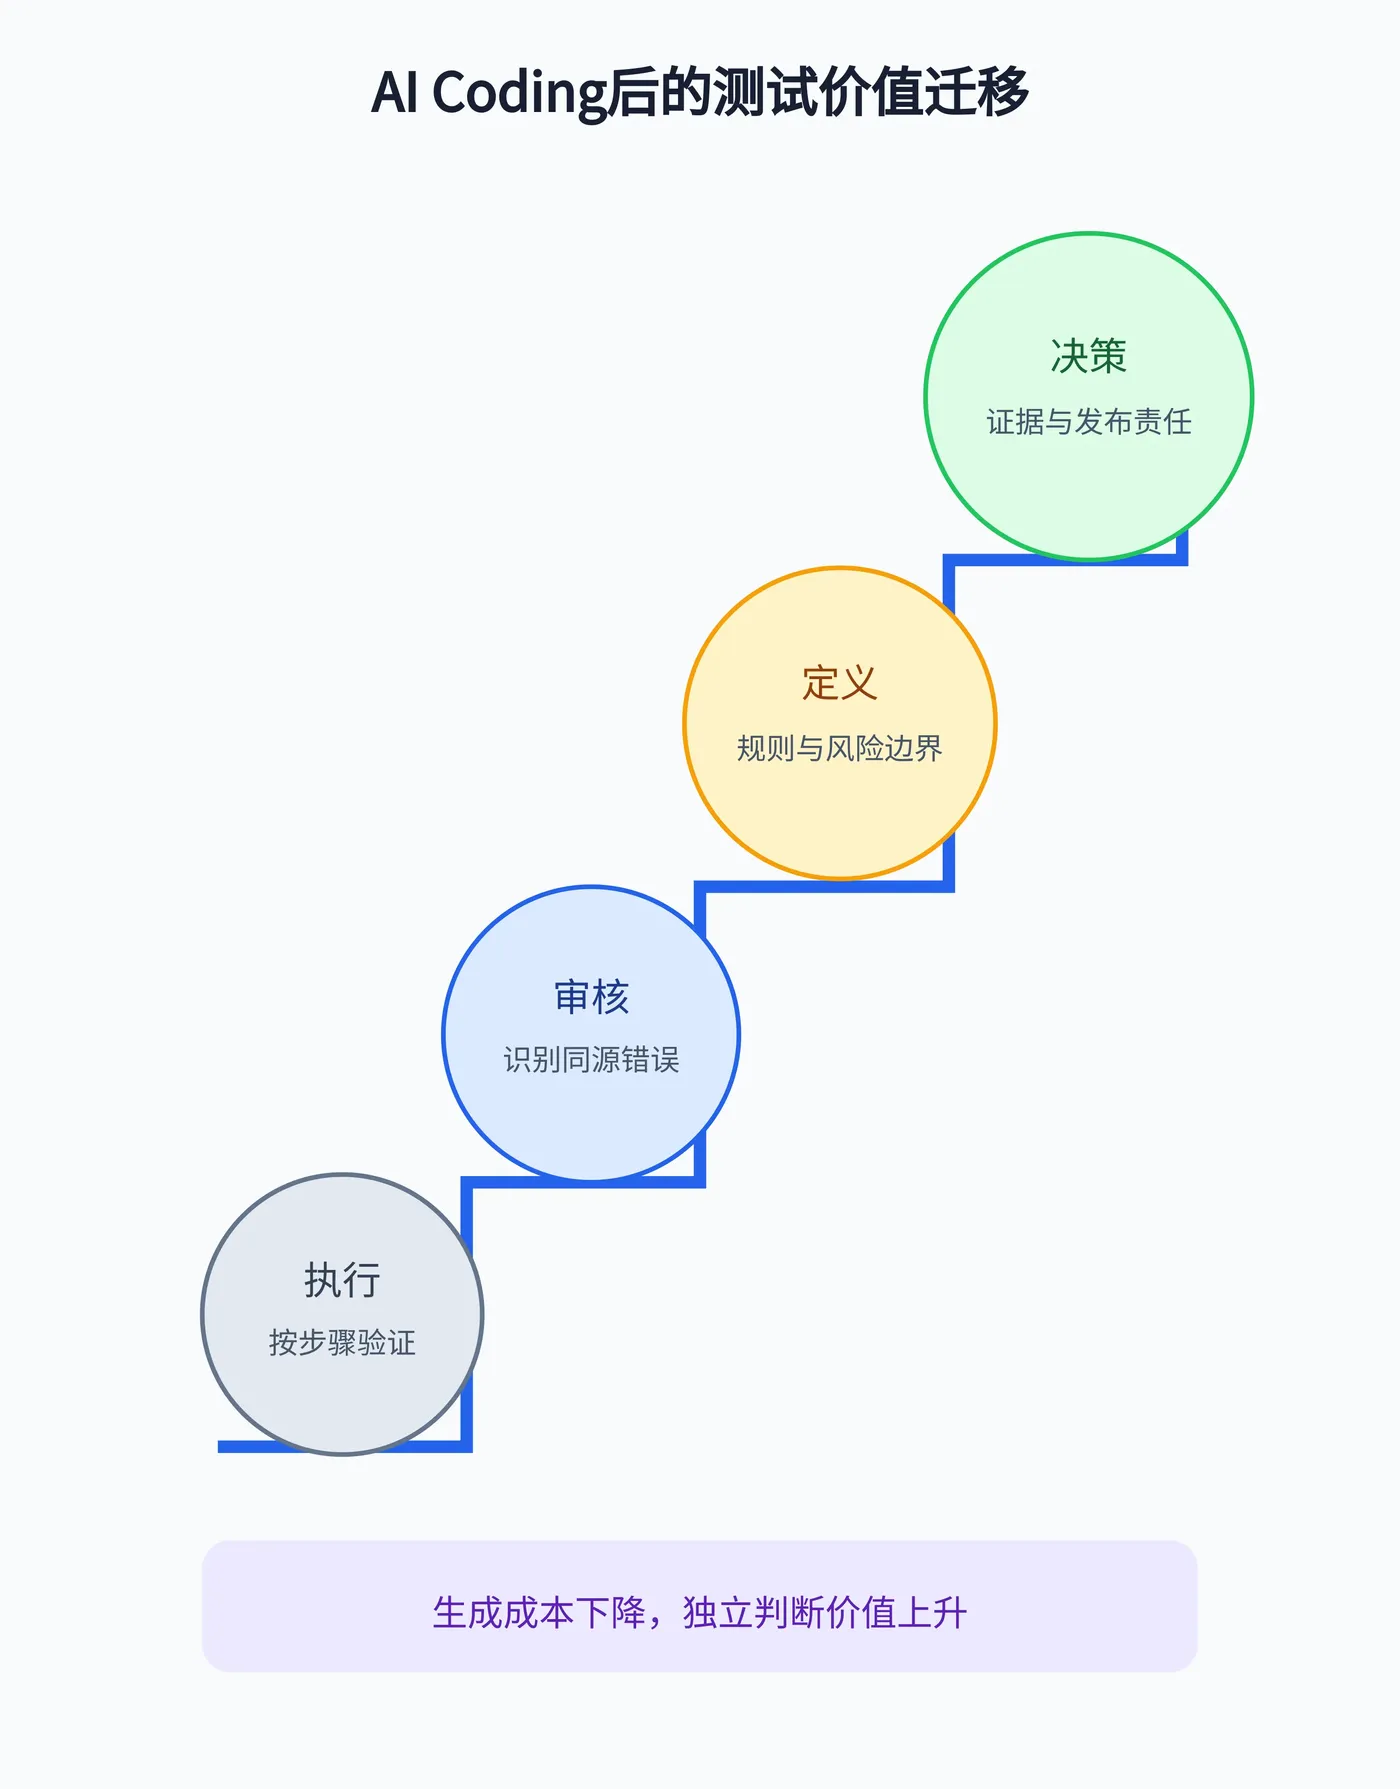
摘要:GitHub在2026年10月讨论开发者职业变化时,把能力重点放在指挥Agent、批判性审查输出和保持技术判断。对测试岗位而言,这并不是“学会更多提示词”,而是从执行既定步骤,迁移到定义成功、识别同源错误、解释发布风险和建立独立证据。

一个需求交给Coding Agent后,代码、单测、接口文档和变更说明可以一起生成。交付物更多了,测试工作却没有自动变轻:如果这些内容都来自同一份错误理解,它们会彼此印证。代码符合单测,文档符合实现,流水线一路通过,但业务规则从一开始就被解释错了。

GitHub在2026年10月2日的官方文章中提出三项开发者能力:指挥AI Agent、批判性审查第一版输出、用节省的实现时间解决更大的问题。文章讨论的是开发者职业,并非专门预测测试岗位。本文据此推断:测试工程师的稀缺价值会从重复执行,向独立定义与判断迁移。

会被压缩的是“按现成答案检查”

固定步骤录入、常规接口脚本、样板数据和基础报告,都会被Agent更快完成。继续把竞争力放在“我能比AI多写多少条脚本”上,边际价值会越来越低。真正难替代的,是没有现成答案时判断什么不能错。

需求里的“新用户”“及时退款”“合理推荐”都不是天然可执行的断言。测试要追问口径、状态、责任和例外,把模糊承诺转成可验证标准。这一步位于代码之前,也决定后续自动生成的用例是否有意义。

会被放大的是四类工作

第一,风险定义:指出资金、权限、隐私和责任边界。第二,独立证据:不让生成代码的同一个Agent同时决定验收标准。第三,系统判断:把模型、工具、数据、流程和人放在一起看。第四,发布解释:向业务说明为什么不能上线,以及还缺哪条证据。

旧重心 AI可加速 人要上移到
编写常规用例 生成边界样本 定义风险模型
执行回归 自动运行与聚类 判断失败是否可接受
输出报告 自动汇总 解释证据与责任
查接口结果 自动比对 验证跨系统业务后果

image.png

一条现实的学习路线

初级工程师先学会读Trace和工具调用,能解释Agent为什么得到结果;中级工程师练习把业务规则写成状态机、契约与评测Rubric;高级工程师建立风险分层、发布门禁和跨团队责任机制。代码能力仍重要,但它服务于证据,而不是为了证明“我也会调模型”。

每周可以选一个真实需求做逆向练习:不先写用例,先写成功定义、禁止动作、关键证据和未知项;再让AI生成实现与测试,检查它们是否共享了同一假设。把发现的同源错误整理成团队规则,比收集几十个提示词更有长期价值。

同源共错怎样在日常工作里出现

产品写一句“老用户可领取回归券”,Coding Agent把老用户解释成注册超过30天,又基于同一解释生成代码和单测。开发Review看到测试通过,测试如果只补接口自动化,仍然沿用30天口径。真正的缺口不是覆盖率,而是没有独立问清“老用户”的业务定义。

避免同源共错,不等于所有内容都由人手写。可以让不同Agent分别生成实现和反例,但验收标准必须来自受保护的业务规则、历史事实或责任人确认。测试人员要保存需求版本、规则来源和变更理由,使模型无法在修改实现时顺便改掉标准。
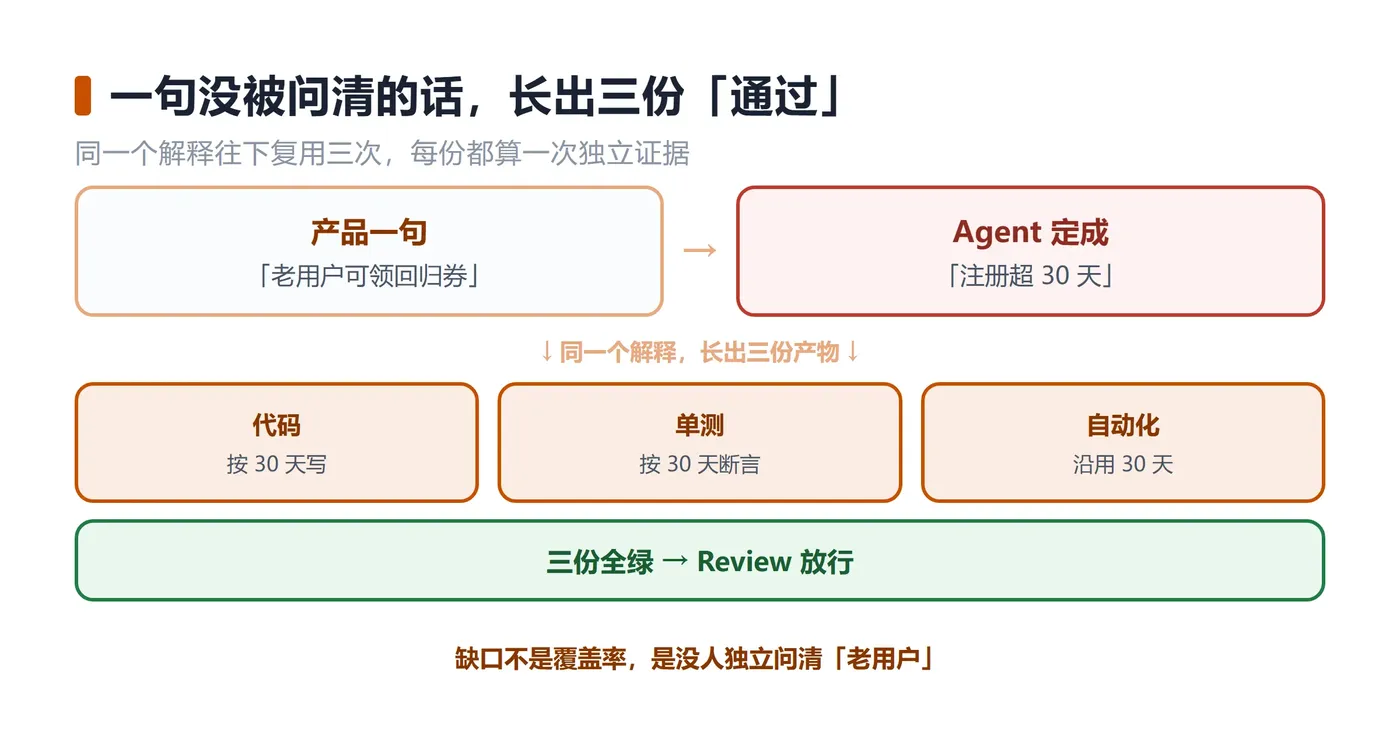
image.png

一条简单实践是“先写不可协商项”:资金上限、权限范围、状态转换、用户确认和审计字段。这些规则进入契约与门禁;表达方式、实现路径和辅助测试可以让AI发挥。自由与约束分开后,团队不会因为担心模型而拒绝自动化,也不会因为追求速度放弃底线。

测试管理者要重新分配工作

如果团队仍按“谁写用例多、谁执行快”评价成员,大家会把AI用于扩大数量,却没人负责评测集质量和风险定义。管理者可以把任务拆为四个Owner:业务标准、自动执行、独立评测、生产反馈。小团队允许一人兼任,但同一次变更至少要有独立复核。
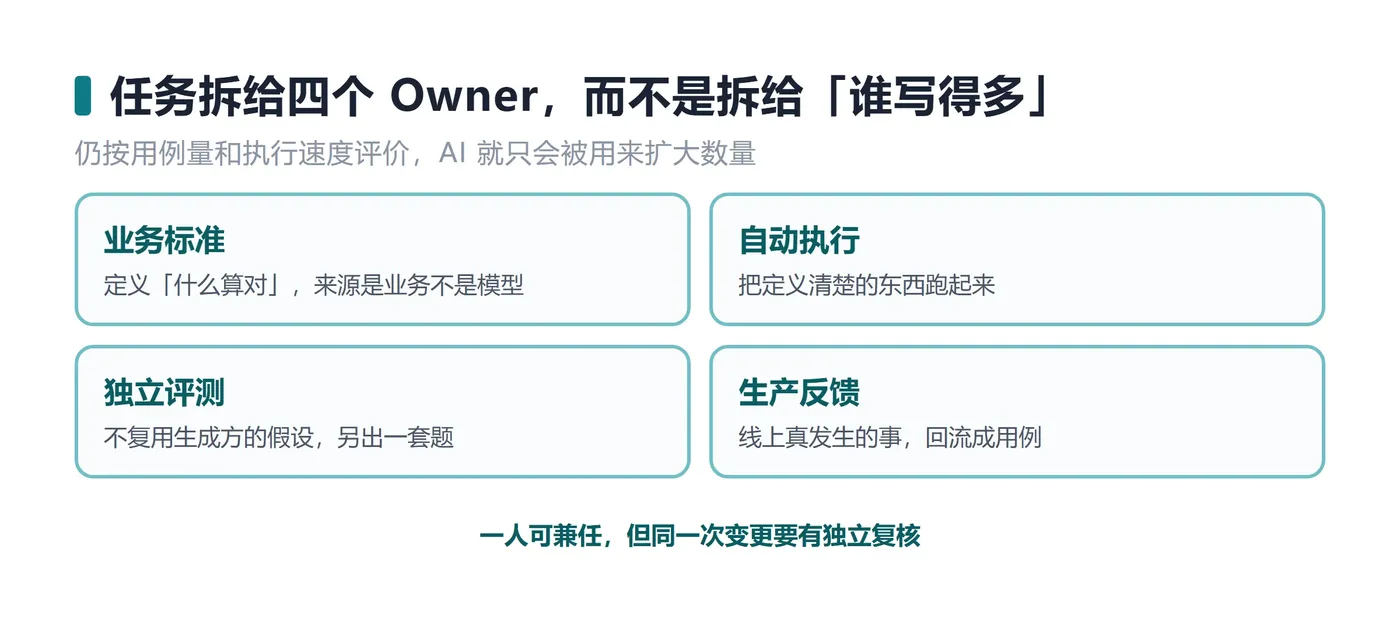
image.png

评审会上也要换问题。不要只问“覆盖率多少”,还应问:哪些标准来自业务而不是生成模型;这次变更增加了什么不确定性;最坏后果是什么;哪条证据支持放行;未知项由谁接受。能持续回答这些问题的人,职业价值不会被一次工具升级轻易替代。

未来半年可以观察什么

第一,看Coding Agent是否开始稳定生成跨仓库改动,而不只是单文件补丁;第二,看企业是否把Agent权限、Trace和评测纳入统一治理;第三,看招聘要求是否从“会某个框架”转向“能定义和验证业务结果”;第四,看团队绩效是否承认风险发现与标准建设。

这些信号比某个模型榜单更能说明岗位变化。榜单提升证明能力上限,组织流程变化才决定日常工作如何重排。

需要保留的反方边界是:并非所有执行工作都会消失,复杂环境搭建、可复现测试和高质量自动化仍需要工程能力;技术判断也不能只靠资历。变化的是价值排序——当生成成本下降,独立验收标准和风险解释更贵。

测试工程师不必和AI比赛谁写得快。更值得争取的位置,是当团队有十份自动生成的“通过证据”时,能够指出它们是否来自同一个错误前提,并定义还需要什么才能真正放行。

本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

相关文章
|
10天前
|
SQL 人工智能 自然语言处理
淘宝 AI 购物助手:基于 LLM-as-a-Judge 的在线评测与质量归因实践
淘宝技术为AI购物助手构建了基于LLM-as-a-Judge的在线自动评测体系,通过生产会话清洗、分布式批量推理、六层Rubric标准及人工校准,实现购后服务多业务域的日级质量监控,支撑AI Agent持续可信演进。
淘宝 AI 购物助手:基于 LLM-as-a-Judge 的在线评测与质量归因实践
|
23天前
|
运维 监控 安全
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
智能体上线评审常陷“五人五义”困局。全国首个五级智能体评测证书揭示破局关键:将主观判断拆为功能性、稳定性、安全、工程化、场景适配五大可证维度,每维设独立判据与证据链,推动验收从经验走向可审计、可复现、可追责。(239字)
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
|
1月前
|
自然语言处理 安全 测试技术
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
本文揭示RAG客服应用因缺乏Prompt注入防护而致系统提示词泄露的事故,指出问题根源在于测试只关注“答得对”,却忽视“会不会答不该答的”。提出将注入测试升级为可回归的红队用例集:结构化存于jsonl,覆盖四类注入;用pytest参数化断言输出、工具调用与拒答行为;接入CI自动拦截。安全不是模型天赋,而是靠可执行、可演进的断言守出来的。
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
|
1月前
|
JavaScript 前端开发 测试技术
对比度不足、缺 alt、缺 label:把 axe-core 挂进 Playwright,用 CI 门禁拦下 WCAG 违规
本文详解如何将 axe-core 无障碍扫描集成到 Playwright 测试中,利用浏览器原生 accessibility tree 自动检测 WCAG 违规(如对比度不足、缺 alt/label、标题跳级等),并通过 CI 基线门禁拦截新增问题,让无障碍从“上线后被投诉”变为“合并前被拦截”。
对比度不足、缺 alt、缺 label:把 axe-core 挂进 Playwright,用 CI 门禁拦下 WCAG 违规
|
1月前
|
消息中间件 安全 测试技术
只断言最终态等于放弃中间可测性:把 Behavioral Evaluation 翻译成 pytest 里的 Trajectory
本文介绍Agent测试新范式——行为评估(Behavioral Evaluation):摒弃仅校验最终结果的“outcome-only”方式,转而对工具调用轨迹(Trajectory)进行三层断言——工具选择、调用顺序与参数、过程与结果一致性。通过jsonl落库、pytest回归、CI门禁,实现可复现、可归因、防蒙对的高可信测试,让Agent能力而非运气成为上线依据。
只断言最终态等于放弃中间可测性:把 Behavioral Evaluation 翻译成 pytest 里的 Trajectory
|
13天前
|
人工智能 监控 测试技术
AI Coding 质量治理:工程规范、代码评审与风险驱动测试
本文基于31万行代码重构实践,提出AI Coding时代质量保障五大支柱:统一AI Rule与工程规范、固化Skill应对重复任务、AI辅助技术债排查、前置AI Code Review、风险驱动的测试设计,并倡导渐进式重构。强调AI提效不等于质量自动提升,需以标准、验证与闭环体系筑牢质量防线。
AI Coding 质量治理:工程规范、代码评审与风险驱动测试
|
1月前
|
人工智能 缓存 数据库
常青翻新|Mock 不是万能替身:Dummy/Stub/Spy/Mock/Fake 五种 Test Double 的边界与踩坑
本文厘清测试替身的五大分类(Dummy/Stub/Spy/Mock/Fake),指出滥用“万能Mock”导致测试脆弱或假绿的根源:混淆“提供数据”与“验证交互”。强调选型核心原则——**先明确断言对象(数据?交互?真实行为?),再决定替身类型**,并结合AI场景(如Agent轨迹验证、假模型替代)赋予经典模式新生命力。
|
1月前
|
人工智能 数据挖掘 开发工具
RAG 不一定需要大模型重排:Jev 能不能做 Context Filtering?
RAG中检索易召回冗余内容,Jev作为决策层可精准筛选高相关Chunk,替代简单Top-K输入。它支持多维度判断(如版本、时效性),提升Context质量与LLM答案准确性,降低幻觉与Token成本。(239字)
RAG 不一定需要大模型重排:Jev 能不能做 Context Filtering?
|
1月前
|
人工智能 测试技术 开发工具
Google 开源 ARTEMIS:AI Agent 如何接管 Android 真机测试?
Google开源AI测试框架ARTEMIS,支持自然语言驱动Android真机自动化:理解任务、识别界面、跨App操作、自动截图/日志采集并生成报告。原生集成MCP,可接入Antigravity等AI IDE,实现“描述目标→自主执行→分析结果”闭环。(239字)
Google 开源 ARTEMIS:AI Agent 如何接管 Android 真机测试?