
摘要:会用
readStream / writeStream只是入门。真正写出能长期稳定运行的流式任务,需要知道引擎内部有哪些模块、它们怎么协作、每个 trigger 里到底发生了什么。本文拆开 Structured Streaming 的五层模块(Source、StreamExecution 执行引擎、StateStore、Checkpoint、Sink),讲清编程模型的三层抽象,并逐帧还原一个微批从读数据到提交 offset 的完整执行链路。关键词:Structured Streaming, Spark, 编程模型, StreamExecution, StateStore, Checkpoint, 增量执行, 微批
一、先把模块地图铺开
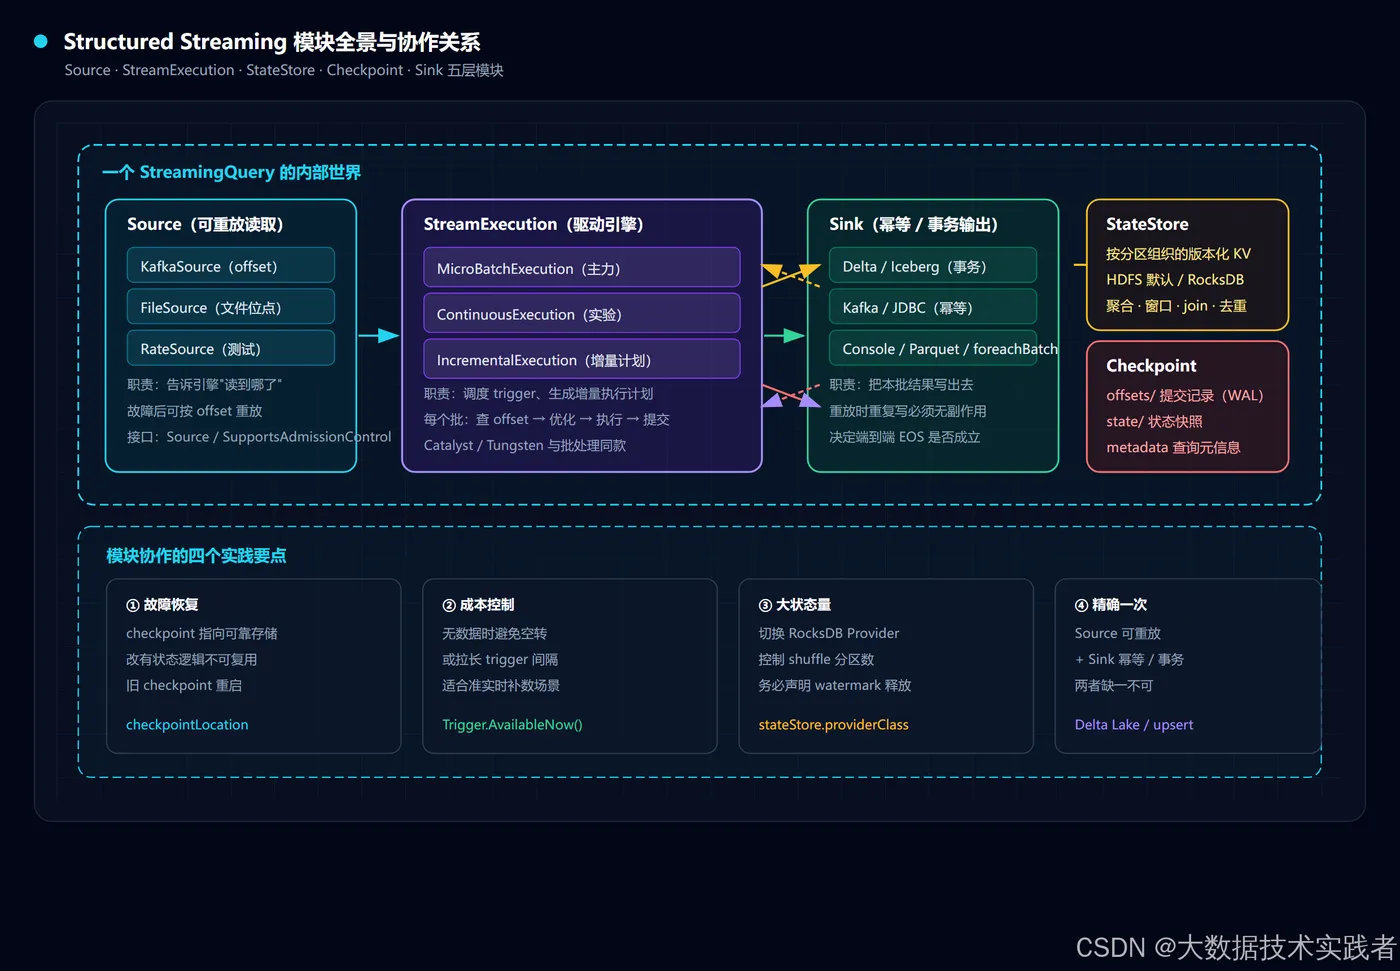
Structured Streaming 跑起来后,实际参与工作的模块可以分成五层,各司其职:
| 模块 | 职责 | 关键实现 |
|---|---|---|
| Source | 从外部系统读数据,提供可重放的 offset | KafkaSource、FileSource、RateSource |
| StreamExecution | 驱动整个查询:调度、生成增量执行计划、容错 | MicroBatchExecution / ContinuousExecution |
| StateStore | 存放有状态算子的中间状态,按分区版本化 | HDFS 默认实现 / RocksDB Provider |
| Checkpoint | 记录进度(offset)与状态快照,故障恢复依据 | offsets / commits / state / metadata 目录 |
| Sink | 把结果写入外部系统,需幂等或事务 | Kafka、Delta、Parquet、Console、foreachBatch |
前四层都在一个 StreamingQuery 里被统一调度,你在代码里看到的只是 query.start() 一行,背后是这套模块在协同。
二、编程模型的三层抽象
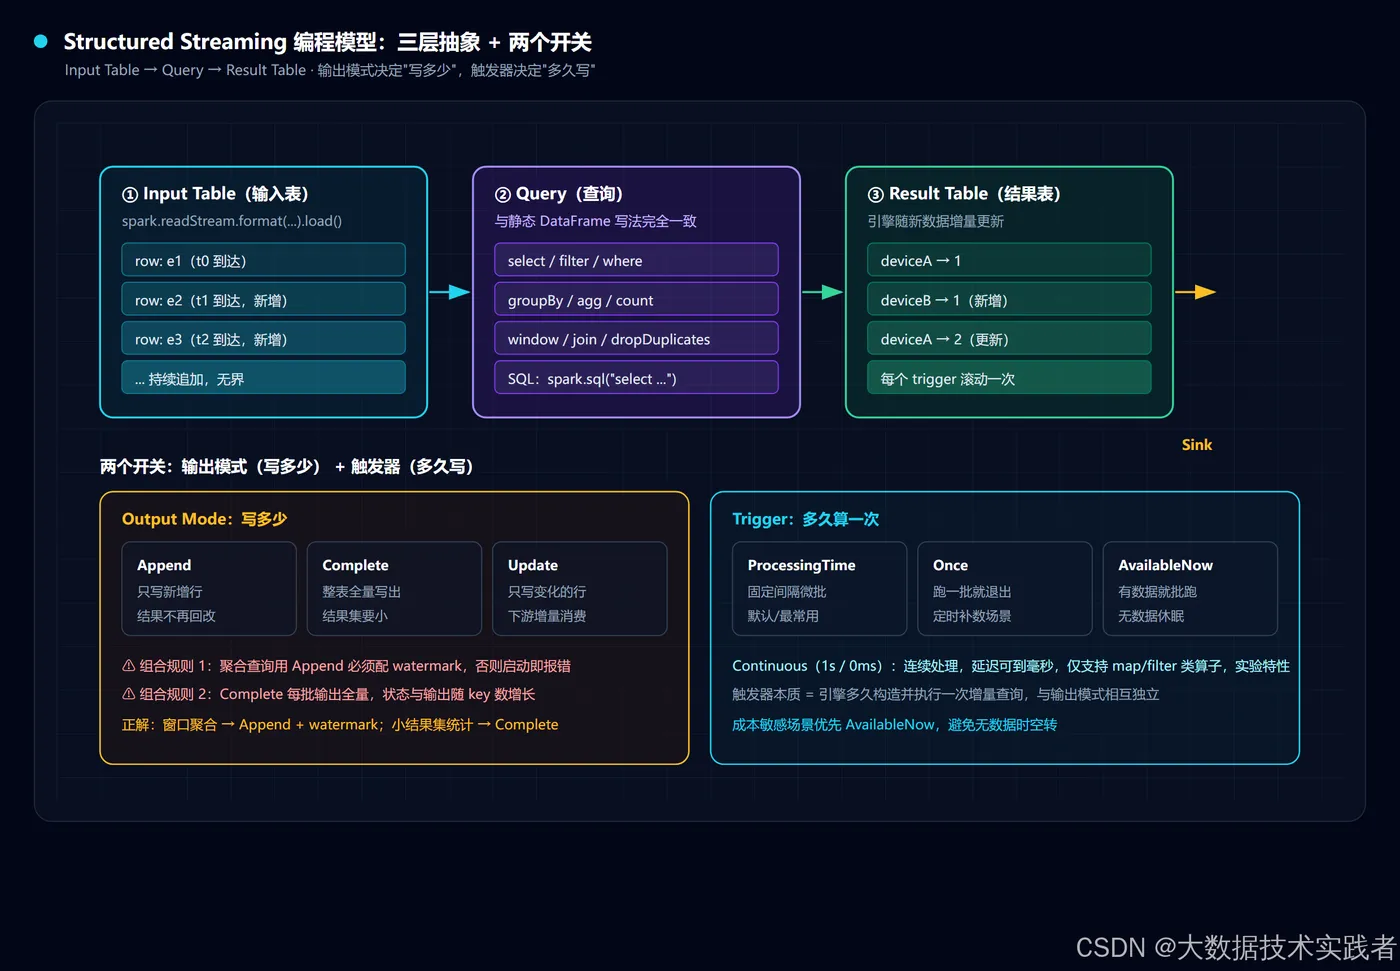
编程模型只有三个概念,理解它们就能理解所有 API 为什么长这样:
// 1. 输入:定义一张"无限表"
val lines: DataFrame = spark.readStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker:9092")
  .option("subscribe", "events")
  .load()

// 2. 查询:和静态 DataFrame 完全相同的写法
val counts = lines.groupBy($"device").count()

// 3. 输出:声明写哪、怎么写、多久写一次
val query = counts.writeStream
  .outputMode("complete")
  .format("console")
  .trigger(Trigger.ProcessingTime("10 seconds"))
  .option("checkpointLocation", "hdfs://nn:8020/chk/device-count")
  .start()
- Input Table(输入表):流式 Source 的抽象,每条到达的数据 = 表里新增一行;
- Query(查询):写在这张表上的 DataFrame/SQL 转换,与批处理写法完全一致;
- Result Table(结果表):查询结果的当前快照,由引擎随新数据增量更新。
三个"必须记住"的约束:引擎不物化整表(只读最新一段,算完即弃)、状态只保留最小集合、结果何时输出由输出模式决定。
Java 侧写法一一对应,只是类型显式一些:
Dataset<Row> lines = spark.readStream()
    .format("kafka")
    .option("kafka.bootstrap.servers", "broker:9092")
    .option("subscribe", "events")
    .load();

Dataset<Row> counts = lines.groupBy("device").count();

StreamingQuery query = counts.writeStream()
    .outputMode("complete")
    .format("console")
    .trigger(Trigger.ProcessingTime("10 seconds"))
    .option("checkpointLocation", "hdfs://nn:8020/chk/device-count")
    .start();
三、输出模式与触发器:写多少 + 多久写一次
这是编程模型里最容易踩坑的两个开关,它们的组合决定了语义正确性与成本:
// 输出模式:写多少
.outputMode("append")     // 只写新增行(最常用,聚合+无 watermark 不支持)
.outputMode("complete")   // 整表全量写出(结果集要小)
.outputMode("update")     // 只写发生变化的行

// 触发器:多久算一次
.trigger(Trigger.ProcessingTime("10 seconds"))  // 固定间隔微批
.trigger(Trigger.Once())                        // 跑一批就退出(定时补数场景)
.trigger(Trigger.AvailableNow())                 // 有数据就批跑,无数据休眠(3.x+,成本友好)
组合规则记两条:
- Append 模式要求结果行不会再被改写——纯
map/filter天然满足;聚合查询必须配合 watermark 才能保证"窗口关闭后不再更新",否则引擎直接报错拒绝启动; - Complete 模式每批都输出全量结果,状态与输出量随 key 数线性增长,只适合小结果集。
四、StreamExecution:一个微批里到底发生了什么
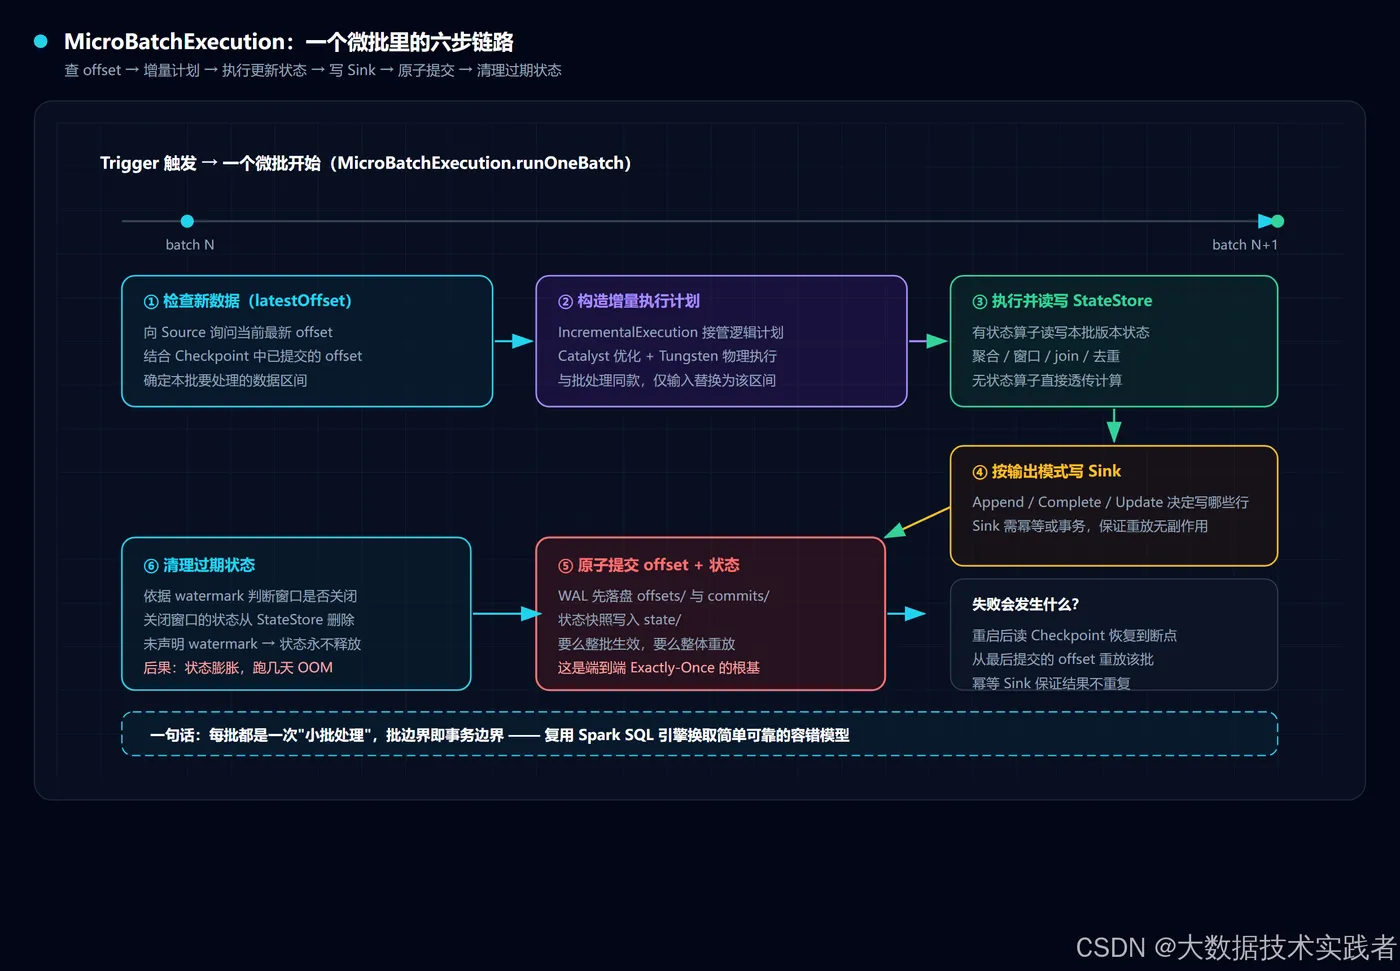
这是全文最值钱的一节。MicroBatchExecution 在每个 trigger 里严格按顺序做六件事:
- 检查新数据:向 Source 询问当前最新的 offset,确定本批要处理的范围;
- 构造增量执行计划:把用户写的逻辑计划,交给
IncrementalExecution重新优化——这一步和批处理的 Catalyst 优化是同一套,区别只在于输入被替换为本批的数据区间; - 执行并更新状态:有状态算子(聚合、窗口、join、去重)读写 StateStore,版本与本批绑定;
- 写 Sink:按输出模式把结果写到外部系统;
- 提交 offset 与状态:把本批的 offset 范围、状态快照写入 Checkpoint(WAL 先落盘);
- 清理过期状态:根据 watermark 删除不再需要的窗口状态。
整个链路的关键在于第 5 步是原子提交:要么整批成功并推进 offset,要么失败重启后从 Checkpoint 原样重放。这就是端到端 Exactly-Once 的实现根基。
五、StateStore:有状态算子的地基
聚合、窗口、双流 join、去重这些跨批操作,都依赖 StateStore。它的设计有三个要点:
- 按分区组织:每个分区一份状态,随分区迁移而迁移,天然支持并行;
- 版本化:每个微批对应一个版本,checkpoint 记录版本与 offset 的对应关系,回滚即可恢复;
- 可插拔实现:默认 HDFS(堆内 HashMap),大状态量切 RocksDB Provider。
# 大状态量生产建议:RocksDB + changelog checkpointing
spark.sql.streaming.stateStore.providerClass=org.apache.spark.sql.execution.streaming.state.RocksDBStateStoreProvider
spark.sql.streaming.stateStore.rocksdb.changelogCheckpointing.enabled=true
spark.sql.shuffle.partitions=200
调优上最常见的问题是状态膨胀:忘了设 watermark,窗口状态永远不释放,跑几天就 OOM。判断标准很简单——如果查询有聚合但不需要处理迟到数据,也要显式声明 watermark,否则引擎无法判断窗口何时关闭。
哪些算子会用到 StateStore,心里要有数:
| 算子 | 是否用状态 | 状态规模取决于 |
|---|---|---|
map / filter / select |
否 | — |
groupBy().count() |
是 | 分组键基数 |
窗口聚合 groupBy(window(...)) |
是 | 窗口数 × 键基数(watermark 后可释放) |
| 流-流 join | 是 | 时间范围内两侧的数据量 |
dropDuplicates |
是 | 去重键基数 |
mapGroupsWithState |
是 | 用户自定义,需显式设超时 |
一句话:只要查询里出现"跨批记住点什么"的语义,就会落状态,而状态的释放条件必须由你通过 watermark 或超时配置告诉引擎。
六、模块协作的四个实践要点
| 场景 | 要点 | 配置/写法 |
|---|---|---|
| 故障恢复 | checkpoint 必须指向可靠存储,改有状态逻辑不可复用旧 checkpoint | checkpointLocation |
| 成本控制 | 无数据时别空转,用 AvailableNow 或拉长 trigger 间隔 |
Trigger.AvailableNow() |
| 大状态 | 切换 RocksDB Provider,控制分区数与状态大小 | stateStore.providerClass |
| 精确一次 | Source 可重放 + Sink 幂等/事务,两者缺一不可 | Delta Lake / 幂等 upsert |
七、总结
- 模块五层:Source 负责可重放读取,StreamExecution 驱动调度与增量执行,StateStore 承载状态,Checkpoint 记录进度,Sink 负责幂等输出;
- 编程模型三层:Input Table → Query → Result Table,不物化整表、只保留最小状态;
- 输出模式决定"写多少",触发器决定"多久写",Append + watermark 是聚合查询的常见正解;
- 每个微批六步走:查 offset → 增量计划 → 执行更新状态 → 写 Sink → 原子提交 → 清理过期状态;
- 状态管理是长期稳定运行的命门:配 watermark、按规模选 Provider、checkpoint 可靠存储。
