多 Agent 代码审查系统的成本会随模型调用次数和上下文长度增长。即使大量输入命中缓存,反复读取会话历史仍会产生较高费用。
Cloudflare 工程团队也遇到了这一问题。系统架构和审查分级没有明显变化,平均审查成本却从 4 月的 1.19 美元升至 8 月底的约 2.46 美元;固定各审查等级的任务比例后,日均单次审查成本从 3 月的 1.22 美元一路上涨至 8 月的 2.32 美元。期间,落入最高审查等级的任务占比从 59% 增长到 65%,但复杂任务增多只能解释较小一部分增长,推高账单的是模型版本调整与上下文规模的持续膨胀。
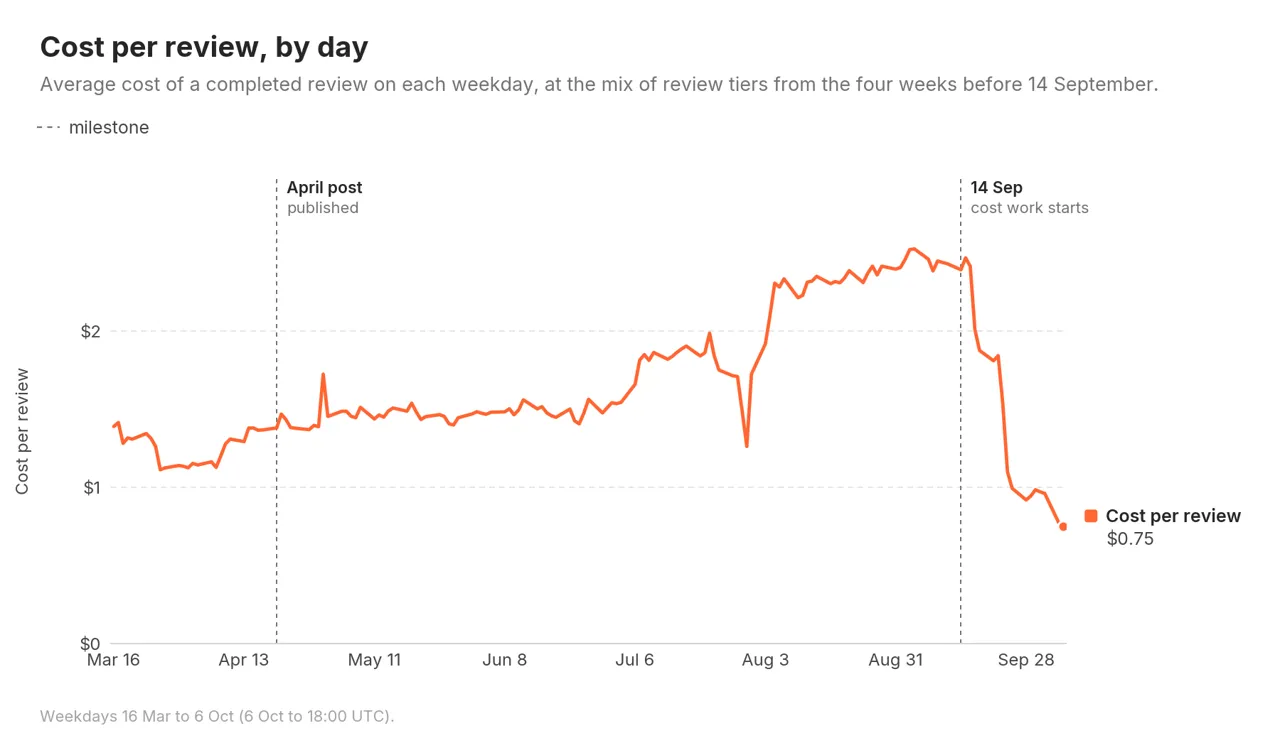
图 1:固定审查等级比例后的单次审查日均成本变化
从 9 月中旬开始,团队围绕缓存复用、模型调用流程和推理强度展开优化。到 10 月初,平均审查成本从 2.43 美元降至 0.77 美元,降幅达到 68%;中位耗时从 4 分 09 秒缩短至 1 分 32 秒。
缓存读写开销占比 77%
优化开始前,模型输出约占推理费用的 23%,缓存写入占 43%,缓存读取占 34%。代码质量审查 Agent 平均每次运行调用模型 16.6 次,累计写入约 7.2 万个缓存 Token,并读取约 108 万个缓存 Token。
每次工具调用都会产生新的会话内容,后续请求又要携带此前的对话,调用轮数和上下文长度会在同一个任务中持续增长。整体缓存命中率无法反映一次任务累计读取了多少上下文。
团队采用的提示词缓存只能复用请求开头连续一致的内容,并在显式设置的缓存断点处保存前缀。缓存写入价格为普通输入的 1.25 倍,读取价格为 0.1 倍;缓存条目在 5 分钟内没有被读取时会过期。
团队因此确定了两个优化方向,首先提高每个会话首次请求的缓存复用率,随后减少会话内部的模型调用次数。
缓存前缀对齐与复用
从 9 月 14 日开始,团队记录各审查 Agent 首次模型调用的 Token 使用情况,并对发送给模型服务商的第一个系统消息块计算哈希。数据显示,新会话首次请求命中已有缓存的比例只有 14% 至 26%。
每个任务开头都包含约 1.1 万至 2.1 万个 Token 的公共工具定义和 Agent 指令。旧版执行框架却将公共指令与工作目录、日期等动态信息放在同一个系统消息块中,并把唯一的缓存断点设置在末尾。动态信息改变了断点前的字节序列,公共内容无法跨仓库复用。
9 月 16 日,团队在每个 Agent 提示词末尾增加固定标记,并通过插件钩子在标记处将原有系统消息块拆成两个区块。拆分后的第一个区块结束于所有任务共享的相同字节,并设置独立缓存断点;工作目录和日期等环境信息保留在后面的区块。为了保证断点前的内容稳定,团队禁用了可用 Skill 列表,并固定工具描述,避免其在不同任务之间发生变化。
调整后,协调 Agent 首次请求的缓存命中率从 14.0% 提高到 90.7%,其余审查 Agent 提高到 98.3% 至 99.5%。
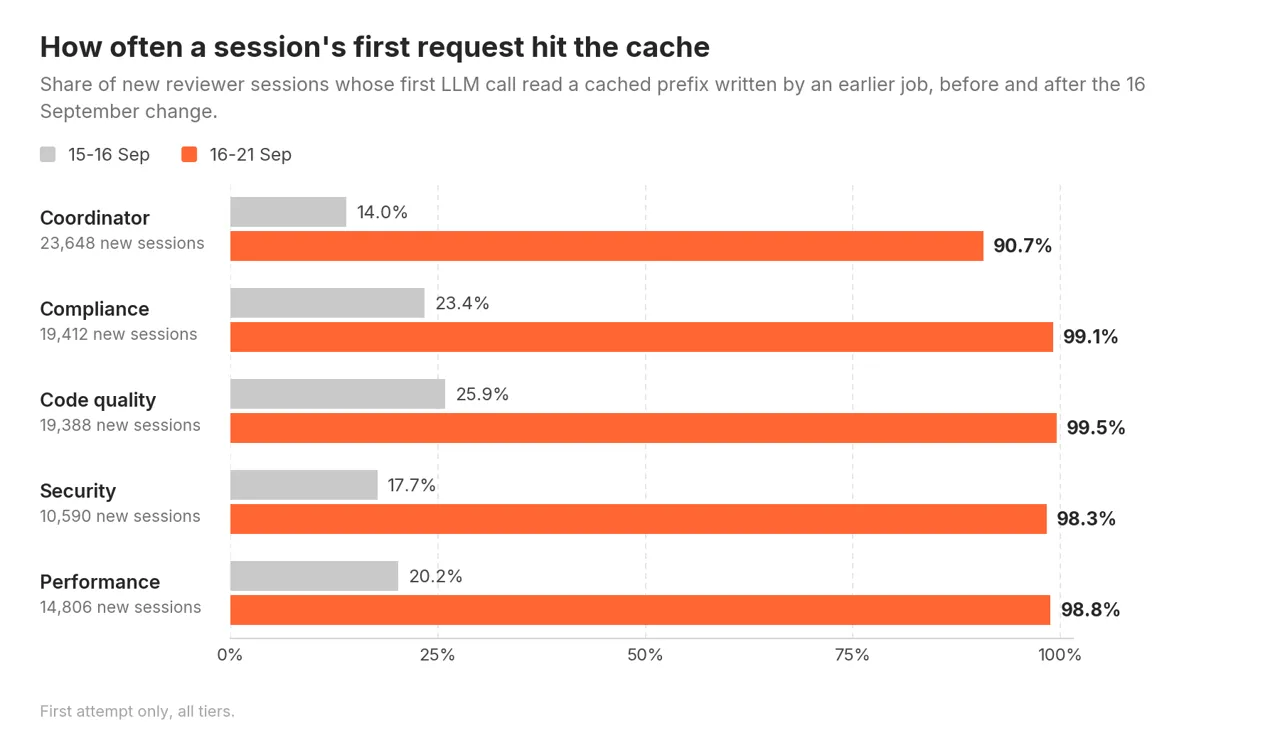
图 2:拆分缓存断点前后各审查 Agent 首次请求的缓存命中率
缓存复用随后扩展到同一次任务内的代码质量、安全和性能审查 Agent。三个审查 Agent 需要读取相同的工具、公共规则、合并请求信息和代码补丁,仅专属审查指令不同。
工具定义和共享规则位于请求开头,并分别设置缓存断点。在审查等级、模型和推理强度配置相同时,这两部分可以跨仓库复用。环境信息和代码补丁之后设置第三处断点,由同一次任务中的三个审查 Agent 共享;专属审查指令之后的第四处断点用于各自后续调用。
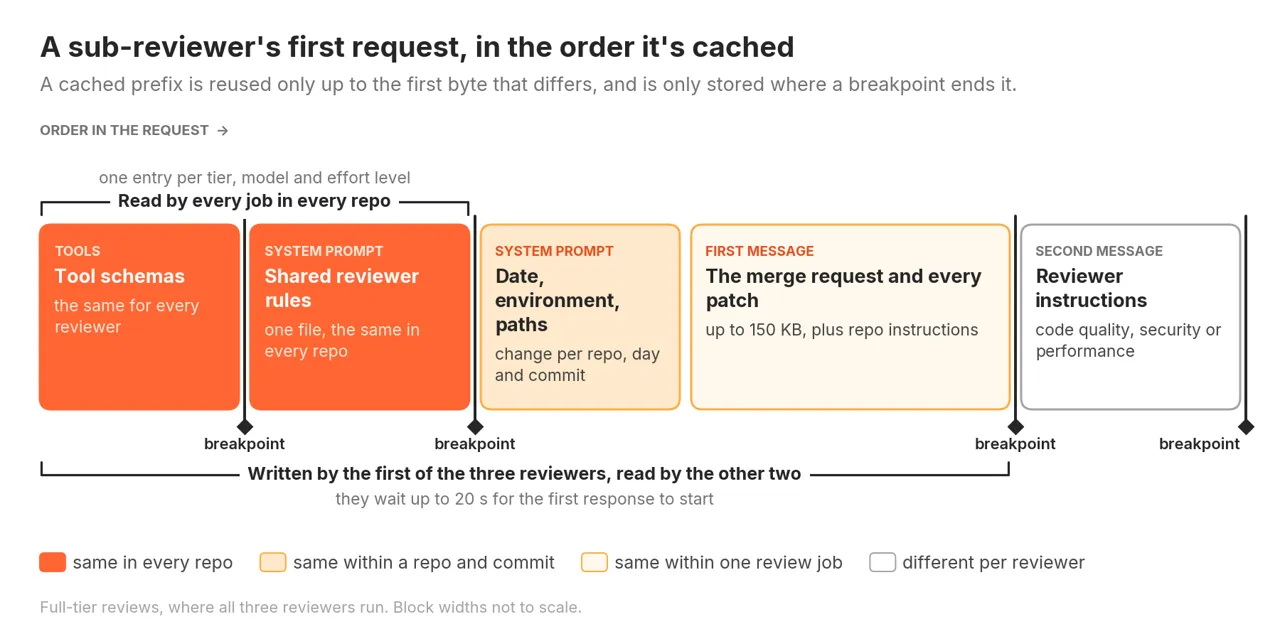
图 3:审查 Agent 首次请求的数据排列顺序和四处缓存断点
三个审查 Agent 默认同时启动,但缓存只有在写入请求开始流式返回后才能被其他请求读取。团队让第二个和第三个审查 Agent 最多等待 20 秒,再发出各自的首次请求。少量启动延迟避免了公共上下文重复写入,平均可为每个审查 Agent 节省约 0.09 美元。
工具与调用链精简
内部规范审查 Agent 原本需要在任务开始时读取标准索引、Skill 文件和参考文件列表,前三轮调用基本用于加载这些固定内容。团队将参考索引放入可缓存的提示词后,平均调用次数从 15.9 次降至 9.6 次,单次运行成本从 1.12 美元降至 0.72 美元。配合缓存改造,系统平均审查成本从 2.47 美元降至 2.02 美元。
部分子审查 Agent 还能看到自己无权使用的结果提交工具。在 57% 至 76% 的会话中,模型会尝试调用该工具,被拒绝后还要额外运行一轮。删除该工具后,每次任务减少一次无效调用,每个请求也减少约 2,900 个工具定义 Token。
代码质量审查 Agent 此前在 64% 的对话轮次中只发起一次工具调用,通常用于读取单个文件。调整后,审查 Agent 可以在首轮响应中读取共享上下文和全部代码补丁,单次处理最多约 150 KB 的内容,减少后续逐个读取文件的轮次。
团队还删除了审查结果提交后的多余总结调用,平均每个任务节省约 0.07 美元;将执行超时和服务故障分开处理,使安全审查 Agent 的超时比例从 1.8% 降至接近零。
约三分之二的任务属于同一合并请求的后续审查。加入前置判断后,AGENTS.md、性能和文档审查可分别跳过 56%、23% 和 13%。任务脚本也会每隔 15 秒检查状态,避免上游任务取消后继续运行。在抽样的 446 个已取消任务中,此前有 358 个仍会运行到审查结束。
系统同期完成了 Agent 执行框架重写。新旧版本在影子模式中对 98% 的合并请求给出相同的审批结论;迁移完成后,在模型配置相同的情况下,新版本的完整审查耗时缩短约 13%。这些流程改动合计将单次审查成本再降低约 0.20 美元。
模型与推理强度调优
按照每次发布和配置变更前后的时间窗口估算,代码与执行流程优化贡献约 0.65 美元,模型和推理强度调整贡献约 1.06 美元。
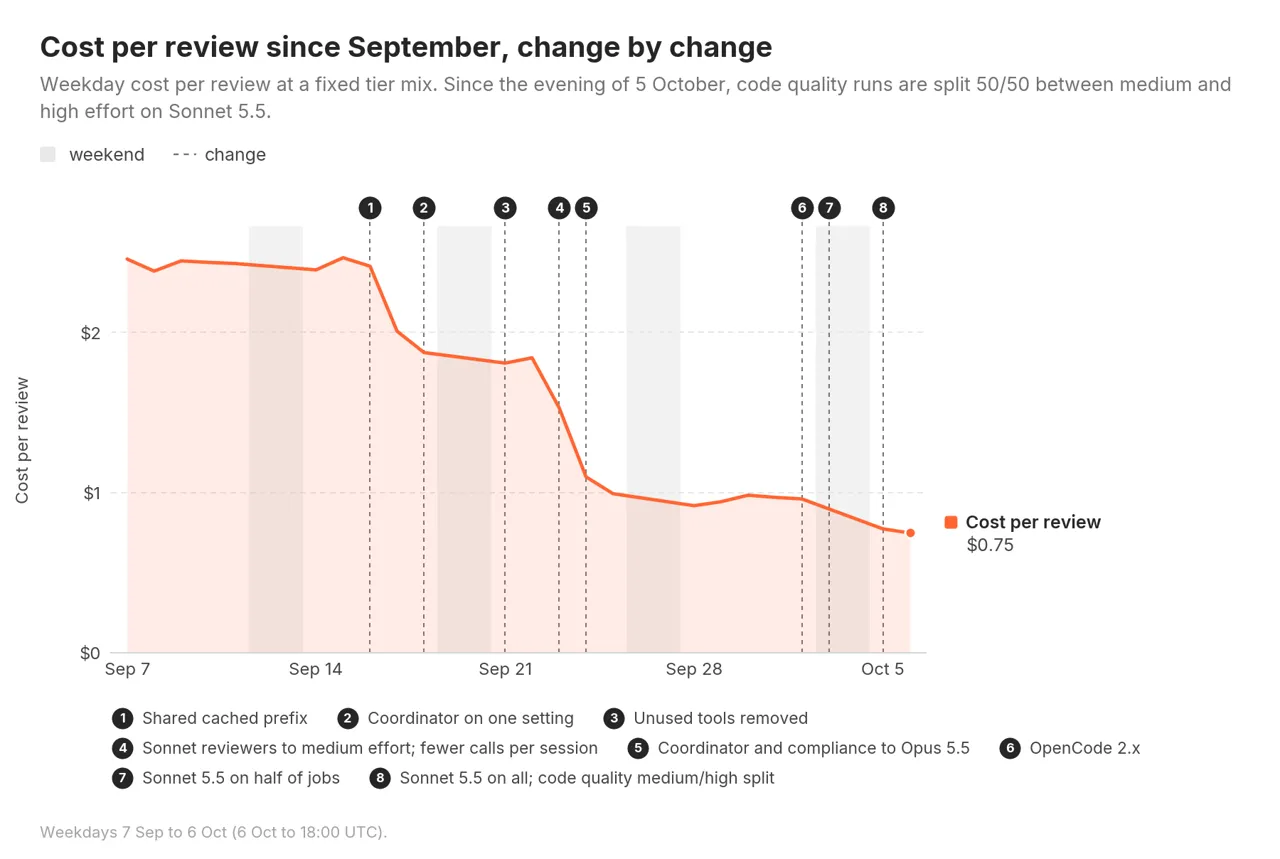
图 4:每次代码发布与配置变更后的单次审查成本
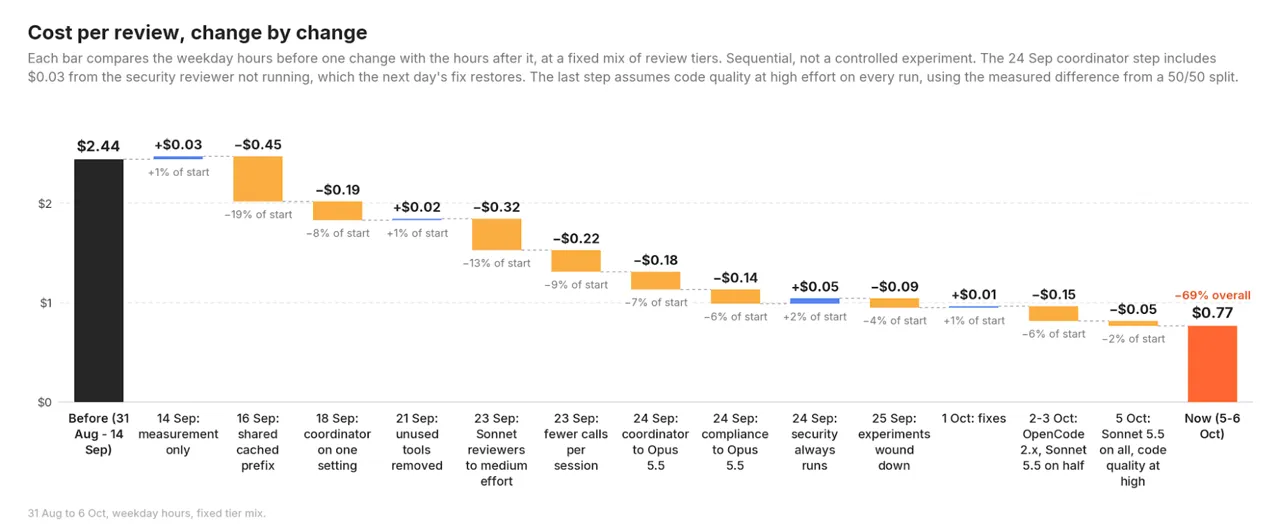
图 5:各项变更对单次审查成本影响的瀑布图
协调 Agent 此前同时运行三种模型与推理强度组合。在同一模型下,中等推理强度的完整审查任务快约 20%,团队因此停用了另外两种组合。随后的随机分流显示,Opus 5.5 使用中等推理强度时,与 Opus 5 相比,审查结论和严重问题数量均未出现可测量变化。团队据此将协调 Agent 切换到中等推理强度的 Opus 5.5;同期,合规审查 Agent 也切换到了 Opus 5.5。
代码质量、性能和安全审查 Agent 随后在 Sonnet 5 和 Sonnet 5.5 之间进行 50/50 分流。两代模型的 Token 单价相同,Sonnet 5.5 将三类审查的单次运行成本分别降低 62%、58% 和 47%。
在中等推理强度下,代码质量审查 Agent 平均每次任务调用模型 1.7 次,旧配置需要 6.2 次;超过一半的任务可以在第一次调用后结束。切换到高推理强度后,平均调用次数上升到 3.4 次。
中高推理强度的进一步分流显示,高推理强度的单次运行成本高出 61%,折合每次整体审查约为 0.02 美元,同时多发现了 58% 的严重级和警告级问题。团队随后结合开发者后续修改和盲评结果判断这些新增问题是否具有价值。
从 9 月初到优化完成,单次审查的缓存读取量下降 82%,缓存写入量下降 54%,模型输出量下降 67%。模型价格变化只解释了约 0.20 美元的成本降幅,其余变化主要来自 Token 使用量减少。
调用次数与审查耗时
模型和工具调用次数下降后,中位耗时从 4 分 09 秒降至 1 分 32 秒,P99 从 15 分 20 秒降至 4 分 41 秒。超过 5 分钟的审查占比也从 37.9% 降至 0.7%。
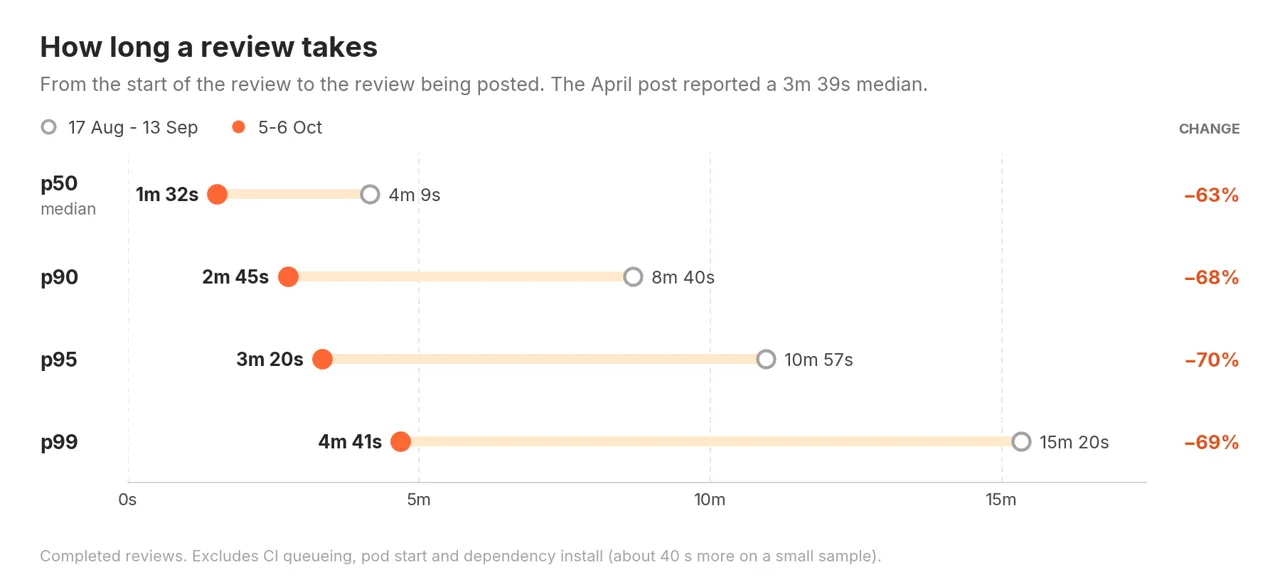
图 6:优化前后各延迟分位点的变化
耗时统计中不包含 CI 排队、容器启动和依赖安装时间。小规模样本显示,这些准备过程还会增加约 40 秒。到 8 月时,中位审查时间已经比 4 月慢 14%,因此本轮优化的一部分收益来自消除此前积累的性能退化。
质量评估与配置决策
优化后,代码质量、安全和性能审查 Agent 发布的严重级与警告级问题数量分别下降 40%、56% 和 71%。合规审查 Agent 则增长了 159%。
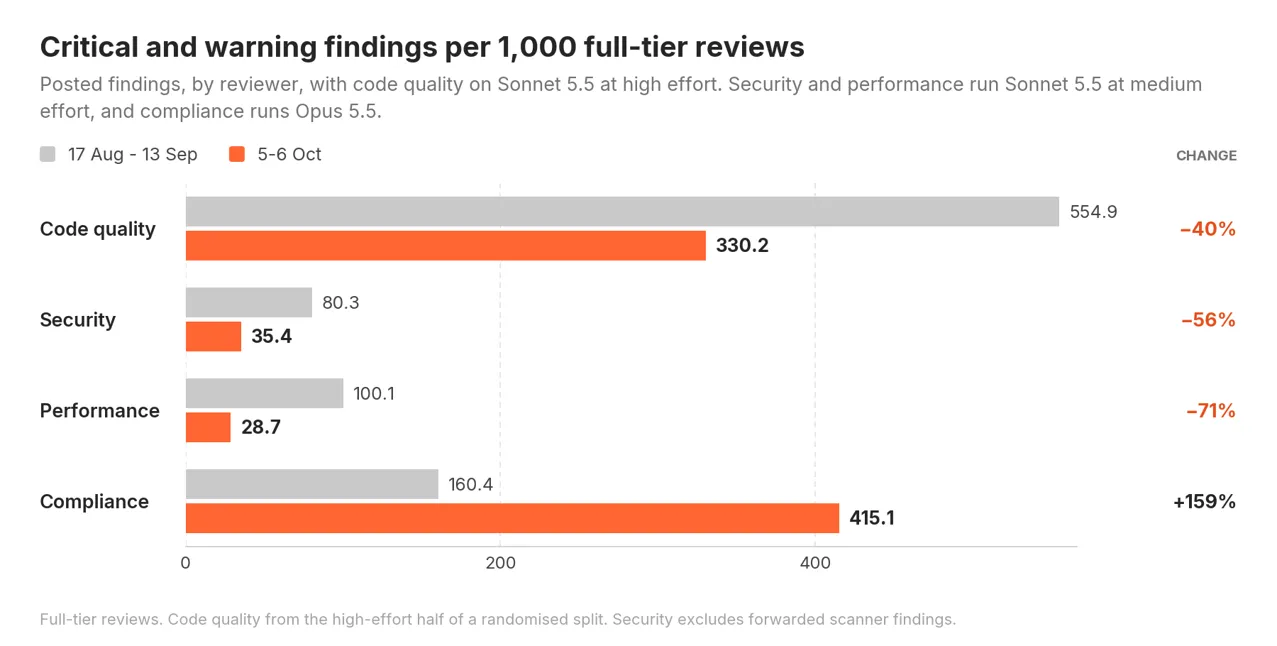
图 7:每 1,000 次完整审查产生的严重级和警告级问题数量
问题数量下降可能来自噪声减少,也可能来自真实问题漏检。团队首先对比被审查版本与开发者下一次推送。如果审查意见指向的代码行随后发生变化,该问题会被记为促成了后续修改。距离目标位置 30 至 40 行的代码在各阶段约有 15% 的自然变化,可以作为偶然修改的基线。
优化前,代码质量审查 Agent 约有 34% 的严重问题对应代码在下一次推送中发生修改,优化后提高到 59%。每 1,000 次完整审查中,促成代码修改的问题数量从约 145 条变为约 132 条,差异处于误差范围内。四类审查 Agent 合计促成修改的严重问题则从约 229 条增至 321 条。
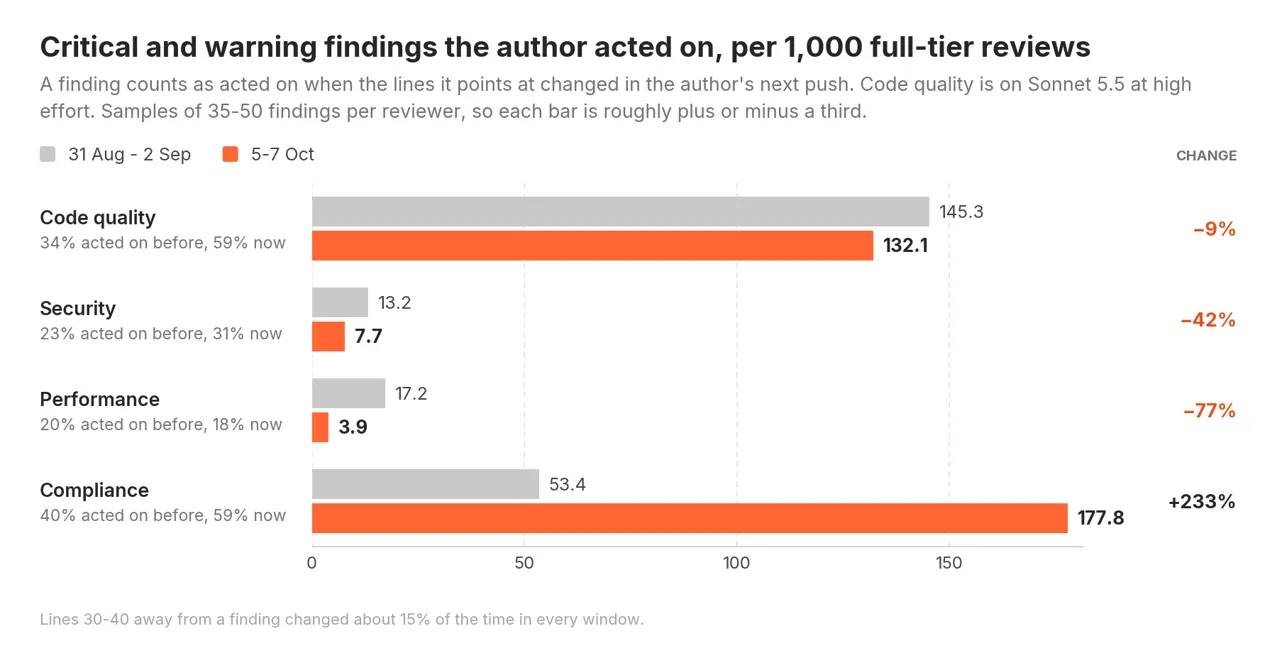
图 8:每 1,000 次完整审查中促成后续修改的问题数量
团队随后从代码质量、安全和性能审查结果中抽取 657 条问题,由两个来自不同服务商的模型进行盲评,分歧交给第三个模型裁决。评估将问题标记为重要、轻微、重复、错误或无法验证,同时检查严重程度是否合理。
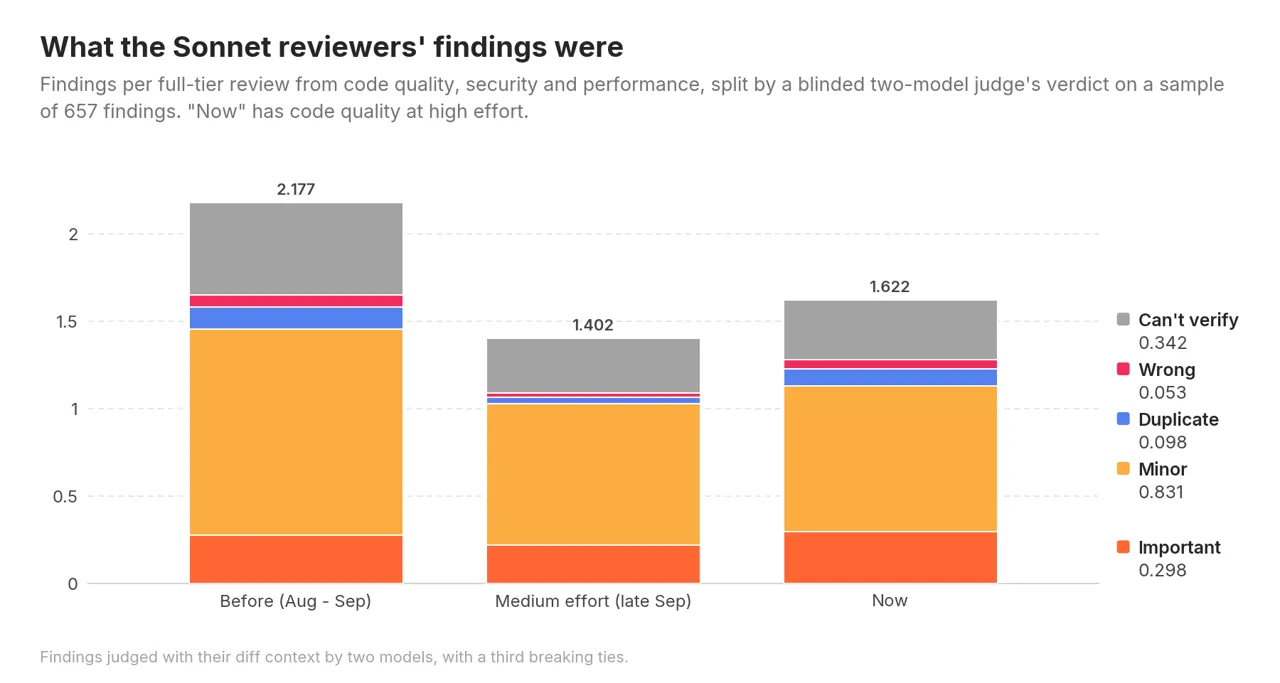
图 9:优化前后不同类型审查问题的构成
减少的内容主要是轻微问题、重复问题和无法验证的问题。三个审查 Agent 发现的重要问题合计从平均每次完整审查 0.28 个变为 0.30 个;盲评结果显示,被评为严重程度过高的严重级或警告级问题,从平均每次审查 0.46 个降至 0.14 个,降幅约为 70%。
代码质量审查 Agent 使用高推理强度时,重要问题发现量基本保持稳定,噪声和严重程度虚高明显减少。中等推理强度下,促成后续修改的问题只有高推理强度的约四分之一,团队因此将其固定在高推理强度。
性能审查 Agent 在中等推理强度下发现的重要问题减少约 64%,约相当于每 24 次完整审查少发现一个重要性能问题。安全审查的重要问题减少约四分之一,但没有达到统计显著水平,团队计划继续测试这两个审查 Agent 的高推理强度配置。
两项评估都有局限。代码发生变化不能直接证明审查意见正确;盲评裁判仍然是模型,各组样本只有 35 至 66 条问题,最终配置的观察窗口也只有一天。系统可靠性没有下降,无最终结论的审查占比从 0.79% 降至 0.27%,安全审查 Agent 的重试比例从 3.5% 降至 0.04%。
Agent 成本优化方法
本轮优化将平均审查成本从 2.43 美元降至 0.77 美元,中位耗时从 4 分 09 秒缩短至 1 分 32 秒。约 40% 的成本节省来自代码、缓存和调用流程优化,其余部分主要来自模型与推理强度调整。
同类系统可以优先检查每个会话的首次请求。整体缓存命中率可能掩盖首轮请求持续写入缓存的问题,日期、路径和动态环境信息都可能破坏公共前缀。模型调用次数也需要独立监控,无效工具、重复文件读取、多余总结和已取消任务都会同时增加费用与延迟。
推理强度调整需要与质量评估同步进行。不同任务对推理深度的需求存在差异,代码质量、安全和性能审查需要分别实验,并通过后续代码修改、问题分类和严重程度评估判断成本下降是否伴随审查能力损失。