前面我们学习了 Elasticsearch集群异常状态(RED、YELLOW)原因分析 ,了解到了当集群发生主分片无法上线的情况下,集群状态会变为RED,此时相应的RED索引读写请求都会受到严重的影响。
背景
- 前面我们学习了 Elasticsearch集群异常状态(RED、YELLOW)原因分析 ,了解到了当集群发生主分片无法上线的情况下,集群状态会变为RED,此时相应的RED索引读写请求都会受到严重的影响。
- 这里我们将介绍索引分片损坏这种情况,当索引分片发生损坏时,对应的主分片会无法分配,且状态也会是RED。然而分片的损坏的情况又分为很多种,有些只是表象,可以通过一些手段恢复,但有些则是真实的物理损坏,且无法恢复,只能丢弃部分数据,甚至整块分片。
问题
场景:集群节点文件系统故障引起的分片损坏
这种情况也是比较常见的,一般我们可以通过explain api来确认:
[root@sh ~]# curl -s -XGET localhost:9200/_cluster/allocation/explain?pretty
{

    "index": "d4f811fc-4a43-40ca-a362-ebdaa9f23a720722",
    "shard": 5,
    "primary": true,
    "current_state": "unassigned",
    "unassigned_info": {

        "reason": "MANUAL_ALLOCATION",
        "at": "2021-07-11T03:05: 49.2417",
        "details": "failed shand on node[IEW657FYSZiiUn53LjBcuAJ]: shard failure,reason [failed to recover from translog], failure EngineException[failed to recover from translog]; nested:TranslogCorruptedException[translogfrom source [/data2/containers/1620201319003550632/es/data/nodes/0/indices/g2Zz7YV6FRj6xPETjZAzCOg/5/translog/translog-38.tlog] is corrupted, operation size is corrupted must be [0..65615539] but was: 2065851766]; ",
        "last_allocation_status ": "no_valid_shard_copy "
    },
    "can _allocate": "no_valid_shard_copy",
    "allocate_explanation": "cannot allocate because all found copies of the shard are either stale or conrupt",
    "node_allocation_decisions": [
        "node_id": "OGORzwn5T2CknwuCkHSNHA",
        "node_ name": "1617024100001322232",
        "transport_address": "9.10.179.196:9300",
        "node_attributes": {

            "ml.machine_memory": "67211821056",
            "rack": "cvm_1_100003",
            "xpack.installed": "true",
            "set": "100003",
            "ip": "9.10.179.196",
            "temperature": "warm",
            "ml.max_open_jobs": "20",
            "region": "1"
        },
        "node_decision": "no",
        "store": {

            "found": false
        }
    ]
}
解决方案
方案一:重试分配上线失败的分片
这是一种乐观的场景,这种情况通常是由于集群压力大,导致的分片无法分配,这里我们尝试重新分配:
[root@sh ~]# curl -s -XPOST localhost:9200/_cluster/reroute?retry_failed=true
{

  "acknowledged": true,
  "state": {

    "cluster_uuid": "LOk2L8k5RsmCC7eg2y3h8A",
    "version": 533752,
    "state_uuid": "jVm_8aAIT6ug9NBJazjVig",
    "master_node": "kHbBiclxR5-c-rsra2A5Jg",
    "blocks": {


    },
    "nodes": {

      "m5eloUNuTJak4xDRqf3FeA": {

        "name": "1625799512002116132",
        "ephemeral_id": "dqHmYahLSbuqvSkRXy2IPg",
        "transport_address": "9.27.34.96:9300",
        "attributes": {

          "ml.machine_memory": "134587404288",
          "rack": "cvm_33_330002",
          "xpack.installed": "true",
          "set": "330002",
          "transform.node": "true",
          "ip": "9.27.34.96",
          "temperature": "hot",
          "ml.max_open_jobs": "20",
          "region": "33"
        }
      },
    "security_tokens": {

    }
  }
}
方案二:REOPEN分片
reopen的目的是触发索引分片重新上线,直接调用_close和_open api即可:
[root@sh ~]# curl -s -XPOST localhost:9200/twitter/_close?pretty
{

  "acknowledged": true
}
[root@sh ~]# curl -s -XPOST localhost:9200/twitter/_open?pretty
{

  "acknowledged": true,
  "shards_acknowledged": true
}
方案三:分配陈腐的分片
如果retry_failed和reopen索引都无法使分片上线,则需要考虑使用reroute api分配stale primary。执行这个api之前,我们需要得到一些信息:
- 索引名称和分片ID可以通过explain api直观看到;
- 节点名称可以通过unassigned_info.details得到。
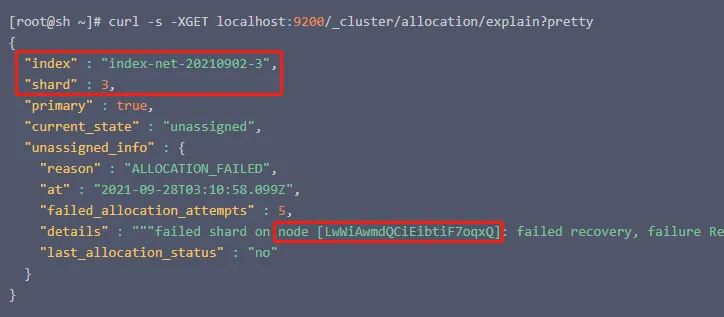
根据这些信息,我们就可以执行reroute api了:
[root@sh ~]# curl -s -H "Content-Type:application/json" -XPOST "localhost:9200/_cluster/reroute?pretty" -d '
{

  "commands": [
    {

      "allocate_stale_primary": {

      "index": "{索引名称}",
      "shard": "{分片ID}",
      "node": "{节点名称}",
      "accept_data_loss": true
      }
    }
  ]
}
方案四:丢弃部分trasnlog文件
这块无法上线的分片有2GB ,但是提示有一个的translog-38损坏了。登上对应节点的服务器,看了下这个文件有6mb,于是我们把它move走,移到/tmp,然后再次执行方案三,这样allocate_stale_primary操作就可以最大限度的恢复分片数据:
[root@sh ~]# mv /data2/containers/1620201319003550632/es/data/nodes/0/indices/g2Zz7YV6FRj6xPETjZAzCOg/5/translog/translog-38.tlog /tmp
[root@sh ~]# curl -s -H "Content-Type:application/json" -XPOST "localhost:9200/_cluster/reroute?pretty" -d '
{

  "commands": [
    {

      "allocate_stale_primary": {

      "index": "{索引名称}",
      "shard": "{分片ID}",
      "node": "{节点名称}",
      "accept_data_loss": true
      }
    }
  ]
}
方案五:丢弃分片(三思!慎用!)
如果以上的所有方案都无法使分片上线,为了不影响索引读写请求,就只能丢弃掉损坏的分片了,这是最糟糕的情况:
[root@sh ~]# curl -s -H "Content-Type:application/json" -XPOST "localhost:9200/_cluster/reroute?pretty" -d '
{

    "commands" : [
        {

          "allocate_empty_primary" : {

              "index" : "{索引名称}",
              "shard" : "{分片ID}",
              "node" : "{节点名称}",
              "accept_data_loss": true
          }
        }
    ]
}'