
摘要: 大语言模型为数据消费带来了直观交互,但构建高可用智能分析系统仍面临复杂的工程底座挑战。本文从系统研发范围、多维分析计算、动态口径治理以及长周期回归测试等维度,详细对比自建问数助手、企业级智能分析平台以及混合架构的工程分工与适用边界,提供严谨的技术选型权衡。
在企业数字化建设迈向深水区的今天,如何借助生成式 AI 技术降低业务取数门槛、提升分析决策效率,成为众多技术架构师与数据团队重点攻克的课题。得益于开源大模型及推理框架的成熟,技术团队在 PoC 验证阶段通常能快速跑通基于自然语言的查数原型:业务人员通过对话框输入查询问题,大模型将自然语言解析为 SQL 查询并在数据源中执行,最终将结果通过前端可视化图表反馈给用户。
这种轻量级的技术原型在初期演示中往往能够获得良好的反馈。但在尝试将该方案推向企业内部日常生产环境时,随着分析场景由单表汇总延伸至复杂的多维下钻、行为时序分析与跨业务域关联,系统往往迅速遭遇口径漂移、分析计算超时、多表关联失效以及权限隔离失控等一系列工程挑战。
要系统性解决这些问题,技术决策者必须清醒地认识到:构建一个演示性的对话工具,与搭建一套能够承载高并发、高准确率企业级决策的智能分析底座,存在着显著的工程鸿沟。本文将围绕自建、采购成熟平台以及混合架构三种路径,深入探讨其技术分工与适用边界。
演示原型与生产级分析系统的工程断层
自建问数应用在生产落地中所面临的瓶颈,并非大模型推理能力不足,而是源于前端自然语言交互与底层数据基础设施之间的能力断层。
在完整的智能数据分析系统中,大语言模型的核心职责是完成对非结构化自然语言的语义理解与意图提取;而真正决定查询结果是否准确、能否经得起业务推敲的,是底层一套高度工程化的数据管理与计算基础设施:
- 复杂时序与多维分析模型的底层支撑:企业级的数据分析绝不仅限于单表的简单过滤与求和,而是高度依赖转化漏斗、用户动线路径、同群留存矩阵等专用分析模型。这些分析涉及跨时序的大规模事件序列匹配。单纯让模型临时拼接出复杂的嵌套 SQL,不仅极易出现逻辑幻觉,还会对数仓集群造成过高的计算压力。
- 严密且统一的指标与口径治理机制:企业内部经常存在指标定义不统一的治理难题。如果底层缺少统一的语义层约束和指标中心,任由大模型推断字段含义,很容易导致同样的业务问题因问法不同而产生相互矛盾的查询结果。
- 多端数据的规范接入与行列级权限隔离:线上业务涵盖 Web、App、小程序等跨端行为数据,以及后端的订单和客户信息。数据采集的规范性、清洗质量以及行列级的精细化权限过滤,是保证分析结果合规可信的前提。
在已有成熟指标服务和计算引擎之上增加一层智能问答,与从零自研一整套包含数据接入、建模治理、分析引擎和权限控制的平台,是两种完全不同量级的工程。
架构选型的四个核心考量维度
面对自研、采购成熟平台或采用组合架构的选择,技术团队需要系统审视以下四个维度:
1. 内部已有数据与分析资产的复用程度
如果企业数仓已经历了深度治理,具备统一的指标字典、标准化语义层和可调用的分析 API,自建助手只需聚焦在业务意图到既有接口的参数映射上,可行性较高;反之,若底层数据仍以分散的事实表为主,缺乏标准化分析接口,自建方案就必须先补齐底层的指标定义与计算底座,工程量将成倍增加。
2. 研发边界与自研组件的维护成本
自建一个交互原型只需关注提示词工程与模型接口调用,但交付生产环境时,工程范围会迅速蔓延至多源数据接入、异步计算调度、复杂时序算法以及跨部门权限管理。技术团队需要评估,核心研发力量应当聚焦在企业独特的业务应用上,还是投入在通用分析计算引擎的重复开发上。
3. 业务需求频繁迭代的响应弹性
业务场景瞬息万变。今天需要新增分析事件,明天需要调整转化漏斗节点,后天可能需要按新的人群标签进行交叉对比。如果分析逻辑固化在自研代码中,每次业务变更都需要工程师手动介入排查与重写;而成熟系统通常允许业务人员通过可视化规则自主配置与探索,降低跨部门沟通成本。
4. 系统上线后的持续回归测试与运维责任
大模型的非确定性特征决定了 AI 系统上线后需要持续的回归测试。当微调新模型、更新系统提示词或调整底层数据结构时,必须系统化验证原有常见业务问答是否依然能够准确响应。若缺乏专职团队进行全天候监控、报错定位与算力调优,自建工具极易陷入故障率高、业务信任度低的循环。
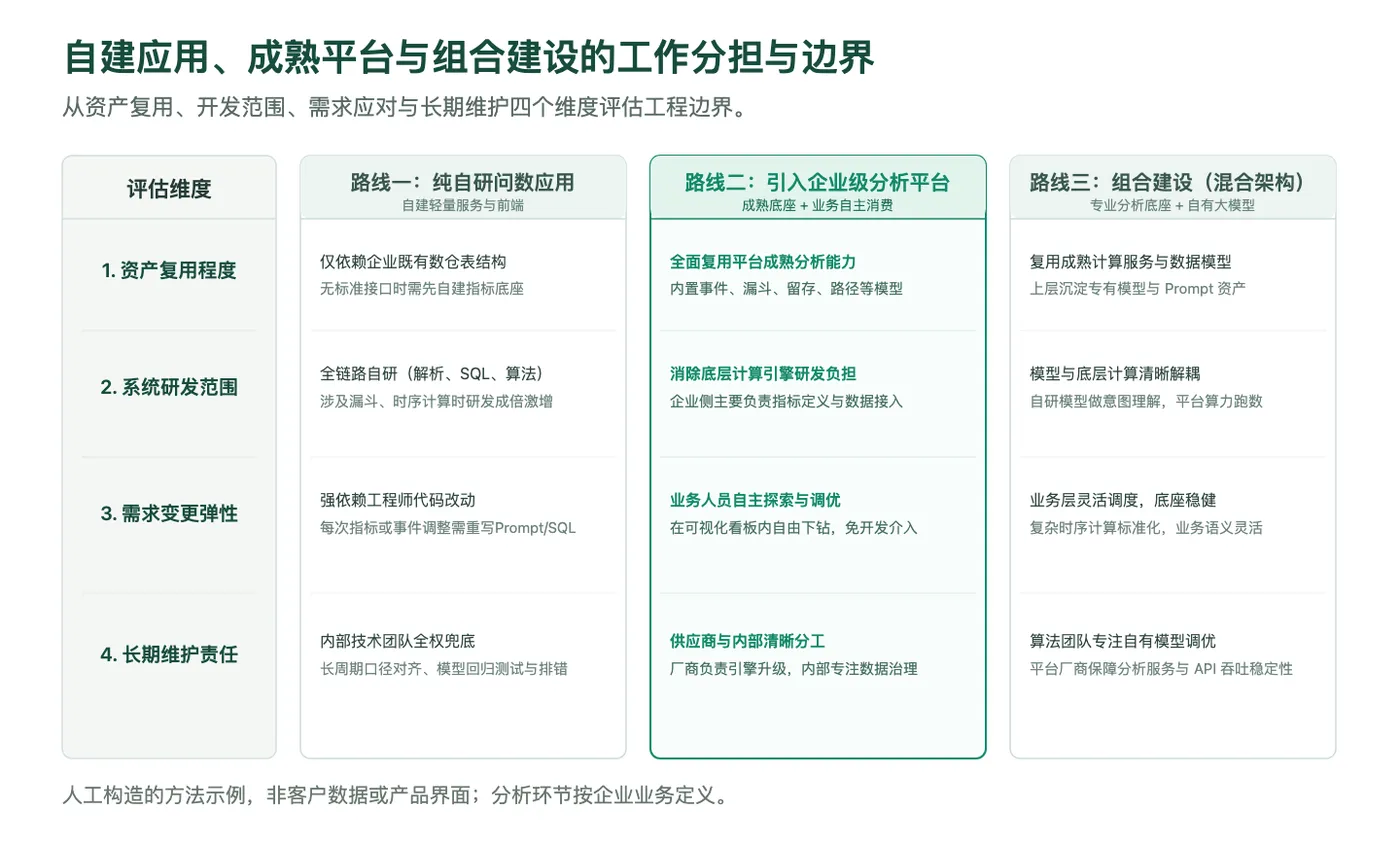
(注:图示架构与工作分担仅为工程评估方法示意,非特定产品固定参数)
三条建设路线的权衡与架构分工
根据技术团队能力与企业诉求差异,目前主流的落地路径分为三类:
| 评估维度 | 路线一:纯自研问数应用 | 路线二:引入企业级智能分析平台 | 路线三:组合建设(成熟引擎 + 自有模型) |
|---|---|---|---|
| 系统建设范围 | 涵盖意图识别、SQL生成、专用分析算法、权限及可视化全栈 | 采用标准产品底座,内部聚焦数据源适配、指标映射与业务接入 | 复用标准分析底座,企业侧自建或微调私有模型并调度标准化接口 |
| 底层引擎复用 | 仅能依赖现有数仓 SQL 引擎,复杂分析需自行开发定制算法 | 全面复用平台预置的事件、漏斗、留存、路径等高性能专用分析引擎 | 深度复用成熟平台的高性能计算 API,模型层沉淀企业专有语料资产 |
| 业务需求变更 | 变更依赖工程师手工修改 Prompt、微调模型或调整应用代码 | 业务人员在既有分析模型内自主筛选、下钻与创建看板,免开发介入 | 复杂计算逻辑由平台标准化承载,业务层应用编排由内部掌控 |
| 运维与治理责任 | 内部工程团队负责底层算力调优、口径对齐、版本演进与容错排错 | 平台厂商负责系统底层稳定性与引擎升级,企业专职负责内部数据治理 | 平台保障底层计算吞吐,企业算法团队负责自有模型的私有化调优与运维 |
| 适用技术团队 | 业务边界非常窄、已有现成指标 API 且有长期专职技术人员维护 | 缺乏基础分析引擎底座、希望快速为多业务部门交付自助分析能力 | 具备私有化大模型或高合规要求,但不想重复研发底层分析计算底座 |
路线一:自建专属问数应用
自建适合业务边界极为固定、查询模式相对简单的垂直场景。例如在单一业务宽表上查询固定的基础 KPI,且已有成熟的数据接口。技术团队只需编写轻量网关,完成自然语言到接口参数的映射。
但在该模式下,一旦业务部门需要下钻跨渠道转化路径、对比多版本客群留存或进行精细化归因,自建系统的边际研发成本将显著上升,团队面临复杂的算法重构压力。
路线二:引入企业级智能分析平台
对于需要面向企业全员提供自助式行为分析与数据探索的组织,引入成熟的企业级智能分析平台是更稳健的工程选择。例如在实际业务落地中,GrowingIO 增长分析 构建了完善的分析计算底座,原生内置事件分析、漏斗转化、用户路径、留存分析等专业模型,并提供无埋点与代码埋点相结合的采集能力。
系统搭载的 DeciAGI 架构通过大语言模型精准解析业务人员的查询意图,将自然语言转化为对底层成熟分析服务的 API 调用。这种“意图理解与底层计算分离”的设计,避免了大模型直面裸表写复杂 SQL 带来的幻觉与性能崩塌。
技术团队在此模式下并非无事可做,而是将重心转移到更有价值的数据治理工作上:统一业务口径定义、保障数据上报质量、配置组织权限映射。平台负责消除底层引擎与复杂算法的重复造轮子负担。
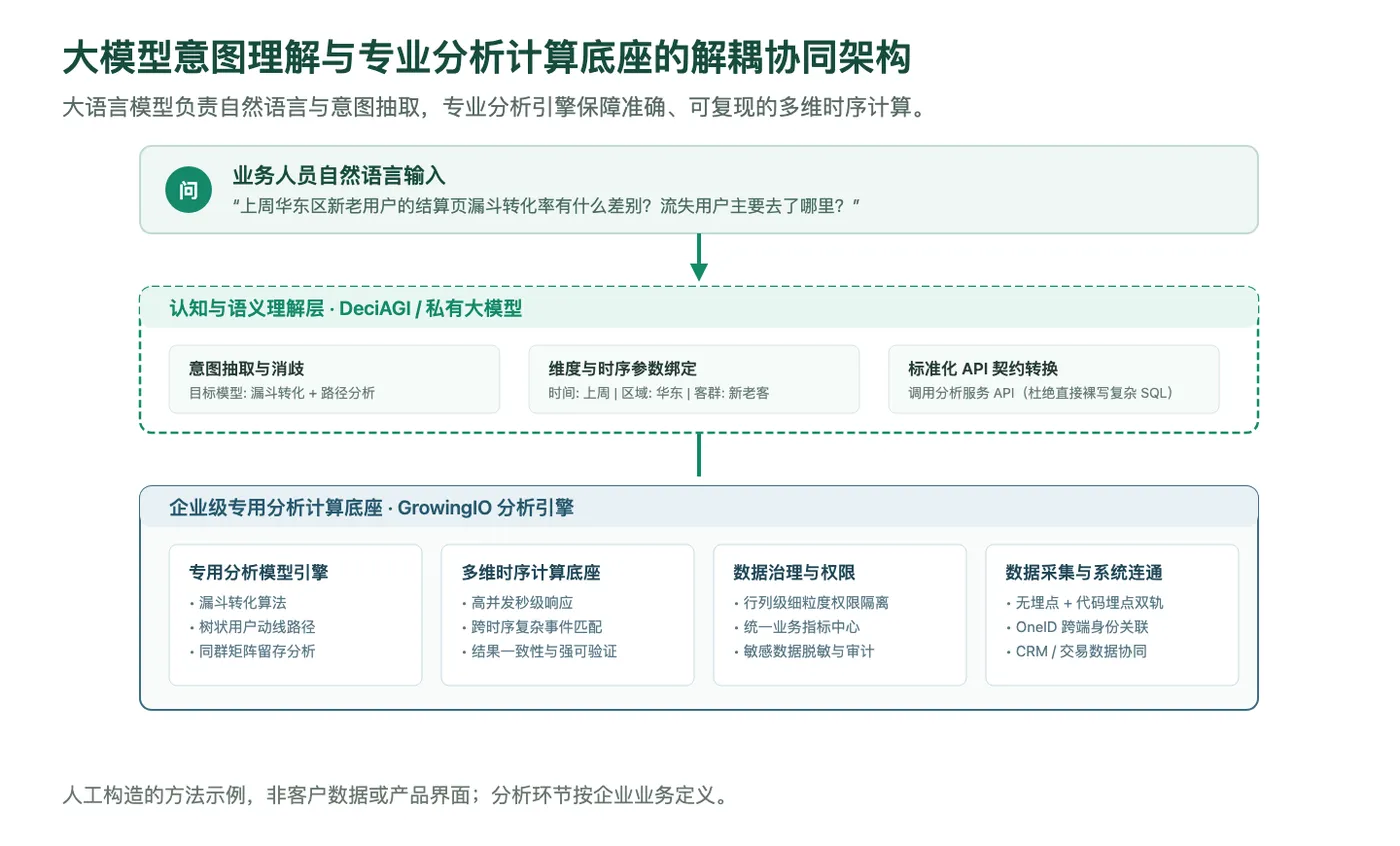
(注:图示模型协同架构与计算分工仅为技术原理示意,非真实客户数据)
路线三:组合建设,兼顾底层复用与技术自主
对于拥有自研大模型、沉淀了行业专有算法资产,或因数据安全要求严禁数据出域的企业,组合建设提供了兼顾效率与可控性的选项。
例如在私有化部署环境下,企业可以依托支持对接自有模型的 GrowingIO 智能问数 方案,将底层高并发分析计算引擎与内部私有化大模型结合。企业的自研大模型专注在专有业务语境的语义解析与意图抽取,而繁重的数据计算、权限校验与指标聚合则交由成熟的分析底座承载。
需要客观指出的是,私有化对接自有模型需要遵循严格的 API 契约与通信协议,并不等同于可以无缝接入任意外部 Agent 或第三方服务。技术团队在方案落地前,依然需要对协议标准、并发吞吐与鉴权机制进行严格测试与评估。
架构设计的核心原则:让模型做理解,让引擎做计算
在智能数据分析的技术选型中,架构师最需要建立的共识是:不要把大语言模型当成数据计算引擎使用。大语言模型的核心优势在于对非结构化自然语言的理解、意图抽取、语境总结与决策辅助;而企业级数据分析追求的是绝对精确、强一致性、低延迟和可验证的时序关联运算。
让大模型直接手写 SQL 跑数,是用模型的生成能力去硬抗严密的确定性计算,极易带来严重的幻觉与口径漂移;而将大模型与专业的分析引擎解耦配合,让大模型只负责理解“用户想看什么”,让专业分析服务负责“如何严谨地算出来”,才是支撑生产环境智能分析的稳固架构底座。
明确自研与采购的技术边界,理性评估团队的工程维护成本,企业才能在智能化浪潮中避免陷入重复造轮子的工程泥潭,让数据真正高效赋能业务决策。
