最近讨论度很高的 AI 模型:JEV。
它和常见的大模型不太一样。ChatGPT、Claude 这类模型更擅长对话、生成文本、写代码、解释问题;JEV 的定位更窄一些,主要用来做判断。调用接口后,它会根据输入内容返回结构化结果,程序可以直接读取这个结果,再决定下一步怎么执行。
这个特点很适合放在自动化流程里。
以 UI 自动化测试为例,传统脚本通常是提前写好步骤:点击哪个按钮、输入什么内容、断言哪个元素出现。只要页面结构稳定,这种方式没有问题。但在实际项目里,页面经常会出现一些不确定情况:
- 同一个业务入口在不同环境里文案不完全一致;
- 页面上有多个相似按钮,需要判断应该点哪一个;
- 执行失败后,需要先判断是定位器失效、等待不足,还是业务状态不满足;
- 探索页面时,需要在多个可操作元素中选择下一步动作。
这些地方如果全部交给固定规则处理,脚本会变得很复杂,也很难维护。如果全部交给通用大模型判断,效果通常可以,但调用成本和响应速度不一定适合频繁执行。
所以这次我尝试把原来的 UI 自动化流程做了一次改造:保留 Playwright 和 Skill 工作流的主体能力,只把其中需要“做判断”的环节交给 JEV。
简单说,就是让脚本不再完全机械地往下跑,而是在关键节点先判断一下。
*
原来的 UI 自动化流程
之前我做过一套基于 Playwright + Midscene 的双策略 UI 自动化 Skill 工作流。
大致流程是:
1. 先通过 Playwright 打开页面,获取页面快照;
2. 根据页面结构和任务目标,生成探索计划;
3. 根据计划生成自动化代码;
4. 执行代码,生成报告;
5. 如果执行失败,再走修复流程。

这套流程的优势是比较完整:从页面探索、计划生成、代码生成,到执行和修复,基本可以串起来。
但在实际使用时,也能明显看到一些环节不是简单规则能解决的。比如页面快照里有很多按钮,下一步应该点哪个;生成的计划是否已经覆盖主要路径;某个 locator 是否稳定;执行失败到底是页面没加载出来,还是代码选错了元素。
这些问题本质上都是判断题。
JEV 刚好适合放在这些位置。它不负责生成整段测试代码,也不负责替代 Playwright 执行操作,只负责在关键节点给出一个结构化判断结果。
*
哪些环节适合接入 JEV
这次改造主要放在两个 Skill 里:探索 Skill 和修复 Skill。
1. 探索 Skill:辅助选择下一步动作
页面探索阶段,Playwright 可以拿到当前页面的 snapshot。snapshot 里会包含页面上的文本、按钮、输入框、链接等信息。
以前的做法通常是根据规则或通用模型来判断下一步动作。比如看到“新增”按钮就点新增,看到“查询”按钮就尝试筛选。但实际页面没有那么标准,同一个页面可能同时有“新增”“导入”“导出”“批量删除”“高级筛选”等多个操作入口。
这时可以把页面快照、当前任务目标、已执行步骤一起传给 JEV,让它判断:
- 当前页面最合理的下一步操作是什么;
- 应该优先选择哪个控件;
- 当前计划是否已经覆盖主要路径;
- 某个 locator 是否存在稳定性风险。
JEV 返回结构化结果后,流程再按这个结果继续执行。
这里要注意一点:JEV 的作用不是“代替测试人员理解业务”,而是在页面探索过程中帮我们减少机械判断。真正的业务范围和测试重点,仍然要靠人来定义和确认。
2. 修复 Skill:先判断失败原因
自动化执行失败时,如果一上来就让模型直接改代码,容易出现两个问题:
一是改动范围过大。明明只是等待时间不足,结果把 locator 和断言都改了。
二是修复方向不稳定。失败原因没有判断清楚,后面修复就会带有猜测成分。
所以这次在修复 Skill 前面加了一步:先让 JEV 判断失败原因。
*
实操步骤
下面是这次基于 JEV 改造后的完整使用流程。
1. 配置环境变量
先创建 .env 文件,填写 JEV 的 API Key。
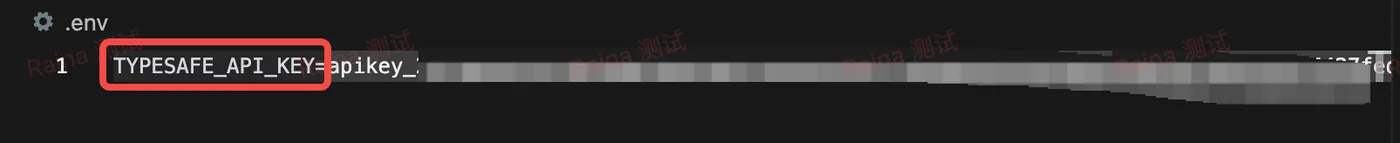
这里建议把配置和代码分开,不要把 API Key 直接写进脚本里。后续如果在 CI 或不同环境中运行,也更方便切换。
配置完成后,Skill 在需要做判断的地方会自动读取环境变量,再调用 JEV。
2. 探索页面
接下来执行探索 Skill。
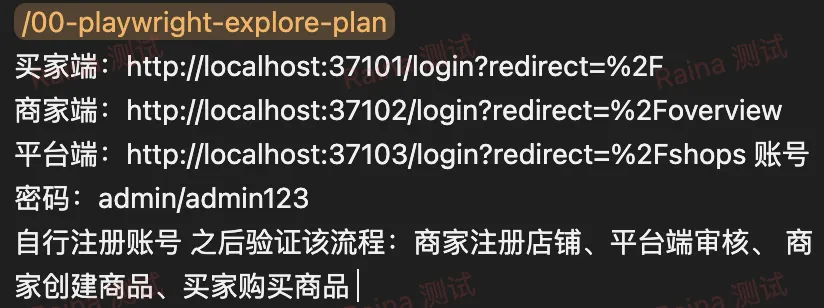
探索时,Playwright 会打开目标页面并生成 snapshot。流程会根据当前页面结构、任务目标以及历史步骤,判断下一步应该操作哪个元素。
在这个过程中,部分节点会调用 JEV 做决策。
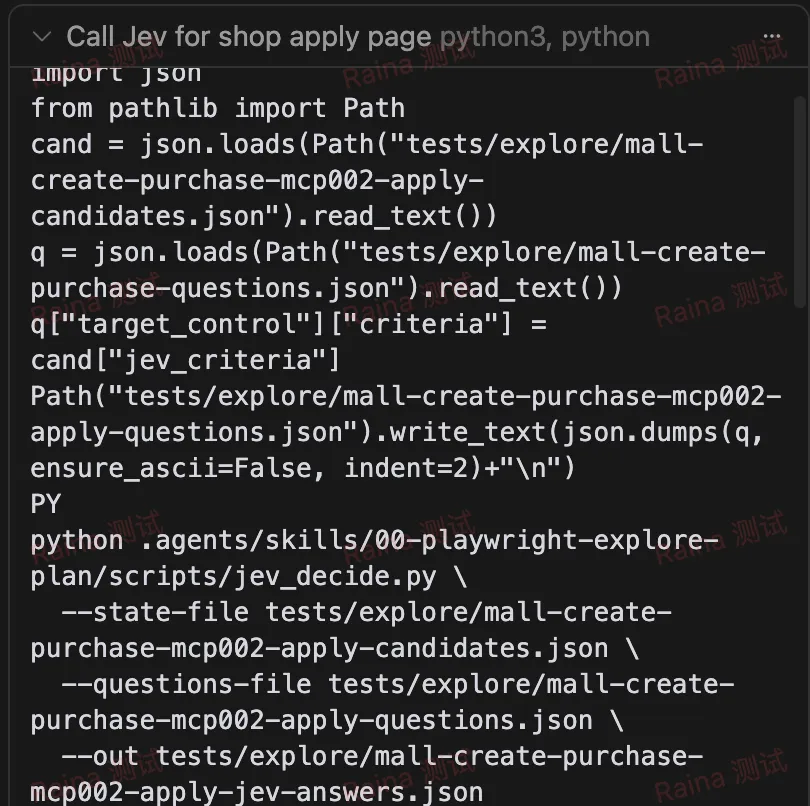
比如页面上同时存在多个可点击元素时,JEV 会结合目标判断当前更应该点击哪个入口;如果页面已经完成了主要路径探索,也可以判断当前计划是否足够完整。
探索完成后,会生成一份计划文件。
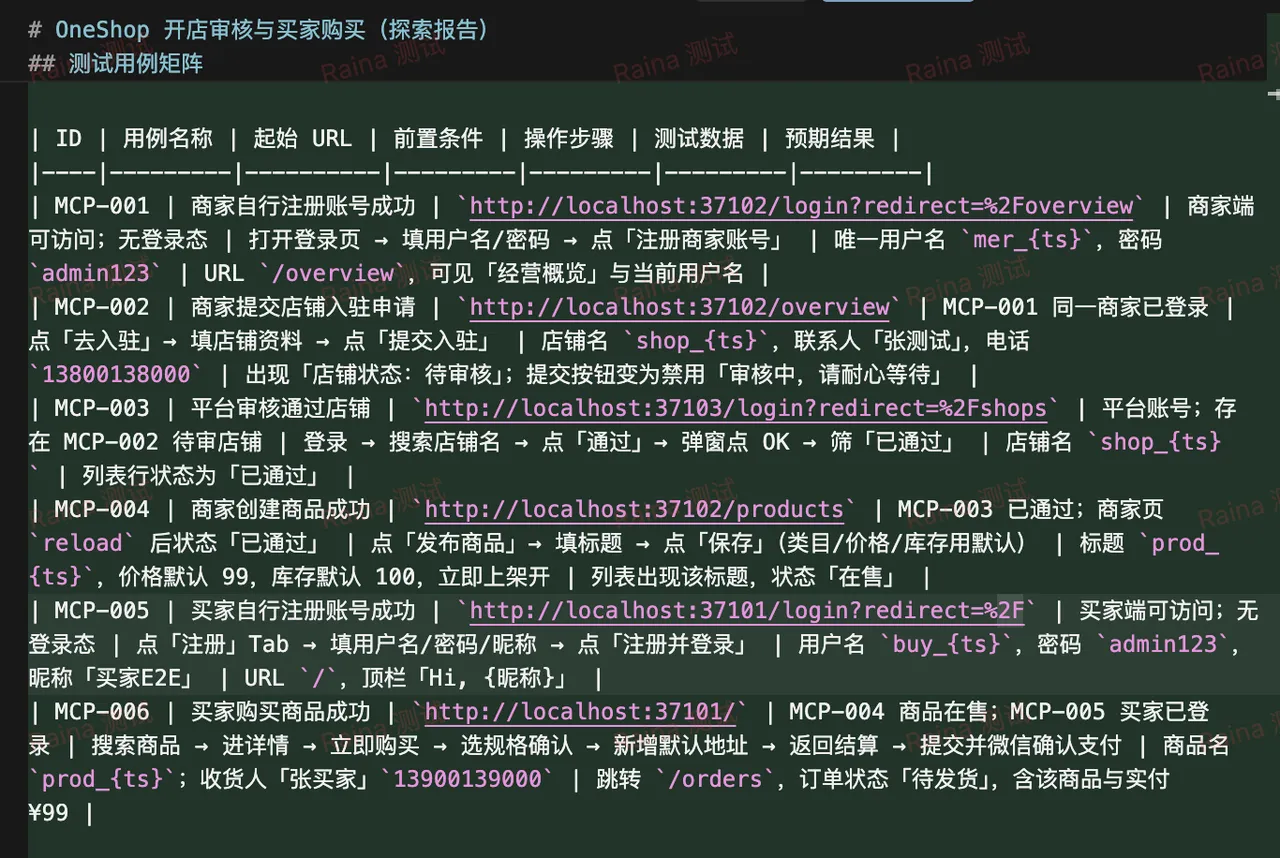
这一步不要急着直接生成代码。建议先看一遍计划,重点确认几件事:
- 目标页面是否探索完整;
- 主流程是否覆盖;
- 有没有明显不该操作的入口;
- 是否遗漏关键业务场景;
- 计划里的步骤是否符合真实业务逻辑。
如果计划有问题,先让 Skill 补探或调整计划。计划确认好,再进入代码生成阶段。
3. 生成自动化代码
计划确认后,就可以根据计划生成 Playwright 自动化代码。
生成结果如下:
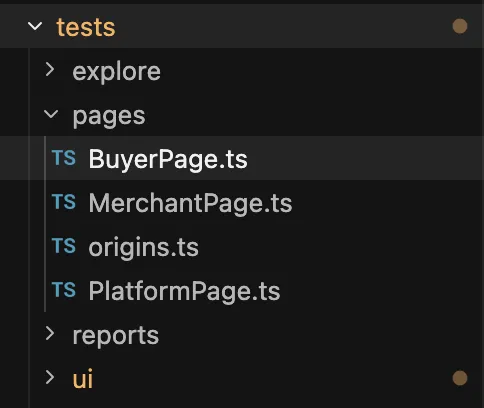
这里仍然建议保持代码可读,不要把所有逻辑都塞进一条长链路里。
比较理想的结构是:
- 登录、进入页面、准备数据等动作独立封装;
- 关键操作步骤保留清晰注释;
- 断言尽量和业务结果对应;
- locator 优先使用稳定属性,比如 role、label、test id。
JEV 可以辅助判断 locator 风险,但最终脚本还是要尽量遵循 Playwright 的最佳实践。否则一旦页面变化,后续维护成本还是会很高。
4. 执行代码
代码生成后,直接执行测试脚本。
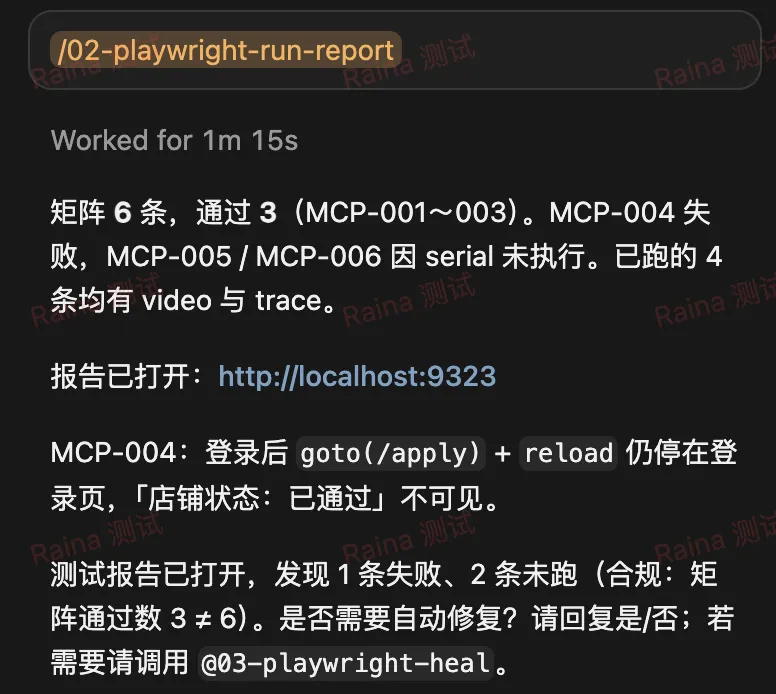
如果执行通过,就可以进入报告查看阶段。
如果执行失败,则进入修复流程。
这里需要区分两类失败:
一类是技术问题,比如元素定位不到、等待不足、页面还没加载完成就开始断言。
另一类是业务问题,比如账号没有权限、数据状态不对、页面本身报错、测试环境不稳定。
前者可以通过修复脚本解决;后者如果强行改代码,反而会掩盖真实问题。
所以修复前先做失败原因判断很重要。
5. 失败修复
如果执行过程中出现问题,就走修复 Skill。
修复 Skill 会先收集失败信息,再调用 JEV 判断失败原因。
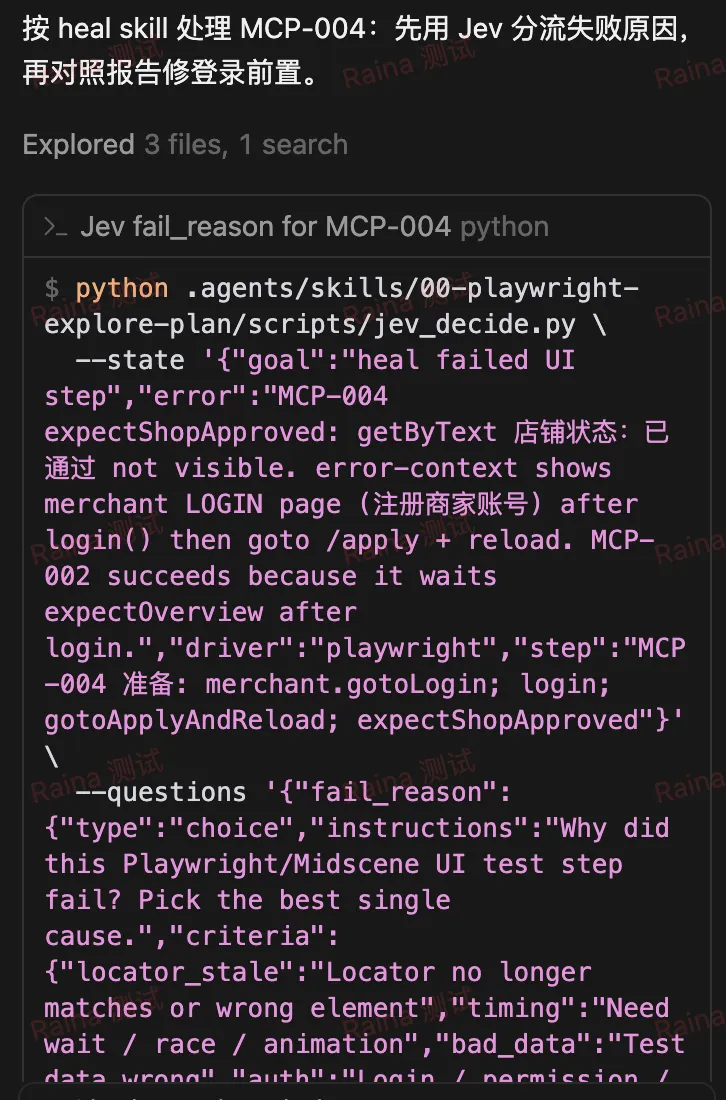
判断完成后,再按不同类型选择处理方式:
- 如果是 locator 问题,重新基于 snapshot 选择更稳定的定位方式;
- 如果是等待问题,补充可见、可点击、网络完成等等待条件;
- 如果是断言问题,检查断言对象是否符合页面真实反馈;
- 如果是测试数据问题,提示补充或重置前置数据;
- 如果是权限或登录状态问题,先处理账号和会话状态。
修复完成后,再重新执行脚本。必要时可以重复几轮,但不建议无限循环修复。
一般来说,如果连续多次修复仍然失败,就应该人工查看 trace、截图和日志,确认是不是业务流程本身有问题。
6. 查看报告
执行完成后,可以查看报告列表。
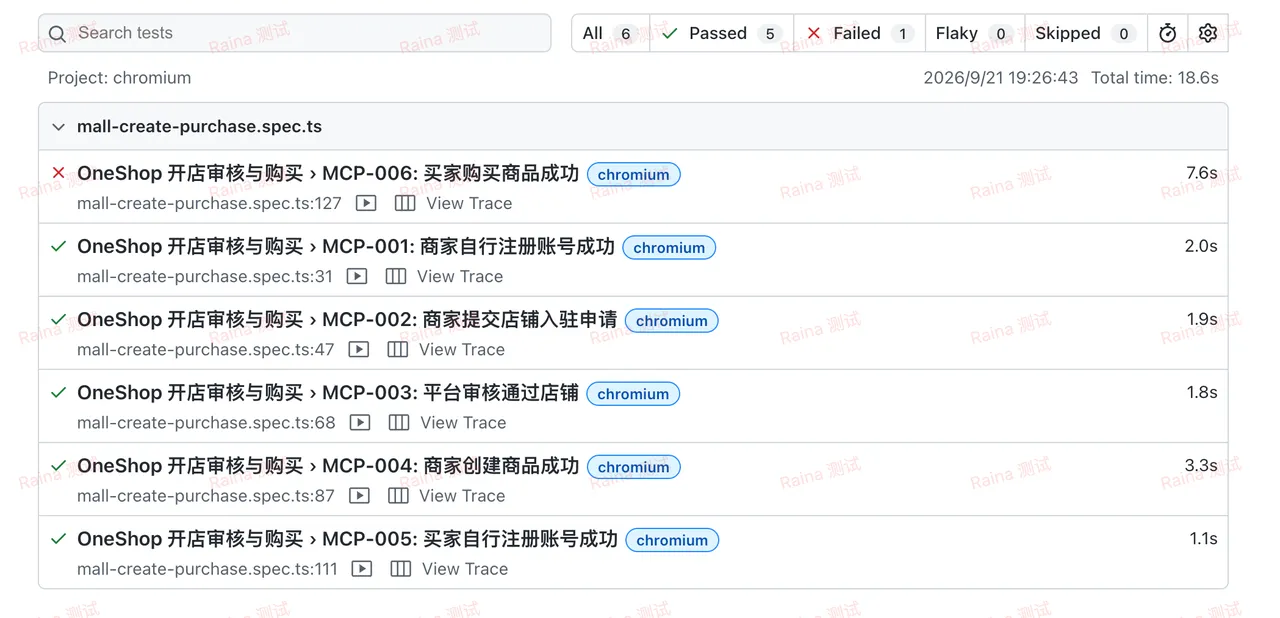
报告里最有价值的通常是两类信息。
第一类是执行视频。它可以还原脚本到底做了哪些操作,适合判断流程是否真的按预期走完。
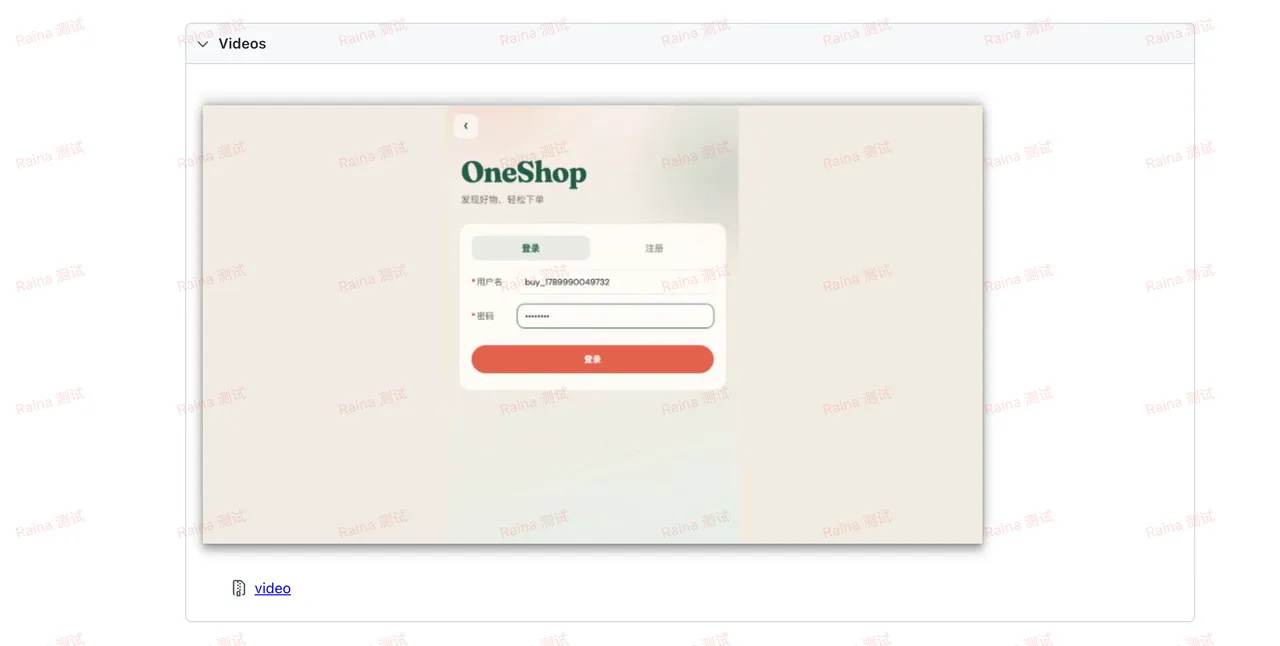
第二类是 trace。trace 会记录每一步操作、页面状态、网络请求和错误信息。定位失败问题时,比单看控制台日志更直观。
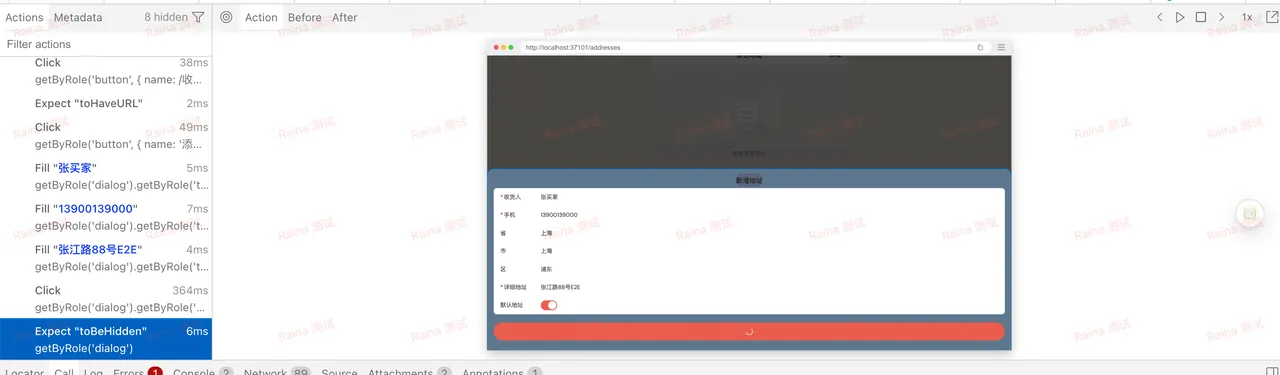
如果脚本是由 Skill 生成和修复的,trace 也可以反过来帮助我们判断:这次失败到底是计划不合理、代码生成不稳定,还是页面本身存在异常。
*
这套方案适合什么场景
基于 JEV 的 UI 自动化改造,并不是要把所有判断都交给模型。
它更适合这些场景:
- 页面探索过程中,需要在多个控件中选择下一步动作;
- 计划生成后,需要判断覆盖是否完整;
- 自动化执行失败后,需要先分类失败原因;
- 页面变化较频繁,希望降低 locator 维护成本;
- 希望在 Skill 工作流中加入更轻量的决策能力。
但它不适合解决所有问题。
比如业务规则本身不清楚、测试数据长期不可控、环境经常不可用,或者页面没有稳定可访问状态,这些问题不是接入一个判断模型就能解决的。
JEV 能提高的是“判断节点”的效率和稳定性,不会替代测试设计,也不会替代环境治理。
*
一点实践建议
这次改造下来,我觉得有几个点比较重要。
第一,不要让模型直接掌控完整流程。
UI 自动化里真正稳定的部分,还是应该交给 Playwright 这类确定性工具。模型适合做判断,不适合替代所有执行逻辑。
第二,判断结果要结构化。
如果 JEV 只返回一段自然语言,程序还要再解析,稳定性会差一些。更好的方式是让它返回固定字段,比如 action、target、reason、confidence、risk,这样后续流程才能可靠消费。
第三,失败修复要先分类,再改代码。
很多自动化脚本越修越乱,就是因为没有先判断失败原因。等待问题、定位问题、数据问题、权限问题,对应的处理方式完全不同。
第四,计划文件必须人工确认。
AI 可以帮我们探索页面、整理步骤、给出建议,但测试范围是否合理、业务链路是否正确,仍然需要人来把关。尤其是涉及资金、权限、审批、状态流转这类功能,更不能跳过确认环节。
*
总结
这次基于 JEV 的改造,核心不是把 UI 自动化“AI 化”,而是把原来流程中需要判断的部分单独抽出来,让更适合判断的模型来处理。
Playwright 继续负责浏览器操作,Skill 继续负责组织工作流,JEV 负责在探索和修复阶段做决策辅助。
从实践效果看,这种方式比较适合作为 UI 自动化工作流的增强层。它不会让自动化测试一步到位,但能减少一些重复判断和无效修复,让脚本生成、执行、修复这条链路更顺一些。