
Anthropic有一个未发布的新模型被 The Information 报道,核心卖点是"理解用户真实意图"——在信息有限时判断用户真正想解决的问题。
官方没有确认,参数未知。这篇不谈模型本身,谈一个工程问题:如果意图推断能力真的上了一个台阶,现有的 Agent 架构该怎么改。
读者画像:正在做 Agent / 工作流编排的工程师。
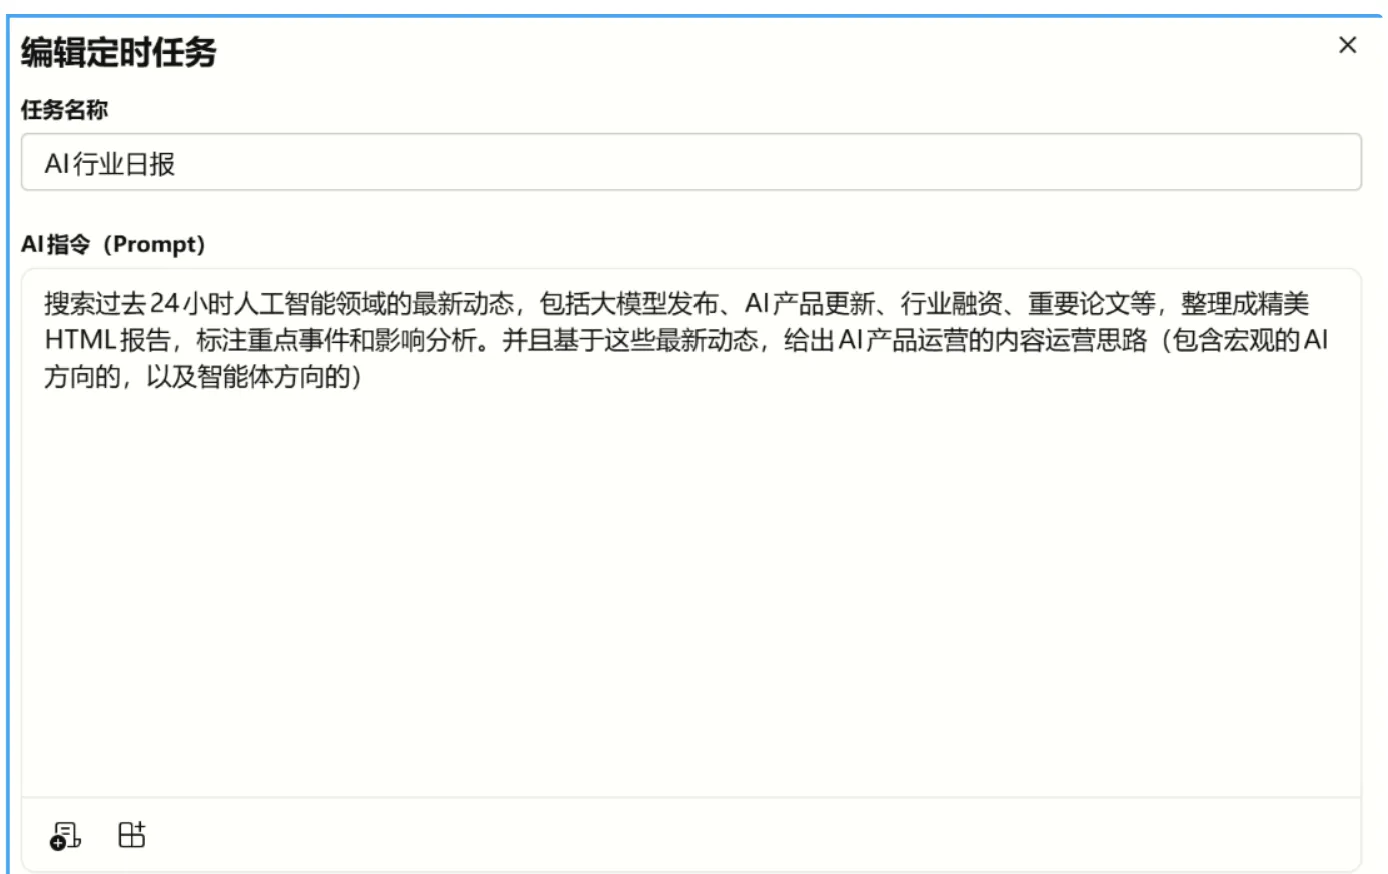
而我之所以知道这个消息,是因为我在AiPy(一个桌面智能体)安了定时任务,它会在我每天打开后自动整理AI行业的信息,我不用自己前前后后安装,只需要描述需求即可。最后它会给你一个html,非常方便。感兴趣的可以来尝试,也可以用自己觉得顺手的工具做一个。

现状:意图识别是硬编码的
现在大部分 Agent 的意图识别,靠的是一层显式的分类器或者规则:
def route_intent(user_input: str) -> str:
    if any(k in user_input for k in ["报错", "异常", "error"]):
        return "debug"
    elif any(k in user_input for k in ["优化", "重构", "性能"]):
        return "refactor"
    elif any(k in user_input for k in ["写", "生成", "实现"]):
        return "generate"
    else:
        return "chat"
这套东西的问题很明显:
- 关键词覆盖不全,用户换个说法就漏
- 多意图混杂时无法处理("这段代码又慢又难读,帮我改改")
- 上下文完全没用上,每一轮都是独立的
更常见的做法是加一层 LLM 做意图分类,但本质还是"先分类,再路由",多一次调用,多一次延迟,而且分类错了后面全错。
变化一:从"先分类后执行"到"边执行边修正"
如果模型能在信息不全时做出合理推断,架构上可以省掉显式分类这一步。
原来的链路:
用户输入 → 意图分类 → 路由到工具 → 执行 → 返回
可以改成:
用户输入 + 上下文 → 模型直接决定动作 → 执行 → 观察结果 → 必要时修正
差别在于,意图不再是执行前的一个独立步骤,而是执行过程中的一个副产品。
工程上的影响:
- 少一次 LLM 调用,延迟下降
- 分类错误的成本从"整条链路走错"变成"走错一步就纠正"
- 但需要执行层支持快速回退,否则纠错成本更高
这就要求工具调用要幂等,或者至少可回滚。现在很多 Agent 的工具设计是"一次性执行",改完就落地,没有中间态。这种设计在新架构下会很吃亏。
变化二:上下文组装从"可选"变成"核心"
意图推断的前提是有信息可推。信息从哪来?上下文。
现在大部分 Agent 的上下文组装很粗糙:把最近 N 轮对话拼进去,塞进 system prompt,完事。
如果模型要"在信息有限时判断用户真正想解决的问题",那喂给它的信息质量直接决定推断质量。
需要重新设计的东西:
上下文的层次。 不是所有历史都等价。当前文件内容、最近一次报错、用户最近三次的操作,权重应该远高于三天前的闲聊。
上下文的时效。 编辑器里的代码是实时的,对话历史是滞后的。两者的时间戳要对齐,否则模型会基于过期信息做推断。
上下文的取舍。 塞太多会稀释信号。现在的做法通常是"能塞多少塞多少",未来应该是"只塞和当前意图相关的"。
这块工程量大,但收益直接。上下文组装做得好,等于免费获得了一部分意图推断能力。
变化三:追问策略要显式设计
现在 Agent 的追问基本是两种极端:
- 不追问,直接猜,猜错了让用户重来
- 频繁追问,把用户当表单填
意图推断变强之后,追问应该变成一个有成本判断的决策:
追问成本 = 用户等待时间 + 打断心流的代价
猜测成本 = 猜错的概率 × 猜错后返工的成本
只有当"猜测成本 > 追问成本"时才追问。
这个判断现在没人做,因为模型不知道自己猜得准不准。但可以做近似:
- 上下文充分度(有没有相关文件、有没有报错、历史轮次够不够)
- 任务的可逆性(改代码可回退,发邮件不可回退)
- 用户的历史行为(这个用户是不是经常一句话就发)
可逆性这一条特别重要。不可逆的操作必须追问,哪怕模型有 95% 的把握。 删数据、发消息、提交订单,这类操作猜错的代价不是"重来一次",是"没法重来"。
一个具体的改造清单
如果你手上有一个 Agent 项目,可以按这个顺序改:
- 先做上下文组装。 把编辑器状态、最近报错、git 状态接进来,比换模型见效快
- 把工具改成幂等的。 至少让写操作有 dry-run 模式,为"边执行边修正"铺路
- 给追问加成本判断。 先按"可逆/不可逆"二分,不可逆的一律追问
- 最后才考虑换模型。 前面三件事做完,用现有模型也能有明显提升
一点保留
The Information 的报道没有给出任何技术细节,也没有第三方复现。"在信息有限时判断用户真正想解决的问题"这句话,从产品描述翻译成技术能力,中间有多少水分,现在判断不了。
历史上类似的"神秘新模型"消息,最终落地的形态往往和传闻有出入。所以上面这些改造建议,不依赖那个模型是否真的发布——上下文组装、幂等工具、追问策略,这三件事用现在的模型做,也是净收益。
把架构改到"能接住更强的意图推断",比赌某个模型什么时候发布,确定性高得多。

