本文首发于 CSDN(原文链接:https://blog.csdn.net/java_raylu/article/details/168551924)
最近我想验证一个很具体的假设:GitHub 的默认搜索,到底看不看 README?
起因很朴素。我们维护一个数字商品方向的开源仓库,在几个细分词上,仓库名、描述和内容都比排在前面的仓库更匹配,但默认搜索就是搜不到;反过来,一些 star 更少、更新更慢的仓库却排在前面。于是我干脆做了一次对照实验:只改元数据,不改代码,然后在 24 小时内跑 3 轮、每轮间隔 30 分钟,取中位数。
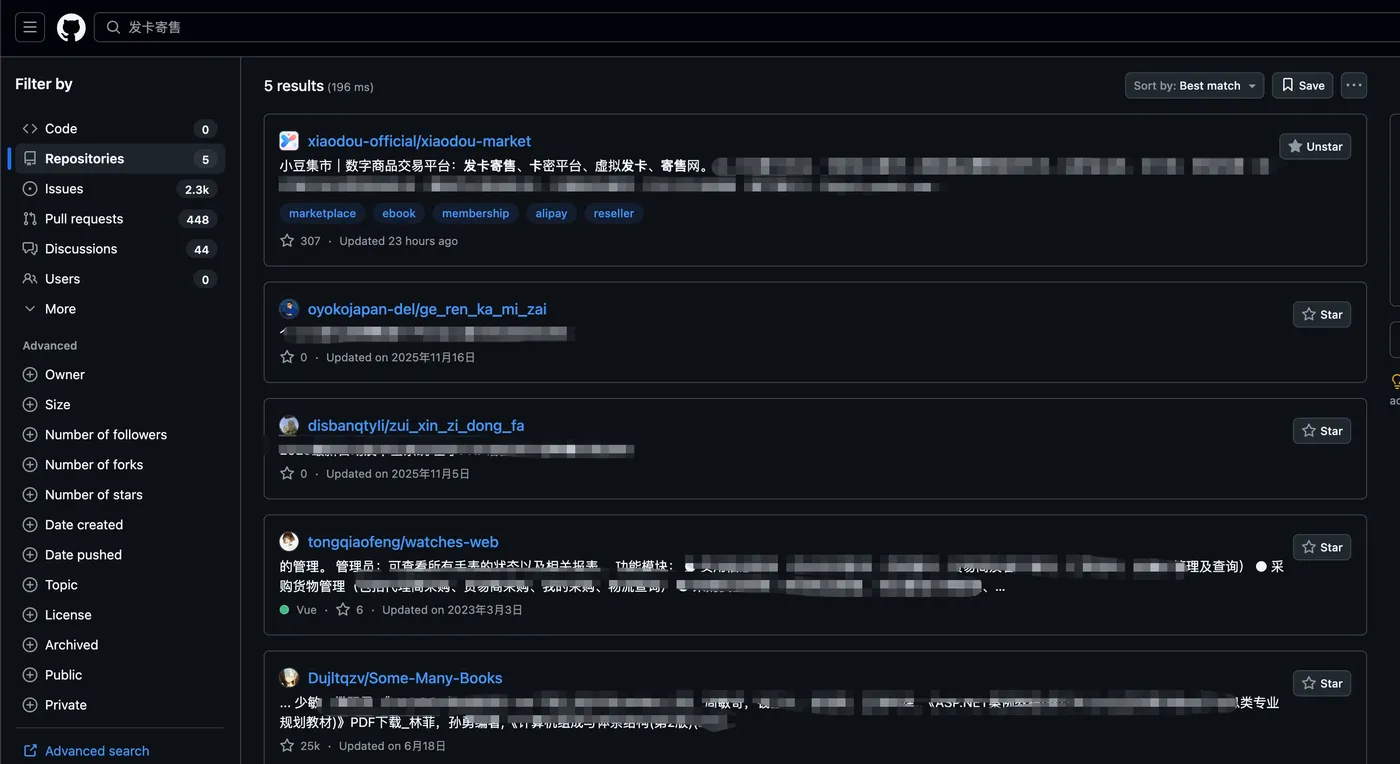
先说结论:**GitHub 默认搜索主要看仓库名、About 描述和 Topics;README 是另一套入口,只有显式用 `in:readme` 才会明显读到正文。** 同一个关键词 `发卡寄售`,改前默认搜索只有 4 条结果,`in:readme` 有 1,504 条——两者不是一个量级。把精确短语放进 About 的前 60 个字符,比在 README 里堆十遍更有效。
## 1. 默认搜索到底搜什么
我一开始也以为 GitHub 搜索会像 Google 一样读 README。实际测试下来,默认搜索(Best match)更像是在做“仓库元数据匹配”:
- 仓库名;
- About 描述;
- Topics(只接受小写字母、数字、连字符);
- 以及 stars、更新时间、issue/PR 活跃度等 best match 信号。
README 是另一套入口:只有加 `in:readme` 才会进正文索引。这个区分很关键——很多人把关键词全塞进 README,默认搜索根本读不到;而 About 只有 350 字符,前 60 字符又是搜索结果里最容易被看到的,值得单独设计。
这不是 GitHub 官方公布的完整排序公式,只是我在这次实验里观察到的稳定规律。stars 和活跃度仍然会影响 best match,所以下面的数据不能理解成“改了描述就一定第一”。
## 2. 怎么测:15 个词、3 轮、中位数
测量方法很简单,但有两个细节必须做对:
1. 同一个词至少跑 3 轮,每轮间隔 30 分钟以上,取排名中位数;单次快照会骗人,今天 #3、明天掉出前 100 是常态。
2. 用 `per_page=100` 拉满前 100 条,再在结果里找自己的仓库;不要只看第一页。
脚本用 `gh` 的 API,不需要额外依赖:
```python
import json
import subprocess
import time
QUERIES = [
'发卡寄售', '24 小时发卡平台', '寄售网', '数字商品寄售', '虚拟商品寄售',
'卡密寄售', '数字商品交易平台', '卡密自动发货', '卡密平台', '发卡平台',
'自动发卡', '发卡', '虚拟发卡', '发卡网', '发卡系统',
]
for q in QUERIES:
r = subprocess.run(
['gh', 'api', '--method', 'GET', 'search/repositories',
'-f', f'q={q}', '-f', 'per_page=100'],
capture_output=True, text=True,
)
if r.returncode != 0:
print(q, 'API_ERROR', r.stderr.strip()[:200])
time.sleep(2)
continue
data = json.loads(r.stdout)
items = data.get('items', [])
rank = next(
(i for i, item in enumerate(items, 1)
if item['full_name'] == 'OWNER/REPO'),
None,
)
print(q, data.get('total_count'), rank or 'not in top100')
time.sleep(1) # 避开 GitHub search 的二次限流
```
改动后 10–15 分钟跑第一轮,之后每隔约 30 分钟跑一轮,第三轮在当天 20:43 完成。下面的“改后”全部是三轮中位数,不是最好那一次。
## 3. 改了什么:只动元数据,不动代码
改动只有三处:
**About 描述。** 总长约 240 字符,前 60 字符放最强的两个精确短语,后面接一句人话说明。没有把十个词排成关键词清单——那样读起来像 spam,也容易被判定低质。
**Topics。** 补了 5 个英文检索词(如 `faka-platform`、`card-key-marketplace`、`digital-goods-consignment`),同时删掉几个泛词(国家名和通用词)。Topics 对中文查询基本无效,主要服务英文检索和主题识别。
**README。** H1 改短,加了一张“常见叫法”表,把用户可能搜的词和平台叫法对应起来;再加了几条 FAQ 和一段英文摘要。README 主要是给 `in:readme` 和人类看的,不是默认搜索的主战场。
没有买 star,没有刷 issue,没有批量关注。仓库本身有约 300 star,这是实验的控制变量:排名变化发生在元数据改动后的 10–15 分钟内,而不是 star 突增之后。
## 4. 结果:零结果的细分词进了第一,强词保持
改前 → 改后(2026-10-19,三轮中位数):
| 关键词 | 改前结果数 | 改前排名 | 改后中位数 |
| --- | ---: | ---: | ---: |
| 发卡寄售 | 4 | 未进前 100 | **#1** |
| 24 小时发卡平台 | 0 | 未进前 100 | **#1** |
| 寄售网 | 8 | 未进前 100 | **#1** |
| 数字商品寄售 | 4 | 未进前 100 | **#1** |
| 虚拟商品寄售 | 2 | 未进前 100 | **#1** |
| 卡密寄售 | 4 | 未进前 100 | **#2** |
| 数字商品交易平台 | 52 | #2 | **#2**(保持) |
| 卡密自动发货 | 48 | #8 | **#8**(保持) |
| 卡密平台 | 114 | #17 | **#7** |
| 发卡平台 | 392 | #48 | **#17** |
| 自动发卡 | 609 | #66 | **#36** |
| 发卡 | 3,108 | 未进前 100 | **#88** |
| 虚拟发卡 | 142 | 未进前 100 | #13 |
| 发卡网 | 516 | 未进前 100 | #25 |
| 发卡系统 | 747 | 未进前 100 | **仍未进前 100** |
英文侧(默认搜索,非 `in:readme`):
- `faka platform`:改前默认 5 条、未进前 100 → 改后 **#3**;
- `digital goods consignment`:改前 0 条 → 改后 **#1**;
- `virtual card code marketplace`、`card key auto delivery`:仍未进前 100。
2026-10-20 我又跑了一次单轮复核:15 个中文词的排名与上表一致(`发卡` #88 → #89,其余不变),英文侧也不变;结果数只增加了几条(有新仓库进来)。这说明这组数据至少隔天可复现,不是单日偶然。
最直观的规律:**结果数只有个位数甚至 0 的细分词,排名变化最快;几百上千条的泛词,提升慢得多。** 如果你要做冷启动,先找那些“搜得到但没人认真做”的词,而不是一上来冲大词。
## 5. 没做到的,以及一个真实的取舍
这次实验不是全线第一,有三个失败项值得写出来:
1. **`发卡系统` 仍未进前 100。** 这个词有 747 条结果,前排是几个 star 很高、更新很勤的老仓库,靠改 About 追不上。它不在这次的目标里,我也没有为它继续堆词。
2. **`虚拟发卡` #13、`发卡网` #25。** 都从“未进前 100”大幅改善,但没进前 10;泛词需要更长时间的活跃度和外部链接,不是一次元数据改动能解决的。
3. **英文侧有一个取舍。** 改前 About 的英文尾是 `China digital goods marketplace`,默认搜索 #1;为了覆盖 `faka platform`,我把英文尾换成了 `faka platform`,结果前者从 #1 掉到无结果。About 只有 350 字符,英文短语最多放 2–3 个,**换词就是换覆盖面**,不存在全都保住。
还有一个必须承认的边界:GitHub 的 best match 会漂移。同一周内,同一个词的单次快照可能从 #3 掉出前 100;所以本文所有结论都基于三轮中位数,而不是某一次截图。
## 6. 可复用的五条
1. **About 前 60 字符放最强精确短语**,后面写人话;不要排成关键词清单。
2. **Topics 放 5 个英文检索词**,不堆拼音;国家名和泛词换成品类词。
3. **README 写给 `in:readme` 和人类看**,默认搜索不吃正文;H1 短、加“常见叫法”表和 FAQ。
4. **同一个词跑 3 轮取中位数**,每轮间隔 30 分钟以上;单次快照只当参考。
5. **不买 star、不刷 issue**;排名会漂移,改动后 1–2 周再复查一次,别在发布当天反复改 About。
这次实验没有让所有词都第一。它只是把几个零结果的细分词做到了 #1,把原来的强词保持住,并且让我确认了一件事:**在 GitHub 上,把词放对地方,比把词写多更重要。**
实验仓库 github.com/xiaodou-official/xiaodou-market;产品 小豆集市 xdjishi.cn