
一篇写给正在被 ISP_FLOW_CONTROL_LIMIT 折磨的同行。
结论先给:QPS 不是"申请"来的,是"换"来的——用资质换基础配额,用业务说明换权限,用资源包换速率。而限流兜底的核心不是加大重试次数,是让系统在限流时不产生脏数据、不雪崩、不被告警淹没。
我做过几年电商开放平台对接,1688 这条线踩过的坑比淘宝、京东都多。原因不复杂:1688 是 B2B,接口天然带"批发"属性——一次拉几百个 SKU、一次查几十个 offer,调用密度比零售平台高一个量级,而免费配额是照零售的量给的。
所以问题从来不是"我的代码写得对不对",而是"我把一个不该这么用的接口,用在了不该这么用的场景"。
下面按这个顺序讲:先搞清限流到底怎么算的,再讲怎么把配额要到手,最后讲被限流之后怎么兜。
一、先搞清一件事:限流是按什么维度算的
很多人以为 QPS 是按"我账号总共能打多少次/秒"算的,于是拼命加机器、加线程。错。
实际生效的通常是好几个维度中最先打满的那个: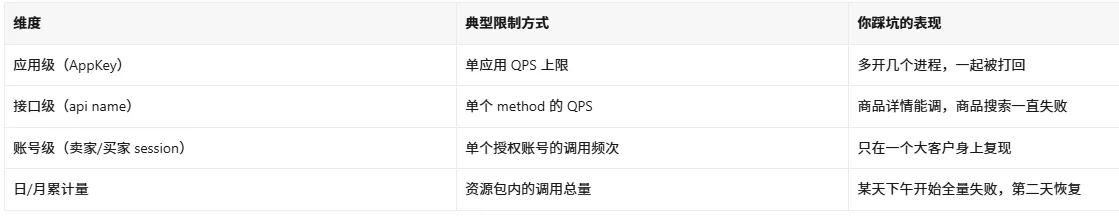
这四层的意义在于:你被限流时的"修复动作"完全取决于哪一层打满。
- 应用级打满 → 降并发、加令牌桶,或者提额
- 接口级打满 → 换接口(比如用批量接口替代循环单品接口)
- 账号级打满 → 排队调度,按账号分桶
- 累计量打满 → 只能买资源包
我见过最冤的一次:一个团队把商品详情接口的 QPS 从 10 提到 50,然后发现搜索接口还是崩。因为额度是按接口算的,提的那个额度没提到搜索接口上。提额之前,先确认你要提的是哪一层的哪个接口。
二、QPS 怎么"申":其实是四步,缺一步都白跑
严格说,1688 没有"提交一个 QPS 数字等审批"这种入口。你能做的是把前置条件铺好,让配额自然到位。四步:
第 1 步:主体资质——个人开发者在这里就出局了 - 必须企业实名认证,营业执照 + 法人信息 + 对公账户
- 经营范围最好含"软件开发 / 供应链服务 / 信息技术服务 / 跨境电商",这一条在人工审核时是真的会被看的
- 审核通常 1–3 个工作日
踩坑提醒:用个人账号接,商品公开接口能调通,让你以为"通了",等到接订单才发现整片权限都开不出来,返工成本很高。
第 2 步:建对应用类型——自用型和 ISV 型别选错
两种类型,走的是两条完全不同的链路: - 自用型:只给自己公司内部系统用,授权简单,审核快,配额申请也简单
- 第三方服务商(ISV)型:给外部商家用,要走服务市场上架、额外资质审核、多用户 OAuth 授权
选错的代价:自用型拿去服务客户,会被判定为场景不符;ISV 型只想内部用,会被迫走一堆上架流程。你是给谁用,就选哪个,别图省事。
另外应用描述不要含糊。我看到过有人写"用于数据采集和分析",直接驳回。写成这样通过率高得多:
本应用用于企业采购供应链管理:同步供应商商品与库存信息、对接内部 ERP 生成采购单、跟踪物流状态,无爬虫批量采集行为。
把"不做什么"写进去,反而更容易过。
第 3 步:申请接口权限——这里才是"申请 QPS"的真正入口
在应用详情里逐个申请接口权限,申请理由里必须写清三件事:场景、日均调用量、峰值 QPS。
示例(可直接改用):
业务场景:自研 ERP 为内部 3 个采购团队同步 1688 供应商商品与库存,用于自动生成采购单。
日均调用量:商品详情约 12 万次,订单查询约 2 万次。
峰值 QPS:商品详情 15,订单查询 8,集中在每日 9:00–11:00。
当前瓶颈:现有配额下批量同步任务无法在营业时间内完成,需要提升至上述峰值。
为什么这么写有用:审核的人每天看几百条"申请提升调用量",只有把数字和业务动作讲清楚的,他才知道批多少合理。你给具体数字,他反而省事。
权限分级大致是:商品类基础接口基本秒批;交易/订单类需要人工审核 1–3 天;分销、跨境、实时库存这类要走单独审批甚至平台小二对接。
第 4 步:提额的两条正规路径
路径 A:购买资源包。 在控制台的服务市场买 API 资源包,按档位把单应用 QPS 提到 50 / 100 / 200,同时开通高级接口(实时库存、分销族等)。这是最直接、最可控的方式。
路径 B:多应用分摊。 同一企业主体下可以创建多个应用,做轮询分摊。理论上总速率 = 单应用上限 × N。
但路径 B 有个必须讲清的前提:这是在分摊合法业务流量,不是用来绕过风控。如果是为了刷数据、批量采集而开一堆应用,那是另一回事,会被识别、会被处置,也不值得——靠这个做业务,本身就是个不稳定的地基。
第 5 步(很多人漏掉):白名单
服务器出口 IP 白名单不配,直接 403。回调地址、OAuth 授权域名同理。这一步不做,前面的申请全部作废。
三、限流长什么样:先认出是哪种"错"
被限流的返回值不止一种,处理方式完全不同。混淆它们会导致越重试越糟。
现象
大概率原因
该怎么办
返回 ISP_FLOW_CONTROL_LIMIT
速率超限(瞬时 QPS 打满)
降速 + 退避,不要立刻重试
HTTP 429
同上,网关层拦截
优先读响应头里的 Retry-After
no permission to access this api / 403
权限没开,不是限流
去控制台申请权限,重试无效
一段正常、某个时段全挂
日/月累计量打满
查资源包余量,只能买包或等重置
单账号复现、其他账号正常
账号级频次限制
按账号分桶排队
最要命的是第 3 种被当成第 1 种处理。权限没开,你重试一百次也是失败,还会把日志写满、把告警打爆、把运维半夜叫起来。
第一件事永远是错误分类,不是重试。
四、兜底:我实际在用的四层结构
下面这套是我在项目里稳定跑过两年的结构。核心思想:限流不是异常,是常态。既然常态,就要让它不影响正确性。
第 1 层:客户端主动限速(令牌桶)
不要等平台来限你,自己先把自己限住。留 20% 余量是硬经验——配额 10 QPS,客户端压到 8。原因有两个:一是配额计算有毫秒级窗口抖动,二是持续打满会被风控额外关注。
import time
import threading
class TokenBucket:
"""线程安全令牌桶(预约制)。
rate:  每秒放行的令牌数,建议设为配额的 0.8
burst: 允许的瞬时突发量,默认 1 表示严格平滑(不攒突发)
"""

def __init__(self, rate: float, burst: float = 1.0):
    if rate <= 0:
        raise ValueError("rate must be > 0")
    self.rate = rate
    self.capacity = float(burst)
    self._tokens = self.capacity
    self._last = time.monotonic()
    self._lock = threading.Lock()

def acquire(self, tokens: float = 1.0) -> float:
    """阻塞直到拿到令牌,返回实际等待的秒数。"""
    with self._lock:
        now = time.monotonic()
        self._tokens = min(self.capacity,
                           self._tokens + (now - self._last) * self.rate)
        if self._tokens >= tokens:
            self._tokens -= tokens
            self._last = now
            wait = 0.0
        else:
            wait = (tokens - self._tokens) / self.rate
            self._tokens = 0.0
            # 关键:时间基准直接推到"睡醒那一刻",否则这段等待会被
            # 下一次调用重复算成"自然恢复",实际速率变成两倍。
            self._last = now + wait
    if wait > 0:
        time.sleep(wait)
    return wait
⚠️ 三个必须注意的点:
- burst 默认给 1。如果把桶的容量设成 rate,首轮任务会瞬间放行 rate 个请求——你以为是"平滑限速",实际是"先来一波 10 QPS 的突发",正好撞在平台的风控上。要平滑就别攒突发。
- 睡完之后必须把时间基准前推到"睡醒那一刻"(上面那行 self._last = now + wait)。这是手写令牌桶最常见的 bug:漏掉这一行,等待时间会被下一次调用当成"令牌自然恢复",实际速率直接翻倍——你限了 8 QPS,实际打出去 16。这个 bug 不会报错,只会让你的限流悄悄失效。
- 令牌桶必须每个进程 / 每个应用单独一个实例。如果你部署了 5 个 Pod,每个 Pod 各 8 QPS,合起来就是 40 QPS——早就超了。多实例场景要么用 Redis 做分布式令牌桶,要么每个 Pod 的 rate 除以实例数。
多实例时:每个实例分到的速率
per_instance_rate = total_qps_limit 0.8 / instance_count
bucket = TokenBucket(rate=per_instance_rate)
关于并发场景的一个重要提醒:上面这个"预约制"写法,我已经在单线程和 4 线程两种场景下实测,速率与理论值一致(8 QPS 跑 20 次耗时 2.38 秒,理论值 2.375 秒)。但如果在多线程下每次批量取多个令牌(比如一次取 100),线程之间会互相插队,实际速率会明显偏离。生产环境里多线程批量限速,别自己写——直接用现成的 aiolimiter(异步)或 pyrate-limiter(同步/异步,支持 Redis 多实例共享)。限速器这种东西,自己手写的价值几乎为零,出错的代价很大。
第 2 层:重试要退避,而且要带抖动
固定的 2*i 退避有个致命问题:所有失败的请求会在同一时刻重试,形成重试风暴——你本来只是偶发限流,结果被自己的重试打成持续限流。
import random
import time
def backoff_delay(attempt: int, base: float = 1.0, cap: float = 30.0,
retry_after: float = None) -> float:
"""指数退避 + 随机抖动。优先尊重服务端给的 Retry-After。"""
if retry_after is not None:
return min(retry_after, cap)
# full jitter:在 [0, base * 2^attempt] 之间随机
raw = min(cap, base * (2 ** attempt))
return random.uniform(0, raw)
full jitter(全抖动)比"固定退避"效果好得多,因为它把重试时间摊开了。这是 AWS 那篇著名的 Exponential Backoff and Jitter 里的结论,在接口限流场景同样成立。
第 3 层:错误分类 + 熔断
class ErrKind:
RETRYABLE = "retryable" # 限流、超时、5xx
FATAL = "fatal" # 签名错、无权限、参数非法
UNKNOWN = "unknown"
def classify(resp_code: str, http_status: int, body: str) -> str:
if http_status == 429 or "FLOW_CONTROL" in body:
return ErrKind.RETRYABLE
if http_status == 403 or "no permission" in body:
return ErrKind.FATAL # 别重试,去开权限
if "sign" in body.lower() and "invalid" in body.lower():
return ErrKind.FATAL # 签名错,重试也没用
if http_status >= 500 or http_status == 0:
return ErrKind.RETRYABLE
return ErrKind.UNKNOWN
配套一个简单熔断:连续 N 次限流,就暂停这个接口的调度 30 秒再放行。不做熔断的话,你的任务队列会一直堆积,内存和连接数一起爆。
class CircuitBreaker:
def init(self, threshold: int = 10, cooldown: float = 30.0):
self.threshold = threshold
self.cooldown = cooldown
self.fails = 0
self.open_until = 0.0
def allow(self) -> bool:
    return time.monotonic() >= self.open_until

def record(self, ok: bool):
    if ok:
        self.fails = 0
        return
    self.fails += 1
    if self.fails >= self.threshold:
        self.open_until = time.monotonic() + self.cooldown
        self.fails = 0
第 4 层:队列 + 死信 + 降级(真正决定成败的一层)
前三层是"别把自己搞死",这一层是"限流了业务还能不能转"。
- 任务进队列,不要同步等接口。 同步调用一旦限流,用户体验就是"页面转圈"。进队列后,限流只是延后,不是失败。
- 优先级分级。 订单查询、发货回传是 P0(直接影响履约),商品详情、SKU 库存是 P1(可以延后几分钟)。限流时先牺牲 P1。
- 降级到缓存。 库存、价格这类数据,允许读"几分钟前的快照"。限流时拿缓存顶上,在页面上标注"库存为 X 分钟前数据",比直接报错好得多。
- 死信队列要有人看。 这条我强调过很多次——没人看的死信队列等于没有。至少配一个每日汇总告警。
关键认知:限流兜底的真正目标不是"一次都不被限",而是"被限的时候,没有一笔订单丢失、没有一个买家看到报错"。前者取决于平台,后者取决于你。
五、比降速更有效的:减少调用次数
这是我这些年最大的收获。大多数人解决限流的方式是"要更多配额",正确的做法通常是"少调几次"。
几个立竿见影的手段:
- 批量接口优先。 循环调 100 次单品详情,改成一次批量查询。调用量直接差两个数量级。
- 按需拉字段。 很多接口支持 fields 参数。默认会返回一大堆你根本不用的字段,响应体大、耗时长,还容易触发其他限制。只拉你要的。
- 增量而非全量。 商品改了才拉,用更新时间做游标。全量轮询是配额杀手。
- 本地缓存 + 变更推送。 能用消息推送就别轮询。1688 有消息订阅机制,商品变更、订单变更可以推给你,比定时拉省得多。
- 库存低频同步。 库存不需要秒级。5–15 分钟同步一次对绝大多数场景足够。如果业务真的需要秒级准确,那说明你该用实时库存接口(需要权限),而不是把基础接口的频率拉满。
最后一条要特别提醒:基础的商品详情接口返回的库存字段可能带缓存、不含占用。如果你拿它做超卖判断,那不是限流问题,是选错了接口——再怎么提 QPS 都解决不了。
六、一个真实案例的数字
一个做一件代发的 ERP,需要监控 500 个活跃 offer,每个 offer 5–20 个 SKU,希望 30 秒刷新一次库存。
算一下: 500 / 30 ≈ 16.7 次/秒。单应用 10 QPS,注定限流。
他们最初的做法是:加机器、加并发、重试拉满。结果:限流更严重,日志一天几十万条,运维彻底躺平。
我们改了三件事: - 热冷分层。 分层依据是销量:近 7 天有出单的 offer(约 80 个)30 秒刷;其余 420 个 10 分钟刷。所需 QPS 从 16.7 降到约 3.3。
- 批量拉取。 同一批 offer 合并查询,实际请求数再降一半。
- 降级。 被限流时返回上次快照 + 时间戳,任务延后重排,不报错。
改完:QPS 峰值不到 5,限流失败率从 4% 降到 0.1% 以下,没有买资源包。
这个案例想说明的:限额是给定的,调用量是你设计的。绝大多数"配额不够"的问题,回头看都是调用设计太粗。
七、给同行的几条硬建议 - 先算再申。 申请配额前,先用公式算清楚:(对象数 × 刷新频率) / 有效时间窗口 × 抖动系数。算不出来就别申,申了也是瞎报。
- 配额按接口申,不按总量申。 谁打满申谁。
- 错误分类写在最前面。 403 和 429 处理方式相反,混在一起处理的系统一定出事。
- 令牌桶按进程分配,多实例要除以实例数,或者上 Redis。
- 重试必须带抖动,退避上限别超过 60 秒。 拖太久不如直接进死信。
- 永远保留一个"降级模式"。 缓存顶替、延迟处理,比报错可爱一百倍。
- 别碰灰产。 多应用分摊是合法业务的技术手段,但如果你的业务本身是靠批量采集别人的数据,那无论怎么优化 QPS 都是在给一个不可持续的模式续命。这个行业里,"稳定"二字只属于走官方授权的那条路。

