
基于 YOLO11 的多语种交通标志与信号灯识别系统
出海驾驶最头疼的不是开车,而是"路边那块阿拉伯文/英文标志到底什么意思"。
一、背景
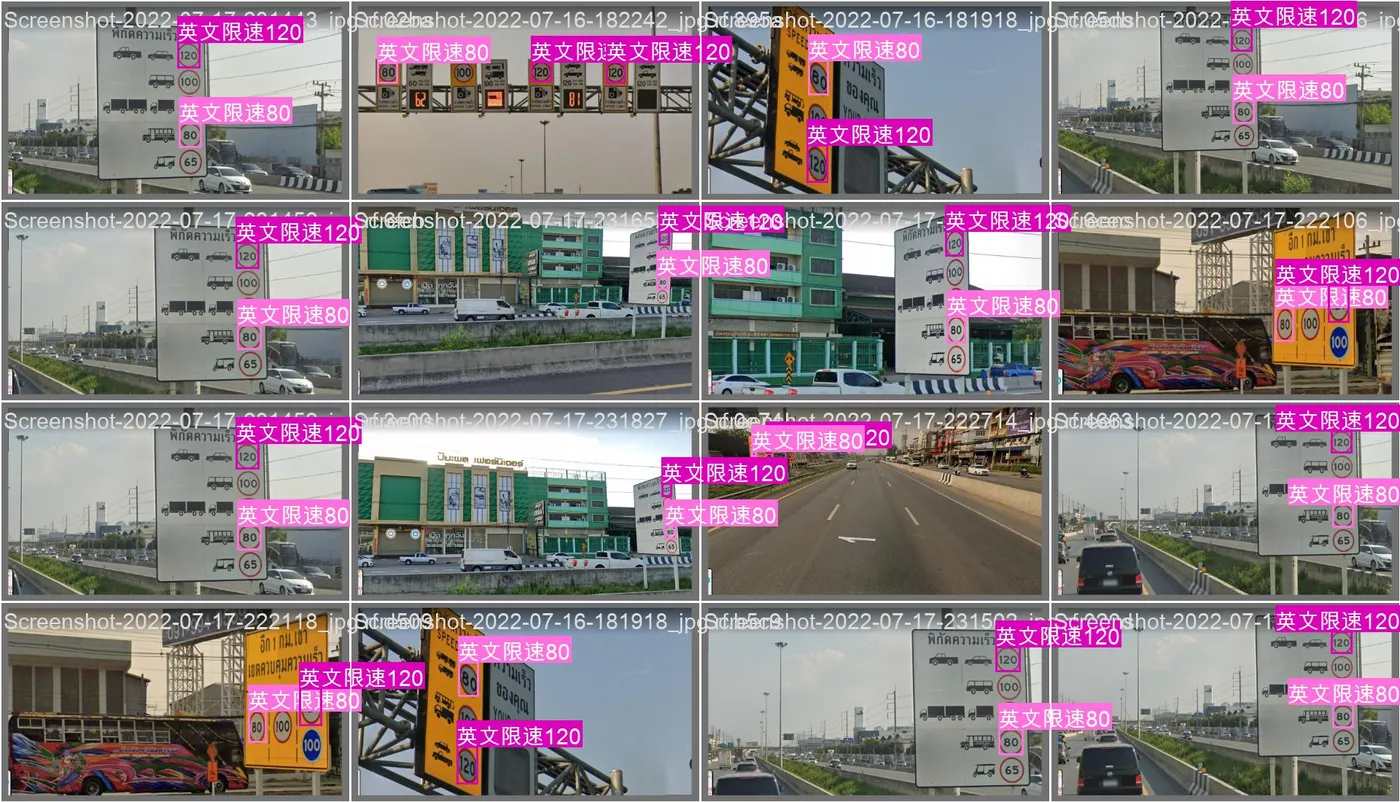
1.1 行业痛点
随着出海驾驶、跨境物流、海外路况巡检、ADAS 出海产品越来越普遍,多语种交通标识感知成为绕不开的一道坎:
- 中东地区大量阿拉伯文限速 / 停车让行标识,国内训练的模型直接迁移过去基本"睁眼瞎";
- 欧美干线常见英文限速、警示、停车让行;
- 出海产品如果只能识别中文标识,到了海外用户那里立刻失灵;
- 多数公开数据集类别粗、语种单一(要么纯中文,要么纯英文),无法满足跨国干线感知。
本项目针对这一痛点,构建了一套覆盖 34 类多语种交通要素 的 检测系统 ,包含:通用警示与通行标识 8 类、英文/阿拉伯文双语限速标识 20 类、停车让行 + 红绿黄交通信号灯 6 类。基于 YOLO11n + Streamlit,可作为车载前视相机、路侧抓拍、高精 地图 采集车的前置感知模块。
视频演示与源码 下载
包含: 📦完整项目源码 📦 预训练 模型权重
🗂️ 数据集
1.2 项目运行效果
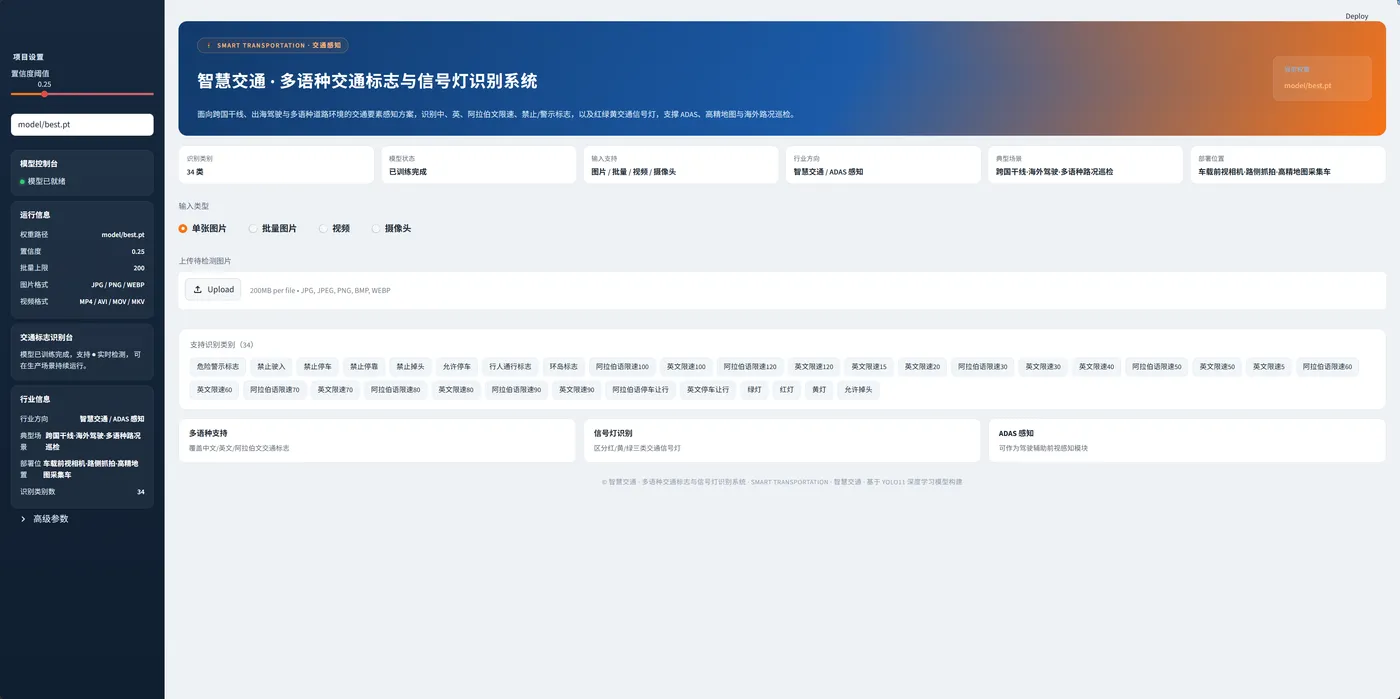
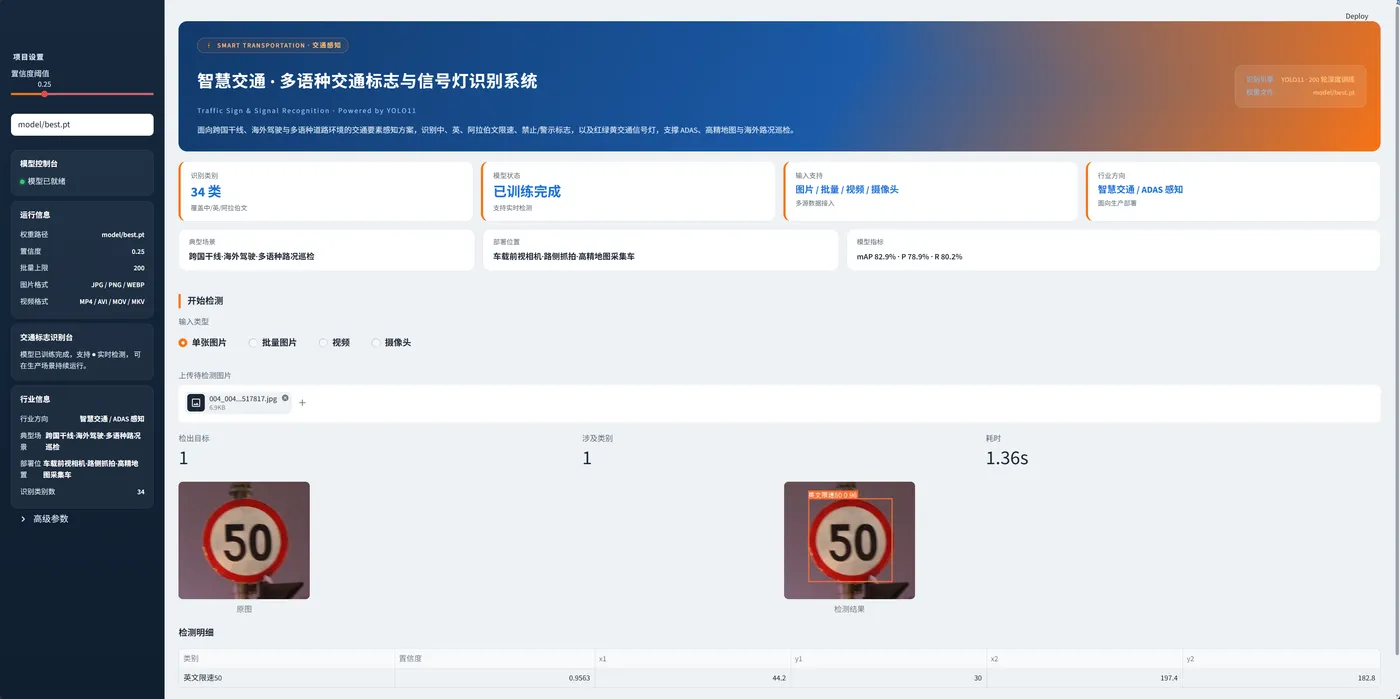
1.3 项目介绍
核心创新点:
| 维度 | 说明 |
|---|---|
| 多语种覆盖 | 同时识别中、英、阿拉伯文交通标识,填补海外市场数据空白 |
| 类别细粒度 | 阿拉伯语限速 30/50/60/70/80/90/100/120 等独立成类,识别后可直接拿数值 |
| 信号灯独立 | 红 / 黄 / 绿三类信号灯单独识别,便于路口逻辑判断 |
| 前后端一体 | Streamlit 提供单图 / 批量 / 视频 / 摄像头四路输入 |
| 行业话术 | 通过 configs/project.yaml 注入"智慧交通 / ADAS 感知"行业字段 |
类别明细(共 34 类):
通用管控(8 类):危险警示标志、禁止驶入、禁止停车、禁止停靠、
                禁止掉头、允许停车、行人通行标志、环岛标志
英文限速(10 类):英文限速 5/15/20/30/40/50/60/70/80/90/100/120
阿拉伯语限速(8 类):阿拉伯语限速 30/50/60/70/80/90/100/120
停车让行(2 类):英文停车让行、阿拉伯语停车让行
信号灯(3 类):红灯、黄灯、绿灯
其它(1 类):允许掉头
技术栈:
| 层 | 选型 |
|---|---|
| 检测模型 | YOLO11n(ultralytics 官方,预训练 yolo11n.pt) |
| 训练框架 | ultralytics ≥ 8.3 |
| 后端推理 | Python 3.10 + PyTorch |
| 前端可视化 | Streamlit + Plotly |
| 视频解码 | OpenCV + imageio-ffmpeg |
| 部署形态 | Streamlit / Docker;可导出 ONNX 供车载边缘盒子 |
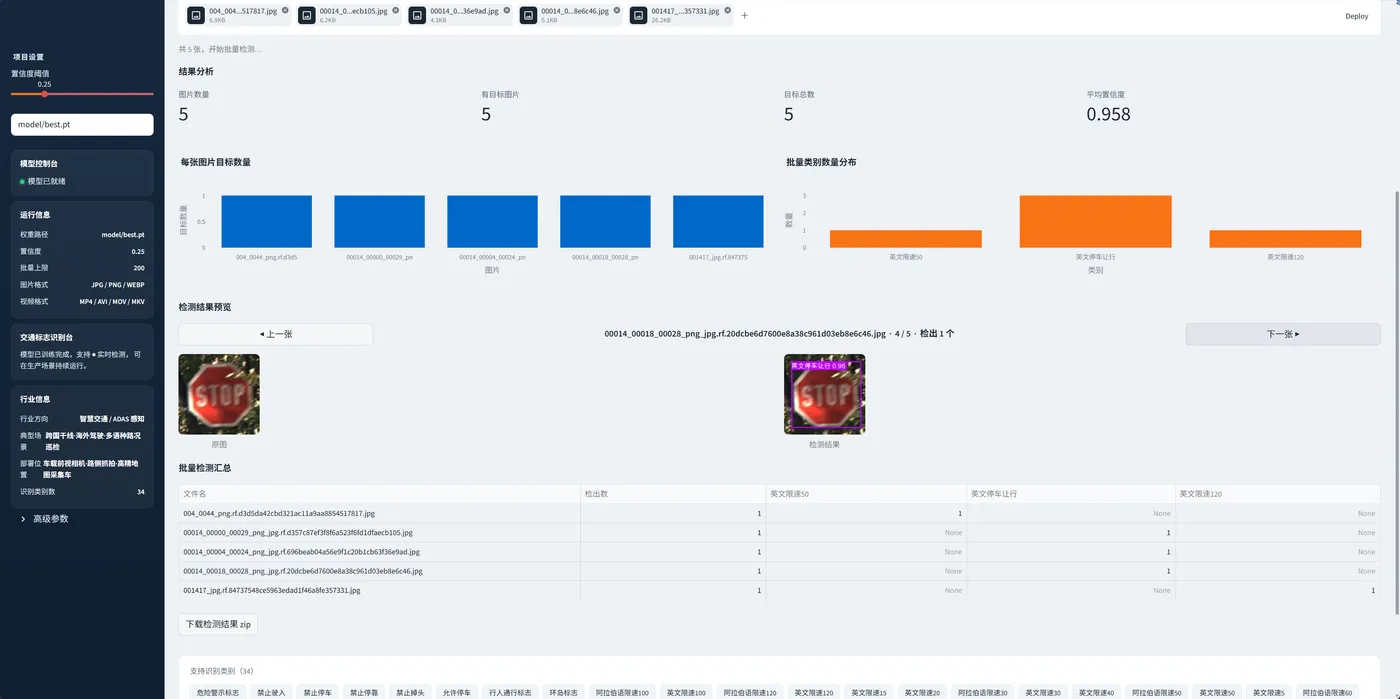
二、设计框架
┌────────────────────────────────────────────┐
│ 浏览器 / 车载 HMI                          │
│ 单图 / 批量 / 视频 / 摄像头实时流           │
└─────────────┬──────────────────────────────┘
              ▼ HTTP(默认 8501)
┌────────────────────────────────────────────┐
│ Streamlit 应用 app/streamlit_app.py         │
│ ├─ infer_image_path() 单帧推理              │
│ ├─ run_batch_image_inference() 批量推理     │
│ └─ render_batch_analysis() 类别 / 置信度图表 │
└─────────────┬──────────────────────────────┘
              ▼ ultralytics.YOLO
┌────────────────────────────────────────────┐
│ YOLO11n 推理引擎                            │
│ model/best.pt(34 类多语种交通要素)         │
└────────────────────────────────────────────┘
YOLO11 网络结构(一图速通):
 输入 640×640
     │
 ┌───▼───── Backbone(C3k2 + SPPF) ─────┐
 │   多尺度特征 P3 / P4 / P5             │
 └───┬─────────────────────────────────┘
     │
 ┌───▼───── Neck(FPN + PAN) ──────────┐
 │   小目标(远处的标志牌)特征上采样融合 │
 └───┬─────────────────────────────────┘
     │
 ┌───▼─── Head(Decoupled + DFL) ──────┐
 │   34 类分类 + 边框 DFL 回归          │
 └───┬─────────────────────────────────┘
     │
   输出:N×(x1,y1,x2,y2,conf,class_id)
YOLO11 的 C3k2 模块在保持精度的同时显著降低参数量,特别适合类别多 + 类别间形似(限速 50 vs 限速 60 仅数字差异)的细粒度场景;DFL 回归则保证了远距离小标志的边界框依然贴合。
检测流程:
 摄像头/上传图  ──▶ letterbox 640  ──▶ YOLO11n 推理
                                          │
                                          ▼
                                conf ≥ 0.25  + NMS(IoU 0.7)
                                          │
                                          ▼
                                 result.plot() 画框
                                          │
                                          ▼
                            类别 → 中文显示名映射 → 报表 + 图表
三、代码结构(核心 50 行)
# app/streamlit_app.py(节选)
from pathlib import Path
import streamlit as st, pandas as pd, yaml
from ultralytics import YOLO

ROOT       = Path(__file__).parent.parent
MODEL_PATH = ROOT / "model" / "best.pt"
CFG        = yaml.safe_load(open(ROOT / "configs" / "project.yaml", encoding="utf-8"))
DISPLAY_NAMES = CFG.get("app", {
   }).get("class_display_names", {
   }) or {
   }

@st.cache_resource(show_spinner=False)
def load_model(p: str) -> YOLO:
    return YOLO(p)                                       # ① 缓存权重

def apply_display(name: str) -> str:
    return DISPLAY_NAMES.get(name, name)                 # ② 类别中英对照

def infer_image_path(model: YOLO, image_path: Path, conf: float):
    result = model.predict(str(image_path), conf=conf, verbose=False)[0]   # ③ 推理
    annotated = result.plot()                            # ④ 画框
    rows = []
    if result.boxes is not None:
        for box in result.boxes:
            cls_id = int(box.cls.item())
            x1, y1, x2, y2 = [float(v) for v in box.xyxy[0].tolist()]
            rows.append({

                "class_name": result.names[cls_id],
                "confidence": round(float(box.conf.item()), 4),
                "x1": round(x1, 1), "y1": round(y1, 1),
                "x2": round(x2, 1), "y2": round(y2, 1),
            })
    return annotated[:, :, ::-1], pd.DataFrame(rows)     # ⑤ BGR→RGB + 结构化结果

# ---------- Streamlit 入口 ----------
st.set_page_config(page_title=CFG["app"]["title"], layout="wide")
conf  = st.sidebar.slider("置信度阈值", 0.1, 0.9, 0.25, 0.05)
model = load_model(str(MODEL_PATH))

if st.radio("输入类型", ["单张图片", "批量图片", "视频", "摄像头"], horizontal=True) == "单张图片":
    up = st.file_uploader("上传待检测图片", type=["jpg", "jpeg", "png", "webp", "bmp"])
    if up is not None:
        annotated, df = infer_image_path(model, Path(up.name), conf)
        st.image(annotated, caption="检测结果")
        df["display_name"] = df["class_name"].map(apply_display)
        st.dataframe(df)
5 段解析:
@st.cache_resource—— YOLO 权重只加载一次,避免每次刷新都冷启动 1~2 秒。apply_display()—— 把权重内置类名(中文)和兼容映射统一成 UI 友好的显示名,多语种场景特别需要。model.predict(...)[0]—— ultralytics 的"一行调用",自动完成 letterbox、归一化、推理、NMS。result.plot()—— 直接拿到带框/类别/置信度的渲染图,BGR 排列。- 把每个 box 拆成结构化记录扔进 DataFrame,给下游"类别分布柱状图""平均置信度卡片"等图表统一消费。
四、训练效果
模型基于 yolo11n.pt 在 5000 张真实道路图像上训练 200 个 epoch,imgsz=640、batch=16,覆盖中、英、阿拉伯文三种语种、34 类 目标。
模型在测试集上检测效果良好,可稳定识别通用警示/通行标志、英文与阿拉伯文双语限速标识、红黄绿交通信号灯等 34 类多语种交通要素,已能满足跨国干线、海外驾驶、多语种路况巡检等场景的初筛与感知使用需要。
五、项目总结
做对了什么:
- 数据维度走差异化:直接补齐了"阿拉伯语限速"这一类公开数据集稀缺的赛道,而不是再卷一个中文数据集。
- 类别细粒度 + 单语种独立:英文限速 60、阿拉伯语限速 60 各算一类,识别完直接能拿到限速数值 + 语种,对下游 ADAS 决策非常友好。
- 工程化模板:Streamlit + 配置驱动 UI,把"训练 → 测试 → 演示"一条龙打通,业务方扫码就能体验。
还能怎么做:
- 接 OCR:对识别到的限速标识 ROI 再做一次 OCR,把"英文限速 60"细化到任意数字,避免类别爆炸;
- 时序融合:连续 N 帧投票输出当前限速,降低单帧抖动;
- 多任务联合:标志检测 + 信号灯状态 + 车道线分割共享 Backbone,节省车载算力;
- 数据扩充:法语 / 西语 / 俄语限速标识,把多语种从 3 种再扩到 6+。
一句话总结: 用 YOLO11n 把"中 / 英 / 阿"三种语种的 34 类交通要素塞进一个权重,只占 5MB 多,是出海 ADAS 与跨国巡检很轻量也很实用的一块拼图。

