
命令行工具容易被当成"不开网页的对话入口",但它真正值钱的地方在另一头:它能成为本地脚本里的一段管道。材料从标准输入进去,结构化结果从标准输出出来,落进文件系统,后面还能接着被脚本处理。
我这次拿它跑的是一件很具体的事:一份简历对 20 条招聘信息,每条要一份"匹配 / 缺口 / 该突出 / 一句话"的四段结论。手工做每条 15 分钟,20 条就是 5 个小时。网页对话框做不了这个形状,它是一条线,材料要重粘、结果留在会话里、没法横向比对第 3 条和第 17 条。
下面这条动线用的是阿里云百炼 CLI(bl 2.1.0),只涉及 bl text chat 和 bl speech synthesize 两条命令,全部在 API Key 域内,不需要创建任何云上资源。读数都是 10 月 19 号我在自己电脑上跑出来的,macOS,标准 API Key 登录。
一、能力面:一条命令上的几个参数口子
bl text chat 上真正让批处理成立的,是下面这几个参数。
| 参数 | 作用 | 在这条动线里干什么 |
|---|---|---|
--messages-file - |
从标准输入读消息数组 | 材料现拼现喂,不落中间文件,循环得以成立 |
--message(可重复,支持 role: 前缀) |
逐条追加消息并指定角色 | 把上一轮对话手工拼进这一次请求,做多轮追问 |
--system |
单独设定模型身份 | 材料不动,换视角跑对照 |
--model |
指定模型 | 轻量模型批量跑,强模型只精修抽样 |
--output json |
返回含 choices 与 usage 的结构化 JSON |
结果可落盘、可聚合、可读 token 数 |
有一个边界要先说清楚:这条命令没有任何文件输入 flag,只有 --message 和 --messages-file。PDF 形态的材料不能直接喂,必须先转成文本。这是流水线的前置工序,不是可以绕过去的细节。
二、动线:粗筛、逐条、精修、音频
第一段是粗筛。把 20 条招聘信息拼进同一个 user 消息,一次调用要一张短名单。
python3 mk_all.py | bl text chat --messages-file - --model qwen3.8-flash --output json > shortlist.json
80.8 秒返回,prompt_tokens 2135、completion_tokens 6195(其中思考 5684),20 行,一行一条,匹配度分布是高 1 条、中 9 条、低 10 条。
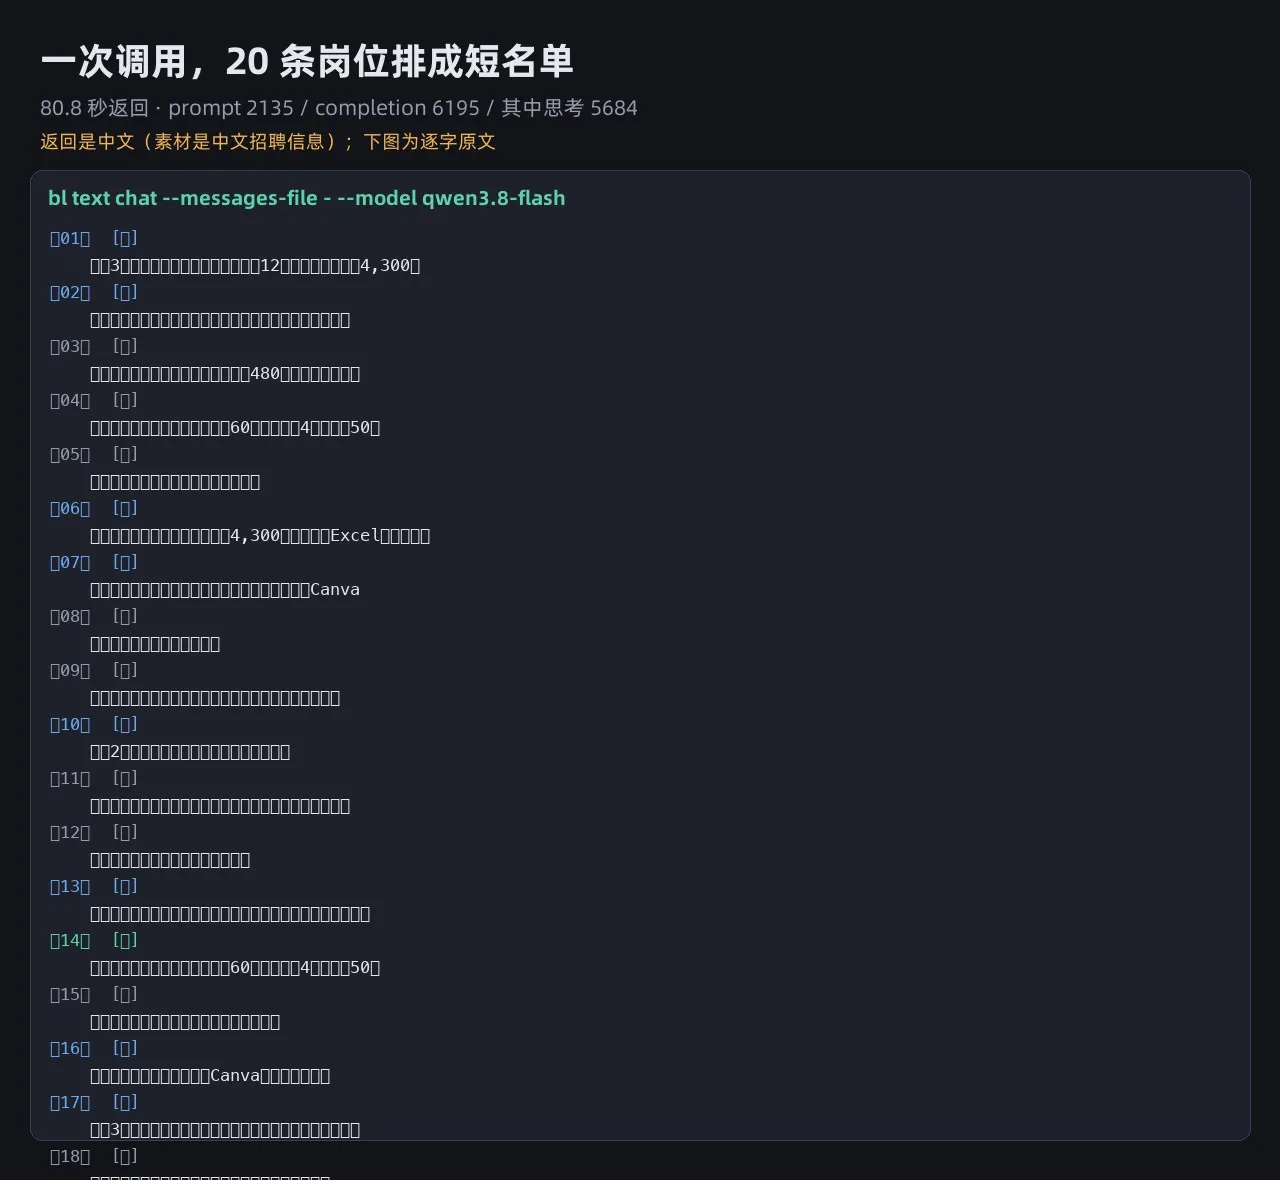
它的上限就在这儿:每行一句话,给不出"对上了招聘要求里的哪一句"。作为收窄范围的粗筛合格,作为定制输出不够。
第二段是逐条。mk.py 在命令跑起来那一刻现拼消息数组,通过管道喂给 -,循环 5 行有效代码:
mkdir -p out log
for f in jd/*.txt; do
  n=$(basename "$f" .txt)
  python3 mk.py resume.txt "$f" | bl text chat --messages-file - --model qwen3.8-flash --output json > "out/$n.json"
done
20 条全部 exit 0,finish_reason 全部 stop,合计 1698 秒(28 分 18 秒),单条最快 23 秒、最慢 203 秒。token 合计 prompt 12058 / completion 70211 / 其中 reasoning 65341,也就是说 93% 的思考量没有出现在最终答案里,答案正文只有 278 到 448 字。
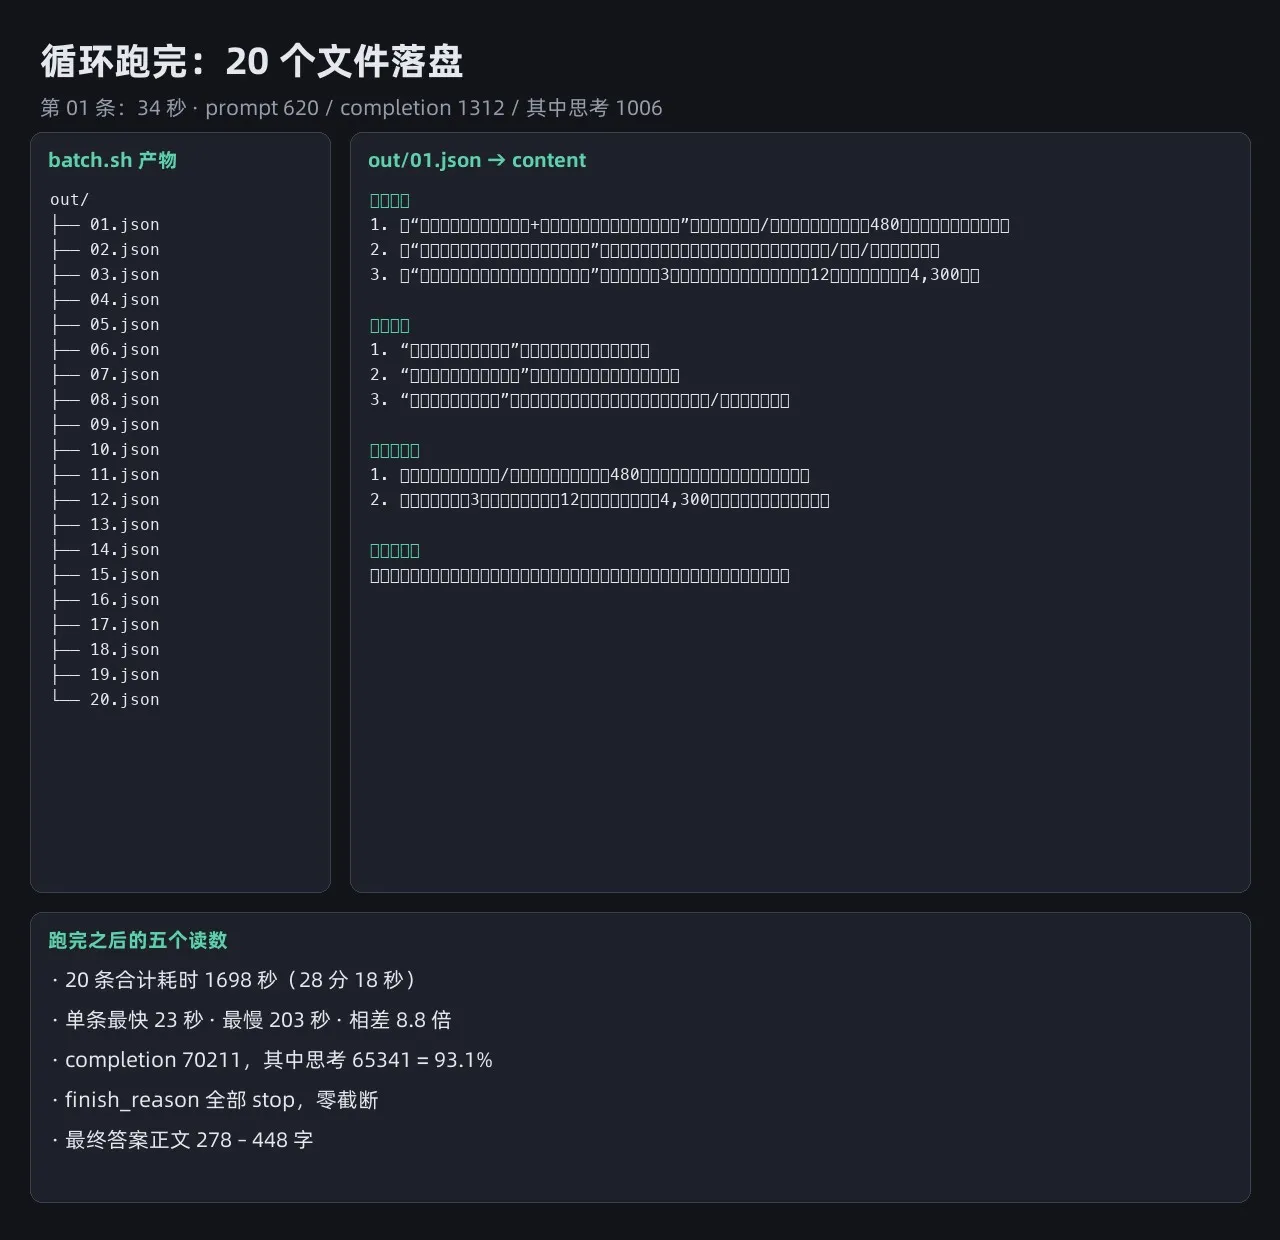
第三段是精修。粗筛把 20 压到 10,我从这 10 条里挑了第 01 条换强模型再跑:
python3 mk.py resume.txt jd/01.txt | bl text chat --messages-file - --model qwen3.8-max --output json > out/01-refined.json
108.0 秒,prompt_tokens 621、completion_tokens 4051(思考 3807),比轻量模型多给了一节【追问预演】。分工就在这里:20 条全用强模型,等待时间会翻好几倍,而其中 10 条压根不值得精修。
第四段跟求职没关系,是我自己想要的。把面试题文本合成成音频,走路时听:
bl speech synthesize --text-file questions.txt --model cosyvoice-v3-flash --voice longcheng_v3 --format mp3 --out interview.mp3
3.9 秒出一个 mp3,257 KB,时长 12.86 秒。文本与语音共用同一套凭证,不用另外配一次。
三、结果落在文件系统里,才谈得上聚合
这一段是我觉得最容易被忽略的。如果结果留在会话里,20 份分析就只是 20 段读过就忘的文字;落在 out/*.json 里,它们就还能被脚本再处理一遍。
我做了两件事。一是清洗:数了一遍符号残留,20 条输出里 ** 出现 0 次,行首的 - 出现 48 处,于是加一道正则把行首短横线去掉,顺手把 json 里的答案抽成 txt。二是聚合:把 20 份结果的【缺口】段抽出来做词频统计,"转化" 4 次、"小红书" 3 次、"进店"和"管理"各 2 次,而我读单条结果时印象最深的"电商后台"和"大促"各只 1 次。
单条阅读的直觉在这儿是错的。共性问题只能靠统计出来,而统计的前提是结果在文件里。
四、同一份材料换身份跑,用来交叉验证
--system 能单独设定模型身份,材料一个字不动。我用同一份简历和同一条招聘信息跑了两个对立视角,一个扮招聘负责人筛简历,一个扮简历主人决定投不投。
| 招聘方视角 | 求职者视角 | |
|---|---|---|
| 耗时 | 14.2 秒 | 19.9 秒 |
| 读数 | 599 / 736 / 643 | 599 / 713 / 620 |
| 结论 | 【会不会进面】看情况 | 【投不投】投 |
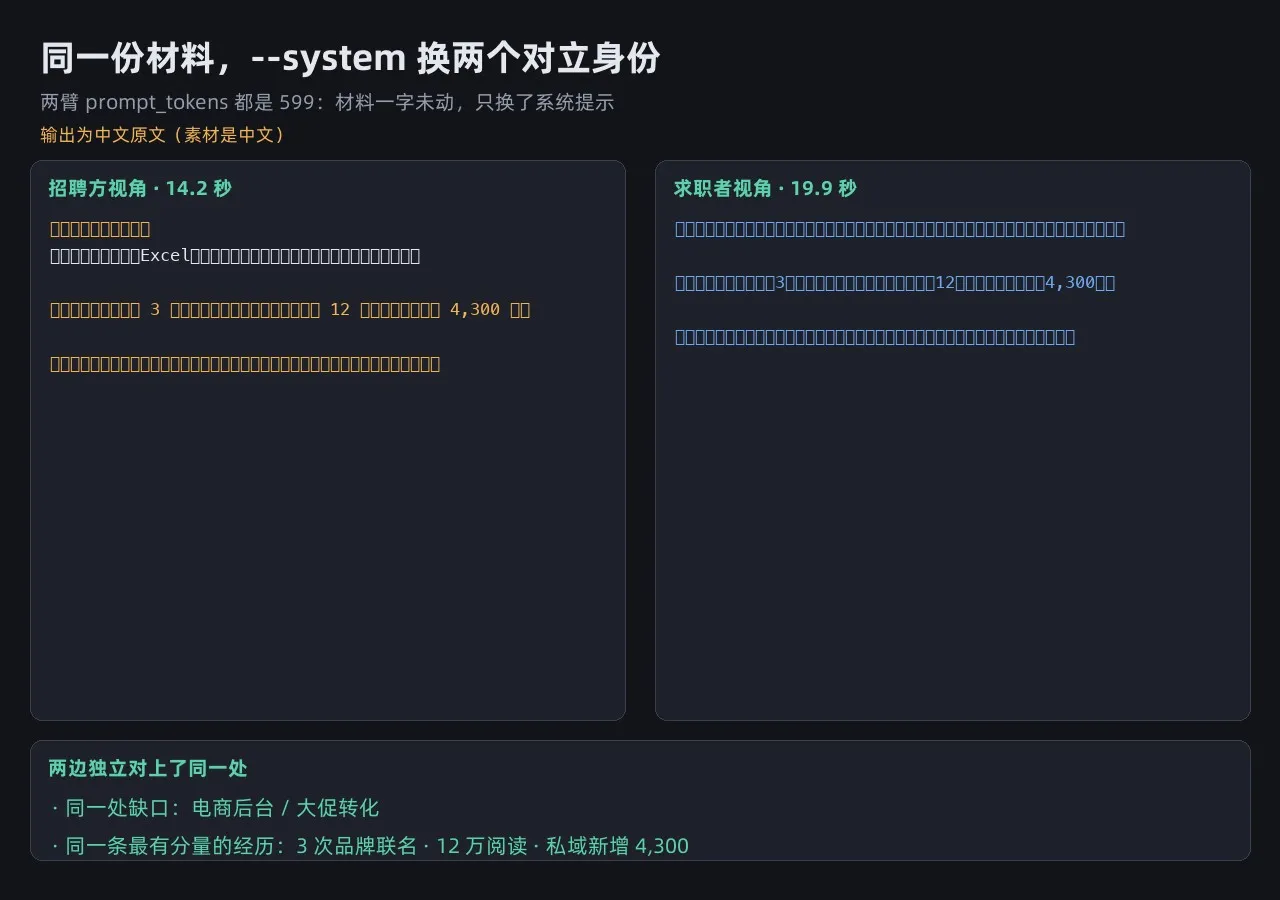
两臂 prompt_tokens 都是 599,材料完全一样。两个对立身份各自独立指向了同一处缺口,也各自挑出了同一条最有分量的经历。两边对上,说明结论不是某一侧顺着提示词编的;要是两边完全不一样,就得怀疑其中一方在编。
--message 的 role: 前缀则是另一种验证。我把上一轮的追问塞回去,问一个材料里没有的数据(涨粉最多的那一个月),返回的开头是"峰值月份我没记准",然后接回了材料里真有的数字。系统提示里"不替材料编造经历"这句起了作用。这是一次可复现的单次观察,我不把它当成普遍规律。
五、边界与适用
这条动线适合"一份固定材料 + N 份变动材料 → N 份定制输出"的形状,换成逐条对招标要求、逐份汇总周报、逐类归档工单也一样跑。N 只有 1 的时候别用,网页对话框更省事。
三条边界写在这里。它不碰第三方网站,也不做自动投递,动线到"生成文本"就停,绕过平台反爬有封号风险。它不是离线的,材料是本地 txt,经标准输入进模型,但调用本身会把材料发到云端模型,含身份证号、住址这类字段的先删再跑。它也不替你核实数据,每条结论都要对着原材料核一遍。
这套动线跑下来是 26 次调用(文本 25 次加语音 1 次),调提示词时另外试跑了 3 次,不计入。文中的简历人物、20 家公司名和全部经历数字都是我编的虚构素材,用来演示动线,不指向任何真实的人或公司。

