
同一行定位器代码,升级前后可能断的已不是同一个格子。
发布评估会上,两份自动化测试报告并排投在幕布上,前后都是全绿。争论点在一张表格用例:升级前一版绿,升级后一版也绿,可测试开发把两次的断言日志逐条摊开,发现它们验的根本不是同一个格子——旧报告数的是全表第 3 格,新报告数出来的是每一行的第 3 格。红绿没变,被断言的对象变了,这就是 Playwright 断言(assertion,用例对定位到的目标断言期望值的判定语句)要补的一门口径课。据 Playwright 官方 Release Notes(v1.64),locator.within() 与相对定位器解析规则都有动作,而多数团队的升级检查表里只有三行字:跑一遍、全绿、合并。
nth() 这一行怎么就换了断言目标
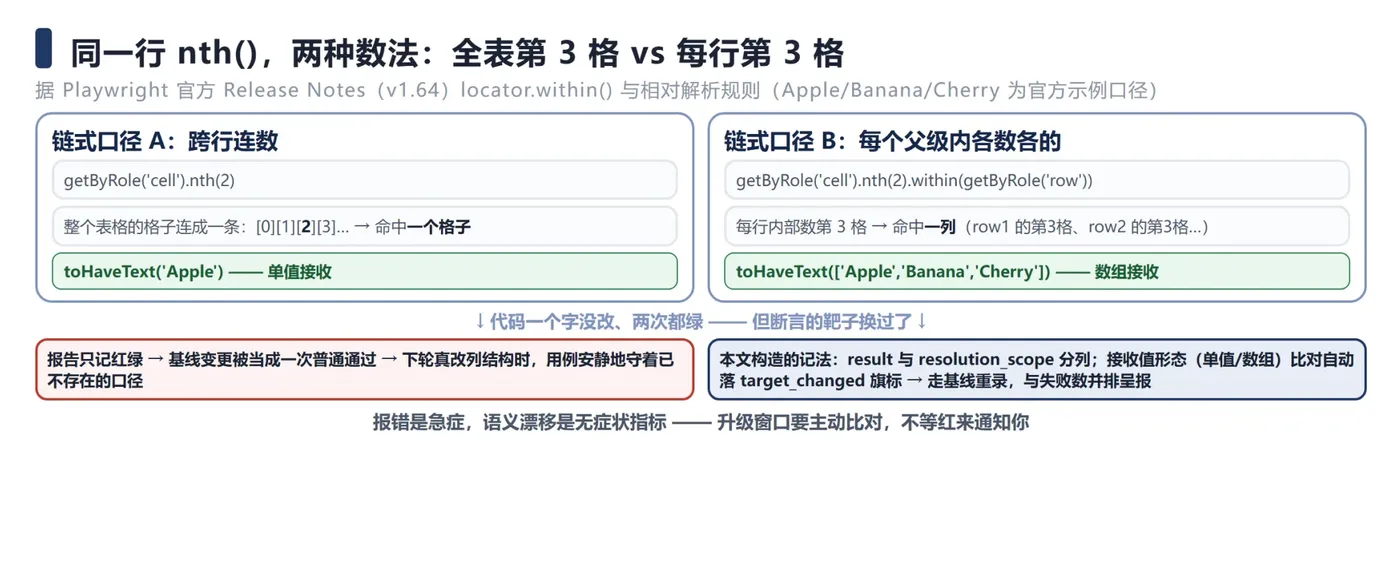
机制要说准。据 Playwright 官方 Release Notes(v1.64),新增的 locator.within() 用来组合两个已有 locator,按自然顺序读——「这个按钮,在那个弹窗里」。相对 locator(nth()/first() 这类按序取子的定位器)则改为在每个父级内分别解析:官方示例里,getByRole('cell').nth(2).within(getByRole('row')) 得到的是「每行第 3 格」,而不是全表第 3 个格子。自然顺序读还有个副作用值得写进代码评审规则:链式写法变成了一句可朗读的话,朗读时最容易暴露的歧义就是「第几个」到底在哪个范围内数——评审时把代码念出声,念到 nth 处需要停顿解释的,就是该补父级范围的一条。同一段表格里,两种链式写法各数出什么,看官方示例最直观:
| 链式写法(官方示例口径) | 解析出的目标 | 断言收到什么 |
|---|---|---|
| page.getByRole('cell').nth(2) | 跨行连数,全表第 3 个格子 | 一个文本值 |
| page.getByRole('cell').nth(2).within(page.getByRole('row')) | 每个父级行内各自数第 3 格,凑成一列 | 数组 ['Apple','Banana','Cherry'] |
// locator-semantics.ts —— 两种链式解析口径对照 + within 常规用法
import {
    test, expect } from '@playwright/test';

test('口径A:全表第 3 格(跨行连数,单目标)', async ({
    page }) => {

  await page.goto('/orders');
  const thirdCell = page.getByRole('cell').nth(2);
  await expect(thirdCell).toHaveText('Apple');          // 只有一个格,收到一个值
});

test('口径B:每行第 3 格(v1.64 within 组合后,按父级分别解析)', async ({
    page }) => {

  await page.goto('/orders');
  const thirdColumn = page.getByRole('cell')
    .nth(2)
    .within(page.getByRole('row'));                     // 「第 3 格,在每一行里」
  await expect(thirdColumn).toHaveText(['Apple', 'Banana', 'Cherry']); // 一列三个值
});

test('within 常规用法:这个按钮,在那个弹窗里', async ({
    page }) => {

  await page.goto('/settings');
  const saveButton = page.getByRole('button', {
    name: 'Save' });
  const dialog = page.getByTestId('settings-dialog');
  await saveButton.within(dialog).click();
});
为什么这个坑危险:写用例的人脑中的解析模型如果是「数遍全表」,那口径 B 那行代码在升级前后长得一模一样,跑起来大概率还是绿的——它只是悄悄从验一个格变成验一列格,或者反过来。更麻烦的是,这类规则调整与那种会直接报错的改动不同:报错逼你处理,语义漂移不逼任何人。报错是急症,当天就会被流水线拦下来;语义变更是无症状体检指标,只有把两次运行的断言接收值放在一起比对才显形。所以它的处置路径也不该一样:不能等着某个用例变红来通知你「靶子换了」,而要在升级窗口里主动比对。报告里给「解析规则变更」留一行字,本质上是把升级从「红绿可过的例行事件」改成「基线需要重新确认的口径事件」——评审的人由此知道,从这一版起,这批用例守护的对象换过一次定义。
对质量报告来说,「断言目标变了」和「结果红绿」是两件事:红绿回答这次过没过,断言目标回答这次验的还是不是老靶子。基线变更被误记成一次通过,下一轮真有人把列结构改了,这条用例可能既不红也不响——它守着一个已经不存在于原口径里的东西,安静地绿着。
报告里怎么分开记「红绿」和「断言目标」
一行用例在报告里不该只有一个 status 字段。下面这段元数据是本文构造的记法骨架:给每条用到相对 locator 的用例,登记引擎版本、链式原文、解析口径、基线口径和一个目标变更旗标——
{

  "case_id": "orders-table-third-col",
  "result": "pass",
  "locator_semantics": {

    "engine_version": "playwright-1.64",
    "locator_chain": "getByRole('cell').nth(2).within(getByRole('row'))",
    "resolution_scope": "per_parent_row",
    "baseline_scope": "global_nth",
    "target_changed": true,
    "baseline_action": "re-record-assertion-target"
  }
}
字段就三条规矩。第一,result 与 resolution_scope 分列:解析口径变了,哪怕 result 还是 pass,报告头部也要单列一行「N 条用例断言目标变更」,走基线重录流程,不进失败列表、也不混进通过统计的口径说明。第二,target_changed 用旗标而不是靠人记:旗标由升级窗口内「同一用例新旧引擎各跑一次、比对断言接收值」的步骤自动落盘——旧版 toHaveText 收到一个文本、新版收到一个数组,接收值类型本身就是目标变更的指纹。第三,报告引用定位链时引原文:locator_chain 存的是那行代码的字面量,评审的人对着代码核对口径,而不是对着「点了第三列」这种人话脑补。
| 报告字段口径 | css 长链 | role + within | getByRef(aria ref) |
|---|---|---|---|
| 定位表达式示例 | page.locator('.dialog .row:nth-child(3) .btn') | getByRole('button', { name: 'Save' }).within(dialog) | page.getByRef('e2') |
| 语义挂在哪 | DOM 结构,改版即断,语义不自解释 | 无障碍角色 + 父级范围,按自然顺序读 | 挂在这一次的 aria 快照上 |
| 报告引用要记什么 | 选择器原文 + DOM 版本 | 链式原文 + 父级 locator + 解析口径 | 快照产出条件 + ref 编号 |
| 失败时能说什么 | 「选择器没匹配到」 | 「父级或角色变了」,可定位到段 | 只能回放到那张快照,链下无法离线复现 |
getByRef 与截图格式:新增条目各给一句
据同一份 Release Notes 的「New APIs」条目,新增 page.getByRef():按 page.ariaSnapshot() 的 'ai' 模式报出的 aria ref(如 e2)定位元素。说白了,这是给 AI 代理留的一条路——代理读的是无障碍树快照,快照里每个节点带一个 ref 编号,getByRef 让「读快照的一方」和「点元素的一方」引用同一套坐标。它天然带着实验性色彩:ref 只在一张快照内有效,所以报告里引用它必须连快照的产出条件一起登记,别把它当成替代 role 定位的通用推荐。这类定位对报告还有一个结构性影响:过去报告的基线只有断言文本一种,现在多了「一张快照」这种新基线——快照换一次,ref 全重编,所以用它定位的用例,版本可比性的锚点从代码行变成了快照文件,报告里两条链都要存。另一句留给视觉断言:同版 toHaveScreenshot 新增 type:'webp' 输出选项——视觉基线报告从此多一个格式字段要记,截图存档记得写格式,不然换了解码器产生的像素差,会被当成一次真实的视觉回归记到研发头上。
升级窗口的回归报告,实操按三步走:带 nth()/first() 的用例列成影响清单;新旧引擎各跑一次,比对每条断言的接收值形态并落 target_changed 旗标;旗标为真的用例走基线重录,报告把「断言目标变更数」与「失败数」并排放,让评审第一眼就看到口径动过几条。这条流水线挂进 CI 也很轻:引擎版本 bump 的提交自动触发影响清单步骤,版本变更因此成为一次可归因的基线事件,而不是散落在某天全绿报告里没人认领的暗变量。
边界:本篇覆盖不到的部分
其一,本篇只写 v1.64 里 within 与 New APIs 两条中分到的句子,链上其他条目各有归属,不在这里复述。其二,机制全部停在文档层描述,本篇没记任何提效数字——「少写多少选择器」这类话没有出处就不说。其三,Apple/Banana/Cherry 与表页、弹窗场景是文档示例与构造演示,不是任何真实产品的成绩。其四,解析规则的精确边界以你实际锁定版本的官方文档为准,升级评估时按版本号回去核对原文,别拿一篇转述当依据;报告元数据字段是本文提出的记法,接不进你们流水线的,至少先把「断言目标变更」记成失败之外的单独一类。
结语:下周升级先改报告模板
下一次升级窗口,先给回归报告加「断言目标变更数」一行,再决定要不要合并依赖升级提交。全绿只是及格线,靶子没换才算数。评审会上再遇到两份都绿的报告,追问的次序也该换过来了:先问这两份绿断的是不是同一个目标,再问它们为什么绿。
红绿告诉你用例过没过,元数据才告诉你它过的是不是同一个东西。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

