
ESP32 的编译报错有个特点:报错信息往往跟真正的问题毫无关系。
我印象最深的一次,日志最后一行是 fatal error: xxx.h: No such file or directory。我对着头文件路径查了半小时,最后发现是 Windows 用户名带了中文,工具链解析路径的时候直接炸了。改了个英文用户名,一遍过。
从那以后我养成了个习惯:每次编译报错,先别盯着报错本身看,往报错发生之前的地方多看十行。时间长了发现,这些坑翻来覆去就那么几类。今天把我踩过的都列出来,省得你们再一个一个踩。
一、版本坑:最常见,也最隐蔽
这是重灾区,没有之一。
IDF 版本和工程不匹配。ESP-IDF 从 v4 到 v5 再到 v6,API 改动不小,一些驱动接口直接换了名字。你从 GitHub 拉了个三年前的老工程,用最新版 IDF 编译,几十个报错扑面而来,看着吓人,其实就是人家当年是按 v4.4 写的。反过来也一样,新工程用旧 IDF 会缺新特性。排查方法很简单:看工程根目录的 dependencies.lock 或者 README,里面一般写了推荐版本,用它就行。
Python 版本冲突。IDF 的工具脚本对 Python 版本有要求,v5.0 之前要 Python 3.7/3.8,后面的版本又要 3.9+。机器上还装着别的项目用的 Python,版本一混,pip install 装到别的环境里去了,编译时还是找不到包。建议给 IDF 单独建一个虚拟环境,虽然多一步,但能省掉后面无数次"为什么包明明装了还是找不到"。
子模块没拉全。GitHub 上 clone 下来的工程,components 目录下一堆空文件夹,编译报头文件找不到。这种工程依赖 submodule,clone 完还要跑一句 git submodule update --init --recursive。国内网络环境这一步经常卡死或者拉一半断掉,断了的 submodule 就是后面那些莫名其妙的编译错误。
二、配置坑:sdkconfig 是个纸老虎
别手改 sdkconfig。这个文件是 menuconfig 生成出来的,几千行,而且每次重新配置都可能被整体覆盖。你的自定义选项应该写在 sdkconfig.defaults 里,每次生成 sdkconfig 时会自动套用。直接改 sdkconfig 也不是不能跑,但换个机器重新配置一遍,改动就全没了。
分区表和固件体积。编译到链接阶段报 app partition is too small,意思是固件比默认分区大。ESP32 默认单应用分区只有 1MB 出头,稍微上点功能的工程必超。解决办法是换分区表:要么用官方的 huge_app / no_ota 方案,要么自己写一份 partitions.csv。顺手提醒一下 Flash 大小也要在 menuconfig 里对准,板子上是 4MB 就选 4MB,选大了烧进去跑飞,选小了连编译都过不了。
目标芯片选错。esp32、esp32s3、esp32c3 是三个不同的编译目标,工具链都不一样。网上抄的配置是 S3 的,你的板子是 C3,编译能过,烧录时报一堆芯片不匹配的错。选目标之前,先看一眼板上丝印。
三、内存坑:报错最凶,其实最好懂
region dram0_0_seg overflowed by XXXX bytes,链接的时候内存溢出。ESP32 的片上 RAM 就几百 KB,静态分配的大数组、大量字符串常量、开太多全局缓冲区,都会撑爆它。
大数组加 static 或挪到堆上分配,字符串常量能精简就精简,大部分情况这样就够了。真要抠内存的,得去看 map 文件里每一段占了多少——这个话题能写另一篇文章,这里先不展开。
四、环境坑:跟代码无关,但最磨人
这类坑的报错最离谱,因为问题根本不在代码里:
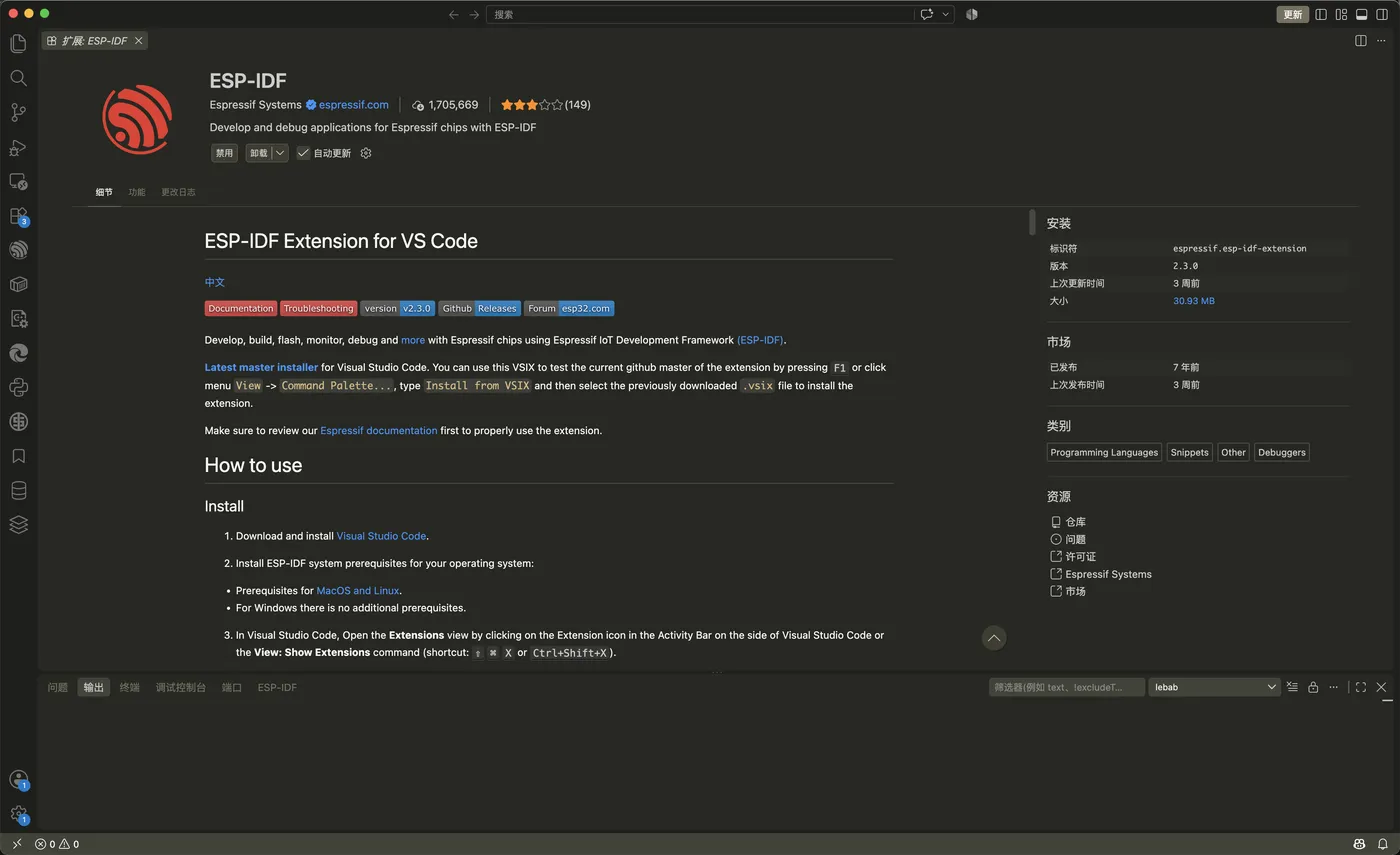
- 路径里有中文、空格或者过长(Windows 默认 260 字符限制),直接编译失败,报错还指不到点上。工程放个纯英文短路径里,能解决一大半玄学问题。
- 工具链下载慢或失败。IDF 安装要从境外源拉几百 MB 的工具链,国内网络看运气。用镜像源能好很多,但镜像源的配置本身又是一层坑。
- 杀毒软件实时扫描把编译中间文件锁住了,报"文件被占用"。把工程目录加白名单。
如果你已经踩过一圈,会发现一个规律:环境坑消耗的时间,远大于代码坑。代码有错它至少告诉你哪行错了,环境错只告诉你"失败了"。
五、干脆别维护环境了:把编译搬到云端
写这篇的契机其实是我自己换电脑。新机器上重装一遍 IDF、配一遍环境变量、拉一遍工具链,前后又花了小半天。当时就想,编译环境这个东西,本质是个一次性投入巨大的固定成本,而我真正需要的只是"把这份代码变成 .bin 文件"。
后来发现国内团队鹿戴马物联(16302.com)做了个云编译服务,把这件事直接简化掉了。用法不复杂:把 GitHub 或 Gitee 的仓库地址填进去,点"测试读取",它会自动拉取分支、识别工程类型(ESP-IDF、Arduino、通用 C/C++、ARM 交叉编译都支持),然后你只需要确认 IDF 版本、目标芯片,有需要再补一段 sdkconfig 配置,提交,云端排队编译,成功后直接下载固件。
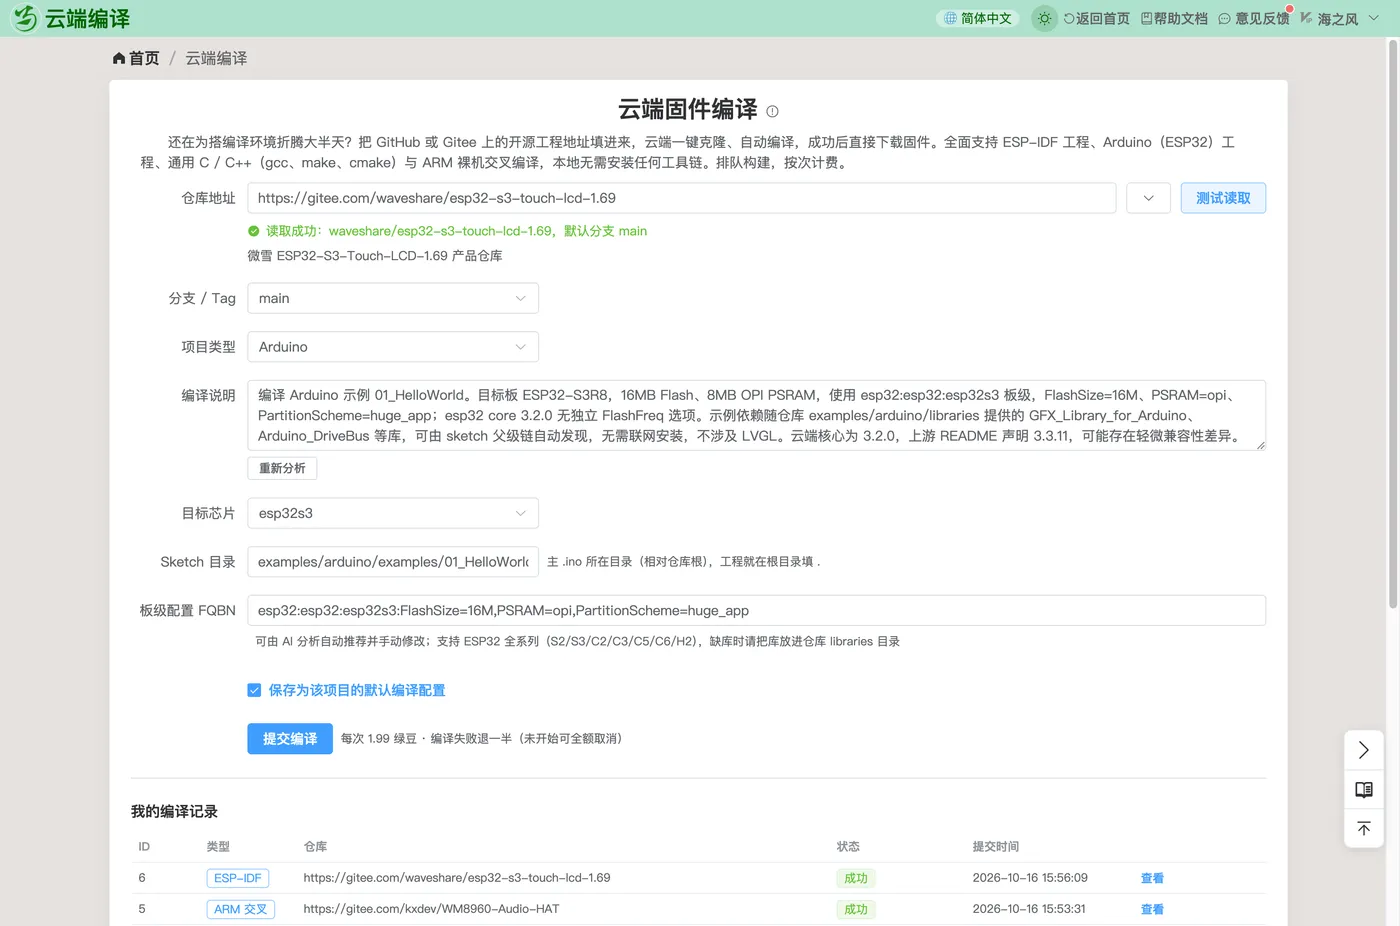
几个实际用下来觉得有用的点:
- 环境为零。没有 Python、没有工具链、没有路径问题,浏览器里操作,换电脑、用公司机器都一样。前面写的那些环境坑,从这个角度看是不存在的。
- 编译配置能存下来。每个项目的版本、芯片、sdkconfig 可以保存为默认配置,下次改完代码重新编译,参数直接复用,这点对反复出固件的工程很实用。
- 编译完还能直接在线烧录。固件、SHA256、完整日志都保留 24 小时,下载或直接推到板子上都行。
当然要说局限:它解决的是"把仓库里的代码编译成固件"这一步,你本地的调试、单步跟踪、改一行立刻验证的迭代节奏,还是得在本地做。它更适合的场景是——拿到一个开源工程想快速出个固件试试、临时在别人的电脑上需要编译、或者就像我一样,单纯不想再装第二遍 IDF。
编译环境是一次性投入巨大的固定成本。如果不是天天编译,维护它并不划算。
第一次用可以先拿个小的 hello world 仓库试手,两分钟就能看到结果。
