一、那个让人崩溃的现象
先描述症状,因为这类故障的特征太典型了。
系统里有三个服务要调同一个电商开放平台的接口:商品服务拉货信息、订单服务同步订单、仓库服务回传运单。三个服务各有一套配置,各自存了一份令牌。
第一次观察到异常,是订单服务报「鉴权失败」。重试一次,成功。再过十分钟,仓库服务报同样的错。我们第一反应是平台侧抖动,翻平台的状态公告,没有异常;看调用量,也没到配额上限。
这种故障最难查的地方在于:它不是稳定复现,而是交替出现。A 服务成功的时候 B 服务失败,隔一会儿又反过来。日志里只有一行错误码,看不出任何规律。
后来我们把三个服务的令牌打指纹(取哈希前八位)打到同一个日志流里,问题立刻清楚了:三个服务持有的令牌指纹,一直在变,而且互相覆盖。
原因一句话:这个平台的令牌是「单活」的——重新获取会让上一次的令牌在一段缓冲期后失效。三个服务各自定时刷新,等于三方在互相把对方的凭证踢下线。
二、五个必须先想清楚的边界
那次改造之后,我们把凭证管理拆成一套固定的约定。下面这张表是它的骨架,建议直接抄进你的接入文档。
| 边界 | 错误做法 | 正确做法 | 不改正的后果 |
| 密钥存放 | 写在配置文件、写进代码仓库 | 环境变量或专用密钥服务注入 | 一旦仓库泄露,凭证等于公开 |
| 令牌持有者 | 每个业务服务各存一份 | 只有一个中控服务持有与刷新 | 偶发鉴权失败,排查成本极高 |
| 刷新触发 | 每个服务自己定时刷 | 中控定时提前续期 + 调用方撞错后回调 | 并发刷新风暴,把平台配额打光 |
| 环境隔离 | 沙箱与生产共用一套配置模板 | 启动时校验凭证指纹前缀,不匹配直接拒绝启动 | 测试凭证在生产生效,属于高危事故 |
| 失效响应 | 捕获异常后无限重试 | 鉴权类错误只允许触发一次刷新 + 一次重试 | 错误被重试放大,变成配额雪崩 |
上面五个里,「令牌持有者」是根因,「刷新触发」是放大器。这两个不改,其余三条改得再规范也没用。
三、代码:一个能用的中控服务
下面这段是当时落地版本的简化,去掉业务耦合后大约一百行,用 Python 写,换成任何语言思路一样。
import time
import threading
import hashlib
import requests
class TokenCenter:
    """唯一持有凭证与令牌的服务。
    对外只暴露 get_token(),内部负责续期、刷新与失效兜底。"""
    def __init__(self, app_key, app_secret, refresh_url, ttl=7200):
        self._app_key = app_key
        self._app_secret = app_secret
        self._refresh_url = refresh_url
        self._ttl = ttl                    # 平台下发的有效期(秒)
        self._token = None
        self._issued_at = 0.0
        self._lock = threading.Lock()
    def _need_refresh(self):
        if not self._token:
            return True
        # 提前 20% 的时间续期,避免卡在过期边缘
        return time.time() - self._issued_at > self._ttl * 0.8
    def _fetch(self):
        resp = requests.post(
            self._refresh_url,
            json={"app_key": self._app_key, "app_secret": self._app_secret},
            timeout=5,
        )
        resp.raise_for_status()
        body = resp.json()
        token = body["access_token"]
        # 只记录指纹,绝不打印明文
        print("token_fp=%s" % hashlib.sha256(token.encode()).hexdigest()[:8])
        self._token = token
        self._issued_at = time.time()
    def get_token(self, force=False):
        # 双检锁:多数请求走快路径,只有真正需要刷新时才抢锁
        if not force and not self._need_refresh():
            return self._token
        with self._lock:
            if force or self._need_refresh():
                self._fetch()
            return self._token
class PlatformClient:
    """业务侧的统一入口,业务代码不接触任何签名细节。"""
    def __init__(self, token_center, base_url):
        self._tc = token_center
        self._base_url = base_url
    def call(self, path, payload):
        for attempt in (1, 2):
            token = self._tc.get_token(force=(attempt == 2))
            resp = requests.post(
                self._base_url + path,
                json=payload,
                headers={"Authorization": "Bearer " + token},
                timeout=8,
            )
            if resp.status_code == 401 and attempt == 1:
                continue        # 只允许「刷新一次 + 重试一次」,绝不无限重试
            resp.raise_for_status()
            return resp.json()
这段代码有两个刻意的设计,值得单独说。
第一,force 参数只在一次重试里出现。 很多团队会写 while True 重试鉴权失败,这在凭证配置错误时会变成对着平台打配额的死循环。一次刷新、一次重试,失败了就该告警让人来看。
第二,日志里只有指纹,没有明文令牌。 这一条不是洁癖。令牌一旦进了日志系统,就等于在所有能查日志的人面前公开了凭证。
四、一张图看懂改造前后的差别
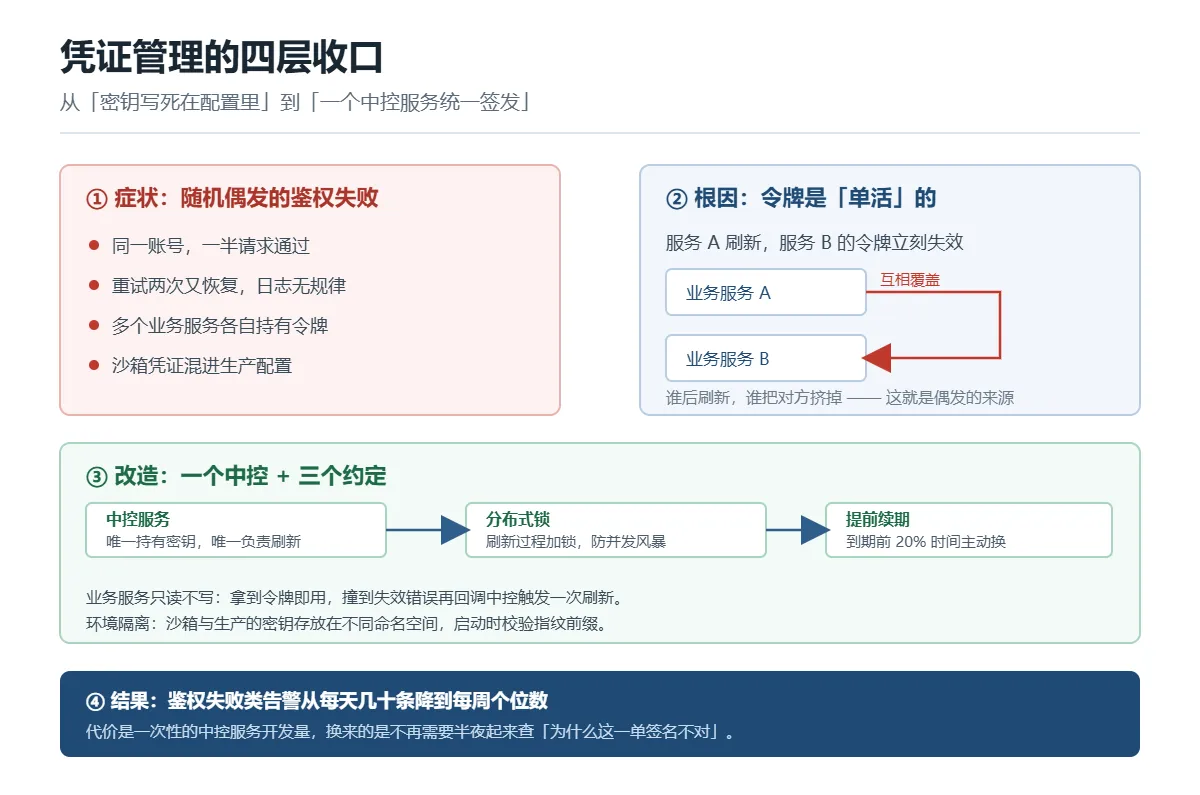
图:症状、根因、改造、结果四段。核心动作是把「令牌谁持有」和「什么时候刷新」这两件事收归一个地方。
改造完成后,我们盯了三个指标:鉴权类错误数、令牌刷新次数、中控服务本身的可用性。第一周鉴权错误还偶发两三次,第二周开始基本清零;刷新次数从每天上百次降到每天两次(一个是定时续期,一个来自那次人工重启)。
五、检查清单
上线前逐条对一遍,能挡掉绝大部分同类问题。
- 密钥不在代码仓库、不在容器镜像、不在前端配置
- 全系统只有一个服务持有令牌,其余服务通过内网接口获取
- 刷新过程有分布式锁,多实例同时启动不会产生刷新风暴
- 续期在有效期 80% 处触发,不等到过期
- 鉴权类错误最多触发一次刷新 + 一次重试,之后必须告警
- 日志只记录令牌指纹,不记录明文
- 沙箱与生产凭证在存储层面隔离,启动时校验
- 密钥支持在不重启服务的前提下更换
- 平台侧配额消耗有监控,防止刷新把配额吃掉
六、一句总结
接口接入这件事里,很多问题的答案不在文档里,而在「你有几个进程在同时做同一件事」这个提问里。凭证如此,后面的限流、回调、对账也是如此。
如果你正在做代购、集运、转运这类长链路系统,凭证管理往往是第一个真正卡住上线的地方——它不复杂,但它会把你的排障时间全部吃掉。