上一篇讲了 Flink Watermark 水位线的原理与机制,其中提到 Watermark 的核心作用之一就是处理乱序数据。这篇深入剖析乱序问题——乱序是什么、为什么会产生、对窗口计算有什么影响、Flink 提供了哪五种处理方案、生产环境怎么选、有哪些坑。
乱序是分布式系统的常态,不是异常。只要数据经过网络传输、消息队列、多分区并行消费,就必然存在乱序。很多同学刚接触 Flink 事件时间时,窗口不触发、数据丢失、结果不准确,90% 的原因都是乱序处理配置有问题——乱序容忍时间设置过小、用单调递增 Watermark 处理有乱序的数据、忘记设置 withIdleness、allowedLateness 设置过长导致状态爆炸……
这篇把乱序问题一次性讲透,从本质到方案到实战到避坑。
一、乱序问题本质:到达顺序与发生顺序不一致
乱序(Out of Order)的定义很简单:数据到达 Flink 的顺序,与数据中事件发生的顺序不一致。
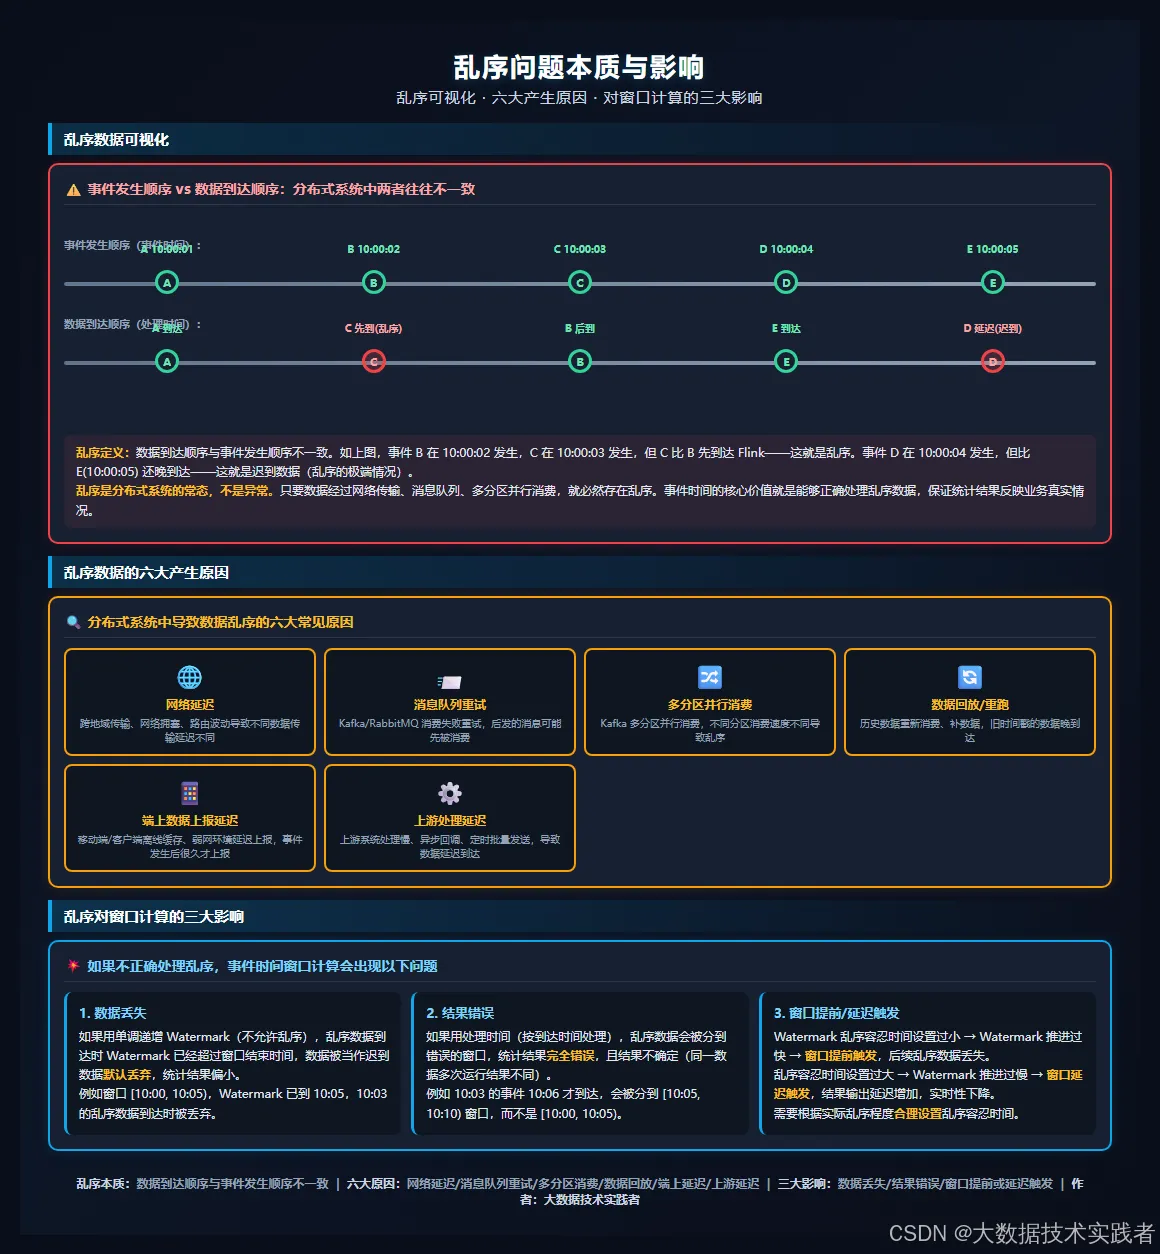
例如事件 A 在 10:00:01 发生,事件 B 在 10:00:02 发生,事件 C 在 10:00:03 发生。但由于网络延迟,C 比 B 先到达 Flink——这就是乱序。事件 D 在 10:00:04 发生,但比 E(10:00:05) 还晚到达——这就是迟到数据(乱序的极端情况,数据到达时 Watermark 已经超过了它的事件时间)。
下面这张图把乱序的可视化、六大产生原因、对窗口计算的三大影响放在一起展示。
1.1 乱序 vs 迟到数据
乱序和迟到数据是相关但不同的概念:
乱序:数据到达顺序与事件发生顺序不一致,但数据到达时 Watermark 还没有超过它的事件时间,仍然会被正确包含在窗口中。例如 C(10:00:03) 比 B(10:00:02) 先到达,但 Watermark 还没到 10:00:03,C 仍然会被正确处理。
迟到数据:数据到达时 Watermark 已经超过了它的事件时间,窗口已经触发计算,数据不会被默认包含在窗口中。例如 D(10:00:04) 在 Watermark 到 10:00:05 之后才到达,D 是迟到数据。
简单说:乱序是"顺序不对但还来得及",迟到数据是"顺序不对且来不及了"。乱序容忍时间内的乱序数据会被正确处理,超过乱序容忍时间的就是迟到数据。
1.2 为什么处理时间不需要考虑乱序
处理时间(Processing Time)是数据到达算子时的系统时间,窗口按到达时间划分,数据到达就处理,不需要等待"数据到齐",所以不存在乱序问题。但处理时间的结果是不确定的——同一批数据多次运行结果不同,且数据延迟会导致统计结果偏小(延迟到达的数据被分到后面的窗口)。
事件时间(Event Time)是数据中事件发生的时间,窗口按事件时间划分,需要等待"数据到齐"才能触发窗口,所以必须处理乱序。但事件时间的结果是确定的——同一批数据多次运行结果相同,且能正确反映业务真实情况。
这就是为什么生产环境首选事件时间,而事件时间必须正确处理乱序。
二、乱序数据的六大产生原因
分布式系统中导致数据乱序的原因很多,最常见的有六种:
2.1 网络延迟
数据从产生端到 Flink 需要经过网络传输,跨地域传输、网络拥塞、路由波动都会导致不同数据的传输延迟不同。例如同一台服务器产生的两条数据,一条走了 10ms,另一条因为网络拥塞走了 500ms,后产生的数据可能先到达。
2.2 消息队列重试
Kafka/RabbitMQ 等消息队列消费失败时会重试,后发的消息可能先被消费成功,先发的消息重试后才被消费,导致乱序。尤其是在消费端处理慢、批量消费、异步处理的场景下更明显。
2.3 多分区并行消费
Kafka 多分区并行消费时,不同分区的消费速度不同(有的分区数据量大、有的分区消费者处理慢),导致不同分区的数据到达 Flink 的顺序与事件发生顺序不一致。即使同一分区内数据有序,跨分区也会乱序。
2.4 数据回放/重跑
历史数据重新消费、补数据时,旧时间戳的数据会晚到达。例如 T+1 补跑昨天的数据,昨天 10:00 的数据在今天才到达 Flink,与今天的实时数据混在一起,产生严重乱序。
2.5 端上数据上报延迟
移动端/客户端离线缓存、弱网环境延迟上报,事件发生后很久才上报到服务端。例如用户在地铁里离线使用 APP,事件发生在 10:00,但到了 12:00 有网络了才上报,延迟 2 小时。
2.6 上游处理延迟
上游系统处理慢、异步回调、定时批量发送,导致数据延迟到达。例如支付回调延迟、订单系统定时批量同步、第三方接口异步通知,都会导致数据延迟到达 Flink。
三、乱序对窗口计算的三大影响
如果不正确处理乱序,事件时间窗口计算会出现以下三个问题:
3.1 数据丢失
如果用单调递增 Watermark(不允许乱序),乱序数据到达时 Watermark 已经超过窗口结束时间,数据被当作迟到数据默认丢弃,统计结果偏小。
例如窗口 [10:00, 10:05),Watermark 已到 10:05,10:03 的乱序数据到达时被丢弃,这个窗口的统计结果少了这条数据。
3.2 结果错误
如果用处理时间(按到达时间处理),乱序数据会被分到错误的窗口,统计结果完全错误,且结果不确定(同一数据多次运行结果不同)。
例如 10:03 的事件 10:06 才到达,会被分到 [10:05, 10:10) 窗口,而不是 [10:00, 10:05)。这个窗口的统计结果多了这条数据,[10:00, 10:05) 窗口少了这条数据,两个窗口的结果都错了。
3.3 窗口提前或延迟触发
Watermark 乱序容忍时间设置过小 → Watermark 推进过快 → 窗口提前触发,后续乱序数据丢失。
乱序容忍时间设置过大 → Watermark 推进过慢 → 窗口延迟触发,结果输出延迟增加,实时性下降。
需要根据实际乱序程度合理设置乱序容忍时间,不能凭感觉设置。
四、乱序程度的度量与监控
在设置乱序容忍时间之前,必须先度量实际乱序程度,不能凭感觉设置。
4.1 乱序程度的定义
单条数据的乱序程度 = 数据到达时间(处理时间) - 数据事件时间。
例如事件时间 10:00:03 的数据在 10:00:08 到达,乱序程度 = 5 秒。
4.2 乱序程度的统计指标
- 最大乱序时间:所有数据中乱序程度的最大值
- P95 乱序:95% 的数据乱序程度不超过这个值
- P99 乱序:99% 的数据乱序程度不超过这个值
- 平均乱序:所有数据乱序程度的平均值
生产环境建议用 P99 乱序 × 1.2~1.5 作为乱序容忍时间,留一定余量。不要用最大乱序时间(可能是极端值,会导致窗口触发延迟过大),也不要用平均乱序(会丢很多数据)。
4.3 如何监控乱序程度
上线前可以用一个简单的 Flink 作业监控乱序程度:
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.ProcessFunction;
import org.apache.flink.util.Collector;

import java.time.Duration;

public class OutOfOrderMonitor {


    public static class Event {

        public long eventTime;  // 事件时间(毫秒)
        public String data;

        public Event() {
   }
    }

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        DataStream<Event> source = env.addSource(new EventSource());

        // 用一个很大的乱序容忍时间,保证所有数据都被处理
        WatermarkStrategy<Event> strategy = WatermarkStrategy
            .<Event>forBoundedOutOfOrderness(Duration.ofHours(1))
            .withTimestampAssigner((event, ts) -> event.eventTime);

        source
            .assignTimestampsAndWatermarks(strategy)
            .process(new ProcessFunction<Event, String>() {

                private long maxOutOfOrder = 0;
                private long count = 0;
                private long sumOutOfOrder = 0;

                @Override
                public void processElement(Event event, Context ctx, Collector<String> out) {

                    long processingTime = ctx.timerService().currentProcessingTime();
                    long outOfOrder = processingTime - event.eventTime;

                    if (outOfOrder > maxOutOfOrder) {

                        maxOutOfOrder = outOfOrder;
                    }
                    sumOutOfOrder += outOfOrder;
                    count++;

                    // 每 10000 条打印一次统计
                    if (count % 10000 == 0) {

                        out.collect(String.format(
                            "count=%d, maxOutOfOrder=%dms, avgOutOfOrder=%dms",
                            count, maxOutOfOrder, sumOutOfOrder / count));
                    }
                }
            })
            .print();

        env.execute("OutOfOrder Monitor");
    }
}
这个作业用一个很大的乱序容忍时间(1小时),保证所有数据都被处理,然后在 ProcessFunction 中统计每条数据的乱序程度(处理时间 - 事件时间),每 10000 条打印一次最大乱序和平均乱序。运行一段时间(建议至少 24 小时,覆盖业务高峰和低谷),就能得到实际乱序程度的统计数据。
注意:这个监控作业只是上线前的临时作业,上线后应该用 Flink Metrics 或 Prometheus 持续监控乱序程度。
五、乱序处理方案一:有界乱序 Watermark(最常用)
有界乱序 Watermark(BoundedOutOfOrderness)是 Flink 最常用的乱序处理方案,适用于乱序范围固定的场景。
5.1 原理
Watermark 计算方式:Watermark = 当前最大事件时间 - 乱序容忍时间。
原理:记录当前最大事件时间,每次生成 Watermark 时减去固定的乱序容忍时间,允许一定程度的乱序。乱序容忍时间内的数据都会被窗口正确包含。
例如乱序容忍时间 5 秒,最大事件时间 10:00:10,Watermark = 10:00:05,表示 10:00:05 之前的数据都到齐了。10:00:01 到 10:00:05 之间的数据即使延迟到达,也会被正确处理。
5.2 完整代码
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;

import java.time.Duration;

public class BoundedOutOfOrdernessExample {


    public static class Order {

        public String userId;
        public double amount;
        public long timestamp;  // 毫秒级事件时间戳

        public Order() {
   }
    }

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        DataStream<Order> source = env.addSource(new OrderSource());

        // 有界乱序 Watermark:允许 5 秒乱序(最常用)
        WatermarkStrategy<Order> strategy = WatermarkStrategy
            .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
            .withIdleness(Duration.ofMinutes(1))  // 空闲输入处理(必须设置)
            .withTimestampAssigner((event, timestamp) -> event.timestamp);

        DataStream<Double> result = source
            .assignTimestampsAndWatermarks(strategy)
            .keyBy(order -> order.userId)
            .window(TumblingEventTimeWindows.of(Time.minutes(5)))
            .sum("amount");

        result.print();

        env.execute("Bounded OutOf Orderness Example");
    }
}
5.3 乱序容忍时间怎么设
- 先监控再设置:上线前用上面的监控作业统计实际乱序程度,设置为 P99 乱序 × 1.2~1.5
- 不要凭感觉设置:设置过小会丢数据,设置过大会增加窗口触发延迟
- 业务高峰和低谷都要覆盖:乱序程度在业务高峰和低谷可能差异很大,监控时间建议至少 24 小时
- 持续监控调整:上线后持续监控迟到数据量,如果迟到数据量突然增加,可能需要调大乱序容忍时间
六、乱序处理方案二:allowedLateness(允许迟到数据重新触发)
allowedLateness 允许窗口触发后不立即清理状态,保留一段时间,迟到数据到达时重新触发窗口计算。
6.1 原理
窗口触发条件是 Watermark ≥ 窗口结束时间。默认情况下,窗口触发后立即清理状态,迟到数据被丢弃。
设置 allowedLateness 后,窗口触发后不立即清理状态,而是保留 allowedLateness 时间。在这段时间内到达的迟到数据,会重新触发窗口计算(增量更新结果)。超过 allowedLateness 的迟到数据,默认丢弃(或用 sideOutputLateData 侧输出)。
6.2 完整代码
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.util.OutputTag;

import java.time.Duration;

public class AllowedLatenessExample {


    public static class Order {

        public String userId;
        public double amount;
        public long timestamp;

        public Order() {
   }
    }

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        DataStream<Order> source = env.addSource(new OrderSource());

        // 定义迟到数据侧输出标签
        OutputTag<Order> lateTag = new OutputTag<Order>("late-data") {
   };

        WatermarkStrategy<Order> strategy = WatermarkStrategy
            .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(30))
            .withIdleness(Duration.ofMinutes(1))
            .withTimestampAssigner((event, ts) -> event.timestamp);

        SingleOutputStreamOperator<Double> result = source
            .assignTimestampsAndWatermarks(strategy)
            .keyBy(order -> order.userId)
            .window(TumblingEventTimeWindows.of(Time.minutes(5)))
            .allowedLateness(Time.minutes(5))  // 允许 5 分钟迟到数据重新触发
            .sideOutputLateData(lateTag)        // 超过 allowedLateness 的迟到数据侧输出
            .sum("amount");

        // 主流结果
        result.print("main");

        // 侧输出的迟到数据(超过 allowedLateness)
        result.getSideOutput(lateTag).print("late");

        env.execute("Allowed Lateness Example");
    }
}
6.3 allowedLateness 设置建议
- 不要设置过长:allowedLateness 设置几小时甚至几天,窗口状态保留时间过长,状态大小爆炸,Checkpoint 超时。建议设置为几分钟到几十分钟
- 超过的迟到数据用侧输出:设置 sideOutputLateData,超过 allowedLateness 的迟到数据侧输出到单独的流,单独处理(写入补数表、T+1 批量补算)
- 业务允许结果更新才用:allowedLateness 会导致窗口结果多次更新(第一次触发 + 每次迟到数据到达都更新),如果业务要求结果一旦输出不能变,不要用 allowedLateness,改用侧输出
七、乱序处理方案三:sideOutputLateData(侧输出迟到数据)
sideOutputLateData 把超过 allowedLateness 的迟到数据侧输出到单独的数据流,不影响主流结果,迟到数据可追溯、单独补算。
7.1 原理
超过 allowedLateness 的迟到数据,默认会被丢弃。设置 sideOutputLateData 后,这些数据不会被丢弃,而是通过 OutputTag 侧输出到单独的数据流。可以对侧输出的迟到数据单独处理(写入补数表、告警、T+1 批量补算)。
注意:sideOutputLateData 只处理超过 allowedLateness 的迟到数据。allowedLateness 内的迟到数据会重新触发窗口计算,不会侧输出。如果没有设置 allowedLateness(默认为 0),所有迟到数据都会侧输出。
7.2 完整代码
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.sink.SinkFunction;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.util.OutputTag;

import java.time.Duration;

public class SideOutputLateDataExample {


    public static class Order {

        public String userId;
        public double amount;
        public long timestamp;

        public Order() {
   }
    }

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        DataStream<Order> source = env.addSource(new OrderSource());

        // 定义迟到数据侧输出标签
        OutputTag<Order> lateTag = new OutputTag<Order>("late-orders") {
   };

        WatermarkStrategy<Order> strategy = WatermarkStrategy
            .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(30))
            .withIdleness(Duration.ofMinutes(1))
            .withTimestampAssigner((event, ts) -> event.timestamp);

        SingleOutputStreamOperator<Double> result = source
            .assignTimestampsAndWatermarks(strategy)
            .keyBy(order -> order.userId)
            .window(TumblingEventTimeWindows.of(Time.minutes(5)))
            .allowedLateness(Time.minutes(1))   // 允许 1 分钟迟到重新触发
            .sideOutputLateData(lateTag)         // 超过 1 分钟的迟到数据侧输出
            .sum("amount");

        // 主流结果:写入实时报表
        result.addSink(new SinkFunction<Double>() {

            @Override
            public void invoke(Double value, Context context) {

                // 写入实时报表系统
                System.out.println("实时报表: " + value);
            }
        });

        // 侧输出的迟到数据:写入补数表,T+1 批量补算
        result.getSideOutput(lateTag).addSink(new SinkFunction<Order>() {

            @Override
            public void invoke(Order value, Context context) {

                // 写入补数表,T+1 批量补算
                System.out.println("补数表: userId=" + value.userId
                    + ", amount=" + value.amount
                    + ", timestamp=" + value.timestamp);
            }
        });

        env.execute("Side Output Late Data Example");
    }
}
7.3 侧输出迟到数据的处理方式
侧输出的迟到数据可以有以下几种处理方式:
- 写入补数表,T+1 批量补算:最常用。迟到数据写入补数表,第二天批量跑批补算,修正前一天的统计结果。
- 写入告警系统:如果迟到数据量超过阈值,触发告警,通知运维人员排查原因(可能是上游系统故障、网络异常等)。
- 写入原始数据存储:迟到数据写入 HDFS/S3 等原始数据存储,供后续回溯和审计。
- 直接丢弃:如果业务对迟到数据不敏感,可以直接丢弃(但不建议,至少应该记录日志)。
八、乱序处理方案四:自定义 Watermark(动态乱序容忍)
当内置策略不能满足需求时(如乱序范围变化大,白天和夜间乱序差异大),可以自定义 WatermarkGenerator,动态调整乱序容忍时间。
8.1 原理
实现 WatermarkGenerator 接口,在 onEvent 中更新内部状态(如最近 N 条数据的最大乱序程度),在 onPeriodicEmit 中基于状态动态计算 Watermark。
例如可以用滑动窗口统计最近 1 分钟内的最大乱序程度,动态调整乱序容忍时间:白天业务高峰乱序大,自动调大容忍时间;夜间业务低谷乱序小,自动调小容忍时间,减少窗口触发延迟。
8.2 完整代码
import org.apache.flink.api.common.eventtime.Watermark;
import org.apache.flink.api.common.eventtime.WatermarkGenerator;
import org.apache.flink.api.common.eventtime.WatermarkOutput;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;

import java.time.Duration;
import java.util.ArrayDeque;
import java.util.Queue;

public class CustomWatermarkExample {


    public static class Event {

        public long eventTime;
        public String data;

        public Event() {
   }
    }

    // 自定义 WatermarkGenerator:动态调整乱序容忍时间
    // 统计最近 N 条数据的最大乱序程度,动态调整乱序容忍时间
    public static class DynamicOutOfOrdernessGenerator
        implements WatermarkGenerator<Event> {


        private long maxTimestamp = Long.MIN_VALUE;
        private final Queue<Long> recentOutOfOrders = new ArrayDeque<>();
        private final int maxRecords;  // 统计最近多少条数据的乱序
        private final long minOutOfOrderness;  // 最小乱序容忍时间
        private final long maxOutOfOrderness;  // 最大乱序容忍时间

        public DynamicOutOfOrdernessGenerator(int maxRecords,
                long minOutOfOrderness, long maxOutOfOrderness) {

            this.maxRecords = maxRecords;
            this.minOutOfOrderness = minOutOfOrderness;
            this.maxOutOfOrderness = maxOutOfOrderness;
        }

        @Override
        public void onEvent(Event event, long eventTimestamp, WatermarkOutput output) {

            // 更新最大事件时间
            maxTimestamp = Math.max(maxTimestamp, eventTimestamp);
        }

        @Override
        public void onPeriodicEmit(WatermarkOutput output) {

            if (maxTimestamp == Long.MIN_VALUE) {

                return;
            }

            // 动态计算乱序容忍时间:基于最近数据的乱序程度
            // 这里简化为:在最小和最大之间取中间值
            // 实际场景可以根据业务时间、数据量等动态调整
            long dynamicOutOfOrderness = (minOutOfOrderness + maxOutOfOrderness) / 2;

            output.emitWatermark(new Watermark(maxTimestamp - dynamicOutOfOrderness));
        }
    }

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        DataStream<Event> source = env.addSource(new EventSource());

        // 自定义 Watermark 策略:动态乱序容忍(最小5秒,最大60秒)
        WatermarkStrategy<Event> customStrategy = WatermarkStrategy
            .<Event>forGenerator(ctx -> new DynamicOutOfOrdernessGenerator(
                1000,  // 统计最近1000条数据
                5000,  // 最小乱序容忍 5 秒
                60000  // 最大乱序容忍 60 秒
            ))
            .withIdleness(Duration.ofMinutes(1))
            .withTimestampAssigner((event, ts) -> event.eventTime);

        DataStream<String> result = source
            .assignTimestampsAndWatermarks(customStrategy)
            .keyBy(event -> event.data)
            .window(TumblingEventTimeWindows.of(Time.minutes(5)))
            .process(new MyWindowProcessFunction());

        result.print();

        env.execute("Custom Watermark Example");
    }
}
8.3 自定义 Watermark 的注意事项
- Watermark 必须单调递增:发出的 Watermark 必须单调递增,如果新 Watermark ≤ 当前 Watermark,Flink 会忽略(自动保证)。自定义实现时要注意不要让 Watermark 回退。
- 不要频繁大幅调整:乱序容忍时间不要频繁大幅调整,否则 Watermark 推进不稳定,窗口触发时间波动大。建议平滑调整(如滑动平均)。
- 有界乱序能满足就不要自定义:自定义 Watermark 实现复杂,容易出 bug。如果乱序范围相对固定,用有界乱序 Watermark 就够了,不要为了"高级"而自定义。
九、乱序处理方案五:Source 端排序
在 Source 端按事件时间排序后再下发,从源头消除乱序。
9.1 原理
在 Source 算子中,先缓存一段时间的数据,按事件时间排序后再下发。这样下游收到的数据就是有序的,不需要再处理乱序,可以用单调递增 Watermark,窗口触发延迟最小。
9.2 优缺点
优点:
- 从源头消除乱序,下游不需要处理乱序
- 可以用单调递增 Watermark,窗口触发延迟最小
- 下游逻辑简单,不需要考虑乱序和迟到数据
缺点:
- Source 端需要缓存数据,状态开销大
- 增加数据处理延迟(需要等待排序窗口结束)
- 实现复杂,需要自己处理排序、缓存、超时等逻辑
- 只适用于数据量小、延迟要求不高的场景
9.3 适用场景
Source 端排序只适用于数据量小、要求严格有序的场景,例如:
- 金融交易流水(要求严格按交易时间排序)
- 小批量数据的精确统计
- 对延迟要求不高的离线近线场景
大多数实时计算场景不建议用 Source 端排序,状态开销大、延迟高,用有界乱序 Watermark 更合适。
十、五种方案对比与选型
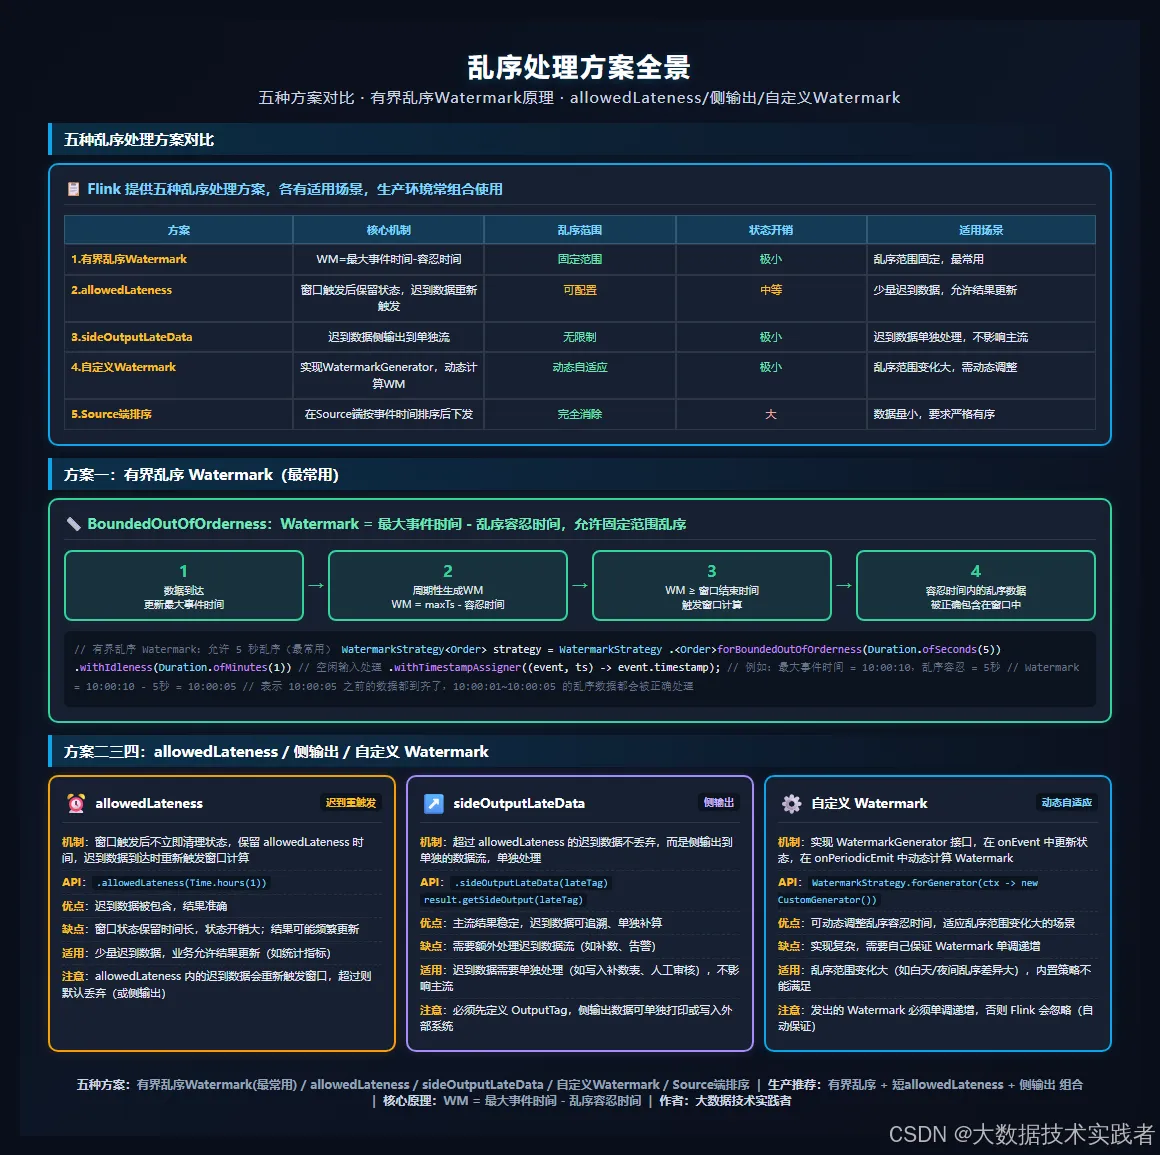
下面这张图把五种方案的对比、有界乱序 Watermark 原理、allowedLateness/侧输出/自定义 Watermark 放在一起展示。
10.1 五种方案对比表
| 方案 | 核心机制 | 乱序范围 | 状态开销 | 适用场景 |
|---|---|---|---|---|
| 1.有界乱序Watermark | WM=最大事件时间-容忍时间 | 固定范围 | 极小 | 乱序范围固定,最常用 |
| 2.allowedLateness | 窗口触发后保留状态,迟到重新触发 | 可配置 | 中等 | 少量迟到数据,允许结果更新 |
| 3.sideOutputLateData | 迟到数据侧输出到单独流 | 无限制 | 极小 | 迟到数据单独处理,不影响主流 |
| 4.自定义Watermark | 实现WatermarkGenerator,动态计算WM | 动态自适应 | 极小 | 乱序范围变化大,需动态调整 |
| 5.Source端排序 | 在Source端按事件时间排序后下发 | 完全消除 | 大 | 数据量小,要求严格有序 |
10.2 选型决策树
按业务需求逐步判断:
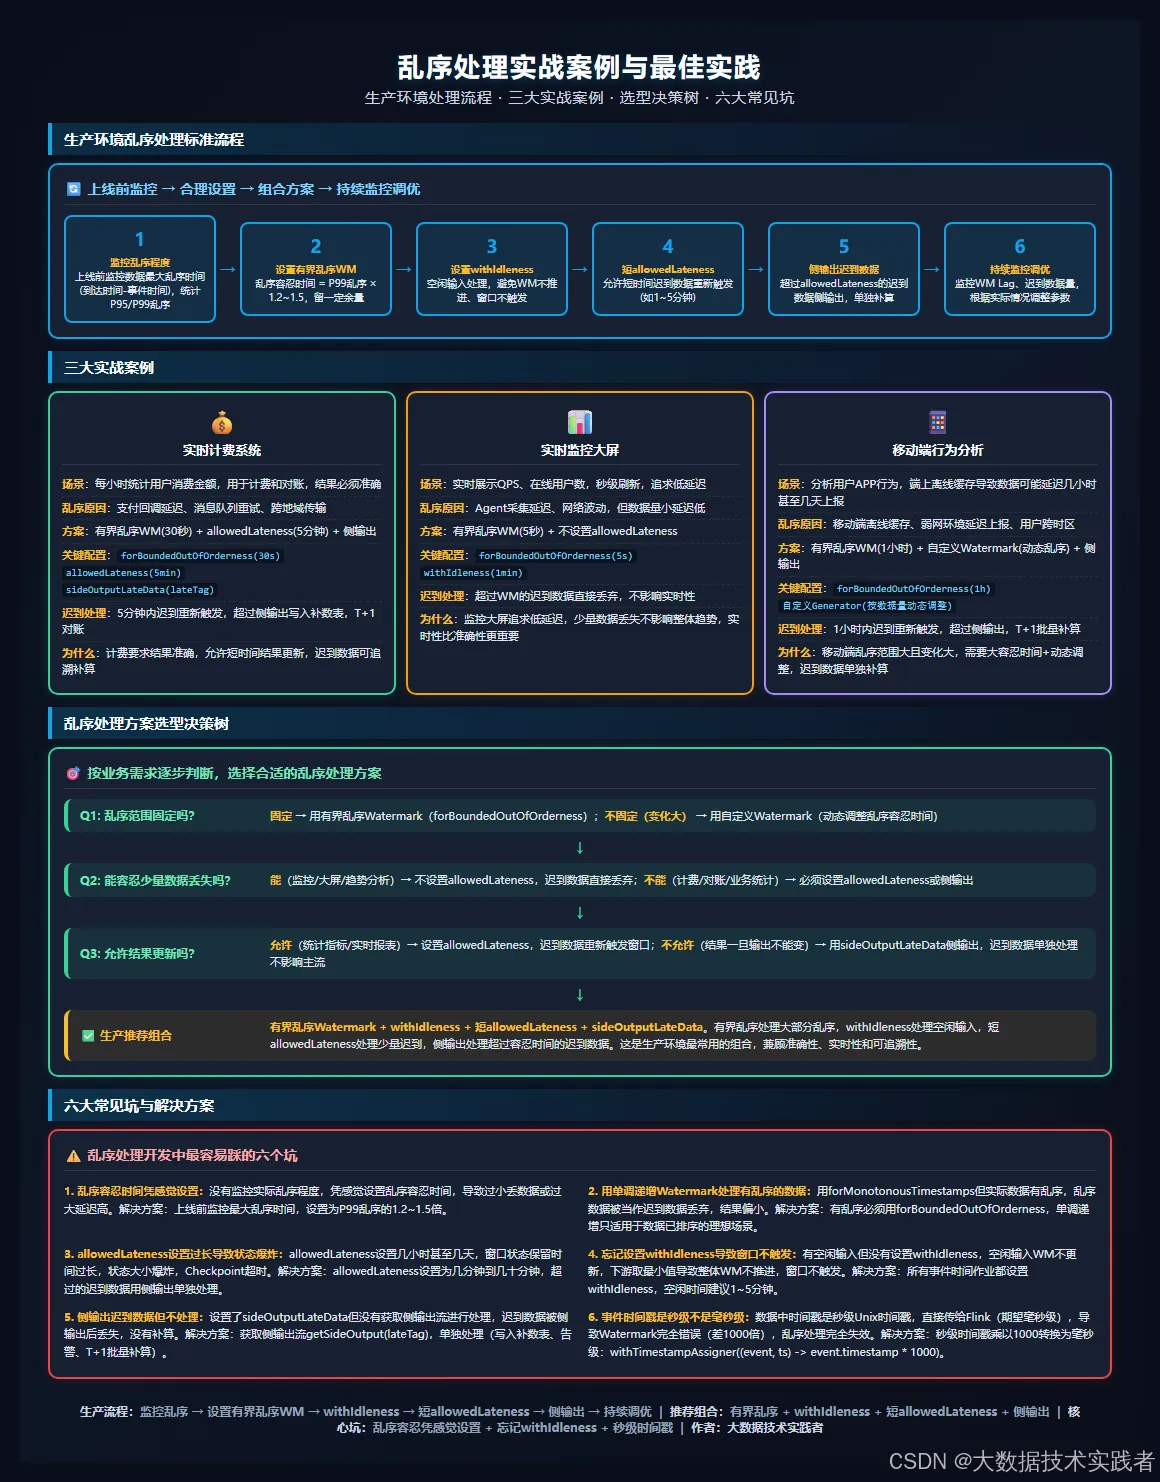
Q1: 乱序范围固定吗?
- 固定 → 用有界乱序 Watermark(forBoundedOutOfOrderness)
- 不固定(变化大) → 用自定义 Watermark(动态调整乱序容忍时间)
Q2: 能容忍少量数据丢失吗?
- 能(监控/大屏/趋势分析) → 不设置 allowedLateness,迟到数据直接丢弃
- 不能(计费/对账/业务统计) → 必须设置 allowedLateness 或侧输出
Q3: 允许结果更新吗?
- 允许(统计指标/实时报表) → 设置 allowedLateness,迟到数据重新触发窗口
- 不允许(结果一旦输出不能变) → 用 sideOutputLateData 侧输出,迟到数据单独处理不影响主流
10.3 生产推荐组合
有界乱序 Watermark + withIdleness + 短 allowedLateness + sideOutputLateData
- 有界乱序 Watermark 处理大部分乱序
- withIdleness 处理空闲输入
- 短 allowedLateness(1~5 分钟)处理少量迟到数据
- sideOutputLateData 处理超过容忍时间的迟到数据,单独补算
这是生产环境最常用的组合,兼顾准确性、实时性和可追溯性。
十一、三大实战案例
下面这张图展示了生产环境乱序处理标准流程、三大实战案例、选型决策树和六大常见坑。
11.1 案例一:实时计费系统
场景:每小时统计用户消费金额,用于计费和对账,结果必须准确。
乱序原因:支付回调延迟、消息队列重试、跨地域传输。
方案:有界乱序 WM(30秒) + allowedLateness(5分钟) + 侧输出。
关键配置:
forBoundedOutOfOrderness(Duration.ofSeconds(30))allowedLateness(Time.minutes(5))sideOutputLateData(lateTag)
迟到处理:5 分钟内迟到重新触发,超过侧输出写入补数表,T+1 对账。
为什么:计费要求结果准确,允许短时间结果更新,迟到数据可追溯补算。
11.2 案例二:实时监控大屏
场景:实时展示 QPS、在线用户数,秒级刷新,追求低延迟。
乱序原因:Agent 采集延迟、网络波动,但数据量小延迟低。
方案:有界乱序 WM(5秒) + 不设置 allowedLateness。
关键配置:
forBoundedOutOfOrderness(Duration.ofSeconds(5))withIdleness(Duration.ofMinutes(1))
迟到处理:超过 WM 的迟到数据直接丢弃,不影响实时性。
为什么:监控大屏追求低延迟,少量数据丢失不影响整体趋势,实时性比准确性更重要。
11.3 案例三:移动端行为分析
场景:分析用户 APP 行为,端上离线缓存导致数据可能延迟几小时甚至几天上报。
乱序原因:移动端离线缓存、弱网环境延迟上报、用户跨时区。
方案:有界乱序 WM(1小时) + 自定义 Watermark(动态乱序) + 侧输出。
关键配置:
forBoundedOutOfOrderness(Duration.ofHours(1))- 自定义 Generator(按数据量动态调整乱序容忍时间)
迟到处理:1 小时内迟到重新触发,超过侧输出,T+1 批量补算。
为什么:移动端乱序范围大且变化大,需要大容忍时间 + 动态调整,迟到数据单独补算。
十二、生产环境乱序处理最佳实践
12.1 上线前
- 先监控再设置:上线前用监控作业统计实际乱序程度(P95/P99/最大),监控时间建议至少 24 小时,覆盖业务高峰和低谷。
- 乱序容忍时间 = P99 乱序 × 1.2~1.5:留一定余量,不要用最大乱序(极端值),也不要用平均乱序(会丢很多数据)。
- 所有事件时间作业都设置 withIdleness:空闲时间建议 1~5 分钟,避免空闲输入导致 WM 不推进、窗口不触发。
12.2 上线时
- 短 allowedLateness + 侧输出组合:allowedLateness 建议 1~5 分钟,不要设置过长(状态爆炸)。超过 allowedLateness 的迟到数据用 sideOutputLateData 侧输出,单独补算。
- 秒级时间戳必须转毫秒:Flink 事件时间默认是毫秒级时间戳,秒级时间戳乘以 1000 转换。
- 事件时间字段必须是 long 类型:不要用 String 或 Date,直接用 long 毫秒级时间戳,减少转换开销。
12.3 上线后
- 持续监控 WM Lag 和迟到数据量:配置 WM Lag(系统时间 - WM)的告警阈值,超过阈值(如 5 分钟)时告警。监控迟到数据量,如果突然增加,可能需要调大乱序容忍时间。
- 定期回顾乱序容忍时间:业务变化(如新增数据源、上游系统改造)可能导致乱序程度变化,定期回顾并调整乱序容忍时间。
- 迟到数据不要直接丢弃:至少侧输出记录,便于回溯和补算。直接丢弃会导致统计结果偏小且无法追溯。
十三、六大常见坑与解决方案
13.1 坑一:乱序容忍时间凭感觉设置
现象:没有监控实际乱序程度,凭感觉设置乱序容忍时间,导致过小丢数据或过大延迟高。
解决方案:上线前监控最大乱序时间,设置为 P99 乱序的 1.2~1.5 倍。
13.2 坑二:用单调递增 Watermark 处理有乱序的数据
现象:用 forMonotonousTimestamps 但实际数据有乱序,乱序数据被当作迟到数据丢弃,结果偏小。
解决方案:有乱序必须用 forBoundedOutOfOrderness,单调递增只适用于数据已排序的理想场景。
13.3 坑三:allowedLateness 设置过长导致状态爆炸
现象:allowedLateness 设置几小时甚至几天,窗口状态保留时间过长,状态大小爆炸,Checkpoint 超时。
解决方案:allowedLateness 设置为几分钟到几十分钟,超过的迟到数据用侧输出单独处理。
13.4 坑四:忘记设置 withIdleness 导致窗口不触发
现象:有空闲输入但没有设置 withIdleness,空闲输入 WM 不更新,下游取最小值导致整体 WM 不推进,窗口不触发。
解决方案:所有事件时间作业都设置 withIdleness,空闲时间建议 1~5 分钟。
13.5 坑五:侧输出迟到数据但不处理
现象:设置了 sideOutputLateData 但没有获取侧输出流进行处理,迟到数据被侧输出后丢失,没有补算。
解决方案:获取侧输出流 getSideOutput(lateTag),单独处理(写入补数表、告警、T+1 批量补算)。
13.6 坑六:事件时间戳是秒级不是毫秒级
现象:数据中时间戳是秒级 Unix 时间戳,直接传给 Flink(期望毫秒级),导致 Watermark 完全错误(差 1000 倍),乱序处理完全失效。
解决方案:秒级时间戳乘以 1000 转换为毫秒级:withTimestampAssigner((event, ts) -> event.timestamp * 1000)。
十四、总结与下一篇预告
乱序是分布式系统的常态,事件时间必须正确处理乱序。要点回顾:
第一,乱序本质是数据到达顺序与事件发生顺序不一致。乱序是"顺序不对但还来得及",迟到数据是"顺序不对且来不及了"。六大产生原因:网络延迟、消息队列重试、多分区并行消费、数据回放、端上延迟、上游延迟。三大影响:数据丢失、结果错误、窗口提前或延迟触发。
第二,乱序程度必须先监控再设置。用 P99 乱序 × 1.2~1.5 作为乱序容忍时间,不要凭感觉设置。监控时间建议至少 24 小时,覆盖业务高峰和低谷。
第三,五种处理方案:有界乱序 Watermark(最常用,WM = 最大事件时间 - 容忍时间)、allowedLateness(窗口触发后保留状态,迟到重新触发)、sideOutputLateData(迟到数据侧输出单独处理)、自定义 Watermark(动态调整乱序容忍)、Source 端排序(从源头消除乱序,数据量小才用)。
第四,生产推荐组合:有界乱序 Watermark + withIdleness + 短 allowedLateness + sideOutputLateData。有界乱序处理大部分乱序,withIdleness 处理空闲输入,短 allowedLateness 处理少量迟到,侧输出处理超过容忍时间的迟到数据。
第五,六大常见坑:乱序容忍凭感觉设置、用单调递增处理有乱序数据、allowedLateness 过长状态爆炸、忘记 withIdleness 窗口不触发、侧输出迟到数据但不处理、秒级时间戳未转毫秒。