
42%,这是 Sonar 2026 年开发者调查里,AI 生成代码在交付代码中的占比。同一份调查预测,这个数字到 2027 年会到 65%。
同一时间线上的另外两个数字没那么好看。GitClear 的 2026 年报告显示,代码 churn(写完不久就被改掉的部分)同比上涨了 39%;LinearB 的数据里,AI 参与的 PR 体积大约是过去的两倍多,而合并率不到一半。
一边是产量翻倍,一边是返工同步上涨。这两件事同时发生,说明问题不在「能不能写出来」。
产量涨了,交付没跟上
把三个数字连起来读:AI 写得多,写完改得也多,改完能顺利合进主干的还不到一半。多出来的产出,有相当一部分没有走到交付那一步。
如果只看「生成」这一个动作,今天的工具都已经做得不错。但一个需求从一句话走到可运行的工程,中间要经过的远不止生成:需求有没有被理解对,接口和表结构定没定,前后端字段对不对得上,代码进仓库后别人能不能接手。
这些环节里出问题,返工就来了。也就是说,返工多数发生在生成之外的地方。
一个具体的落差是:生成一段代码可能只要几十秒,把这段代码对齐到项目里要花的时间,往往是它的好几倍。生成越快,这个落差的绝对值越大。
往上追一层,返工从哪来
顺着「返工」往上追,第一层原因是验证成本。代码是生成的,人不敢直接用,得逐处看,看懂了才敢提交。这部分时间不会因为生成变快而减少,反而因为产出量变大而变多。
更深一层的原因更具体:生成出来的东西,形态对不上项目的需要。一段能跑的代码,和一个能进仓库的产物,中间隔着依赖、规范、分层、命名这些没有写在需求里的东西。这些东西没人补,就得人来补,人补的每一处,都是返工。
再往上追一层,就追到工具的边界了。多数工具的工作停在「输出文本」这一步,后面的归档、对齐、落库不在它负责的范围内。工具不管,这部分成本就转移给了用它的人。
这三层原因叠在一起,指向的都是同一件事:链条中间断了一节。生成能力越强,这一节断得越明显,因为前面的产出越多,后面要接的东西就越多。
差的是最后那一步:产物有没有落进工程
飞算 JavaAI 在链路上多做了一件事,把过程的每一步都变成落在工程里的产物。它的智能会话把四件事串成了一条线:/需求分析 先把一句话需求落成需求文档和业务设计文档,含糊的地方会先反问而不是直接猜;/前后端设计 接着出数据库表结构和接口定义;/前端开发、/后端开发 照这份接口写实现,想一次走完,用 /全栈 从需求分析一路推到前后端。
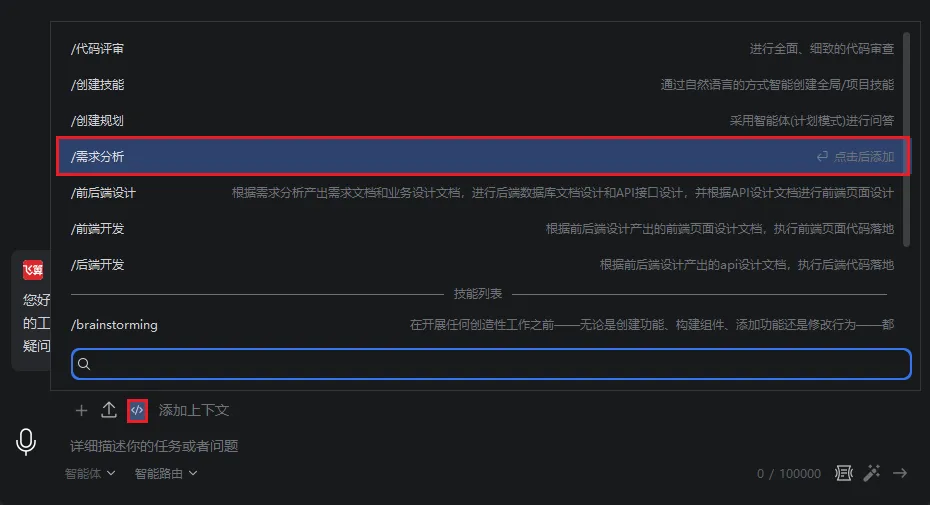
需求文档、接口设计、数据库脚本、代码,都落在项目自己的工作区里,进了仓库,能被版本管理,能在下一次改动时被翻出来对照。
为什么这一步能对上返工的问题:返工大多不是「写得不对」,是「写得对不上」:对不上已经定下的接口、对不上项目的目录结构、对不上上一次的设计。 当需求、设计、代码在同一条链上依次落盘,后面的每一步都对得上前面那一步留下的东西,人需要手工搬运和对齐的部分就少了。
可交付性不是一个单独的环节,是前面每一步都留下可追溯产物之后自然的结果。一段代码有没有出处、改它的时候该不该连带改接口,这些问题在产物齐全的情况下,看一眼就能回答。
它管不了的是需求本身。一句话需求如果本身就有歧义,澄清那一步省不掉,工具能做的只是把它变成一次明确的提问。产物能保证链不断,保证不了输入一定准确。
一句话到可运行,是一条链
「AI 写代码快」这句话容易验证,因为它只涉及一个动作。「AI 交付快」难的是一整条链:需求、设计、实现、归档,每一环都得接上。少一环,前面省下的时间会在后面还回去,而且往往还得加上找原因的成本。
这条链上每一环都有专门的工具,但把它们串起来的动作往往没人负责。串不上,等于每一环都在高效地各做各的,交接处的成本没人认领。每一环单独看都不差,合起来还是慢,原因就出在交接的地方。
飞算 JavaAI 想接的就是这个交接处:把四段串成一条,产物一路落盘,谁接手都能顺着往上找。
往后看,这个比例还会继续涨。涨到 65% 的时候,如果中间那一节还是断的,返工的量也会跟着涨。比例越高,链条的完整度就越重要。
那 42% 只是起点。真正决定交付速度的,是这 42% 之外的那一段路有没有人管。
留一个问题
你上一次用 AI 交付一个完整功能,从提出需求到合并进主干,中间哪一步花的时间最长?

