引言:一个每天重复几十遍的场景
做集运的都知道这个动作:客户发来一句"我的货到哪了",客服复制运单号,打开承运商官网,粘贴,看状态,再翻译成客户能懂的话,回复。
一单 2 分钟。一天 50 单,就是将近 2 个小时——全部花在了"看一眼"上。
更糟的是这件事的本质:查询的人不是不知道答案,是答案不在自己的系统里。
这一篇讲清楚,怎么用接口把物流追踪变成自动的:轨迹自己进来、状态自己流转、异常自己冒出来。以及——哪些环节做了是白做。
一、手动查单为什么撑不住
先看清楚这件事的四个隐性成本:
| 成本 | 具体表现 |
| 多渠道切换 | 不同承运商有不同官网,每家格式、语言、更新频率都不一样 |
| 时差错位 | 海外客户睡觉时轨迹在变化,醒来集中问,客服早上最忙 |
| 语言转换 | 轨迹原文常是外文,客服逐单人工翻译,口径还不统一 |
| 异常滞后 | 丢件、卡关、退回,是客户先发现的 —— 等客户来问,投诉已经成立 |
最后一条最贵。前三条是效率问题,这一条是信任问题:客户对"货到哪了"的容忍度很低,但对"你们怎么比我先知道丢件"的容忍度更低。
自动化的目标因此有两层:
- 表层:客服不用再逐单查(省时间)
- 里层:异常比客户先被发现(保信任)
只做到第一层的自动化,等于只做了一半。
二、自动追踪的三层结构
物流追踪自动化不是"接一个接口"就完了,它是一个三层结构。每一层的职责必须分清,否则后期排查问题时会搅在一起。
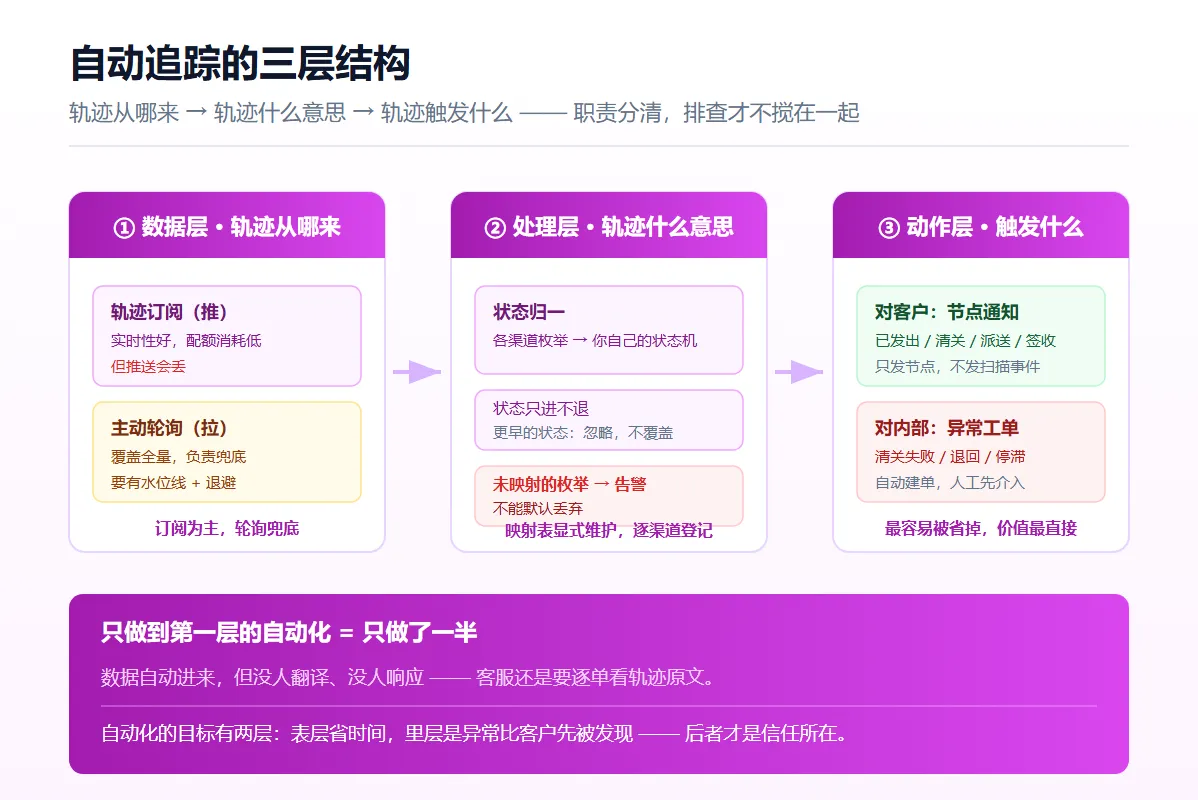
图 1 · 数据层管"轨迹从哪来",处理层管"轨迹什么意思",动作层管"轨迹触发什么"
第一层:数据层——轨迹从哪来
两种获取方式,就是系列概念篇讲过的推与拉:
| 轨迹订阅(推) | 主动轮询(拉) | |
| 触发方式 | 承运方有更新时推给你 | 你定时去查 |
| 实时性 | 好 | 取决于轮询间隔 |
| 配额成本 | 低 | 高——运单量大时轮询成本增长很快 |
| 会不会漏 | 会(推送会丢) | 覆盖全量 |
正确姿势是两者配合:订阅为主,轮询兜底——每天对"一段时间没有轨迹更新的运单"做一轮主动补查(这个动作在第四步还会再用到,它同时是异常检测的载体)。
第二层:处理层——轨迹什么意思
各渠道的状态五花八门:同样是"到了目的国",有的渠道叫"清关完成",有的叫"进口互换局开拆",有的直接给一个代码。
这一层的职责是归一:把所有渠道的状态翻译成你自己系统里的一套状态机(比如:已发出 → 运输中 → 已到国内/海外仓 → 清关中 → 派送中 → 已签收)。
两条铁律(对账篇讲过,这里再强调一次):
- 状态只能前进,不能倒退——收到更早的状态,忽略而不是覆盖
- 未映射的状态必须告警——新渠道接入或渠道改枚举时,你要在第一时间知道
第三层:动作层——轨迹触发什么
状态变了之后做什么。这是最容易被省掉的一层,也是价值最直接的一层:
- 对客户:关键节点自动推送(已发出 / 已到达 / 清关中 / 派送中 / 已签收)
- 对内部:异常状态自动建工单(清关失败、退回、超时无更新)
三、落地四步
按顺序做,每一步都有明确的验收标准。
第一步:接入轨迹订阅
对接承运方或轨迹聚合服务的订阅接口:运单发货时注册订阅,状态变化时接收推送。
接入时三件事不能省(概念篇回调部分的规则,原样适用):
1. 验签   —— 回调地址是公开的,先确认消息真的来自服务方
2. 快返回 —— 先应答"收到",再异步处理;超时会被判定失败并重推
3. 幂等   —— 同一条推送可能来多次,处理动作不能执行两次
验收标准:人为重放同一条推送,你的系统不产生重复记录。
第二步:状态归一
建一张显式的映射表,把每个渠道的枚举值翻译成你自己的状态:
STATUS_MAP = {
    "channel_a": {
        "PICKED_UP":    "已发出",
        "IN_TRANSIT":   "运输中",
        "CUSTOMS":      "清关中",
        "OUT_FOR_DELIV": "派送中",
        "DELIVERED":    "已签收",
    },
    # 每接一个新渠道,补一段
}
def normalize(channel, raw_status):
    mapped = STATUS_MAP.get(channel, {}).get(raw_status)
    if mapped is None:
        alert(f"未映射状态: {channel}/{raw_status}")   # 必须告警,不能默认丢弃
        return None
    return mapped
验收标准:随机抽 100 条历史轨迹,每一条都能对应到你状态机里的一个状态,没有"未知"。
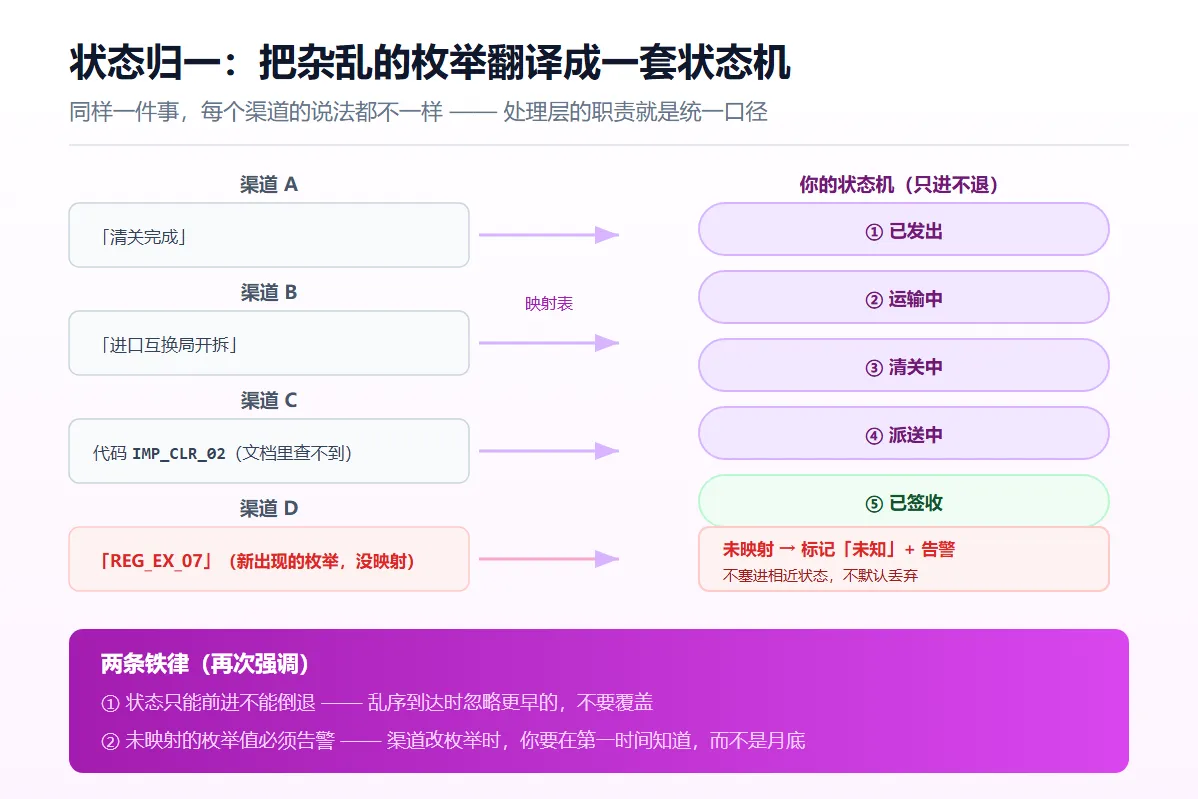
图 3 · 映射表显式维护、逐渠道登记,未映射的枚举一律告警
第三步:通知触发
不是所有状态都值得打扰客户。扫描事件和节点事件的区别是这一步的关键:
- 一个包裹从发出到签收,可能产生 20 多条轨迹扫描记录
- 但客户只关心 4~5 个节点
| 节点 | 通知谁 | 形式 |
| 已发出 | 客户 | 自动消息,附查单链接 |
| 清关中/被税 | 客户 + 客服 | 客户告知,客服待命 |
| 派送中 | 客户 | 自动消息 |
| 已签收 | 客户 | 自动消息 + 邀请确认 |
| 退回/清关失败 | 客服 + 客户 | 工单优先,人工先介入 |
把 20 条扫描事件都推给客户,换来的一定是"消息免打扰"——通知的价值和频率成反比。
第四步:异常兜底——停滞检测
这是整套体系里价值最高、也最少有人做的一环。
逻辑:运单超过 N 天没有新轨迹,就自动进入"停滞"状态,触发内部工单——不用等客户来问。
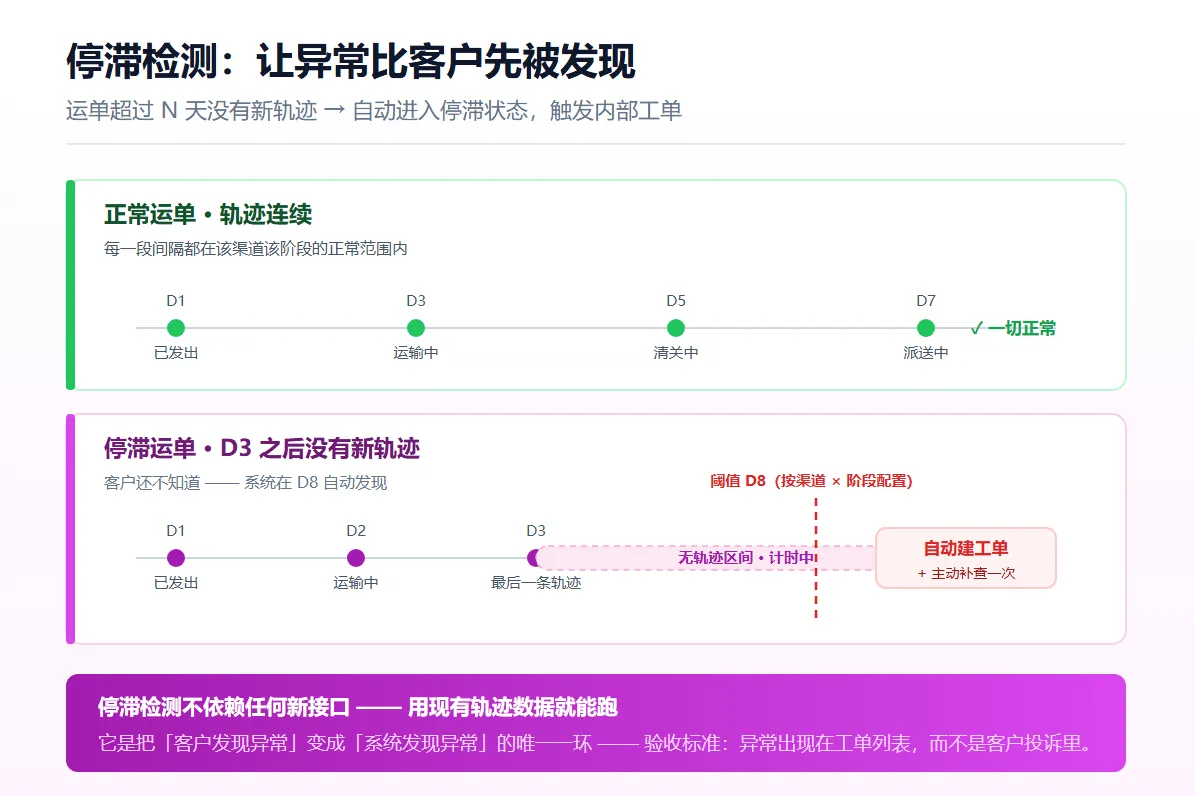
图 2 · 正常运单轨迹连续,停滞运单超过阈值自动告警——从「客户发现」变成「系统发现」
# 每日跑一次
stalled = orders_where(last_track_time < now() - threshold(days=5),
                       status_not_in=["已签收", "已关闭"])
for order in stalled:
    create_ticket(order, reason="轨迹停滞超过 5 天")
    refresh_tracking(order)      # 顺便主动补查一次
阈值怎么定:不同运输阶段不同——运输中的段和清关中的段,正常停留时间完全不一样。可以按"渠道 × 阶段"分别配置,初始值取该渠道历史 P90 停留时长。
验收标准:故意造一条 5 天无更新的运单,第二天早上它应该出现在工单列表里,而不是出现在客户的投诉里。
四、选型时的五个问题
如果轨迹数据来自第三方聚合服务(多数团队会这么选),签约前把这几个问题问清楚:
- 渠道覆盖:你用的那些承运渠道,覆盖了几个?未覆盖的怎么办?
- 推送延迟:轨迹更新到推送到达,正常延迟多久?有无延迟指标承诺?
- 异常粒度:失败、退回、清关扣留,是区分成不同代码,还是笼统一句"异常"?——异常粒度决定你的工单能不能自动分流
- 计费方式:按运单数还是按查询次数计费?轮询兜底的成本模型要提前算清
- 历史轨迹:接入前的历史运单能不能批量补拉?——不能的话,切换期会出现数据断层
第 3 问是分水岭。把所有异常都归成一类"异常"的服务商,你的异常处理就永远要人工看——自动化程度的天花板在选型时就定死了。
五、自检清单
- [ ] 轨迹以订阅为主、轮询兜底?轮询有没有水位和退避?
- [ ] 回调验签、快返回、幂等三件事都做了?
- [ ] 每个渠道 × 状态都有显式映射?未映射的会告警而不是丢弃?
- [ ] 状态更新有防倒退保护?
- [ ] 客户通知只发节点,不发扫描事件?通知有频控吗?
- [ ] 异常状态自动建工单,而不是只改个状态?
- [ ] 有停滞检测?阈值按"渠道 × 阶段"分别配的?
- [ ] 停滞运单会自动触发补查?
如果只能先做一条,做停滞检测——它不依赖任何新接口,用现有轨迹数据就能跑,却是把"客户发现异常"变成"系统发现异常"的唯一一环。
结语
回到开头那个场景。
自动化之后的图景是:客户问"货到哪了",客服看一眼自己的系统——不对,多数时候客户不会问了,因为关键节点系统已经主动告诉他了。
而少数需要人工介入的情况(清关卡住、轨迹停滞、退回),是以工单的形式出现在客服的工作列表里,比客户的提问早一步。
最后给一个判断标准:
客户问"货到哪了"时,你的客服是打开自己的系统,还是打开承运商的官网?
答案还是后者,说明追踪这件事还停留在"人肉查询",接口只接了一半。