摘要:从敲下 spark-submit 到第一个 Task 在 Executor 上跑起来,中间到底经历了什么?本文以"时间线"的方式,将 Spark 两大调度过程——资源调度(6 步)和任务调度(7 步)——按先后顺序完整串联。从 SparkContext 初始化、Master schedule() 分配资源、Worker fork Executor JVM、Executor 反向注册,到 Action 触发 DAGScheduler 切分 Stage、TaskScheduler 数据本地性排序、launchTasks 发送 Task、TaskRunner 执行并回传结果——每一步都有源码支撑。配合 1 张原创深色全流程图,助你建立 Spark 调度的端到端心智模型。
关键词:Spark 资源调度, 任务调度, schedule(), DAGScheduler, launchTasks, TaskRunner, Executor, 全流程
一、开篇:从 spark-submit 到 Task 执行的完整时间线
spark-submit ──→ 资源调度(6步) ──→ Executor就绪 ──→ 任务调度(7步) ──→ 结果返回
|<-------- SparkContext 初始化 -------->|<-------- Action 触发后循环 -------->|
两条核心原则:
- 资源调度发生在 SparkContext 初始化时(一次)
- 任务调度发生在每个 Action 算子调用时(循环)
二、全流程图
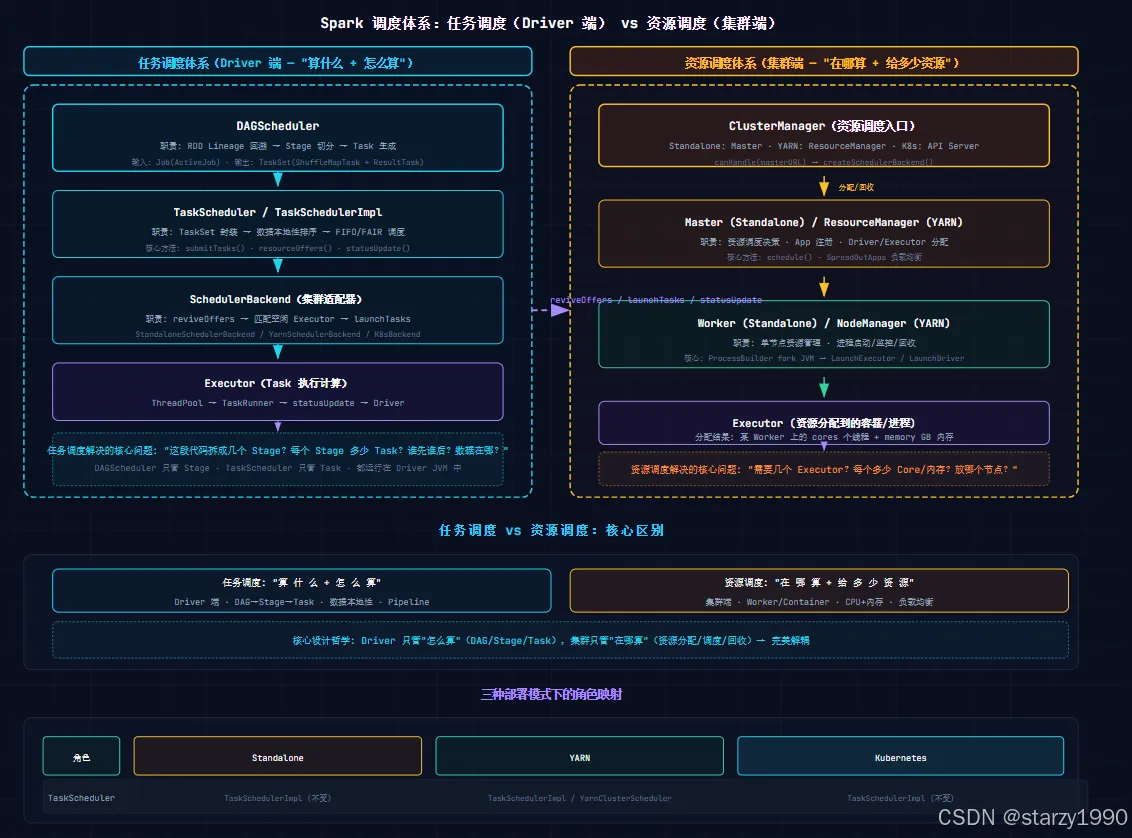
三、资源调度 6 步(SparkContext 初始化时)
Step ①: SparkContext 创建三大调度器
// 源码:SparkContext.scala
val (schedBackend, taskScheduler) = SparkContext.createTaskScheduler(this, master)
_dagScheduler = new DAGScheduler(this)
_taskScheduler.start()  // ← 触发后续资源调度
Step ②: SchedulerBackend 向集群注册
// StandaloneSchedulerBackend.start()
override def start(): Unit = {
  // 创建 ClientEndpoint → 向 Master 发送 RegisterApplication
  client = new StandaloneAppClient(sc.env.rpcEnv, masters, ...)
  client.start()
}
Step ③: Master.schedule() 分配资源
// Master.scala - schedule() 核心
private def schedule(): Unit = {
  for (app <- waitingApps) {
    // 筛选 Alive Worker → SpreadOut 分散
    val usableWorkers = workers.filter(...)
    for (worker <- usableWorkers) {
      launchExecutor(worker, app, coresToUse)
    }
  }
}
Step ④-⑥: Worker fork JVM → 反向注册 → Driver 确认
Worker 收到 LaunchExecutor → ProcessBuilder fork
  → CoarseGrainedExecutorBackend.onStart()
  → ref.ask(RegisterExecutor(executorId, self, cores, memory))
  → Driver: executorDataMap.put(id, data) → RegisteredExecutor
四、任务调度 7 步(每个 Action 触发)
Step ①: Action → sc.runJob()
// RDD.collect() 内部
def collect(): Array[T] = sc.runJob(this, iter => iter.toArray)
Step ②: DAGScheduler 切分 Stage
// DAGScheduler.handleJobSubmitted()
val finalStage = createResultStage(finalRDD, func, partitions, jobId)
submitStage(finalStage)  // 递归提交(先父后子)
Step ③: submitMissingTasks → TaskSet
// 每个 Partition → 一个 Task
stage match {
  case s: ShuffleMapStage => partitions.map(id => new ShuffleMapTask(...))
  case s: ResultStage     => partitions.map(id => new ResultTask(...))
}
taskScheduler.submitTasks(new TaskSet(tasks, stage.id, ...))
Step ④: TaskScheduler 数据本地性排序
TaskSetManager.getLocalityWait() → PROCESS > NODE > RACK > ANY
Step ⑤: launchTasks → Executor
// SchedulerBackend.launchTasks()
executor.send(LaunchTask(new SerializableBuffer(serializedTask)))
Step ⑥-⑦: TaskRunner 执行 → statusUpdate
// Executor.TaskRunner.run()
val task = ser.deserialize(taskData)           // 反序列化
val res = task.run(...)                        // 执行 RDD 算子
execBackend.statusUpdate(FINISHED, serResult)  // 回传 Driver
五、资源调度 vs 任务调度对比
| 维度 | 资源调度 | 任务调度 |
|---|---|---|
| 触发时机 | SparkContext 初始化(一次) | 每个 Action(循环) |
| 执行位置 | 集群端(Master/RM → Worker/NM) | Driver 端(DAGScheduler → TaskScheduler) |
| 核心方法 | schedule() → launchExecutor() |
runJob() → launchTasks() |
| 输出 | Executor JVM 进程 | Task 执行结果 |
| 粒度 | 应用级(全局资源) | Stage/Task 级(Per Job) |
六、总结
| 要点 | 总结 |
|---|---|
| 资源调度 | 初始化时执行 1 次,分配 Executor 进程 |
| 任务调度 | 每个 Action 触发,循环分发 Task 到已有 Executor |
| 关键分界 | Executor 反向注册完成 = 资源调度结束 = 任务调度开始 |
金句:资源调度是"盖工厂"(建 Executor),任务调度是"派订单"(发 Task)。工厂只盖一次,订单源源不断。
作者:starzy | AI Data Engineer / 大数据技术实践者
博客:blog.starzy.cn | GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践