去年我开始用 Claude Code 的时候,基本就是把它当个终端里的 AI 补全工具。我问它答,它写我抄,就这样。
直到有一天我数了一下,发现自己一天里重复输入了七遍几乎一模一样的提示词,改了十二个文件之后发现方向全错,还得手动一个个改回去。我才意识到:我用的不是 Claude Code,我用的是一个会打字的复读机。
后来我慢慢摸到了它真正的用法。下面这 10 个功能,是我现在每天都会用到的,顺序不分先后,但每一个都解决过一个具体的痛点。
被 Claude 一口气改了 15 个文件之后,我学会了先让它闭嘴
我以前的习惯是,看到需求直接让 Claude 写代码。结果它一上来就把半个项目翻了个底朝天,改完之后我看 diff 看了半小时,最后发现思路根本不对,只能全部回滚。
解法是 Plan Mode。 按 Shift+Tab 切进去,先让它理解项目、给方案,别碰文件。我的提示词大概是这样:
进入计划模式。我想给这个 FastAPI 项目加认证。先检查现有结构,不要修改任何文件。给我:需要改哪些文件、数据库改动、API 改动、安全考虑、测试计划。
这给了我一个机会,在它开始动手之前,先拦住那个错误的方案。多文件改动之前,先规划,省下的不是时间,是不用回滚的安心。
同样的提示词写到第七遍,我把它变成了一个命令
我曾经每隔两天就要给 Claude 发一次几乎相同的代码审查指令:检查 bug、检查重复逻辑、检查安全问题、检查缺测试、检查命名、检查不必要的复杂度……
写到第七遍的时候,我停了。为什么要让 AI 记住我的习惯,而不是我把它固化下来?
我在 .claude/skills/review/SKILL.md 里写了一个技能文件,把上面这些检查项写进去。现在我只打一个 /review,它就按我的标准跑一遍。
技能最爽的地方在于,它可以带辅助文件、可以带脚本,慢慢长成一个完整的工作流。你不再是在写提示词,你是在给自己造工具。
我讨厌提醒 Claude “记得格式化”
有一件事我特别烦:每次 Claude 改完文件,我都得补一句“顺便格式化一下”。有时候我忘了,代码就带着它自己的缩进风格提交上去了。
后来我用了 Hooks。它的逻辑很简单:某些事不该靠 AI 记得,应该靠系统强制执行。
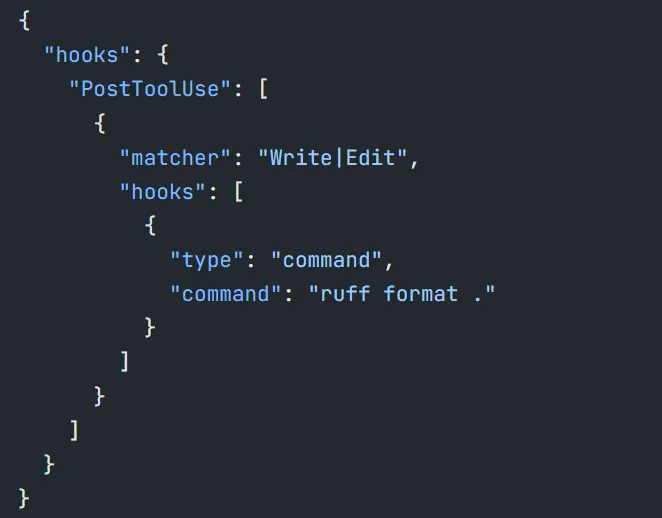
我在配置里加了一个 PostToolUse 钩子,匹配 Write|Edit,命令是 ruff format .。现在只要 Claude 写完或编辑完文件,格式化自动跑。我不再说那句话,Claude 也不用记。
钩子还能干很多事:记录命令、跑检查、发通知、拦截某些操作。凡是“每次都该发生”的事,都不该指望 AI 的记性。
我的主对话越来越长,直到我学会了“叫外援”
有那么一段时间,我的 Claude 主对话变得越来越臃肿。我在里面写功能、查 bug、做代码审查、让它搜代码库,什么都在一个上下文里。结果就是它越来越慢,越来越容易忘前面说过什么。
解法是 Subagents(子智能体)。
我可以直接说:
用一个子智能体检查认证实现里的安全问题,不要修改文件。
子智能体去干这个专项任务,把结果送回主对话。主对话保持干净,专注于主线。
不必把所有任务都塞进一个巨大的对话里,小任务隔离出去,主上下文保持专注。
两个 Claude 在同一个仓库里打架,我看不清是谁改坏了
我试过同时开两个 Claude 会话跑在同一个仓库里。一个在改认证,一个在修 bug。然后我改了同一个文件,突然就不知道是哪个会话破坏了什么。两个智能体在同一个目录里,就像两个人用同一支笔写同一张纸。
Git Worktrees 解决的就是这个。每个会话有自己独立的工作目录:
claude --worktree feature-login
claude --worktree bug-fix
现在项目结构变成:
project/
├── main
├── worktree-feature-login
└── worktree-bug-fix
每个 Claude 各干各的,互不干扰。并行不是问题,共享目录才是问题。
我手动告诉 Claude “改文件 1、改文件 2、改文件 3……”改到崩溃
有一次做一个大迁移,我给 Claude 列了一长串文件清单,一个个说改哪个。说到第五个的时候我就觉得,这不是 AI 该干的活,这是我该被 AI 替代的活。
/batch 就是干这个的:
/batch migrate src/ from JavaScript to TypeScript
它不会把整个迁移当成一个大任务,而是拆成独立的小块,分发到多个智能体和 worktree 里并行处理。从这一刻起,Claude Code 开始不像自动补全,而像一个工程系统。
代码能跑,但不代表它干净
我以前写完一个功能,跑通测试,就提交了。后来才发现,“能跑”和“写得好”是两件事。
/simplify 就是那第二遍审查:
给 API 响应加缓存。跑测试。然后对改动跑 /simplify。
它不只是问“这代码能工作吗”,它会从复用、质量、效率、和项目规范的一致性几个角度再看一遍。相当于实现完之后,再来一轮独立的“挑刺”。
我第九次跟 Claude 说“用 pytest,不要用 unittest”
我曾经一遍又一遍地纠正 Claude:用 pytest 不用 unittest、外部 API 调用用 async、别随便加依赖、新 Python 代码加类型注解。
然后在下一个会话里,我又得重新说一遍。
Auto-Memory 治的就是这个。用 /memory 配置之后,它会记住这些偏好:
- 优先用 pytest,而不是 unittest
- 外部 API 调用使用异步函数
- 未经询问不要添加依赖
- 新的 Python 代码使用类型注解
它和手动写项目指令不是一回事,它是 Claude Code 内置的、跨会话的记忆系统。它不能让“我已经告诉过你了”这句话彻底消失,但能让它出现的频率降下来。
Claude 改了 12 个文件,我不喜欢这个方向
这是那种“你不遇到就不知道它有多值”的功能。
Claude 改了 12 个文件,我看了一眼,不喜欢。以前我得手动一个个文件撤销,或者直接 git checkout . 把没提交的东西全扔了,包括我本来想留的部分。
/rewind 让我回到之前的状态。Claude Code 会自动在提示词周围创建检查点,我可以回滚,不用手动一个个撤销。
对实验性工作来说,这基本上就是一张安全网——让我敢试那些我不想马上提交的东西。
我不想每 30 分钟手动重启同一个任务
最后一个功能,是我需要任务反复执行的时候用的。
/loop 可以在本地安排一个循环任务:
/loop 30m check the test suite and report new failures
或者:
/loop 1h review the open PRs and summarize anything that changed
它和技能结合起来更有意思:
/loop 1h /review
于是你得到了:技能 /review 定义了可复用的审查流程,/loop 1h 让它每小时自动跑一次。重复的流程,不需要重复的人。
Claude Code 能写代码。但这些功能,才是让整个工作流真正感觉自动化的东西。