摘要:你有没有好奇过——为什么
--master spark://和--master yarn切换如此丝滑?这背后是 Spark 设计中最精妙的抽象层之一——ClusterManager。它通过 ExternalClusterManager 接口 + ServiceLoader 机制,将 Standalone、YARN、Kubernetes 三种资源管理器统一为可插拔的适配器。本文从接口设计、Master URL 路由、三种实现源码对比、自定义扩展四个维度,配合 1 张原创深色架构图 + 完整源码分析,带你彻底理解 Spark 资源调度层的设计哲学。关键词:Spark ClusterManager, ExternalClusterManager, SchedulerBackend, Master URL, ServiceLoader, Standalone, YARN, Kubernetes
一、开篇:一条命令背后的精妙设计
你在终端敲下:
spark-submit --master spark://master:7077 ...
spark-submit --master yarn ...
spark-submit --master k8s://https://kubernetes.default.svc ...
三条命令,三种完全不同的资源管理器。但对你的业务代码来说——完全透明,一行不改。
这背后就是 Spark 的 ClusterManager 抽象层。它让 Spark 可以在不修改核心调度逻辑的前提下,适配任意资源管理器。这种设计哲学在分布式系统中被称为"适配器模式"——Spark 将资源管理的"变"与 Task 调度的"不变"完美解耦。
二、ClusterManager 抽象层架构
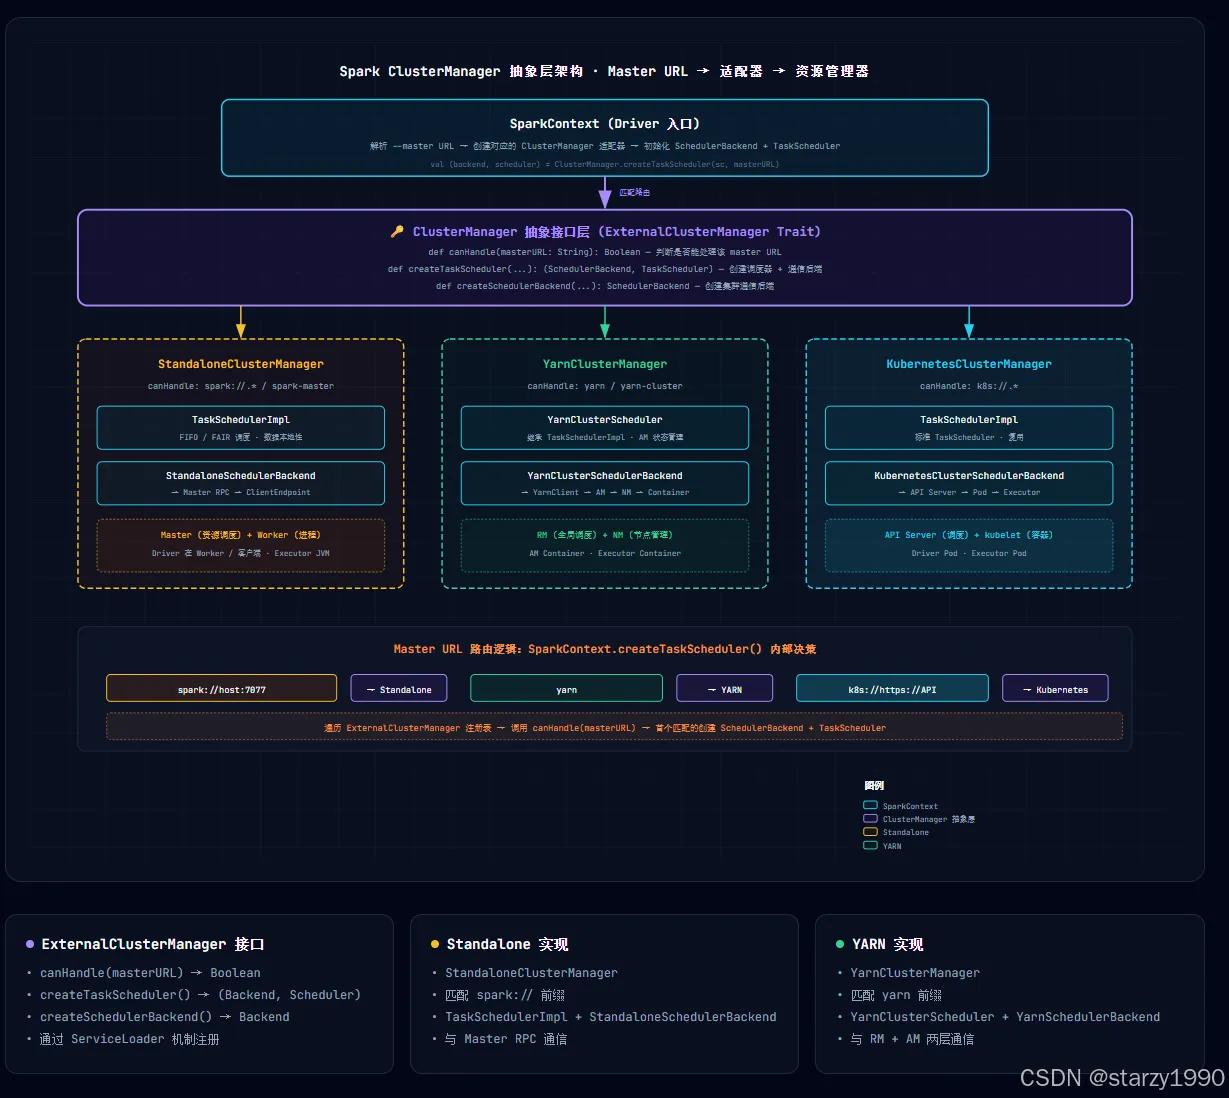
2.1 三层架构模型
Layer 1: SparkContext (用户入口)
         │  解析 --master URL
         ▼
Layer 2: ExternalClusterManager 接口 (抽象适配层)
         │  canHandle() + createTaskScheduler()
         ▼
Layer 3: 具体实现 (适配器)
         ├── StandaloneClusterManager  → StandaloneSchedulerBackend
         ├── YarnClusterManager        → YarnSchedulerBackend
         └── KubernetesClusterManager  → KubernetesClusterSchedulerBackend
2.2 核心接口:ExternalClusterManager
// 源码:ExternalClusterManager.scala
private[spark] trait ExternalClusterManager {
  // 判断是否能处理给定的 master URL
  def canHandle(masterURL: String): Boolean

  // 创建 TaskScheduler + SchedulerBackend 对
  def createTaskScheduler(
    sc: SparkContext,
    masterURL: String
  ): TaskScheduler

  // 创建集群通信后端
  def createSchedulerBackend(
    sc: SparkContext,
    masterURL: String,
    scheduler: TaskScheduler
  ): SchedulerBackend

  // 初始化(注册回调等)
  def initialize(scheduler: TaskScheduler, backend: SchedulerBackend): Unit
}
设计要点:
- canHandle():通过正则匹配 master URL 来决定哪个实现处理
- createTaskScheduler():返回 TaskScheduler(负责 Stage→Task 的分发逻辑)
- createSchedulerBackend():返回 SchedulerBackend(负责与集群通信)
三、Master URL 路由机制
这是 ClusterManager 最核心的代码——一条 URL 如何决定整个调度链?
// 源码:SparkContext.scala (简化)
private def createTaskScheduler(
  sc: SparkContext,
  master: String,
  deployMode: String
): (SchedulerBackend, TaskScheduler) = {

  master match {
    // ===== 内置:Standalone 模式 =====
    case SPARK_REGEX(sparkUrl) =>
      val scheduler = new TaskSchedulerImpl(sc)
      val backend = new StandaloneSchedulerBackend(scheduler, sc, sparkUrl)
      scheduler.initialize(backend)
      (backend, scheduler)

    // ===== 内置:Local 模式 =====
    case LOCAL_N_REGEX(threads) =>
      val scheduler = new TaskSchedulerImpl(sc)
      val backend = new LocalSchedulerBackend(sc.getConf, threads)
      (backend, scheduler)

    // ===== 动态:遍历 ExternalClusterManager 注册表 =====
    case other =>
      val cm = ExternalClusterManager.loadExternalClusterManager(
        new URI(other).getScheme
      )
      if (cm.isDefined) {
        val scheduler = cm.get.createTaskScheduler(sc, master)
        val backend = cm.get.createSchedulerBackend(sc, master, scheduler)
        cm.get.initialize(scheduler, backend)
        (backend, scheduler)
      } else {
        throw new SparkException(s"Unsupported master URL: $master")
      }
  }
}
3.1 ServiceLoader 注册机制
// ExternalClusterManager 通过 Java SPI 加载
object ExternalClusterManager {
  private val loader = ServiceLoader.load(classOf[ExternalClusterManager])

  def loadExternalClusterManager(scheme: String): Option[ExternalClusterManager] = {
    val it = loader.iterator()
    while (it.hasNext) {
      val cm = it.next()
      if (cm.canHandle(scheme)) return Some(cm)
    }
    None
  }
}
META-INF/services/
└── org.apache.spark.scheduler.ExternalClusterManager
    ├── org.apache.spark.deploy.yarn.YarnClusterManager
    └── org.apache.spark.scheduler.cluster.k8s.KubernetesClusterManager
四、三种实现源码对比
4.1 StandaloneClusterManager
// 匹配 spark:// 前缀
private[spark] class StandaloneClusterManager
  extends ExternalClusterManager {

  override def canHandle(masterURL: String): Boolean =
    masterURL.startsWith("spark://")

  override def createTaskScheduler(...) = new TaskSchedulerImpl(sc)

  override def createSchedulerBackend(...) =
    new StandaloneSchedulerBackend(scheduler, sc, masters)
}
通信模型:SchedulerBackend → ClientEndpoint → Master RPC → Worker → Executor
4.2 YarnClusterManager
// 匹配 yarn 前缀
private[spark] class YarnClusterManager
  extends ExternalClusterManager {

  override def canHandle(masterURL: String): Boolean =
    masterURL.startsWith("yarn")

  override def createTaskScheduler(...) = new YarnClusterScheduler(sc)

  override def createSchedulerBackend(...) =
    new YarnClusterSchedulerBackend(scheduler, sc, ...)
}
通信模型:SchedulerBackend → YarnClient → RM → AM(Driver) → NM → Container
4.3 KubernetesClusterManager
// 匹配 k8s:// 前缀
private[spark] class KubernetesClusterManager
  extends ExternalClusterManager {

  override def canHandle(masterURL: String): Boolean =
    masterURL.startsWith("k8s://")

  override def createSchedulerBackend(...) =
    new KubernetesClusterSchedulerBackend(scheduler, sc, ...)
}
通信模型:SchedulerBackend → Kubernetes API Server → Driver Pod / Executor Pod
五、三种实现对比表
| 维度 | Standalone | YARN | Kubernetes |
|---|---|---|---|
| Master URL | spark://host:7077 |
yarn |
k8s://https://api |
| SchedulerBackend | StandaloneSchedulerBackend | YarnClusterSchedulerBackend | KubernetesClusterSchedulerBackend |
| TaskScheduler | TaskSchedulerImpl | YarnClusterScheduler | TaskSchedulerImpl |
| 通信协议 | Netty RPC (自定义) | YARN Protocol (Hadoop RPC) | Kubernetes API (HTTP REST) |
| 资源抽象 | Worker → Executor | NM → Container | kubelet → Pod |
| 进程模型 | JVM 进程 | Container → JVM | Pod → JVM |
| Driver 位置 | Client/Worker | Client/AM | Client/Pod |
| 适用规模 | 中小集群 | 大规模生产 | 云原生 |
六、自定义 ClusterManager(扩展指南)
// Step 1: 实现 ExternalClusterManager
class MyClusterManager extends ExternalClusterManager {
  override def canHandle(masterURL: String): Boolean =
    masterURL.startsWith("mycm://")

  override def createTaskScheduler(sc: SparkContext, masterURL: String): TaskScheduler =
    new TaskSchedulerImpl(sc)

  override def createSchedulerBackend(sc: SparkContext, masterURL: String,
    scheduler: TaskScheduler): SchedulerBackend =
    new MyClusterSchedulerBackend(scheduler, sc, masterURL)

  override def initialize(scheduler: TaskScheduler, backend: SchedulerBackend): Unit = {
    scheduler.asInstanceOf[TaskSchedulerImpl].initialize(backend)
  }
}
# Step 2: 注册到 META-INF/services/
# 文件: META-INF/services/org.apache.spark.scheduler.ExternalClusterManager
# 内容: com.example.MyClusterManager

# Step 3: 使用
spark-submit --master mycm://host:9090 ...
七、总结
| 要点 | 一句话总结 |
|---|---|
| 抽象层 | ExternalClusterManager 接口解耦了 Spark 与资源管理器 |
| 路由 | canHandle() + ServiceLoader = 可插拔的 Master URL 路由 |
| 三种实现 | Standalone/YARN/K8s 各自实现 SchedulerBackend |
| 扩展 | 实现接口 + META-INF 注册 = 自定义资源管理器 |
金句:ClusterManager 是 Spark 的"联合国翻译官"——业务代码说一种语言,三个资源管理器说三种语言,它负责无缝切换。
作者:starzy | AI Data Engineer / 大数据技术实践者
博客:blog.starzy.cn | GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践