
pdf版下载链:https://pan.quark.cn/s/9cc742e9c2a8
24 AI 数据标注平台:ASR-LLM、质量控制与数据闭环
更新: 2026-10-12
适用项目:AI 操作平台、数据标注/质检/验收平台、智能座舱 ASR-LLM 链路、全链路日志查询平台。
适用岗位:Java 后端工程师、全栈工程师、AI 平台工程化工程师、AI Agent 应用开发工程师。
一、项目主线总结
这组面试问题主要围绕 AI 数据标注平台、AI 预标注、AI 质检、Human-in-the-Loop、任务分发、幂等性、动态分包、数据闭环 展开。
结合简历项目,可以把整体项目讲成一条完整链路:
线上问题 / 业务需求
        ↓
数据采集 / 日志回流 / 数据上传
        ↓
数据清洗 / 去重 / PII 治理 / 数据集管理
        ↓
主动学习选样 / 合成数据补齐
        ↓
AI 预标注
        ↓
人工标注
        ↓
AI 质检
        ↓
人工质检 / 仲裁 / 验收
        ↓
数据集版本管理
        ↓
模型训练 / 微调 / Benchmark 评测
        ↓
模型发布 / 线上反馈回流 / 漂移与失败聚类
        ↺ 回到选样、标注、训练与评测
面试回答的核心思路是:
- 平台化:不是为某一个业务单独写死流程,而是抽象成通用标注平台。
- 配置化:通过任务模板、字段配置、流程配置、质检规则配置适配不同业务。
- AI + 人工协同:AI 做预标注、批量质检、异常识别;人工做确认、修正、仲裁和验收。
- 可追溯:每一次标注、质检、验收都保留版本、模型版本、Prompt 版本、规则版本和操作记录。
- 工程化:后端重点讲清楚任务状态机、接口幂等、异步任务、回调幂等、动态分包和数据库行锁。
二、对话内容总结
图片中的对话主要涉及以下问题:
- 不同业务线,比如 LLM、CV、OCR、ASR 的标注流程如何统一设计。
- 标注规范 SOP 如何配置化,而不是写死在系统里。
- Human-in-the-Loop 工作流如何设计。
- 多次标注结果如何做版本管理。
- AI 质检和人工质检的流程、配合关系。
- 数据从数据集、清洗、标注出基准、模型训练、模型微调、Benchmark 到解释的完整链路。
- AI 预标注结果什么时候可以直接采用,什么时候必须人工确认。
- 标注平台如何支持不断变化的业务需求,如何设计可扩展任务模型。
- AI 预标注如何融入工作流,哪些步骤同步,哪些步骤异步。
- 如何保证标注结果的一致性、可追溯性和幂等性。
- 如果不使用缓存,如何让标注人员动态领取任务包,可以使用
select for update skip locked。
三、面试题与参考答案
1. 你们这个数据标注平台整体是怎么设计的?
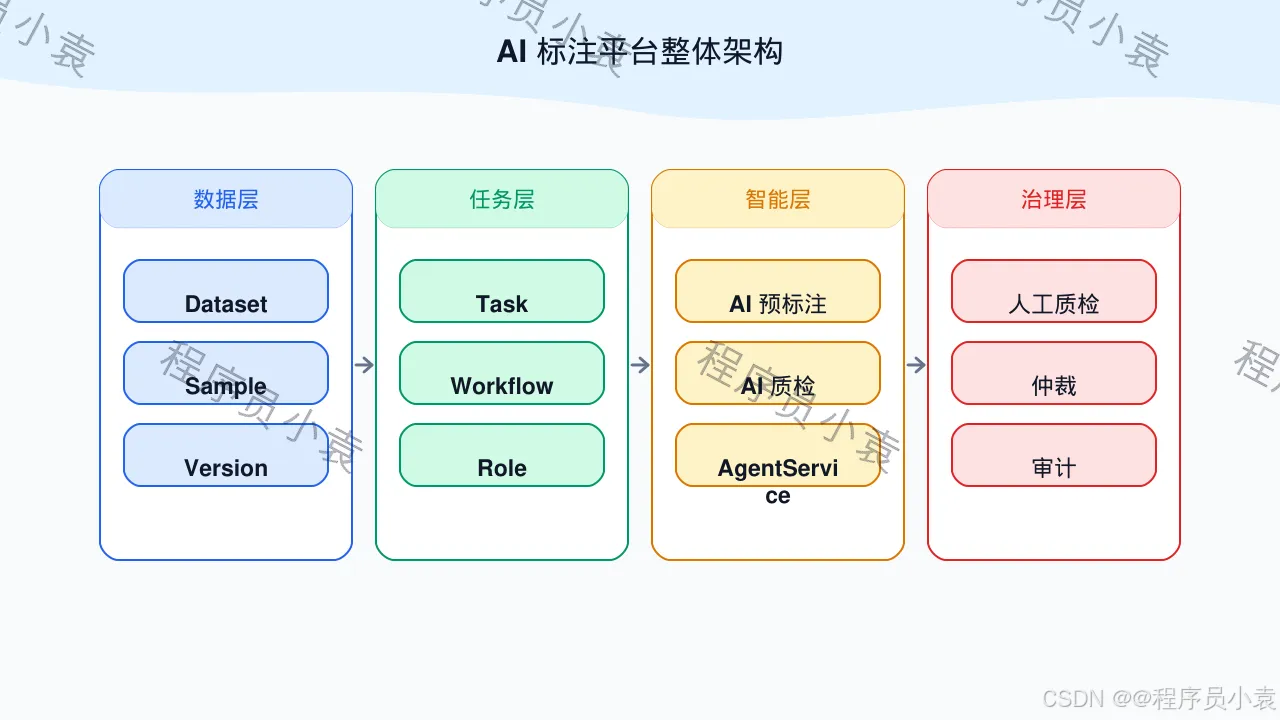
图解:AI 标注平台整体架构
参考回答
我们做的是一个统一的数据标注、质检和验收平台,主要服务智能座舱里的 ASR、文本理解、LLM 评测和数据回流场景。
整体上我没有把它设计成某一个固定业务的标注工具,而是抽象成一套通用的数据生产平台。核心链路是:
数据接入 → 数据集管理 → 任务创建 → AI 预标注 → 人工标注 → AI 质检 → 人工质检 → 验收 → 数据回流 → 模型训练 / Benchmark 评测
底层会把不同任务统一抽象成几个核心对象:
Dataset:数据集Sample:样本Task:标注任务AnnotationResult:标注结果QualityCheckResult:质检结果AcceptanceResult:验收结果Version:数据和结果版本
这样 LLM、ASR、OCR、CV 虽然标注内容不同,但是平台流程可以复用。差异部分通过任务模板、字段配置、规则配置和质检策略来适配,而不是每新增一个业务线就重新开发一套系统。
2. LLM、CV、OCR、ASR 这些不同业务线的标注流程怎么统一?
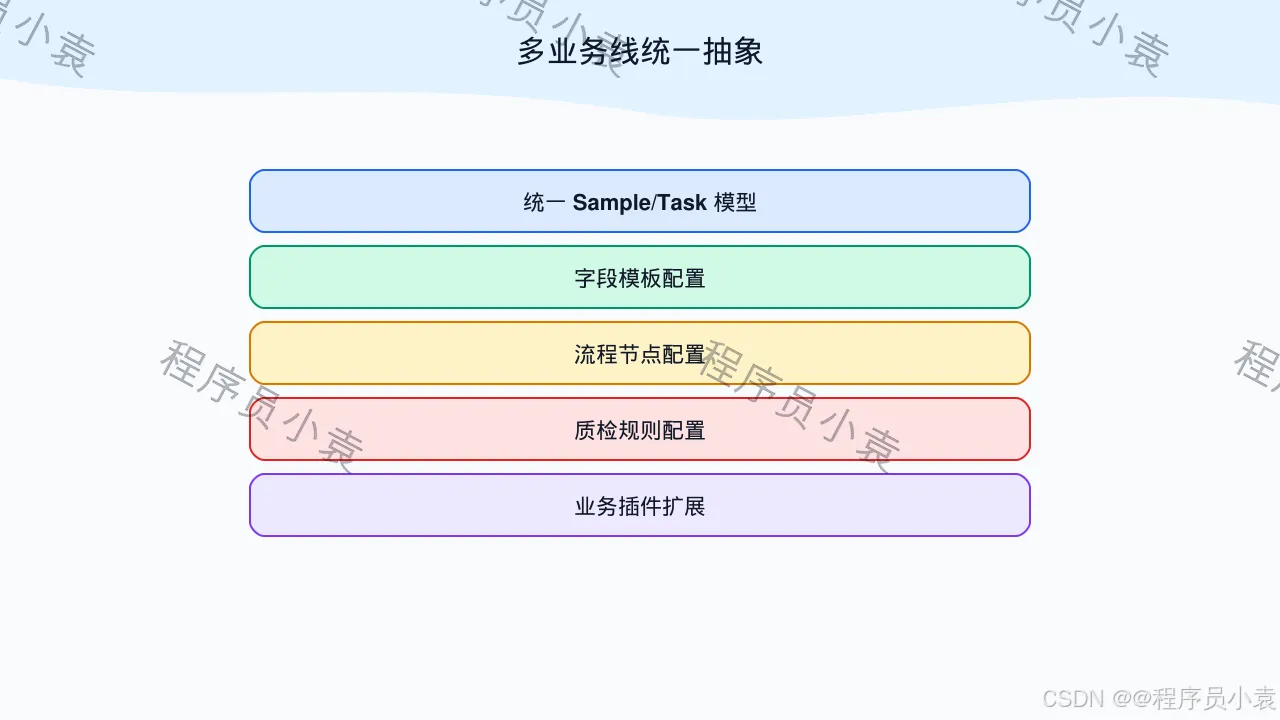
图解:多业务线统一抽象
参考回答
我的理解是,不能从具体业务字段出发去建系统,而是要先抽象共性流程。
不同业务线的差异主要在 数据类型、标注字段、质检规则、验收标准 上,但它们的生产流程是相似的:
样本进入平台 → 创建任务 → 分配人员 → 产出标注结果 → 质检 → 验收 → 形成可训练数据
所以我会把流程层和业务层拆开。
流程层统一处理:
- 任务创建
- 任务分发
- 状态流转
- 角色权限
- 结果提交
- 质检验收
- 版本记录
- 数据回流
业务层通过配置适配:
- ASR 配置音频、转写文本、CER / WER / SER 规则。
- LLM 配置 Prompt、答案、评分维度、裁判模型。
- OCR 配置图片、识别框、文本内容。
- CV 配置框选、分类、标签体系。
这样平台核心流程稳定,业务变化主要改配置和模板,减少代码频繁改动。
3. 标注 SOP 怎么做成配置化,而不是写死在系统里?
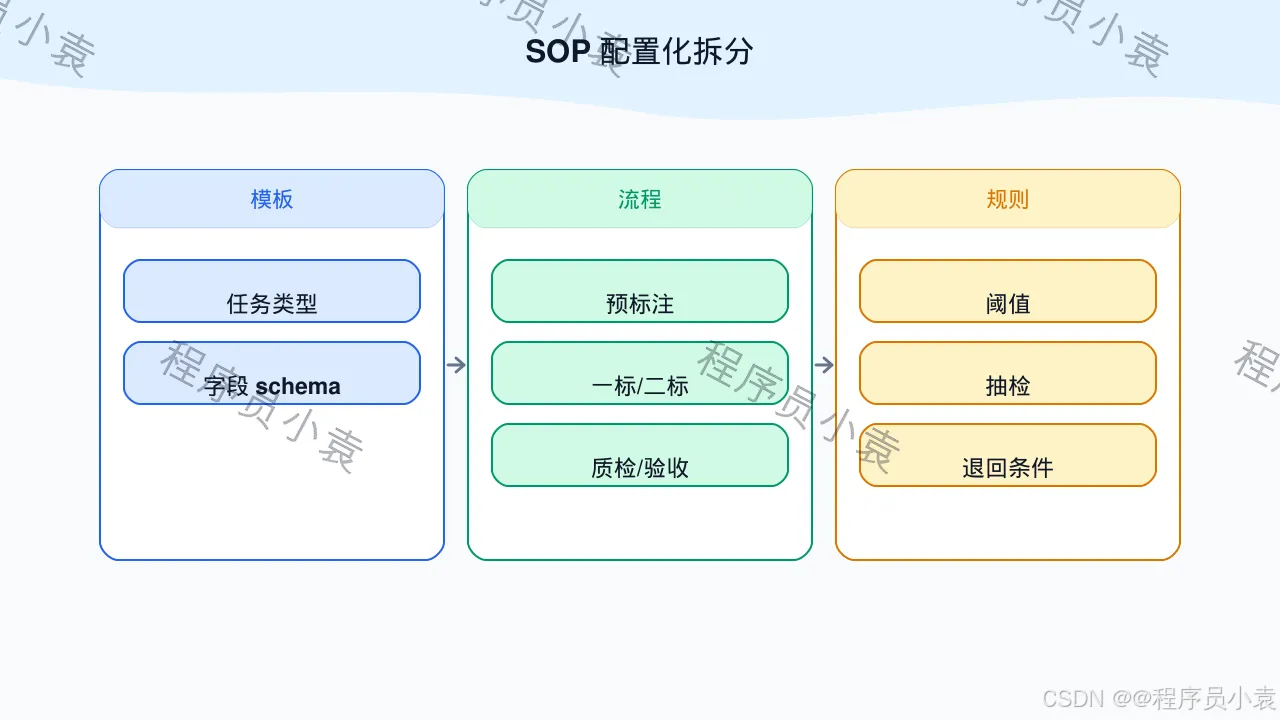
图解:SOP 配置化拆分
参考回答
SOP 配置化的核心是把“流程规则”和“业务代码”解耦。
我会把 SOP 拆成几类配置:
1)任务模板配置
比如任务类型、数据类型、标注字段、是否需要多轮标注、是否需要质检、是否需要验收。
2)流程节点配置
比如 AI 预标注、人工一标、人工二标、AI 质检、人工质检、验收,每个节点是否启用、前后顺序是什么。
3)规则配置
比如 ASR 场景下 CER、WER 超过多少需要退回;LLM 场景下评分低于多少需要人工复核;低置信度结果是否进入人工确认。
4)角色和权限配置
比如标注员只能提交结果,质检员可以打回,管理员可以验收和导出数据。
5)抽样策略配置
比如全量质检、按比例抽检、只抽低置信度样本、只抽高风险样本。
这样 SOP 不是写死在代码里,而是由平台配置驱动。新增一个项目时,只需要创建新的任务模板和规则配置,就可以复用已有的任务流转能力。
4. Human-in-the-Loop 工作流怎么设计?
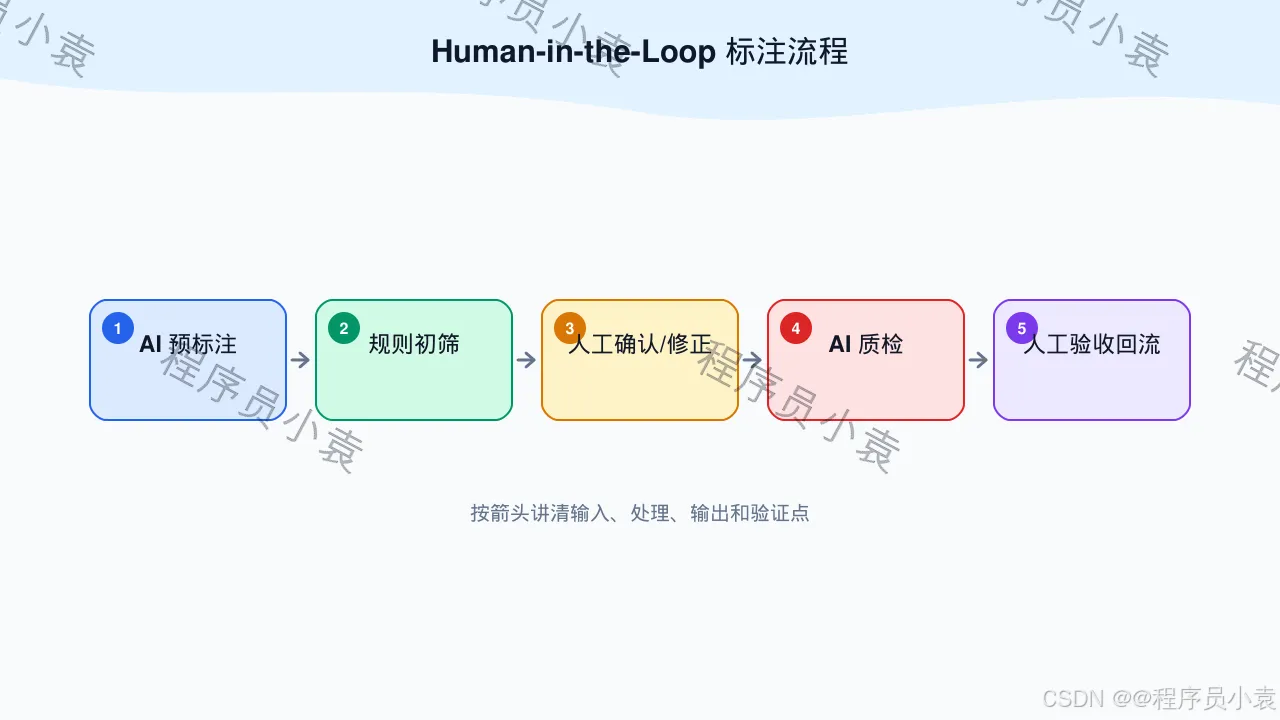
图解:Human-in-the-Loop 标注流程
参考回答
Human-in-the-Loop 本质是让 AI 先处理高重复、标准化的部分,人负责确认、修正和仲裁。
我设计的流程一般是:
数据入库 → AI 预标注 → 规则校验 → 人工确认 → AI 质检 → 人工质检 → 验收 → 回流训练集
AI 预标注阶段可以先生成初始结果,比如 ASR 文本转写、LLM 问答评分、分类标签、异常识别等。
然后系统会根据置信度和规则做一次初筛:
- 高置信度、规则通过的样本,可以进入快速确认或抽检。
- 低置信度、规则不通过的样本,必须进入人工标注。
- 多模型结果冲突的样本,进入人工仲裁。
- 高风险场景,比如车控指令、拒识样本、用户投诉样本,必须人工确认。
人工标注完成后,再通过 AI 质检做批量检查,最后由人工质检和验收保证最终质量。
这样既能利用 AI 提升效率,又不会完全依赖 AI,保证数据质量可控。
5. AI 预标注如何融入工作流?哪些步骤同步,哪些步骤异步?
图解:预标注同步/异步拆分
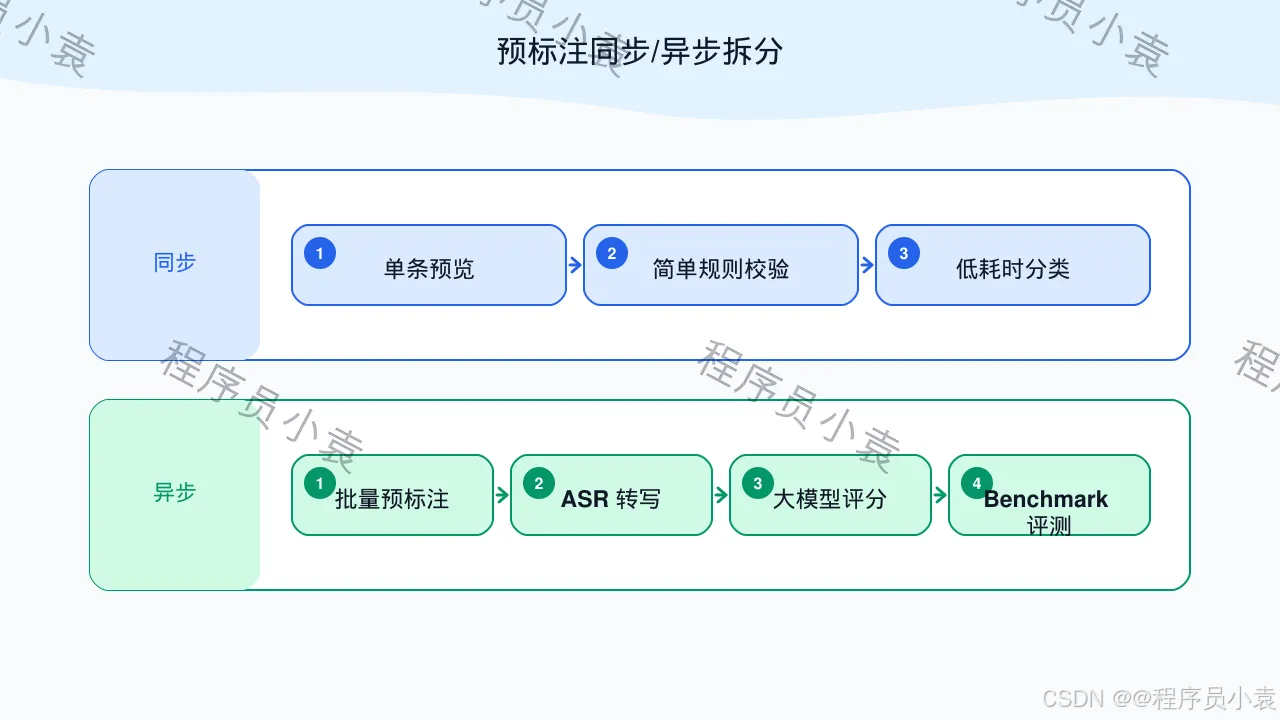
参考回答
AI 预标注我会设计成独立服务,比如 PreLabelService 或 AgentService,而不是直接写在标注平台主流程里。
平台负责创建任务和管理状态,AgentService 负责执行 AI 预标注、AI 质检、裁判模型调用等能力。两者之间通过 API 或消息队列解耦。
适合同步的场景
- 单条样本实时预览。
- 标注员打开样本时实时调用 AI 建议。
- 简单规则校验。
- 低耗时的分类、文本检测任务。
适合异步的场景
- 批量数据预标注。
- 音频 ASR 转写。
- 大模型批量评分。
- 多模型裁判。
- Benchmark 批量评测。
- 大批量质检任务。
异步场景下,我会设计任务状态机,比如:
待预标注 → 预标注中 → 预标注完成 → 待人工确认 → 已提交 → 待质检 → 待验收 → 已完成
同时每次调用都会记录 traceId、模型版本、Prompt 版本、输入输出、耗时、异常信息,方便后续排查和复盘。
6. AI 预标注结果什么时候可以直接采用?什么时候必须人工确认?
图解:AI 预标注采用决策
参考回答
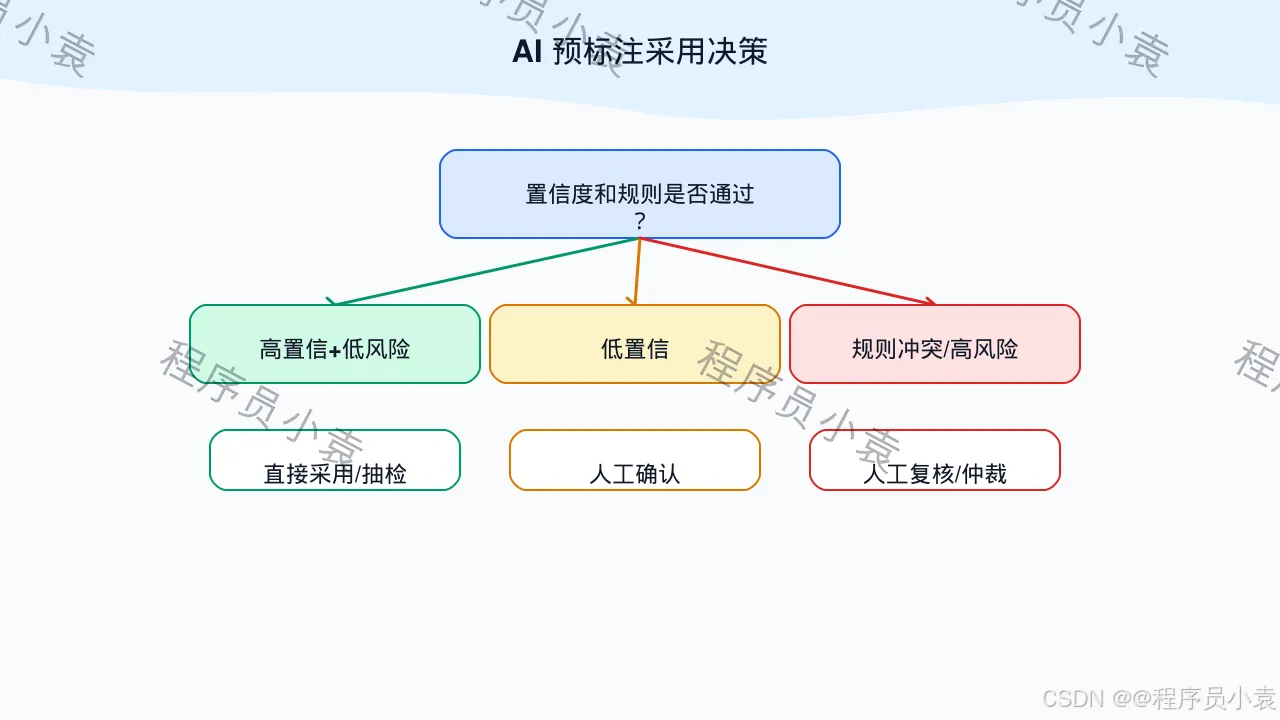
我不会简单地说 AI 结果全部采用或者全部人工确认,而是按风险和置信度分层处理。
可以直接采用或抽检的情况
- 模型置信度高。
- 规则校验通过。
- 历史同类任务准确率稳定。
- 业务风险低。
- 样本没有明显异常。
- 多模型结果一致。
必须人工确认的情况
- 模型置信度低。
- AI 结果和规则校验冲突。
- AI 质检发现异常。
- 多个模型输出不一致。
- 涉及车控、安全、拒识、用户投诉等高风险场景。
- 该样本属于新场景、新意图、新口音、新噪声环境。
比如 ASR 场景中,如果音频质量差、噪声大、识别结果不完整,或者 CER / WER 规则不达标,就必须进入人工确认。
LLM 场景中,如果裁判模型评分较低,或者 Prompt、答案、意图识别存在争议,也需要人工复核。
7. AI 质检和人工质检是什么关系?
参考回答
AI 质检和人工质检不是替代关系,而是分工协作关系。
AI 质检更适合做批量、标准化、规则明确的检查,比如:
- 字段是否缺失。
- 格式是否正确。
- 标签是否越界。
- ASR 转写和音频是否明显不一致。
- LLM 答案是否跑题。
- Prompt 和结果是否匹配。
- 是否存在重复样本、异常样本。
- CER / WER / SER 是否超过阈值。
人工质检更适合处理复杂判断和争议样本,比如:
- 语义是否准确。
- 标注标准是否理解一致。
- 多个标注员结果冲突时如何仲裁。
- 高风险样本是否可进入训练集。
- AI 和人工结果不一致时最终取谁。
所以我会让 AI 质检作为第一道批量筛查,人工质检作为最终质量兜底。这样既能提升效率,也能保证高质量数据不会完全依赖模型判断。
8. 如果 AI 质检和人工质检结果冲突,最终取谁?
参考回答
一般不会简单固定取 AI 或人工,而是看冲突类型和业务规则。
默认情况下,最终验收结果以人工质检或管理员验收为准,因为人工对业务语义和边界场景的判断更可靠。
但系统不会忽略 AI 质检结果,而是会把冲突记录下来,进入争议样本池。
处理方式可以分几类:
- 如果 AI 质检命中的是硬规则,比如字段为空、格式错误、标签不合法,那即使人工通过,也要提示或阻断。
- 如果是语义类冲突,比如 AI 判断答案不准确,但人工认为可以接受,就进入人工复核或专家仲裁。
- 如果同类冲突大量出现,就要反查 SOP 是否不清晰,或者标注员理解是否有偏差。
最终结果会记录为一个新版本,同时保留 AI 质检结果、人工质检结果、仲裁结果和处理原因,保证后续可追溯。
9. 多次标注结果怎么做版本管理?
图解:标注结果版本链路
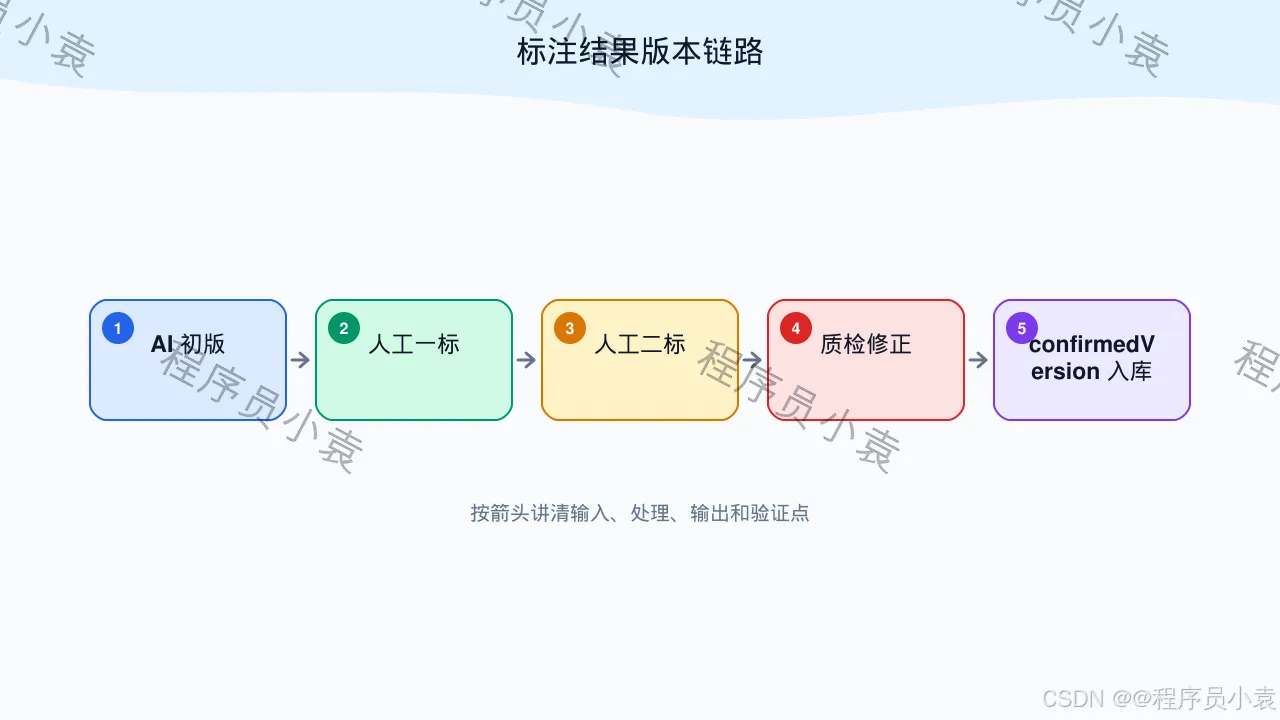
参考回答
标注平台里,同一个样本可能会经历多轮处理,所以必须做版本管理。
比如一个样本可能有:
- AI 预标注结果。
- 人工一标结果。
- 人工二标结果。
- AI 质检结果。
- 人工质检结果。
- 验收修正结果。
- 最终入训练集结果。
我会把每次结果都作为独立版本保存,而不是直接覆盖。
每个版本至少记录:
sampleIdtaskIdresultVersionresultContentoperatorType:AI / 人工 / 质检 / 验收operatorIdmodelVersionpromptVersionruleVersioncreatedTimediff信息- 审核状态
最终数据集会指向一个 confirmedVersion,也就是最终验收通过的版本。
这样可以支持三个能力:
- 结果可追溯,知道每一版是谁改的、为什么改。
- 支持回滚,如果新规则有问题,可以回到之前版本。
- 支持模型效果分析,可以对比 AI 预标注和人工最终结果之间的差异,用来优化模型。
10. 数据从哪里来?怎么进入标注平台?
参考回答
数据来源我会分成几类。
1)业务方直接提供
比如需求方上传 Excel、JSON、音频包、文本数据包。这类数据会先进入对象存储,比如 S3、OSS、Minio 或内部 FMS,然后平台解析元数据入库。
2)离线数据集
比如算法团队已经整理好的训练集、测试集、问题样本集,可以直接导入平台的数据中心。
3)线上日志和用户反馈数据
比如智能座舱里用户反馈的问题、ASR 识别异常、LLM 回复异常,可以通过日志平台筛选后回流到数据集。
4)模型训练或评测后的结果集
比如某次 Benchmark 发现效果差的样本,可以沉淀为新的标注任务。
5)通过规则查询生成
比如通过平台配置查询条件,从数据源里筛选指定品牌、环境、时间范围、意图类型、音频格式的数据,批量创建任务。
所以数据不是只靠人工上传,而是可以从业务反馈、日志链路、对象存储、历史数据集和模型评测结果中统一进入数据中心,再流转到标注任务。
11. AgentService 在这里起什么作用?
图解:AgentService 在平台中的位置
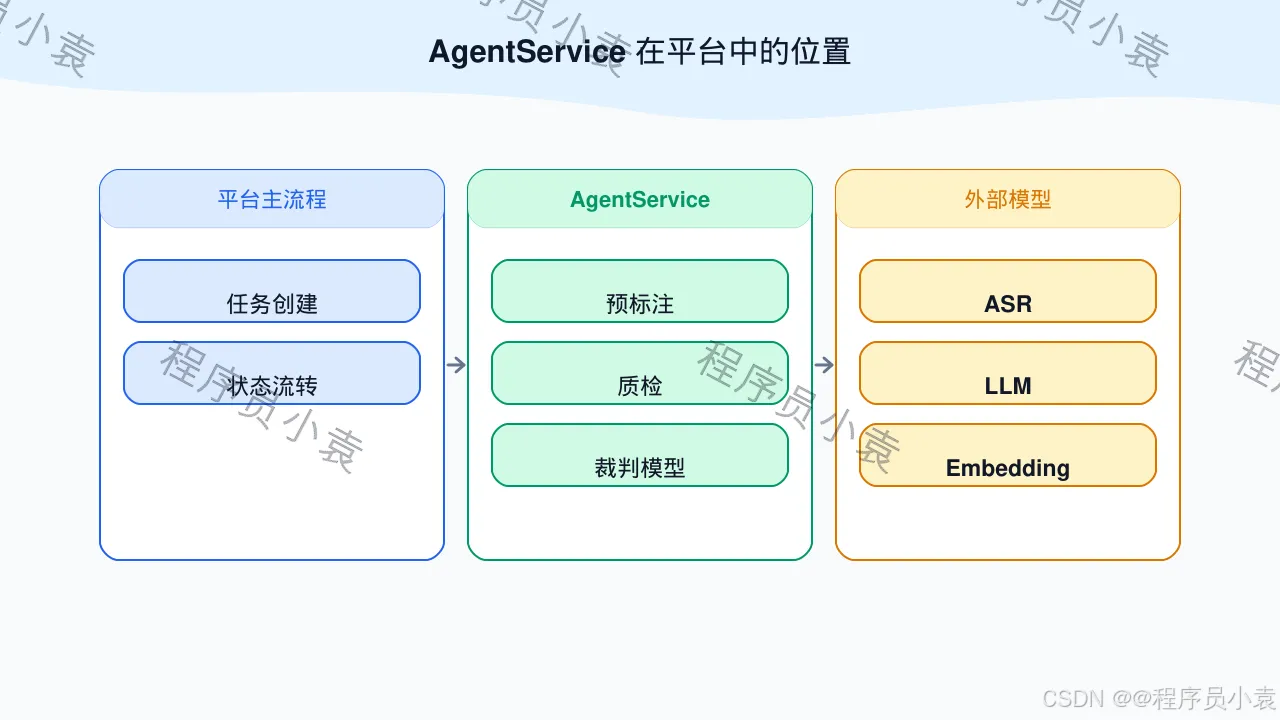
参考回答
AgentService 可以理解成平台里的 AI 能力执行层。
标注平台本身主要负责数据、任务、权限、流程和结果管理;AgentService 负责调用大模型、ASR、裁判模型、仲裁模型等 AI 能力。
它主要做几类事情:
- AI 预标注。
- Prompt 自动生成。
- 标注结果自动校验。
- 异常样本识别。
- 多模型裁判。
- 争议数据仲裁。
- Benchmark 自动评测。
平台通过 API 或消息队列把任务发给 AgentService,AgentService 执行完之后把结果回写到标注平台。
这样做的好处是平台和模型能力解耦。后续如果模型从 GPT-4o Realtime 换成 Qwen,或者新增 ASR 模型、OCR 模型,只需要改 AgentService 的适配层,标注平台主流程不用大改。
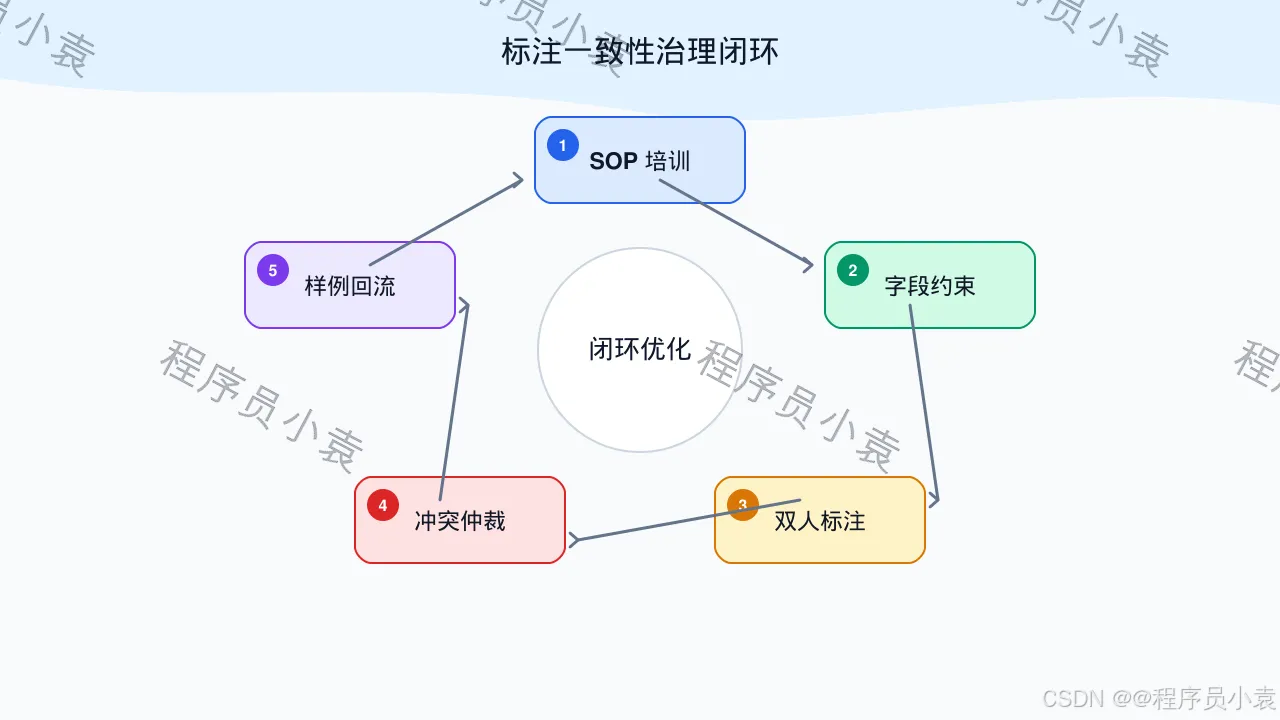
12. 如何保证不同标注员之间的一致性?
图解:标注一致性治理闭环
参考回答
标注一致性主要靠 SOP、工具约束、质检机制和数据分析一起保证。
1)SOP 要清晰
把标签定义、正例、反例、边界样本、特殊情况都写清楚,避免每个人按自己的理解标。
2)平台做字段和规则约束
比如必填项、枚举值、格式校验、标签互斥规则、文本长度限制等,减少低级错误。
3)引入双人标注或多人标注
对高风险样本,可以让两个人独立标注,再计算一致率。如果结果不一致,进入仲裁。
4)AI 质检辅助发现异常
比如识别标签冲突、文本不完整、ASR 转写异常、LLM 答案偏题等。
5)管理员看板做质量分析
按标注员、供应商、任务类型统计通过率、打回率、错误类型,发现某个标注员或供应商持续偏差时,可以做专项培训。
6)沉淀争议样本库
把容易产生分歧的样本作为后续培训和 SOP 优化依据。
13. 标注平台如何支持不断变化的业务需求?
参考回答
我的设计思路是平台能力通用化,业务差异配置化。
如果每新增一个任务类型就写一套代码,后期维护成本会很高。所以我会把系统拆成稳定层和变化层。
稳定层
- 数据集管理。
- 样本管理。
- 任务管理。
- 状态流转。
- 权限管理。
- 结果版本。
- 质检验收。
- 日志追踪。
变化层
- 标注字段配置。
- 任务模板配置。
- 流程节点配置。
- 质检规则配置。
- AI 模型配置。
- Prompt 模板配置。
- 数据导出格式配置。
比如现在做 ASR 标注,后面新增 LLM 问答评测,不需要重新开发任务流转,只需要配置新的任务模板、字段结构、质检规则和模型调用方式。
这样平台就可以支持未来业务扩展。
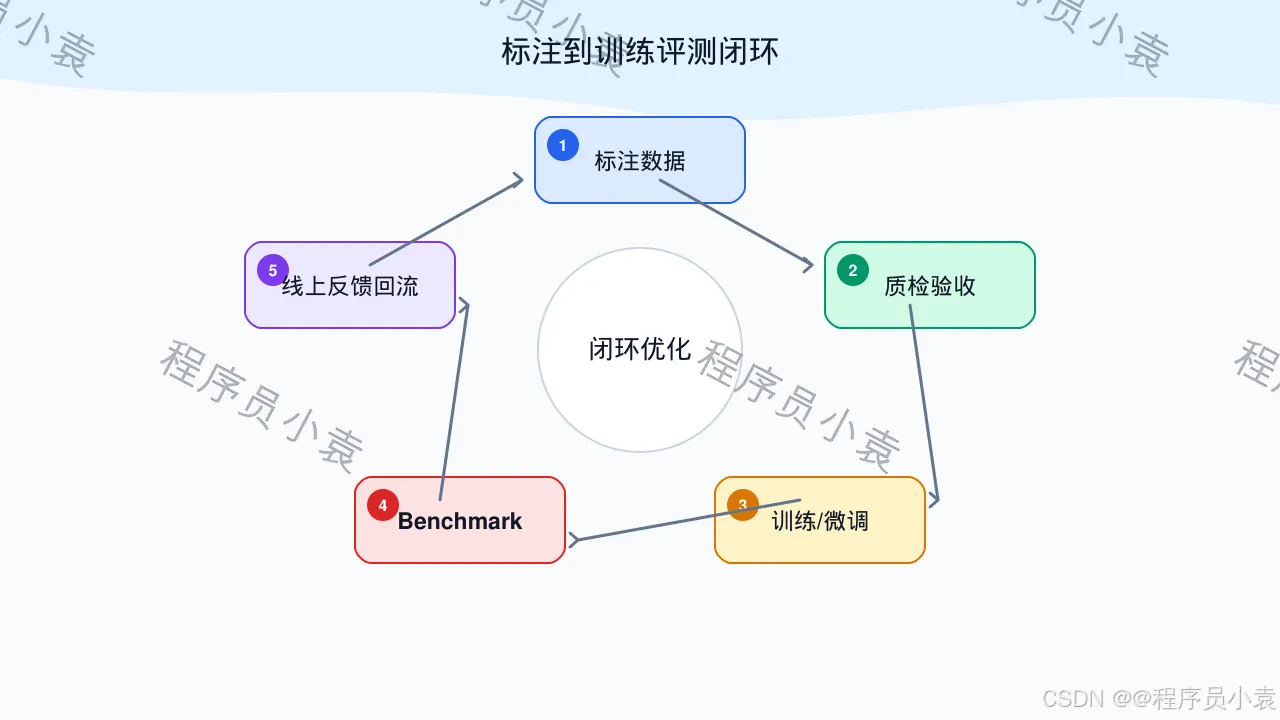
14. 标注平台和模型训练、微调、Benchmark 是怎么串起来的?
图解:标注到训练评测闭环
参考回答
标注平台不是孤立的,它属于整个模型迭代闭环里的数据生产环节。
完整链路是:
线上问题 / 业务需求 → 数据采集 → 数据清洗 → 数据标注 → 数据质检 → 数据验收 → 数据集版本 → 模型训练 / 微调 → Benchmark 评测 → 模型发布 → 线上反馈回流
标注平台主要负责把原始数据变成高质量、可追踪、可复用的数据集。
验收通过的数据会形成一个明确的数据集版本,比如 train_v1、test_v1、reject_case_v1。模型训练、微调和 Benchmark 都基于这个版本使用数据。
如果后续模型效果不好,可以反查:
- 用的是哪个数据集版本。
- 数据来源是什么。
- 标注规则是什么。
- 哪些样本被修改过。
- 哪些样本来自线上问题。
- 哪些样本是 AI 预标注后人工确认的。
这样模型效果问题可以回溯到数据层,而不是只看模型本身。
15. ASR 场景下,标注和质检有什么特殊点?
参考回答
ASR 场景和普通文本标注不一样,因为它涉及音频、转写文本、噪声环境和识别指标。
ASR 标注主要关注:
- 音频是否有效。
- 语音内容是否完整。
- 转写文本是否准确。
- 是否存在噪声、重叠说话、截断。
- 是否需要拒识。
- 是否符合车载语音场景。
质检指标上会接入 CER、WER、SER 等规则:
- CER 关注字符级错误率。
- WER 关注词级错误率。
- SER 关注句子级错误率。
在智能座舱场景里,还要关注语义是否影响后续 NLU / LLM 理解。
比如 ASR 少识别一个普通语气词可能影响不大,但如果把“打开空调”识别成“关闭空调”,那就是严重问题。
所以 ASR 标注平台不仅要看文本转写对不对,还要结合业务意图、上下文状态和车控风险来判断数据是否可用。
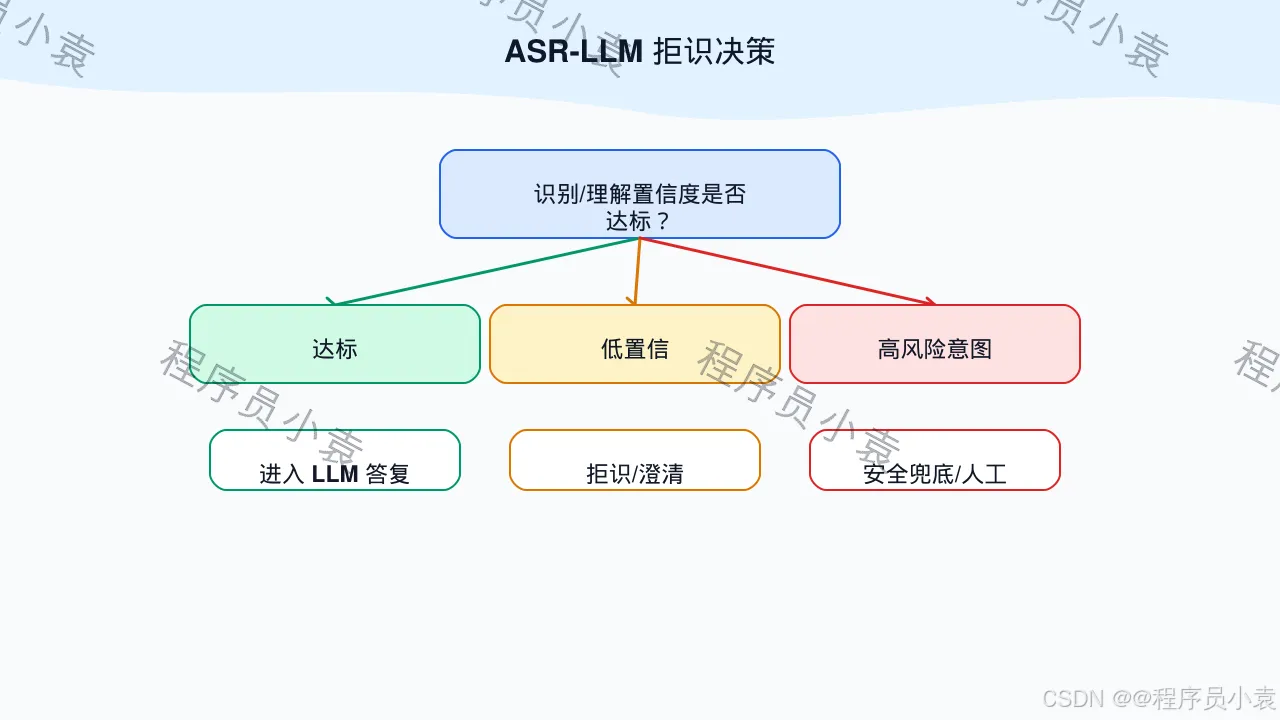
16. ASR-LLM 链路中的拒识机制怎么设计?
图解:ASR-LLM 拒识决策
参考回答
拒识机制主要是为了防止低质量输入继续传给后面的 NLU 或 LLM,避免产生错误执行。
我会在多个节点做拒识:
1)ASR 阶段
根据音频质量、识别置信度、是否为空文本、是否截断,判断是否拒识。
2)NLU 阶段
根据意图识别置信度、槽位是否完整、是否命中业务范围,判断是否拒识。
3)LLM 阶段
根据语义完整性、安全规则、上下文状态、车控风险,判断是否继续生成或执行。
4)业务执行前
再做一次规则校验,比如高风险车控指令必须满足明确意图和完整参数。
拒识样本不会直接丢弃,而是会沉淀到问题样本池,后续进入标注平台重新标注、质检和回流,用来优化 ASR 和 LLM 链路。
17. 你如何排查标注平台或 AI 链路中的问题?
参考回答
我会按链路排查,而不是只看单个接口。
首先通过 traceId 定位这次请求,从端侧数据、云端服务、ASR、NLU、LLM、NLG、标注平台结果一路查下去。
重点看几个信息:
- 请求输入是否正确。
- 数据集版本是否正确。
- 样本是否被重复处理。
- AI 预标注是否成功。
- 使用的是哪个模型版本。
- Prompt 版本是否正确。
- 质检规则是否命中。
- 人工是否修改过。
- 最终验收版本是什么。
- 接口耗时和异常日志是什么。
如果是模型输出问题,我会继续看 Prompt、模型请求、响应结果、Token 消耗、耗时和错误信息。
如果是数据问题,我会看样本来源、清洗规则、标注版本和质检结果。
如果是流程问题,我会看任务状态流转、消息队列、重试记录和数据库状态。
这样能把问题从“现象”定位到具体的数据、规则、模型或服务环节。
四、后端重点面试题
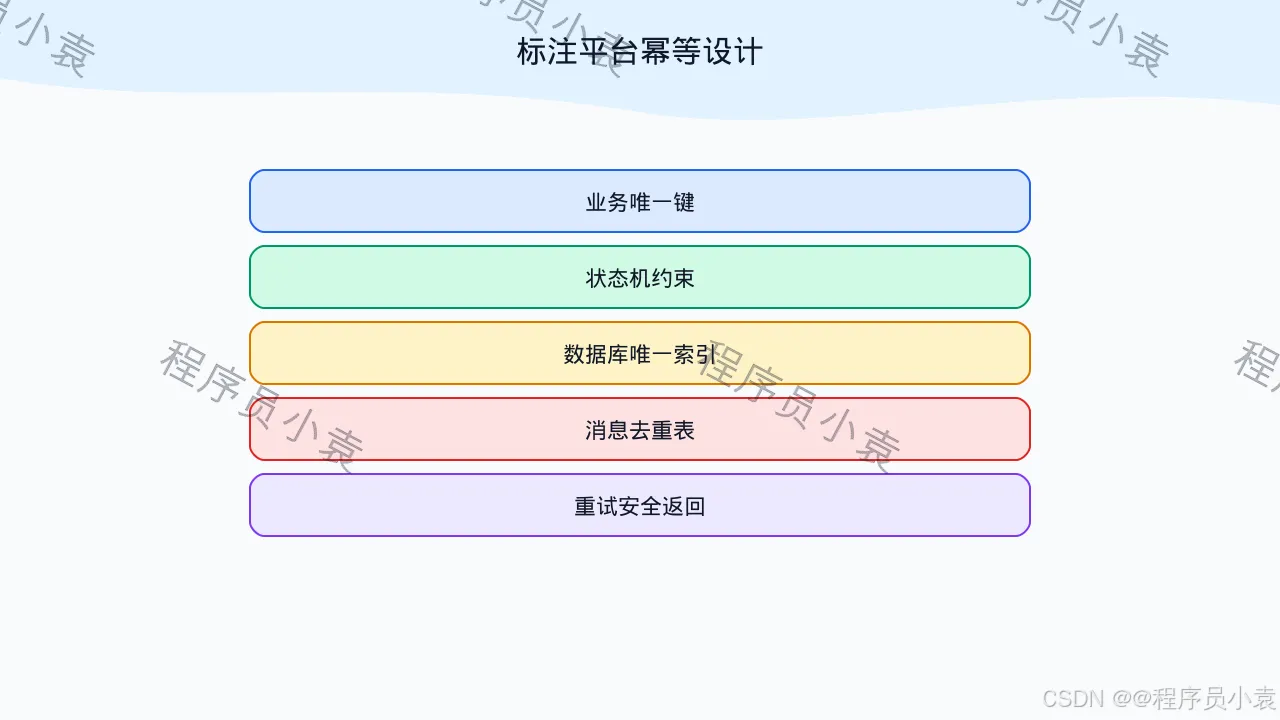
18. 你们平台里怎么保证幂等性?
图解:标注平台幂等设计
参考回答
幂等性我会分两层来看:一层是 业务流程幂等,另一层是 后端接口幂等。
在标注 / 质检平台里,很多操作都有重复执行的风险,比如重复创建标注任务、重复提交标注结果、AI 预标注任务重试、AI 质检回调重复通知、消息队列重复消费等。如果不做幂等,就可能出现重复任务、重复结果、状态错乱或者数据被覆盖的问题。
所以我主要从以下几个方面处理。
1)设计业务唯一键
对于核心业务动作,不能只依赖数据库自增 ID,而是要根据业务语义设计幂等 Key。
创建标注任务时,可以用:
datasetId + sampleId + taskType + taskVersion
保证同一个数据集、同一个样本、同一种任务类型、同一个任务版本下,不会重复创建任务。
AI 预标注时,可以用:
batchId + sampleId + modelVersion + promptVersion
保证同一批样本在同一个模型和 Prompt 版本下,不会因为重试生成多条重复预标注结果。
标注结果提交时,可以用:
taskId + sampleId + annotatorId + resultVersion
保证同一个标注员对同一个任务样本的某一版结果不会重复提交。
2)数据库层加唯一索引兜底
接口层判断不能完全解决并发问题,所以关键表会加唯一索引。
任务表可以加:
unique(dataset_id, sample_id, task_type, task_version)
预标注结果表可以加:
unique(batch_id, sample_id, model_version, prompt_version)
这样即使两个请求并发进来,数据库也能兜底防止重复插入。
接口层捕获唯一索引冲突后,不直接报系统异常,而是查询已有结果返回,保证调用方看到的是一个幂等结果。
3)接口层增加 requestId / idempotencyKey
对于后端接口,尤其是 POST 创建类接口,我会要求调用方传一个 requestId 或 idempotencyKey。
例如批量创建 AI 预标注任务:
{

  "requestId": "xxx",
  "datasetId": "xxx",
  "taskType": "ASR_PRE_LABEL",
  "sampleIds": ["1", "2", "3"]
}
后端先查这个 requestId 是否已经处理过:
- 已处理成功:直接返回之前的处理结果。
- 处理中:返回处理中状态,避免重复执行。
- 处理失败:根据业务规则决定是否允许重试。
- 未处理:创建任务并记录
requestId。
这个方式比较适合防止前端重复点击、网关超时重试、调用方重复提交。
4)状态机控制重复流转
标注平台里任务状态很多,比如:
待预标注 → 预标注中 → 待人工确认 → 已提交 → 待质检 → 待验收 → 已完成
每次状态流转前都要判断当前状态是否合法。
例如任务已经是“已完成”,此时又收到一次 AI 质检回调,就不能再把状态改回“待质检”。
可以通过状态机规则控制:
只有 待预标注 才能流转到 预标注中
只有 预标注中 才能流转到 预标注完成
只有 待质检 才能流转到 质检完成
这样即使接口被重复调用,状态也不会乱跳。
5)异步消息消费做消费幂等
AI 预标注、AI 质检、批量评测这类任务一般会走异步队列,而消息队列本身可能出现重复投递,所以消费者必须做幂等。
消费者拿到消息后,先根据 messageId、batchId、sampleId 查询是否已经处理过。
- 如果已经处理成功,就直接 ack,不再重复执行。
- 如果处理失败,可以进入重试。
- 如果正在处理中,可以跳过或者延迟重试。
核心逻辑是:消息可以重复投递,但业务结果只能生效一次。
6)更新类接口用乐观锁或版本号
对于标注结果、质检结果、验收结果这类会被多人或多个流程修改的数据,我会使用版本号控制。
结果表里可以有:
id
result_content
version
status
updated_time
更新时带上当前 version:
update annotation_result
set result_content = ?, version = version + 1
where id = ? and version = ?
如果更新条数为 0,说明数据已经被别人修改过,需要重新读取最新数据再处理。
这样可以避免人工标注、AI 质检、人工质检同时更新同一条结果时互相覆盖。
19. 后端接口层怎么做幂等性?
参考回答
后端接口幂等性我一般会按接口类型区分处理。
1)查询接口
查询接口本身通常是幂等的,比如 GET 查询任务列表、查询标注结果、查询质检记录。
同样的查询条件,多次请求不会改变数据状态,所以主要关注分页、排序和查询条件一致性。
2)新增类接口
新增类接口最容易出现重复数据,比如:
- 创建标注任务。
- 创建数据集。
- 创建 AI 预标注批次。
- 创建质检任务。
- 创建导出任务。
这类接口不能只靠前端按钮置灰,后端也必须兜底。
常见做法是:
- 前端或调用方传
requestId。 - 后端根据
requestId查询是否处理过。 - 核心业务表加唯一索引。
- Redis 或数据库记录请求处理状态。
- 重复请求直接返回已有结果。
例如创建标注任务时,第一次请求创建成功,第二次相同 requestId 再请求,后端不再插入新任务,而是返回第一次创建的任务 ID。
3)修改类接口
修改类接口要防止重复提交和并发覆盖。
比如标注员提交标注结果,可能连续点了两次提交按钮。如果不处理,可能会生成两条结果,或者把状态重复推进。
我会通过:
taskId + sampleId + annotatorId做唯一约束。resultVersion做版本管理。status状态机判断。- 乐观锁防止并发覆盖。
保证重复提交不会产生重复结果。
4)删除类接口
删除接口一般也要设计成幂等。
比如删除任务:
第一次删除成功,任务状态变成 deleted。第二次再删除,不应该报严重异常,可以返回删除成功或者“数据已删除”。
通常会采用软删除:
deleted = 1
deleted_time = xxx
删除前判断状态,如果已经删除,就直接返回成功。
5)回调接口
AI 预标注、AI 质检、模型评测这类经常有回调接口,回调接口一定要做幂等。
因为第三方服务或者 AgentService 可能因为网络超时重复回调。
回调接口可以用:
callbackId
batchId
sampleId
taskId
作为幂等标识。
收到回调后先判断:
- 这次回调是否已经处理过。
- 当前任务状态是否允许更新。
- 回调结果版本是否比当前版本更新。
- 是否已经存在最终结果。
如果已经处理过,就直接返回成功,避免调用方继续重试。
幂等性简洁背诵版
幂等性我会分业务幂等和接口幂等两层处理。
在标注平台里,重复创建任务、重复提交标注结果、AI 预标注重试、质检回调重复通知都可能导致数据重复或状态错乱,所以我会先根据业务设计唯一键,比如 datasetId、sampleId、taskType、taskVersion,保证同一个样本在同一个任务版本下只生成一次任务。在后端接口层,新增类接口会要求传 requestId 或 idempotencyKey,服务端先判断请求是否已经处理过;数据库层再通过唯一索引兜底,防止并发重复插入。修改类接口会结合状态机和乐观锁,避免重复提交和并发覆盖。异步消息和回调接口会根据 messageId、batchId、sampleId 做消费幂等,保证消息可以重复投递,但业务结果只能生效一次。
所以整体上不是只靠前端防重复点击,而是接口层、数据库层、状态机、消息消费和版本控制一起保证幂等性。
20. 不使用缓存的情况下,如何让标注人员动态领取任务包?
参考回答
在标注平台里,任务包不是提前固定分配给某个人,而是标注员进入系统后动态领取一批待标注样本。这个场景的核心问题是:多个人同时领取任务时,不能领取到同一批样本,也不能因为锁等待导致系统卡住。
如果不使用 Redis、缓存队列或者分布式锁,我会优先考虑用数据库的行级锁来实现,典型方案是:
select ... for update skip locked
它的作用是:当前事务查询待领取任务时,会对选中的行加排他锁;如果某些任务已经被其他事务锁住,就直接跳过,不等待,继续拿其他未锁定的任务。
这样可以实现多个标注员并发领取任务包时,互相不阻塞,也不会拿到重复数据。
1)表结构怎么设计?
可以有一张任务样本表:
annotation_task_item
核心字段包括:
id
task_id
sample_id
status              -- 待领取、已领取、标注中、已提交、已质检
assignee_id         -- 当前领取人
locked_time         -- 领取时间
submit_time
version
created_time
updated_time
状态可以设计为:
WAITING       待领取
ASSIGNED      已领取
ANNOTATING    标注中
SUBMITTED     已提交
QC_PENDING    待质检
FINISHED      已完成
2)动态领取任务包的核心 SQL
假设标注员一次领取 20 条任务,可以这样写:
begin;

select id
from annotation_task_item
where task_id = ?
  and status = 'WAITING'
order by id
limit 20
for update skip locked;

update annotation_task_item
set status = 'ASSIGNED',
    assignee_id = ?,
    locked_time = now(),
    updated_time = now()
where id in (...);

commit;
这里的关键点是:
for update skip locked
它会锁住当前事务选中的 20 条数据。如果另一个标注员同时来领取,已经被锁住的任务会被跳过,他会拿到另外一批未锁定的数据。
3)完整流程怎么说?
标注人员点击“领取任务”时,后端开启数据库事务,先从任务样本表中查询状态为 WAITING 的样本,并使用
select for update skip locked对这批数据加行锁。如果其他标注员也在同时领取,数据库会自动跳过已经被锁住的行,不会等待,也不会重复领取。查询到数据后,立即把这些样本状态更新为 ASSIGNED,并写入 assigneeId 和领取时间,最后提交事务。
这样整个领取过程是原子的,多个标注员可以并发领取任务包,不依赖 Redis,也不需要额外的分布式锁。
4)为什么不能用普通 select?
不能这样写:
select id
from annotation_task_item
where status = 'WAITING'
limit 20;
因为高并发下可能出现两个标注员同时查到同一批 WAITING 数据。
例如:
A 标注员查到 1-20
B 标注员也查到 1-20
A 更新为已领取
B 也更新为已领取
这样就会出现重复分配。
所以必须让“查询待领取数据”和“更新领取状态”在同一个事务中完成,并且查询时加行锁。
5)为什么不用普通 for update?
普通 for update 会加锁,但如果前面的数据已经被别人锁住,它会等待。
例如:
select id
from annotation_task_item
where status = 'WAITING'
limit 20
for update;
问题是多个标注员同时领取时,后面的请求可能一直阻塞,吞吐量会下降。
而:
for update skip locked
会跳过已锁定数据,直接拿其他可领取任务,更适合任务池并发领取场景。
6)后端接口怎么设计?
接口可以设计成:
POST /annotation/tasks/{taskId}/claim
请求参数:
{

  "userId": "10001",
  "batchSize": 20
}
后端逻辑:
@Transactional
public List<TaskItemDTO> claimTaskItems(Long taskId, Long userId, Integer batchSize) {

    List<Long> itemIds = taskItemMapper.selectWaitingForUpdateSkipLocked(taskId, batchSize);

    if (itemIds.isEmpty()) {

        return Collections.emptyList();
    }

    taskItemMapper.updateAssigned(itemIds, userId);

    return taskItemMapper.selectByIds(itemIds);
}
Mapper SQL:
select id
from annotation_task_item
where task_id = #{taskId}
  and status = 'WAITING'
order by id
limit #{batchSize}
for update skip locked;
更新 SQL:
update annotation_task_item
set status = 'ASSIGNED',
    assignee_id = #{userId},
    locked_time = now(),
    updated_time = now()
where id in (...)
这里必须注意:select 和 update 必须在同一个事务里。
7)如果标注员领取后不标怎么办?
领取任务后不能永久占用,所以需要设计超时回收机制。
比如任务领取后 30 分钟或 2 小时没有提交,可以通过定时任务把它回收到待领取状态:
update annotation_task_item
set status = 'WAITING',
    assignee_id = null,
    locked_time = null
where status = 'ASSIGNED'
  and locked_time < now() - interval 2 hour;
或者更严谨一点,只回收没有进入标注中的任务:
where status = 'ASSIGNED'
如果已经是 ANNOTATING,可以根据业务规则决定是否回收,避免误回收正在编辑的数据。
8)如果同一个人重复点领取怎么办?
这个可以结合前面的幂等性一起回答。
有两种策略:
策略一:允许继续领取
如果这个人已经有未完成任务,再点击领取时继续领取新的任务包。
策略二:限制未完成任务数量
比如每个人最多只能同时持有 50 条未完成任务。领取前先查:
select count(*)
from annotation_task_item
where assignee_id = ?
  and status in ('ASSIGNED', 'ANNOTATING');
如果超过阈值,就不再分配新任务,让他先完成已有任务。
面试中建议回答第二种,因为更符合标注平台的任务管理逻辑。
9)如果任务有优先级怎么办?
可以在领取 SQL 里加排序规则:
select id
from annotation_task_item
where task_id = ?
  and status = 'WAITING'
order by priority desc, created_time asc
limit 20
for update skip locked;
这样高优先级任务会被优先领取。
也可以按供应商、任务类型、语言、音频场景、车型品牌等条件筛选:
where task_id = ?
  and status = 'WAITING'
  and language = ?
  and data_type = ?
这样可以支持更复杂的动态分包策略。
10)这个方案的注意点
- 必须开启事务:
select for update skip locked只有在事务里才有意义。 - select 和 update 必须在同一个事务中:否则锁释放后,仍然可能被别人抢走。
- where 条件字段要建索引:比如
task_id + status + priority + id,否则高并发下会扫表,影响性能。 - 一次领取数量不要太大:比如一次 20 条或 50 条,避免事务持锁时间过长。
- 领取后要有超时回收机制:防止任务被标注员领取后长期不处理。
- 数据库要支持 skip locked:MySQL 8.0 和 PostgreSQL 都支持。低版本 MySQL 不支持时,需要考虑乐观锁更新或状态抢占方案。
动态分包简洁背诵版
在我们标注平台里,任务包是动态领取的,不是提前固定分配。这个场景的关键是多个标注员同时点击领取时,不能拿到同一批样本。
如果不使用 Redis 或缓存队列,我会用数据库行锁来做,核心是
select for update skip locked。后端在领取接口里开启事务,先查询状态为 WAITING 的任务样本,并通过for update skip locked锁住当前选中的一批数据。如果其他人也在领取,数据库会自动跳过已经被锁住的行,继续选择其他可领取任务。然后在同一个事务里把这批样本更新为 ASSIGNED,写入 assigneeId 和 lockedTime,最后提交事务。这样可以保证查询和更新是原子的,多个标注员并发领取时既不会重复分配,也不会互相阻塞。后续再配合任务超时回收、领取数量限制、优先级排序和状态机控制,就可以实现一个比较完整的动态分包机制。
五、可以背的项目总述
面试时可以这样整体描述:
我在蔚来 AI 项目里参与了数据标注、质检与验收平台建设,这个平台主要服务 ASR、文本、LLM 评测等数据生产场景。我的设计思路是把不同业务线的标注流程抽象成统一的数据集、样本、任务、结果、质检、验收和版本模型,业务差异通过任务模板、字段配置、流程配置和质检规则配置来适配。
在流程上,我们引入了 AI 预标注和 AI 质检能力,通过独立的 AgentService 调用大模型或 ASR 能力,先生成预标注结果,再由人工确认、质检和验收。对于高置信度、低风险样本可以走快速确认或抽检;对于低置信度、规则冲突、高风险样本则必须进入人工复核。
同时,平台会记录每一次标注、质检、验收的版本,包括模型版本、Prompt 版本、规则版本、操作人和修改记录,保证数据可追溯。最终验收通过的数据会形成数据集版本,回流到模型训练、微调和 Benchmark 评测流程中,形成从线上问题、数据生产到模型优化的闭环。
从后端实现上,平台核心关注任务状态机、接口幂等、异步任务、回调幂等和动态分包。比如动态分包在不使用 Redis 的情况下,可以通过数据库的
select for update skip locked实现多个标注员并发领取任务,既避免重复分配,也避免锁等待阻塞。
六、高频追问速答
1. 为什么要把 AI 预标注做成独立服务?
因为标注平台主要管任务、流程、权限和数据;AI 能力会经常变化,比如模型、Prompt、裁判逻辑、ASR 厂商都可能替换。做成独立 AgentService 后,平台和模型能力解耦,后续扩展成本更低。
2. AI 预标注能不能完全替代人工?
不能。AI 适合做初筛、预标注、批量质检和异常识别,但低置信度、高风险、语义争议、多模型冲突的样本必须人工确认。尤其是智能座舱场景,涉及车控和用户体验,最终数据质量必须有人兜底。
3. 标注结果为什么要版本管理?
因为同一个样本可能经历 AI 预标注、人工一标、人工二标、AI 质检、人工质检和验收修正。如果直接覆盖,就无法追溯问题来源。版本管理可以支持结果回溯、差异分析、模型效果复盘和数据集回滚。
4. 任务状态机有什么作用?
状态机可以保证任务只能按合法流程流转,避免重复提交、重复回调、状态回退和并发更新导致的数据错乱。比如任务已经完成后,再收到重复质检回调,只能忽略或记录日志,不能重新改状态。
5. 为什么动态领取任务时要用 skip locked?
图解:动态领取任务包流程
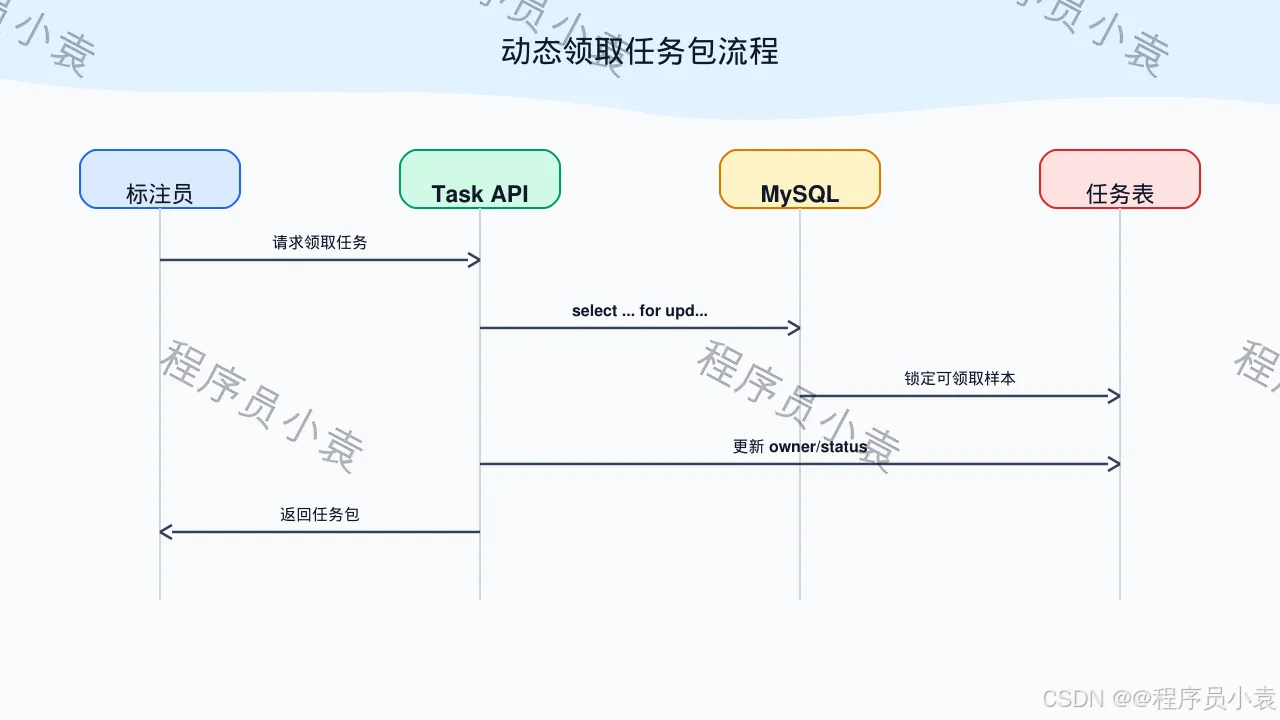
因为普通 select 会导致多人查到同一批任务,普通 for update 会导致后面的请求等待锁释放。skip locked 可以跳过已经被别人锁住的数据,直接拿其他可领取任务,所以更适合任务池并发领取场景。
6. 如果 MySQL 版本不支持 skip locked 怎么办?
可以用乐观锁或状态抢占方案。比如先查询一批 WAITING 任务,然后执行:
update annotation_task_item
set status = 'ASSIGNED', assignee_id = ?
where id = ? and status = 'WAITING'
根据更新成功的行数判断是否抢占成功。但这种方式在批量领取时实现更复杂,吞吐和代码复杂度不如 skip locked 方案。
7. 怎么证明这个平台不是简单 CRUD?
可以强调以下几点:
- 抽象了数据集、样本、任务、标注结果、质检结果、验收结果和版本模型。
- 支持不同业务线通过配置复用同一套流程。
- 接入 AI 预标注、AI 质检、裁判模型和仲裁模型。
- 有任务状态机、版本追踪、幂等控制、异步回调、动态分包等后端复杂逻辑。
- 能把线上问题数据回流到训练集和 Benchmark,形成模型迭代闭环。
七、建议面试表达关键词
面试时可以重点使用这些关键词:
数据生产闭环
任务模板配置化
SOP 配置化
Human-in-the-Loop
AI 预标注
AI 质检
人工仲裁
数据集版本管理
结果可追溯
状态机流转
接口幂等
回调幂等
消息消费幂等
动态分包
select for update skip locked
模型版本 / Prompt 版本 / 规则版本
Benchmark 评测
ASR-LLM 链路
拒识机制
Trace 链路追踪
八、2026 数据闭环、合成数据、主动学习与多模态标注
21. 生产级数据闭环怎么设计,才不会变成“线上坏样本直接回灌”?
参考回答
数据闭环不是把日志自动加入训练集,而是一个带版本、权限、质量门槛和因果验证的反馈控制系统:
线上信号
  → 合规采集/脱敏/不可变原始层
  → 失败检测与切片(模型、场景、地区、设备、噪声、风险)
  → 去重 + 泄漏/污染检查
  → 主动学习选样 + 随机审计样本
  → AI预标注 → 人工确认/专家仲裁
  → 数据集版本 + lineage
  → 训练/微调
  → 离线 golden/challenge/安全集
  → shadow/canary/A-B
  → 线上任务结果与漂移
  ↺ 生成下一轮选样策略
关键控制点:
- 原始层不可变:保留来源、同意/授权、采集时间、内容 hash 和 schema 版本;派生数据另建版本。
- 训练/评测隔离:按用户、会话、文档或时间切分,防止近重复样本跨 split;benchmark 和回归集设污染扫描。
- 反馈不是标签:点击、停留、投诉只是弱信号,要处理曝光偏差、位置偏差和反事实。
- 风险分层:高风险车控、隐私、安全、长尾新类进入专家复核,不能被平均准确率掩盖。
- 可归因发布:记录 dataset/model/prompt/rule/code 版本;canary 失败可回滚到明确工件。
- 删除可传播:用户撤回、数据到期或合规删除时,能定位所有派生集、索引、训练作业和缓存。
面试话术:
"闭环的重点不是回流速度,而是每个样本为什么进入、谁确认、进入哪个版本、是否污染评测、上线后是否真的改善目标切片。"
22. 主动学习怎么选样?为什么不能只挑“最低置信度”?
参考回答
低置信度可能集中在噪声、离群点或模型未校准区域,单独使用会造成采样偏差。生产中使用多目标 acquisition:
score(x) =
  α · calibrated_uncertainty
+ β · diversity_or_coverage
+ γ · business_risk
+ δ · novelty_or_drift
+ ε · disagreement(model/model or model/human)
- λ · annotation_cost
实践流程:
- 冷启动先用 foundation-model embedding 做聚类/覆盖采样,建立小而多样的 seed set。
- 模型有初始能力后,再组合 entropy/margin/ensemble disagreement 与多样性。
- 多模态任务不仅选样本,还可能选择“哪种模态、哪个时间段、哪对跨模态对齐”值得标。
- 每轮保留固定比例的随机样本,估计真实分布质量,避免只在困难池上自我感觉良好。
- 记录 acquisition policy/version/score,比较每标注小时带来的目标切片增益,而非只看标注条数。
- 结束条件应是边际收益、预算或切片覆盖达标,不是“未标数据清空”。
Label Studio 官方文档支持基于 prediction score 排序、预标注和 ML backend 的 active-learning loop;这提供工作流能力,但具体采样算法和偏差治理仍需平台实现。
23. 合成数据如何进入训练集?怎样防止低质量、隐私泄漏和模型坍塌?
参考回答
合成数据适合补充稀有意图、边界、安全对抗和格式覆盖,不能默认替代真实数据。推荐流水线:
需求矩阵/真实seed
 → 生成(generator + prompt + seed + sampling version)
 → 规则/schema/可执行验证
 → LLM/模型评分(多judge、校准)
 → PII/安全/许可证扫描
 → exact + fuzzy + semantic dedup
 → benchmark overlap / contamination 检查
 → 人工分层抽检
 → 与真实数据按切片混合
 → downstream train/eval 消融
质量至少分四轴:
| 维度 | 例子 |
|---|---|
| Quality | 事实、格式、可执行性、标签正确 |
| Diversity | 词法/语义/场景/人口统计覆盖,避免模板化 |
| Complexity | 推理深度、工具链长度、困难边界 |
| Privacy & provenance | PII、近似复现、membership inference、生成模型/Prompt/seed lineage |
NVIDIA NeMo Curator 官方文档提供启发式/分类器过滤、PII 处理、exact/fuzzy/semantic dedup;Distilabel 提供 EvolInstruct、EvolQuality 和 LLM judge pipeline。工具只能执行流程,不能证明数据安全或有效。最终必须用“真实留出集上的下游收益 + 切片鲁棒性 + 隐私攻击”验收,并做不含合成数据的消融基线。
24. 多模态标注与质检有哪些特殊设计?
参考回答
多模态标注的难点是 空间、时间和跨模态对齐,不是给图片再加一个文本框。
| 模态/任务 | 标注对象 | 关键质检 |
|---|---|---|
| 图像检测/分割 | bbox、polygon、mask、keypoint | IoU/边界质量、小目标漏标、类别一致性 |
| OCR/文档 | 文本、区域、阅读顺序、表格/版面 | CER、box IoU、结构正确率、页码/来源 |
| ASR/音频 | 转写、speaker、时间戳、事件、情绪 | WER/CER、说话人 DER、边界偏差、噪声切片 |
| 视频 | track、事件区间、动作、跨帧身份 | temporal IoU、轨迹连续性、关键帧漏标 |
| 图文/音视频 | caption、grounding、问答、偏好、对齐对 | 跨模态一致性、证据位置、负例质量 |
| GUI Agent | 屏幕元素、动作、前后状态、成功断言 | 坐标/selector、动作可执行、最终环境状态、安全级别 |
平台设计要点:
Sample支持多资源与同步时间轴,标注坐标保存原始尺寸/帧率及变换矩阵,避免缩放后无法回放。- 模态预处理(抽帧、裁剪、OCR、降噪、转码)必须版本化并保留与原始资源的映射。
- foundation model/SAM/OCR/ASR/VLM 只做交互式建议;标注员能接受、修改、拒绝,并记录 edit distance/耗时。
- 一致性指标按任务选择 Cohen/Fleiss kappa、Krippendorff alpha、IoU、WER/CER、temporal IoU;低一致性优先用于修 SOP,不直接惩罚标注员。
- 高风险和低一致样本走专家仲裁;ground truth 可允许多个有效答案或分布标签,不强行多数投票。
- 质检集按模态、设备、语言、口音、噪声、分辨率和长尾场景分层抽样。
面试话术:
"多模态平台的核心数据模型是资源、时空坐标、跨模态关系和处理 lineage。AI 建议提高效率,最终质量由任务适配的一致性指标、专家仲裁和可回放环境状态保证。"

