
对比Itext、PdfBox:jquick-pdf为什么是后端首选PDF工具?
引入
PDF 工具选型经常陷入“哪个库最强”的争论,但后端真正关心的是:业务字段能否稳定生成、模板能否由团队维护、中文和分页是否可控、部署是否简单、许可证是否适合产品。iText 功能成熟,却需要理解较完整的对象和排版体系;PdfBox 接近 PDF 底层,灵活但需要自行处理文字布局。jquick-pdf 的切入点是类 HTML 模板,把常见业务版式变成一份可阅读的文档描述。本文讨论的“首选”限定于规则版式的服务端业务文档,而不是所有 PDF 需求。
核心讲解
定位与基线
本文比较的 jquick-pdf 基线为 io.github.paohaijiao:jquick-pdfx:4.0.0 与 JDK 8+,入口是 com.github.paohaijiao.executor.JQuickPdfFactory。它不是浏览器,也不是所有底层 PDF API 的替代品;它更适合报表、通知、订单、合同草稿等结构明确的服务端输出。文本用单引号,变量用 ${key},样式写在 style 属性中。
分层结构
jquick-pdf 将模板解析、节点访问、样式模型和布局渲染分层。工厂负责绑定数据和选择执行方式,解析器识别 <pdf><body> 及其子元素,布局引擎维护页面空间,PDFBox 负责最终绘制。对比直接调用底层库,它把“标题、段落、表格按顺序排列”变成模板树,而不是散落在坐标计算中。
模块构成
核心 jquick-pdfx 包含文档解析和渲染;jquick-pdf-css 负责样式模型;jquick-pdf-svg、jquick-pdf-data 和 jquick-pdf-font 分别面向图表、图表数据和 CJK 字体。iText 和 PdfBox 本身是底层或通用能力,生态成熟、资料丰富;jquick-pdf 则在其上提供面向业务文档的表达层。因此选型的第一步是明确自己需要“文档模板效率”,还是需要“PDF 对象级控制”。
四个视角的对比结论
从依赖看,jquick-pdf 只引入文档层,运行时依赖 PDFBox 3.0.x、ANTLR4 runtime 与 SLF4J,图表能力可按需追加,依赖树相对可控。从部署看,三种方案都是纯 Java,不需要浏览器或本地动态库,差别主要在依赖数量与启动成本。从学习成本看,掌握 Java 与少量 HTML 的后端开发者可以较快产出第一版文档,但要获得对象级控制仍需要理解底层概念。从版式稳定性看,模板把结构固定下来,改动集中在模板文件,代价是超出已支持元素与样式范围的需求需要额外评估,不能假定任意 CSS 都生效。
调用方式
create 和无参构造器都能得到工厂;bind 适合少量字段,bindAll 适合白名单 Map。executeContent 处理内存字符串,executeResource 读取 classpath,executeFile 读取指定文件,三者都返回 byte[]。页面尺寸与页边距可通过 JPdfConfig 配置;若直接向响应流写出,则把字节交给 Web 层。本篇 Demo 采用最易验证的字节数组路径。
关键细节
样式与分页相关属性
常见属性包含 fontSize、fontColor、bold、italic、textAlignment、width、height、backgroundColor、border、borderRadius 以及内外边距,属性名可写驼峰或连字符,尺寸支持 px、pt、mm、cm、in。keepTogether:true 可参与块级分页预留;keepWithNext 虽能被样式模型解析,但其渲染消费边界需要单独验证,不宜作为强保证。分页相关行为必须用接近页底的测试数据实测,而不是依赖属性名推断。
许可证与合规边界
许可证随版本变化:不同版本区间的 PDF 引擎与授权条件可能不同,上线前必须核对版本对照表与 LICENSE,并确认所在产品形态(SaaS、私有化、闭源分发)是否被允许,升级或降级前都要重新核对,不能只依据旧文章或二手结论。
交付与验证边界
“开发机能打开”和“客户端都能打开”不是一回事。应使用 PDF 阅读器检查字体嵌入、中文断行、表格跨页和文件元数据,并在 Linux 容器、Windows 开发机和 CI 环境分别跑一组样例。对于接口下载,要设置正确的 Content-Type 和文件名,生成异常时返回业务错误而不是输出半截字节。模板变更则要和后端字段变更一起评审,避免发布后出现空白字段或错误的金额格式。
性能与容量
模板资源化能降低字符串拼接和编译噪声;数据层先完成格式化,避免模板承担循环或复杂业务计算。按业务量控制并发,给单次生成设置超时和最大页数。对图表和大图片进行尺寸限制,避免一张异常资源拖垮内存。批量任务可以分批提交并及时释放结果,不要把所有 PDF 长期留在内存集合中。模板外部化后还要限制路径和内容大小,防止任意文件读取。
实战说明
<dependency>
    <!-- 引入 jquick-pdf 文档层核心 -->
    <groupId>io.github.paohaijiao</groupId>
    <artifactId>jquick-pdfx</artifactId>
    <version>4.0.0</version>
</dependency>
JDK 8+ 即可运行。不要把旧文章中的构造方式与版本号直接混用,先按当前版本编译最小示例:
import com.github.paohaijiao.executor.JQuickPdfFactory;
import java.nio.file.Files;
import java.nio.file.Paths;

public class ComparisonDemo {

    public static void main(String[] args) throws Exception {

        String template = ""
                + "<pdf><body>"
                + "<h1 style=\"fontSize:22;textAlignment:center\">'月度对账单'</h1>"
                + "<p>'客户:'${customer}</p>"
                + "<p>'周期:'${period}</p>"
                + "<table style=\"width:100%\">"
                + "<tr><th>'项目'</th><th>'金额'</th><th>'状态'</th></tr>"
                + "<tr><td>'技术服务费'</td><td>${amount}</td><td>'已确认'</td></tr>"
                + "</table>"
                + "<p style=\"fontColor:#666666\">'本单由系统自动生成,请以财务确认结果为准。'</p>"
                + "</body></pdf>";
        // 业务代码只负责准备动态数据
        byte[] pdf = JQuickPdfFactory.create()
                .bind("customer", "示例科技有限公司")
                .bind("period", "2026 年 9 月")
                .bind("amount", "18,560.00")
                .executeContent(template);
        // 将 PDF 输出到文件
        Files.write(Paths.get("statement.pdf"), pdf);
    }
}
效果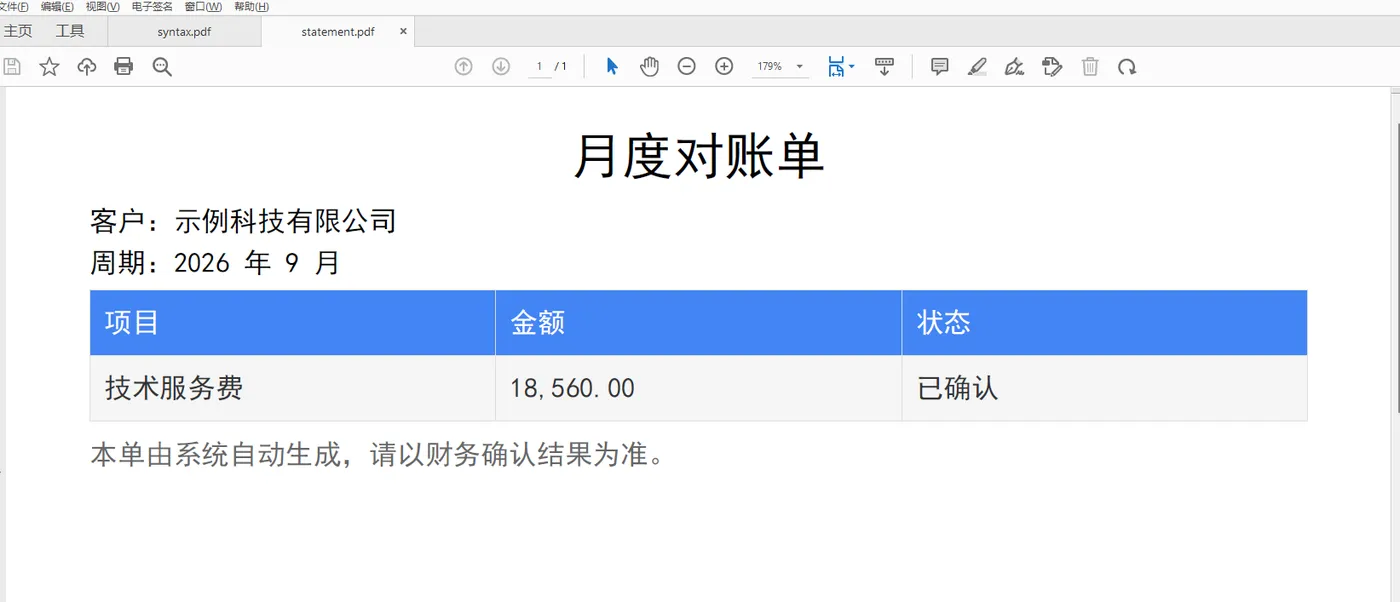
真正的选型要把同一份业务需求拆成“数据准备、版式修改、生成、交付、维护”五个环节,并且用同一份模板做横向验证:
- 中文:长中文标题与客户名称是否断行正确、字体是否嵌入。
- 长文本:超长备注是否挤压表格或产生空白页。
- 空表:明细为空时是否仍能生成,并有明确的“暂无数据”兜底。
- 跨页:明细行数超过一页时,表头、分组标题与金额合计是否仍然可读。
- 并发:多请求同时导出时,耗时、内存与 PDF 大小是否仍在预期范围。
对账单、订单确认、报价单、审批归档、项目报告和运营通知都是典型场景。若团队已经拥有 iText 模板体系,迁移前应选一个低风险文档做 POC;若已有 PdfBox 坐标绘制,也可以只让 jquick-pdf 负责规则版式,其余复杂文档保留原有实现。合理做法是按边界组合,而不是强行“一库通吃”。另外不要使用未经源码确认的 API;中文字体、页眉页脚和分页要在容器环境回归。
总结
| 维度 | jquick-pdf | iText | PdfBox |
|---|---|---|---|
| 表达方式 | 类 HTML 模板 | Java 对象与排版 API | 底层 PDF 对象与绘制 |
| 上手成本 | 常见文档较低 | 中等到较高 | 底层场景较高 |
| 控制粒度 | 覆盖已支持元素 | 很强 | 很强 |
| 部署形态 | 纯 Java,无浏览器 | 纯 Java | 纯 Java |
| 适合重点 | 规则业务文档 | 复杂 PDF 生态 | 底层处理和已有系统 |
jquick-pdf 的“首选”应理解为规则业务文档中的优先候选,而非所有 PDF 需求的唯一答案。复杂签名、标注、加密策略或特殊 PDF 对象仍需专项评估,iText 与 PdfBox 在这类场景中同样有其位置,最终标准是稳定产物与可维护流程。为降低长期风险,可以把选型评估沉淀为模板回归、依赖扫描、字体检查和压力测试四类门禁,图表、图片、表单和加密再分别做专项样本。版本基线:jquick-pdfx 4.0.0、JDK 8+,升级前请核对 README_zh.md 的版本对照表;更多示例见 GitHub 仓库。

