
在大模型工程化落地的过程中,大量开发者会遇到一个十分现实的成本矛盾:旗舰级大模型具备百万级长上下文、极强的代码推理与文档理解能力,但单次推理的Credits消耗偏高。很多开发任务并不需要毫秒级响应,比如完整代码仓库重构、海量文档批量摘要、模型能力批量评测、数据集标注、多版本方案迭代,这类任务完全可以放在算力资源相对充裕的夜间时段后台运行。Night Plan是依托Token Plan额度体系延伸出来的错峰订阅方案,核心思路就是把非实时重型AI任务调度到夜间低负载算力池,在固定时段内调用指定旗舰模型自动触发Credits折扣,在不降低模型本身推理能力的前提下,显著压低批量任务的开销。
它不是一套独立的全新额度体系,而是叠加在Token Plan之上的时段优惠规则,原有密钥、接口地址、SDK都可以继续复用,开发者只需要把任务调度在对应时段提交,无需额外切换网关或者更换密钥,本文将从产品定位、峰谷调度技术架构、时段抵扣规则、支持模型范围、定时任务开发、智能体过夜执行、成本管控策略和常见故障排查等内容完整讲解,附带可直接运行的代码命令,方便开发者快速搭建离线夜间任务流水线。
Night Plan的生效时段为北京时间22:00至次日08:00,在这个窗口内提交的请求,系统会自动识别模型标识并匹配对应的折扣系数。不同模型档位的优惠梯度存在差异,高阶旗舰模型的折扣力度更大,适合高消耗的复杂推理任务。该优惠仅针对清单内的指定模型生效,其余不在清单内的轻量模型、多模态图像视频模型仍然按照Token Plan基础抵扣规则计费,白天高峰时段提交的请求也会恢复标准Credits单价。整套方案面向的是离线、可延迟执行的任务,并不适合面向终端用户的线上实时接口,线上业务对首Token延迟有硬性指标要求,应当选择优速模式或者吞吐预留资源,而Night Plan的价值集中在研发侧后台批量作业、智能体长周期自主任务、数据预处理等场景。详情👉访问阿里云百炼大模型服务平台页面 了解。
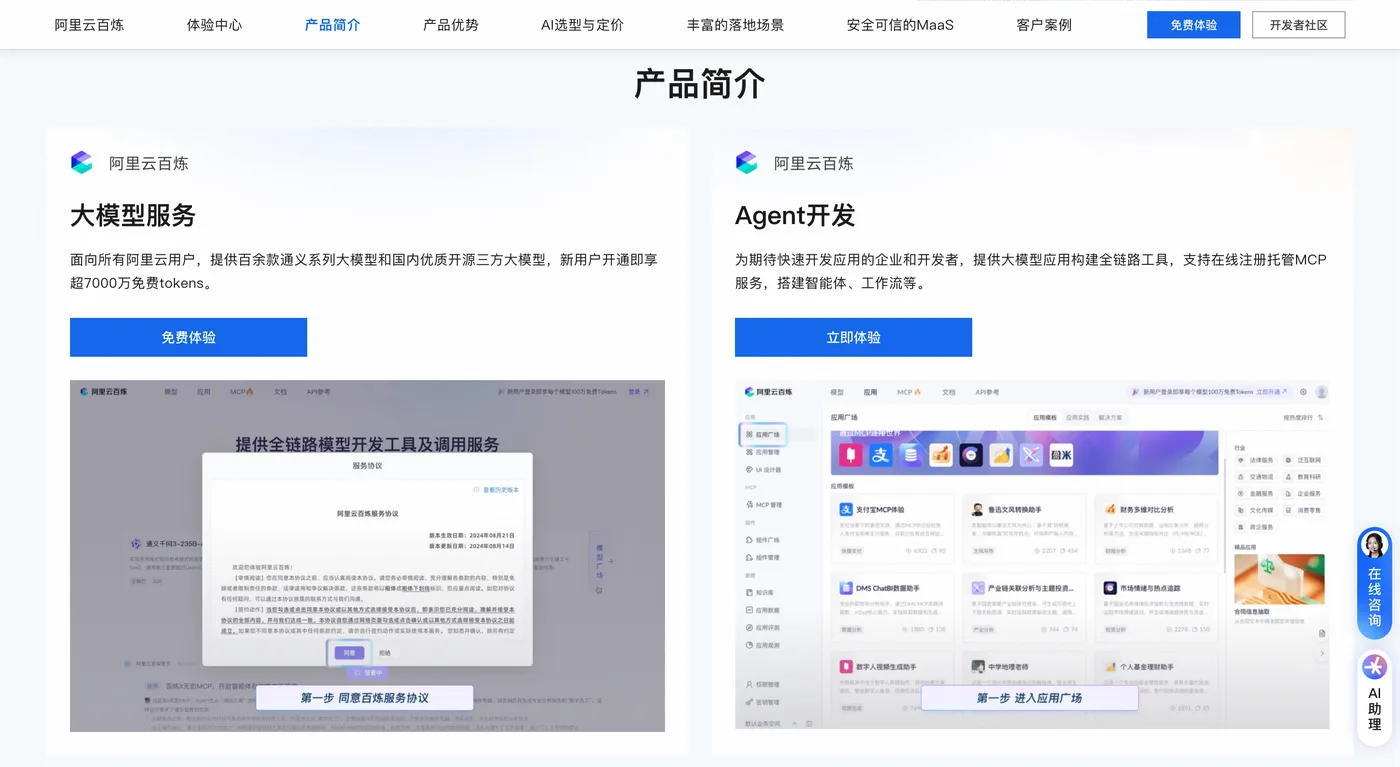
在生态兼容层面,Night Plan原生打通Token Plan体系下所有配套工具,包括Qoder编程工具、秒悟开发平台、DeepSeek Harness智能体框架,开发者可以直接在这些工具中选择支持夜间折扣的模型,在夜间时段启动任务,额度自动享受优惠,不需要额外申请资格,只要是Token Plan付费套餐用户即可自动启用该权益。子密钥体系完全继承Token Plan的管控能力,管理员可以给不同开发人员、不同项目分配独立子密钥,单独设置额度上限与模型白名单,夜间折扣的消耗明细会单独在用量报表中标记,方便区分高峰与错峰时段的成本,做项目维度的成本分摊。
从底层技术架构来看,Night Plan整体架构由时段识别网关、峰谷计量引擎、异构算力调度集群、Prompt缓存服务、任务持久化队列五大模块组成,和基础Token Plan共享同一套鉴权、日志、告警组件,新增的模块主要用于时段判定与算力资源的错峰分配。
第一层是时段识别网关。网关接收所有API请求,除了完成常规的鉴权、模型白名单校验、子密钥配额检查之外,会读取服务器当前北京时间,判断请求落在夜间优惠窗口还是白天高峰窗口,把时段标签注入请求上下文,向下游计量引擎传递。时段判定是在网关层完成,任务的提交时间决定折扣是否生效,而不是任务执行完成的时间,这一点在异步批量任务开发中尤为关键。如果任务在21:59提交,即便推理持续到22点之后,依然按照白天标准费率计算;反之在7:50提交的长耗时任务,全程享受夜间折扣,不会因为8点之后才结束推理而改变计价规则。
第二层是峰谷计量引擎。它在原有Token Plan预扣、结算计量逻辑上增加时段折扣分支,拿到网关传递的时段标签、模型标识、预估Token消耗,查询该模型夜间对应的折扣系数,计算预扣Credits数值。推理结束后,结合真实输入输出Token数量、缓存命中状态完成最终结算,并且在消耗日志中打上night_plan的标记,控制台报表可以单独筛选夜间优惠产生的用量,方便统计降本效果。缓存命中的请求会在折扣基础上再叠加缓存降本,部分长文档、固定系统提示词的批量处理任务,综合成本降幅会非常可观。
第三层是异构算力调度集群,依托UniScheduler调度内核做峰谷资源分配。白天高峰时段算力优先供给低延迟实时业务,夜间用户请求量回落,闲置的推理节点会被纳入Night Plan任务池,专门承接离线批量任务。调度系统会为夜间任务设置相对宽松的排队优先级,牺牲一部分调度时效换取更低的使用成本,当夜间算力资源紧张时,任务会进入持久化队列排队,不会直接返回限流报错,适合不急于立刻拿到结果的作业。调度同时支持弹性扩缩容,夜间批量任务突增时,自动拉起闲置算力,保证队列不会无限堆积。
第四层是Prompt缓存服务,和Token Plan共用同一套缓存池,对于批量任务中大量重复的系统提示词、参考文档上下文,编码后的特征向量会被缓存,后续相同上下文的请求不需要重新做文本编码,既降低推理耗时,也减少Credits消耗。夜间批量文档解析、数据集评测场景,缓存命中率通常很高,是除时段折扣之外第二重要的降本手段。
第五层是任务持久化队列,专门用于异步过夜任务。开发者提交任务之后,即使客户端程序关闭,任务依然保存在服务端队列,算力就绪之后自动执行,适合在工作时间编排任务,夜间自动跑批,次日再读取结果。队列支持设置最大存活时长、重试次数,任务失败可以配置自动重试,同时记录完整的执行日志,方便第二天排查批量任务的报错。
接下来进入实战接入环节,前置条件为已订阅Token Plan套餐,获取套餐专属API Key,接口接入地址和Token Plan完全一致,无需修改BaseURL,只需要在代码里把任务调度在夜间时段提交,并且选择支持Night Plan折扣的模型。详情👉访问阿里云百炼大模型服务平台页面 了解。
第一步,准备开发环境,安装OpenAI兼容SDK,执行安装命令:
pip install openai python-dotenv schedule
其中schedule库用于在本地实现定时调度,控制脚本只在夜间时段发起请求,避免白天误提交消耗标准额度。项目根目录新建.env文件存放密钥:
NIGHT_PLAN_API_KEY="sk-sp-xxxxxxxxxxxxxxxxxxxx"
BASE_URL="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)"
下面是基础对话调用示例,代码增加时段判断逻辑,只有在夜间22点到次日8点之间才发起模型请求,其余时段直接跳过执行,防止错峰优惠失效:
import os
from datetime import datetime
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("NIGHT_PLAN_API_KEY"),
    base_url=os.getenv("BASE_URL")
)

def is_night_window() -> bool:
    now = datetime.now()
    hour = now.hour
    # 北京时间22:00 ~ 次日08:00
    if hour >= 22 or hour < 8:
        return True
    return False

def night_chat_task(prompt_text: str, model_name: str = "qwen3.8-max"):
    if not is_night_window():
        print("当前不在Night Plan优惠时段,跳过本次调用")
        return None
    try:
        resp = client.chat.completions.create(
            model=model_name,
            messages=[
                {
   "role": "system", "content": "你是代码评审专家,仔细阅读仓库代码,列出潜在bug和优化方案。"},
                {
   "role": "user", "content": prompt_text}
            ],
            max_tokens=2048,
            temperature=0.3
        )
        usage = resp.usage
        print(f"输入Token:{usage.prompt_tokens},输出Token:{usage.completion_tokens}")
        print("模型返回结果:\n", resp.choices[0].message.content)
        return resp.choices[0].message.content
    except Exception as e:
        print("调用异常", str(e))
        return None

if __name__ == "__main__":
    task_content = "读取这个后端项目的所有接口代码,检查参数校验漏洞,输出一份安全评审报告"
    night_chat_task(task_content)
在实际批量处理场景中,通常需要定时轮询,每晚22点自动启动批量文档摘要任务,使用schedule库实现常驻调度脚本:
import schedule
import time

def batch_document_task():
    doc_list = ["doc1.md", "doc2.md", "doc3.md"]
    for doc_path in doc_list:
        with open(doc_path, "r", encoding="utf-8") as f:
            content = f.read()
        prompt = f"对下面文档做结构化摘要,输出要点清单:\n{content}"
        night_chat_task(prompt)
        time.sleep(2)

# 每晚22点执行批量任务
schedule.every().day.at("22:00").do(batch_document_task)
print("定时任务已启动,等待22点自动执行夜间批量文档处理")
while True:
    schedule.run_pending()
    time.sleep(60)
使用curl命令提交异步任务,适合服务器定时脚本、Crontab定时作业,请求依然使用Token Plan的兼容网关,只需确保Crontab调度时间落在夜间窗口:
curl [https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions) \
-H "Authorization: Bearer sk-sp-xxxxxxxxxxxxxxxxxxxx" \
-H "Content-Type: application/json" \
-d '{
"model":"qwen3.8-max",
"messages":[{"role":"user","content":"对数据集内所有测试用例做模型评测,汇总准确率表格"}],
"max_tokens":1500,
"temperature":0.2
}'
在DeepSeek Harness智能体框架中接入Night Plan,配置文件和Token Plan保持一致,只需要配合定时脚本在夜间启动Harness任务,让智能体自主完成长时间工程任务。profile配置文件示例:
model:
  adapter: openai-compatible
  base_url: "[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)"
  api_key: "${NIGHT_PLAN_API_KEY}"
  default_model: "qwen3.8-max"
使用定时脚本在夜间启动Harness执行仓库重构任务:
dsh run --headless --profile ./night-profile.yaml --task "重构前端仓库,拆分组件,补充单元测试"
额度告警与用量监控是使用Night Plan不可缺少的一环。虽然夜间单价更低,但批量任务一次处理成千上万份文档,总消耗依然可能超出预期。开发者可以在控制台配置告警策略,支持密钥剩余额度百分比告警、单日消耗阈值告警,当用量到达警戒线之后推送通知,及时暂停批量脚本,避免额度耗尽。报表会区分标准费率和夜间优惠消耗,直观看到错峰任务带来的成本下降,方便后续调整任务规模。
在落地实践过程中,开发者经常会遇到几类典型问题,这里整理对应的排查方案。第一,任务提交在夜间窗口但是没有触发折扣:优先确认选用的模型是否在Night Plan支持清单,轻量Flash模型不在优惠范围内;其次核对请求提交时间,以网关接收请求的时间为准,不是任务结束时间。第二,异步任务长时间排队没有结果:夜间算力池存在上限,批量任务集中提交会进入队列等待,可以在控制台查看任务状态,或者拆分任务分批提交,降低单批次并发量。第三,定时脚本不执行:检查服务器时区,服务器时区不是北京时间会造成时段判断错位,建议服务器统一使用东八区时间。第四,缓存没有生效:批量任务尽量把固定的系统提示词放在消息头部,保持上下文结构一致,动态变化的用户内容无法触发缓存。第五,Harness智能体过夜任务中途中断:开启headless无界面模式,在服务器使用nohup常驻运行,防止SSH断开导致进程退出,示例命令:
nohup dsh run --headless --profile ./night-profile.yaml --task "大规模代码库迁移" > night-task.log 2>&1 &
Night Plan适用的场景有着清晰的边界,最适合的场景包括代码仓库批量重构、海量PDF和Markdown文档摘要、数据集批量标注与评测、长链路多步骤Agent自主任务、多版本方案对比生成。这些任务共同特点是延迟容忍度高,不需要立刻拿到结果,任务耗时较长,使用旗舰模型推理开销大,错峰执行之后可以大幅压缩研发成本。而面向C端用户的实时对话、线上客服接口、需要低延迟的图像生成业务,不适合使用Night Plan,这类业务应当优先选择优速模式保障响应速度。
同时开发者需要认清方案的局限性,Night Plan是算力错峰优惠,不是无限算力,夜间算力资源同样存在上限,大规模超量任务会进入排队;优惠规则只针对指定模型,不会覆盖平台全部能力;时段判定由网关时间决定,在编排定时任务时一定要做好时间校准,避免脚本提前或者延后提交,错失折扣窗口。它也不能替代基础的额度防护,批量脚本依然要做好并发限制、循环保护,防止代码逻辑异常持续调用接口。
对比白天标准Token Plan调用,Night Plan的核心价值在于利用算力峰谷差异做成本优化。云算力资源的负载存在明显潮汐特征,白天大量实时业务抢占算力,资源成本高;夜间整体请求量下降,存在大量闲置推理资源,平台通过折扣激励开发者把可延迟的任务迁移到夜间,既提升算力整体利用率,也给开发者提供低成本的重型推理通道。对于经常做大型代码工程、批量数据处理的研发团队,合理规划任务调度,把重负载作业放在夜间执行,可以在不削减模型能力的前提下,显著降低Token Plan套餐的消耗速度,同等额度支撑更大规模的实验与开发工作。详情👉访问阿里云百炼大模型服务平台页面 了解。
总而言之,Night Plan是Token Plan体系面向离线批量任务的成本优化补充方案,依托峰谷算力调度、时段自动计量、任务持久队列,让旗舰大模型的重型推理任务可以在夜间以优惠折扣运行。它完全兼容原有API、SDK、智能体工具,学习与改造成本很低,上面提供的时段判断Python脚本、定时批量任务代码、Harness过夜任务命令、curl异步请求示例都可以直接部署在开发服务器上。开发者结合定时调度工具,把代码重构、文档处理、模型评测这类非实时任务编排在夜间窗口自动执行,配合Prompt缓存进一步压缩开销,能够在有限的订阅额度内完成更多复杂的AI研发工作,形成一套低成本、可观测的离线大模型任务流水线。

