同一个问题,交给不同的模型,答案可能天差地别——有的秒回但答非所问,有的想很久才给出一个精准答案。Qoder Fast 是怎么挑到最合适的那一个的?
Qoder Fast 已正式上线,首次响应从 8 秒缩短到 3 秒,Credits 消耗从 1.1x 降到 0.8x。这些变化来自模型、Agent 和网络三层的共同优化。本文是为每一个0.1s而努力— Fast 模式速度优化技术详解的姊妹篇,将展开模型层的一项工作:Qoder 如何利用 System One 的快速判断能力,将任务类型用于模型选择。
高速模型提供了更快执行的基础,路由则需要判断眼前这项工作适合交给谁。任务如何识别,选择依据怎样建立,多轮协作如何减少重复开销,下面分别展开。
不同任务,需要不同的模型能力
“解释一下这段函数为什么会报错”,和“梳理这个模块的依赖关系,完成重构并验证”,都属于开发工作,但对模型的要求有明显差别。
前者需要快速抓住关键逻辑,把问题说清楚。后者需要理解更多上下文,处理跨文件影响,并在修改后检查结果。任务不同,模型在理解、生成、工具调用和持续执行中的表现,也会有所不同。
即使都叫代码修改,补一个空输入判断,与同时调整多处调用、保持已有接口行为,也需要不同程度的分析。任务目标、工作范围和交付约束,都与模型需要承担的工作有关。
Fast 在档位内完成这些模型选择。Qoder 根据任务类型调整候选模型的优先级,再结合实际请求的能力要求与模型可用情况,安排后续执行。开发者选择 Fast,背后的模型匹配由路由处理。
用一次结构化判断,识别当前任务
System One 的工作方式很直接:应用先定义需要区分的任务和候选答案,模型根据输入返回一个明确的类别,路由随后使用这个结果安排执行。
例如,用户发来同一段代码,要求“解释它为什么保留了原有顺序”,和要求“修改它,让输入为空时也能正常运行”,对应的是代码解释与代码修改。分类需要识别用户当前想完成的动作,代码中的内容和历史讨论则提供背景。
为此,Qoder 将当前请求与近期对话分别组织,控制判断所需的信息量。System One 只完成任务分类,执行模型继续接收完成工作所需的完整上下文,负责生成代码、调用工具和验证结果。
两者处理的信息量相差很大。在我们的评测中,一次任务判断的输入在千 token 量级;而在一项复杂的开发任务中,执行模型累计处理的输入可达数十万 token。判断只读取它需要的部分,完整上下文留给真正执行任务的模型。
任务类别会参与候选模型的排序,并与请求的能力要求、模型可用情况一起决定后续选择。这样,一次判断的结果就能直接进入现有执行流程。
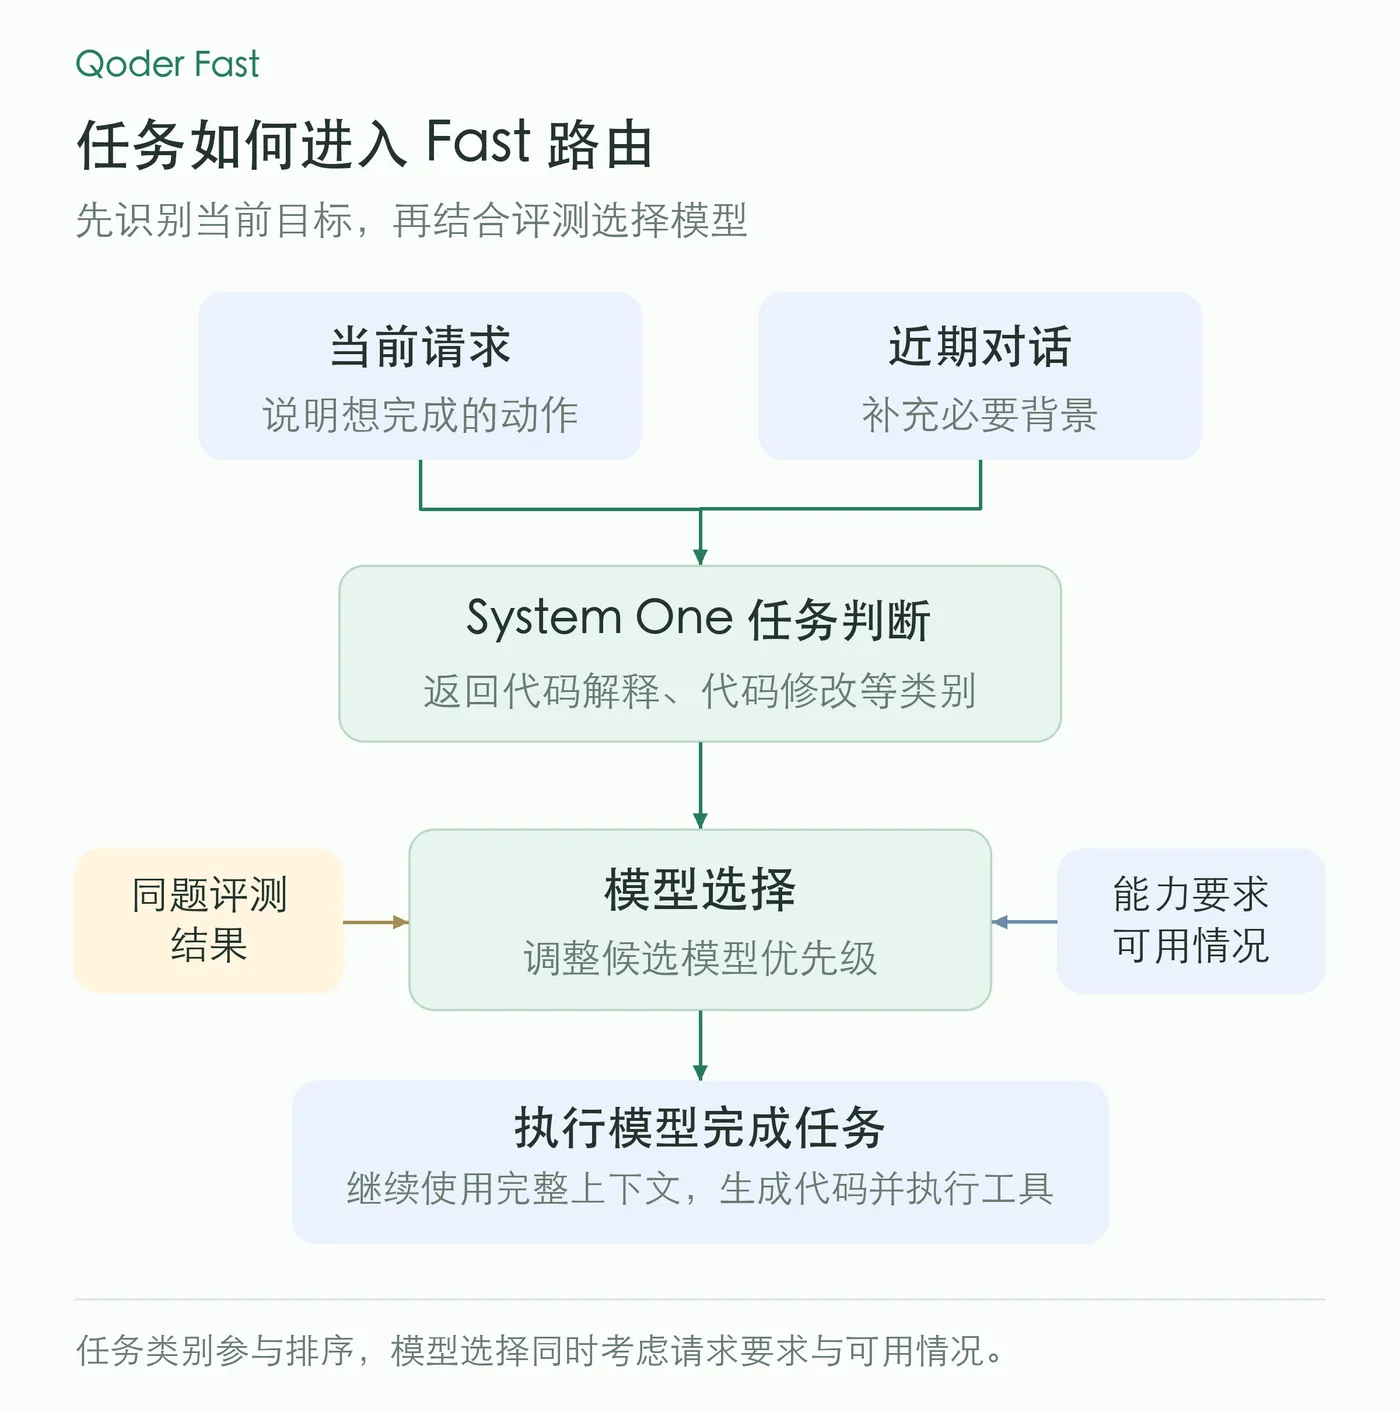
图 1:任务判断与模型选择流程
在我们针对上千条历史任务文本开展的分类评测中,任务判断的平均返回耗时在百毫秒级,99% 以上的判断在 0.5 秒内返回。这一步采用结构化选择,省去了生成长篇分类说明和解析自由文本的过程,让新增的判断开销保持较轻。
用同一批任务,比较质量与完整耗时
任务识别之后,哪个模型更适合承担这类工作,需要由评测回答。我们先在离线阶段比较不同模型与执行方案,再用评测结果调整各类任务的模型选择优先级。在线请求到来后,快速判断便可以使用这些已经积累的结果。
比较按任务类型展开,覆盖代码实现、解释、重构、测试和架构设计等二十余类工作。同一道任务使用相同的输入与验收要求,检查实际代码、文件和运行结果。例如:
任务 |
验收关注什么 |
去重算法优化 |
保留元素首次出现的顺序,输入不被修改,边界用例通过。 |
跨模块重构 |
原有测试继续通过,独立行为检查结果一致,并检查数据规模增加后的表现。 |
接口架构设计 |
幂等、并发与故障恢复机制完整,设计文档和场景结论互相一致。 |
速度也按完整工作来比较:从用户发起任务,到模型调用、工具执行、任务内验证和最终输出结束。模型较早开始输出,只能说明响应开始得快;输出更长、工具调用更多,或需要多轮修订,都可能延长交付时间。
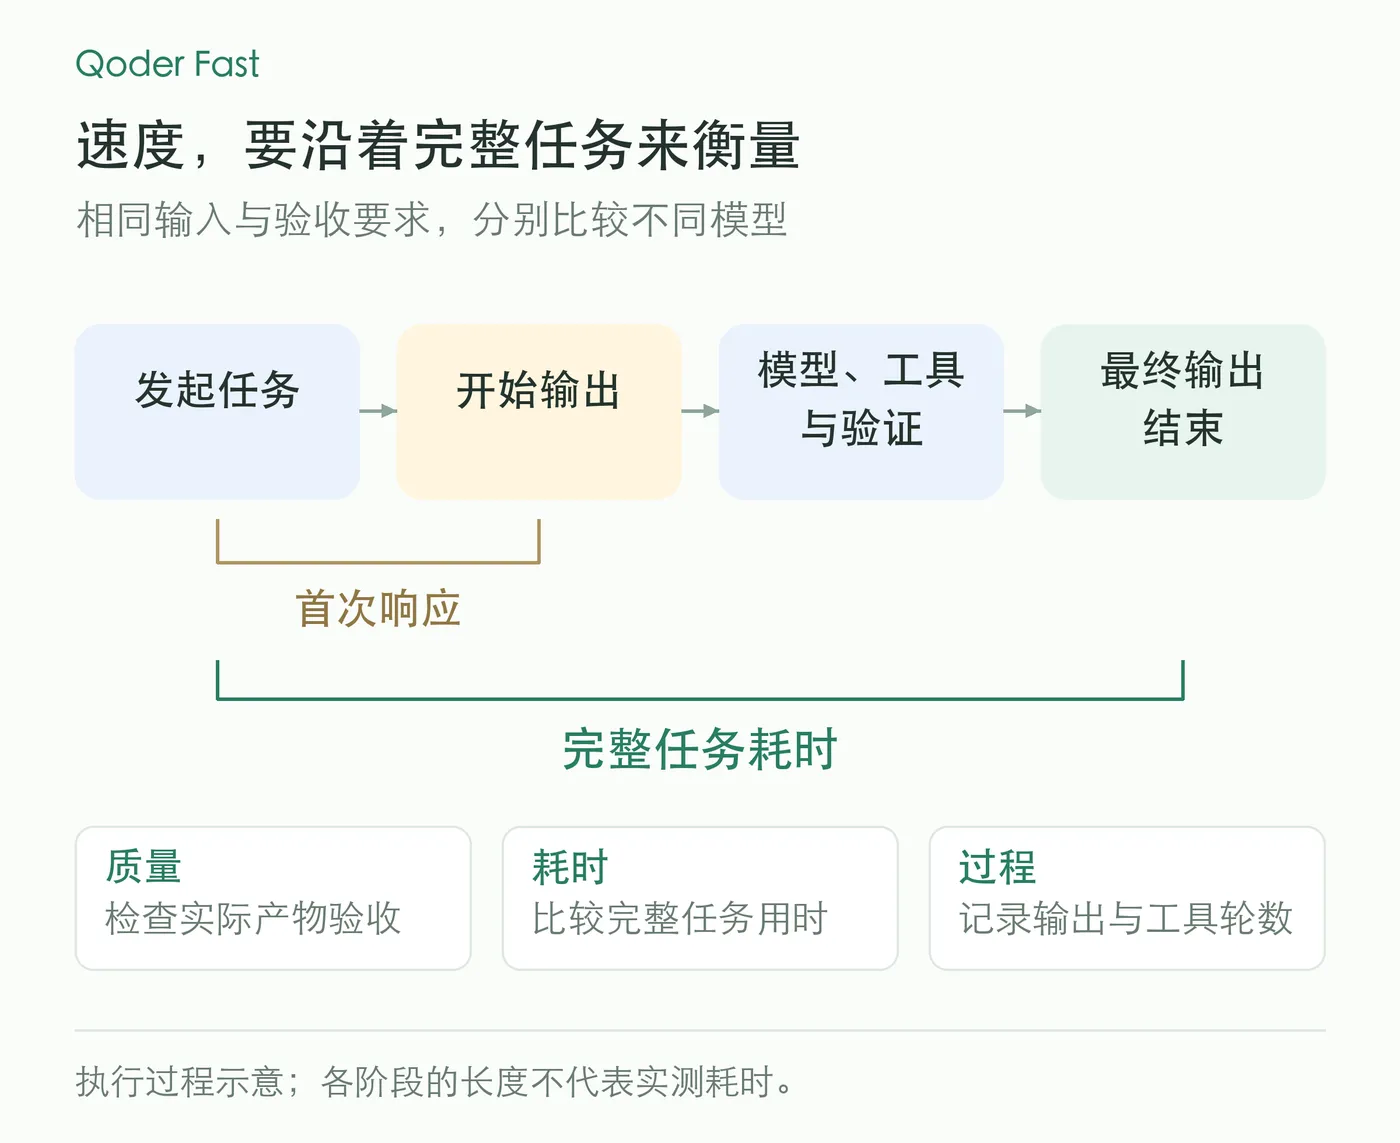
图 2:首次响应与完整任务耗时的衡量范围
在我们自身的复杂任务对照中,同一批任务在不同模型方案下的完整耗时可相差数倍。拆开来看,多出来的时间九成以上落在模型生成阶段,最慢方案的输出 token 量接近最快方案的 3 倍;工具调用轮数和执行耗时同样会拉开差距。这也是路由评测需要同时记录任务是否通过验收、完整耗时和执行过程的原因。
这些结果会反馈到具体任务的模型优先级中。解释代码、生成测试和完成重构各自比较,模型更新后继续复测,让选择依据跟着实际表现一起更新。
同一会话复用选择,减少重复开销
一次 Coding Agent 任务通常包含多轮模型请求:读取文件、修改代码、运行测试,再根据结果继续处理。在我们的复杂任务对照中,一项任务平均就包含十余轮模型请求。如果每一轮都重新分类和切换模型,任务判断会反复发生,已经积累的上下文也可能需要交给另一个模型重新处理。
Qoder 因此按会话复用模型选择:首次需要路由时完成任务判断并保存候选顺序,后续请求在会话缓存有效时沿用已有结果。在我们的链路验证中,首次编写函数会触发分类,同会话继续询问函数为什么保序时,直接复用已有选择,没有再次调用分类器。
放到完整任务里,这项复用的作用更明显。在复杂任务对照中,每项任务只在开始时判断一次,相比逐轮判断,分类调用减少九成以上,判断累计耗时不到完整任务耗时的 1%。
这项取舍同时考虑两类开销:一类是重复分类的等待,另一类是重复处理相同上下文的计算。前文提到的数十万 token 输入中,多轮请求会反复携带前几轮的上下文。保持同一会话中的模型与后端选择相对稳定,可以为模型侧的上下文缓存复用创造条件。具体收益仍取决于实际缓存命中和任务执行情况。
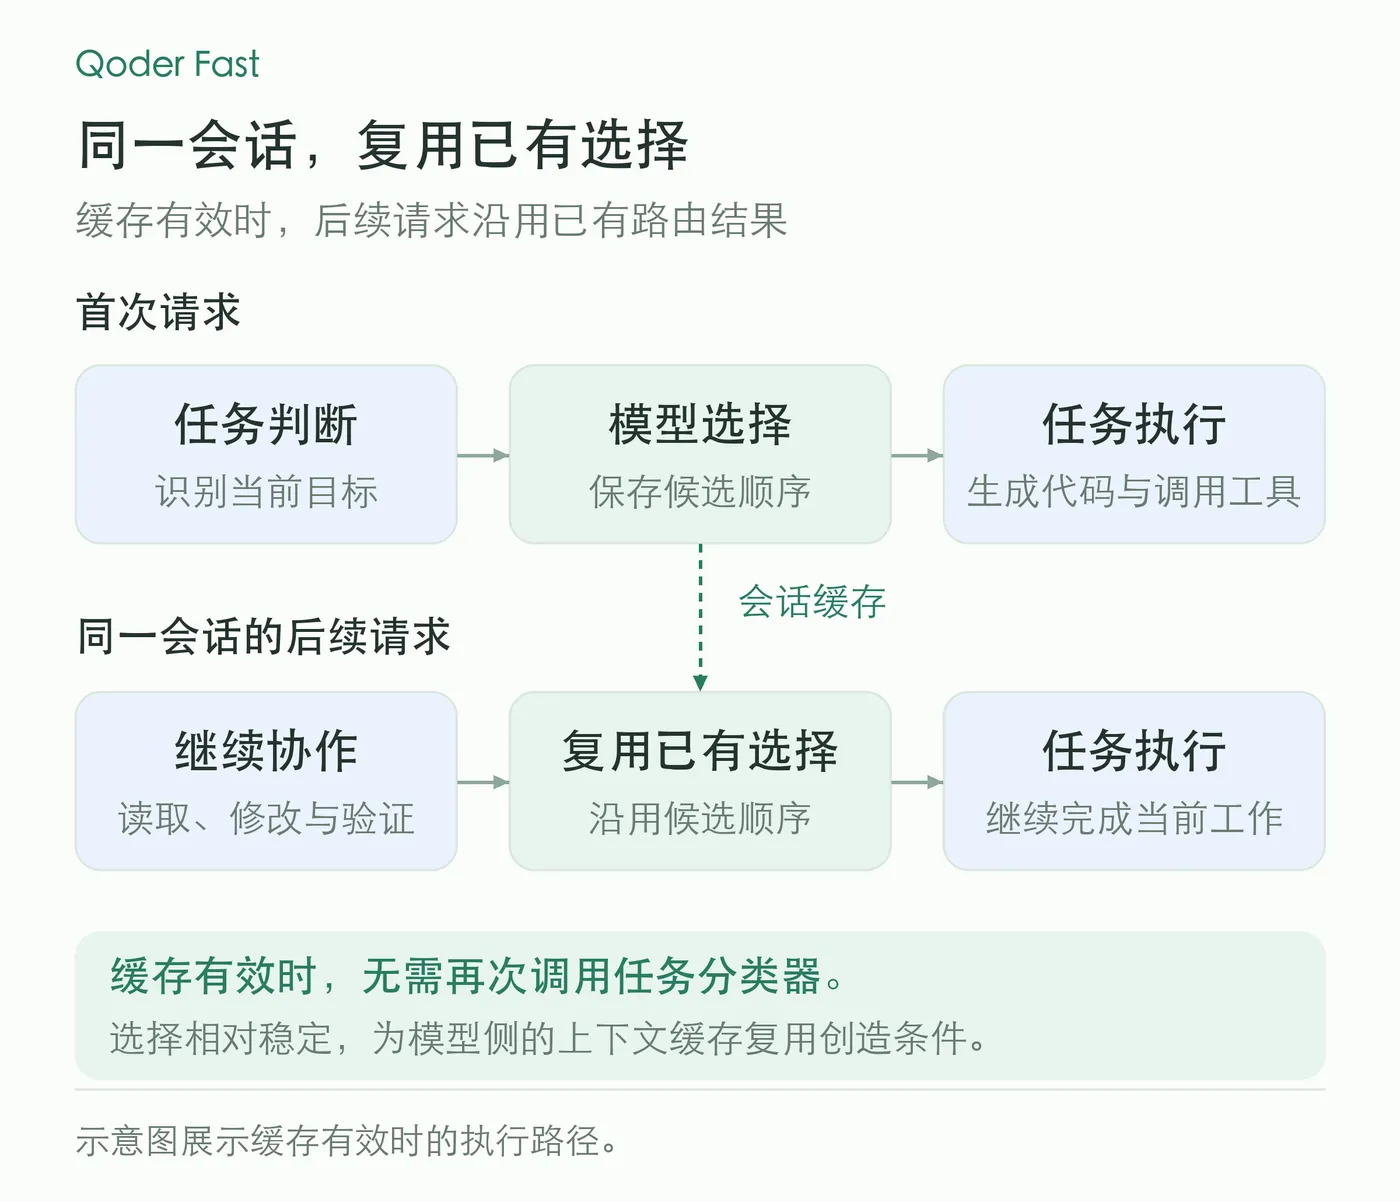
图 3:同一会话复用已有模型选择
判断调用自身也有独立的等待上限。一次判断只调用一次,超时后按照既有评分规则继续选模;出现判断超时时,系统还会暂时停止后续判断调用,经过探测确认恢复后再继续使用。执行模型的重试和回退则沿用原有规则。
通过会话复用、有限的判断开销和故障回退,任务分类可以进入 Fast 的实际执行过程,并与长时间、多轮次的开发协作衔接起来。
让日常任务更快交付
解释函数、修复局部错误、补充测试,或整理资料和工作规划,都需要尽快拿到可用的结果。模型路由将任务判断用于模型选择,与高速模型、端侧执行和网络优化一起改善 Fast 的交付体验。
Fast 档位上线范围:已在Qoder 产品家族的全部产品上线,其中Qoder CLI (1.1.70及以上版本)、QoderWake(1.1.11及以上版本)需升级到对应版本以上方可使用,个人版和企业版用户都可以使用,CN 版和国际版同步支持,欢迎体验。