
着急下载的小伙伴请直接转到:最新版 Ollama 官网中文版安装包下载
Ollama是一款运行AI模型的工具。安装到电脑上,再下载一个模型,就能用中文和它聊天,也可以让它改写文字、整理几条记录。本地使用不用注册云端账号。
图中用的是 qwen3:4b。输入一句“你好”,它已经能用中文回应;软件界面显示英文,不影响这次中文对话。
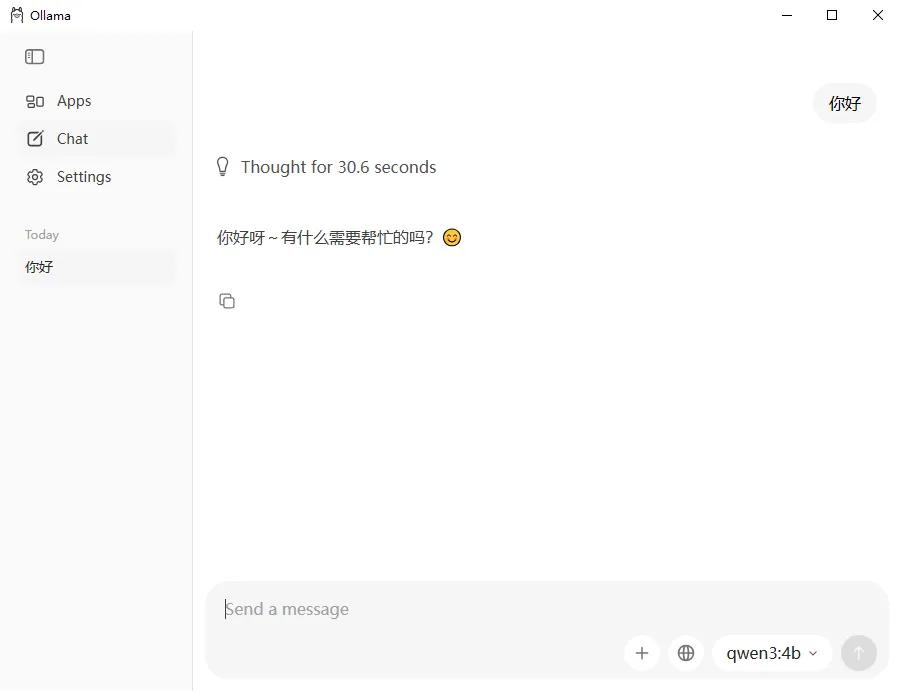
图1:输入你好后,收到模型的中文回复。
本地模型下载好后,可以留在电脑上反复使用。回复速度要看电脑配置,回答效果也取决于模型本身。想尝试这种用法,先选下面对应的程序包,模型的下载和启动方法接着往下看。
Ollama下载,普通Windows电脑选安装版
最新版 Ollama 官网中文版安装包下载:https://www.54benniao.com/a/dxps2s.html
网盘里整理的是 Ollama v0.40.4官方程序包。普通Intel、AMD的64位Windows电脑,选 OllamaSetup.exe。下面的Windows安装和操作截图都用这一版。
| 你的电脑 | 对应文件与用途 |
| 普通Intel、AMD 64位Windows(推荐) | OllamaSetup.exe,桌面安装程序 |
| Apple芯片或Intel Mac | Ollama.dmg,桌面应用 |
| 普通Intel、AMD 64位Linux | ollama-linux-amd64.tar.zst,部署后启动服务 |
| ARM64 Linux | ollama-linux-arm64.tar.zst,按相应架构部署 |
| ARM64 Windows | ollama-windows-arm64.zip,独立命令行版,完整解压后使用 |
系统要求是Windows 10 22H2及更新版本,或macOS 14及更新版本。Mac中,Apple芯片支持CPU和GPU计算,Intel机型使用CPU。Linux的ROCm、JetPack等专用加速附加包没有放进这批资源,需要时另外配置。
程序包不含模型。 安装之后还要下载 qwen3:4b。ARM64 Windows压缩包和Linux包使用命令行,安装方式与下面的Windows桌面版有区别。
选本地模型前,先看这几个条件
Ollama可以自己下载、选择模型,也需要自己管理这些文件。如果只是偶尔提问,不想占用电脑空间或等待模型加载,继续用在线AI会更省事。
改写一段话、给几条记录列个提要,都可以作为本地模型的尝试内容。这时由电脑完成推理;如果改用云端模型,或调用网页搜索、其他联网应用,相关功能仍然需要网络。
模型名称里看到 :cloud,就是云端模型,需要联网,并遵循相应的账号和付费规则。下面选的是本地 qwen3:4b,用Ollama自己的Chat窗口。想确认离线使用,可以等本地模型正常回复后断网再试一次;这里展示的截图尚未做断网测试。
4B、8B说的是参数规模,B代表十亿。下载的这份Qwen3 4B约 2.5GB,这是文件大小;运行时还会占用内存或显存,对话越长,占用也可能增加。不要把2.5GB直接当成电脑所需内存。
Windows程序本身还需要至少约4GB磁盘空间,模型另算。下载前留出足够容量。能不能用显卡加速,要看具体型号和驱动;先下这一份模型试运行,后面再决定是否换更大的。
安装后,选“在本地使用”
双击 OllamaSetup.exe,点 Install,等待安装完成。Windows默认安装不要求管理员权限,正常双击即可。
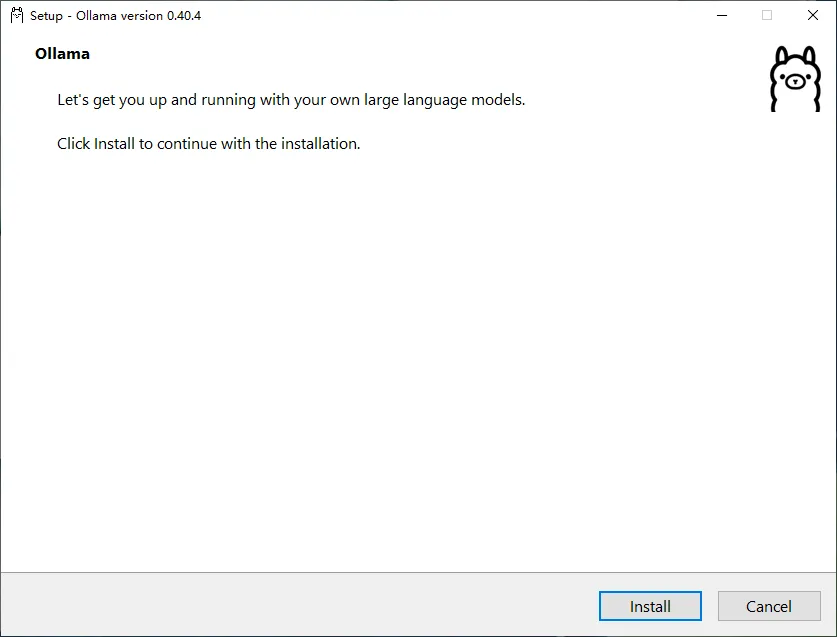
图2:点击Install安装程序。
首次欢迎页点 Continue。下一页会出现注册入口,使用本地模型点下面的「No thanks, I’ll use Ollama locally」。
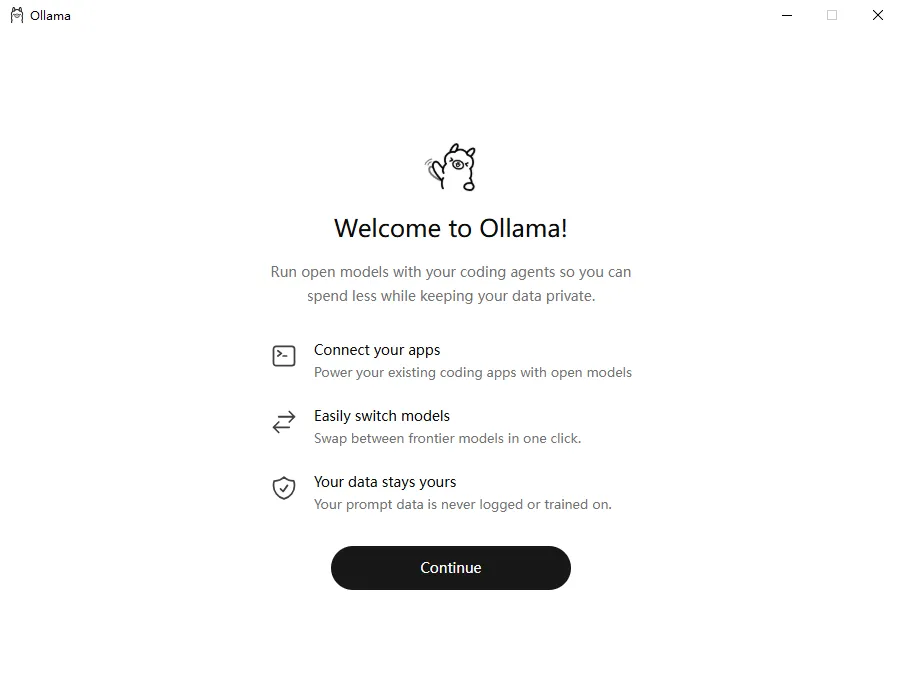
图3:点击Continue继续。
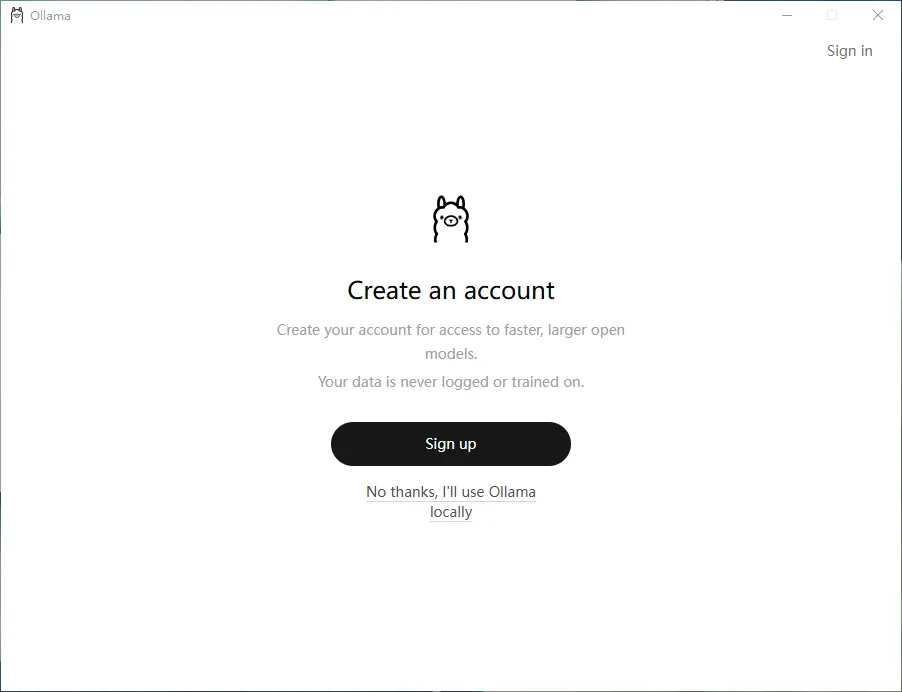
图4:点击下方的本地使用入口。
接下来是 Run Ollama 页面,显示命令 ollama。它在提示终端入口。先打开PowerShell下载模型,完成后既能在终端聊天,也能进入Chat窗口。
图5:当前页提示终端入口,模型还需要另外下载。
Mac把DMG里的Ollama拖入“应用程序”后打开,首次可能出现添加命令行工具的提示。Linux需要安装、启动服务。下文的窗口操作以Windows为主。
C盘空间不多,先改模型保存位置
Windows默认把模型存到当前用户目录的 .ollama\models。C盘空间够用,可以保留;想把模型放到其他盘,再做下面的设置。程序的安装位置和模型目录是分开的。
例如准备放到 D:\OllamaModels,在下载模型之前设置:
- 建立 D:\OllamaModels 文件夹,确认有足够空间。
- 在Windows搜索“编辑账户的环境变量”,打开当前用户的环境变量设置。
- 新建用户变量:名称 OLLAMA_MODELS,值 D:\OllamaModels。
- 保存后,从托盘退出Ollama,再从开始菜单打开;已打开的终端也关掉重开。
如果已经下载过模型,更改 OLLAMA_MODELS 后,旧文件仍在原来的位置。确认哪些要保留,再安排迁移;这个设置本身不会帮你移动或删除文件。
先下载模型,再启动对话
在开始菜单搜索 PowerShell,点“打开”。使用普通窗口就行;截图中出现的管理员窗口不是必需条件。
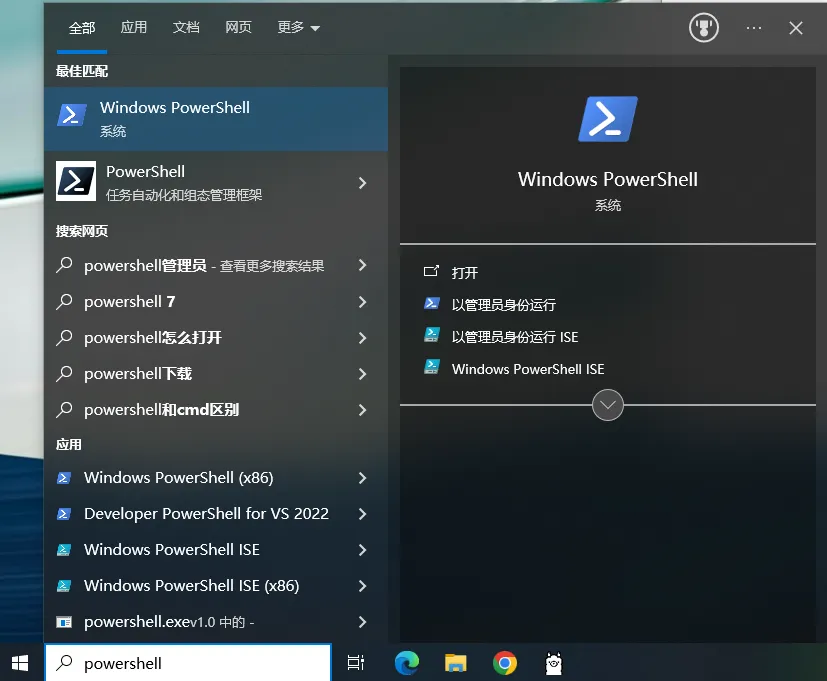
图6:选择Windows PowerShell,点击打开。
先输入这条,按回车下载模型:
ollama pull qwen3:4b
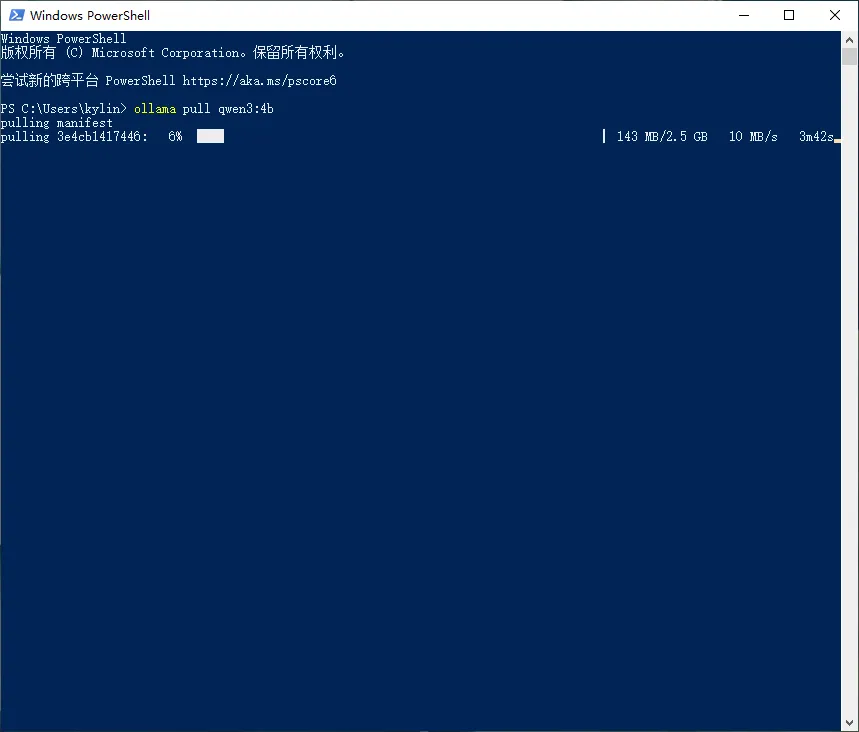
图7:执行pull后,等待模型文件下载。
进度到100%后,还会继续校验。出现 success,并回到PowerShell提示符,就下载好了。速度随网络变化,不用和图里相同。
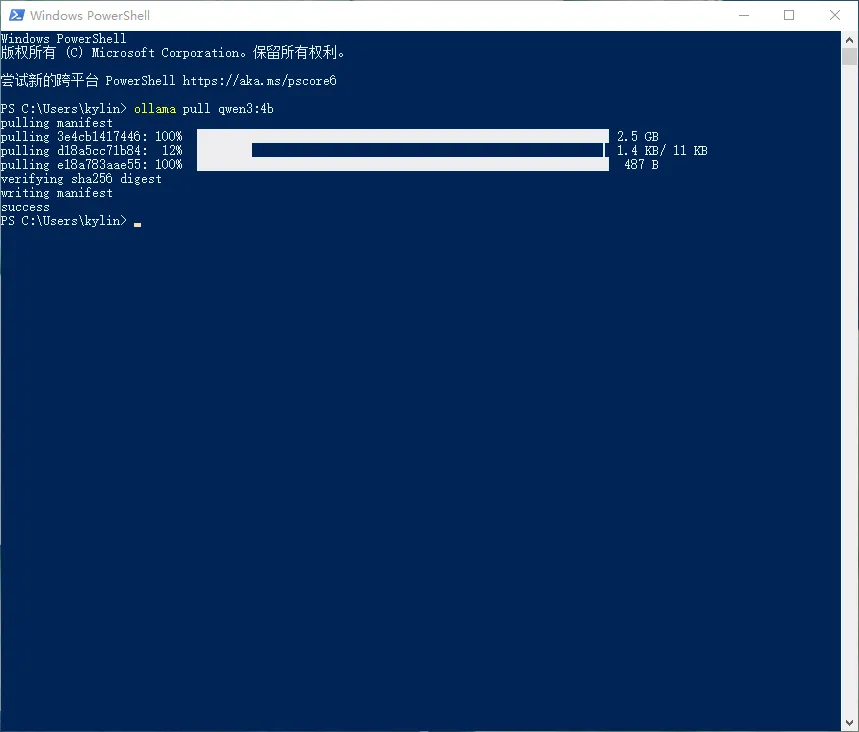
图8:出现success后,模型已下载完成。
pull完成后还停在命令窗口,是正常的。它只负责下载;接下来输入这条启动:
ollama run qwen3:4b
等待模型加载,出现 >>> 后输入中文,按回车发送。结束这次聊天就输入 /bye。模型文件会保留,下次仍用 ollama run qwen3:4b;如果本地没有模型,run也会先尝试下载。
用窗口聊天,打开Chat
喜欢用窗口的话,下载完成后回到Ollama就行。模型还是刚才那一份,终端与Chat任选一种方式聊天。
如果当前显示 Apps,点左上角按钮展开侧栏。这一页列的是可连接的其他应用,直接去Chat就能继续本篇的聊天操作。
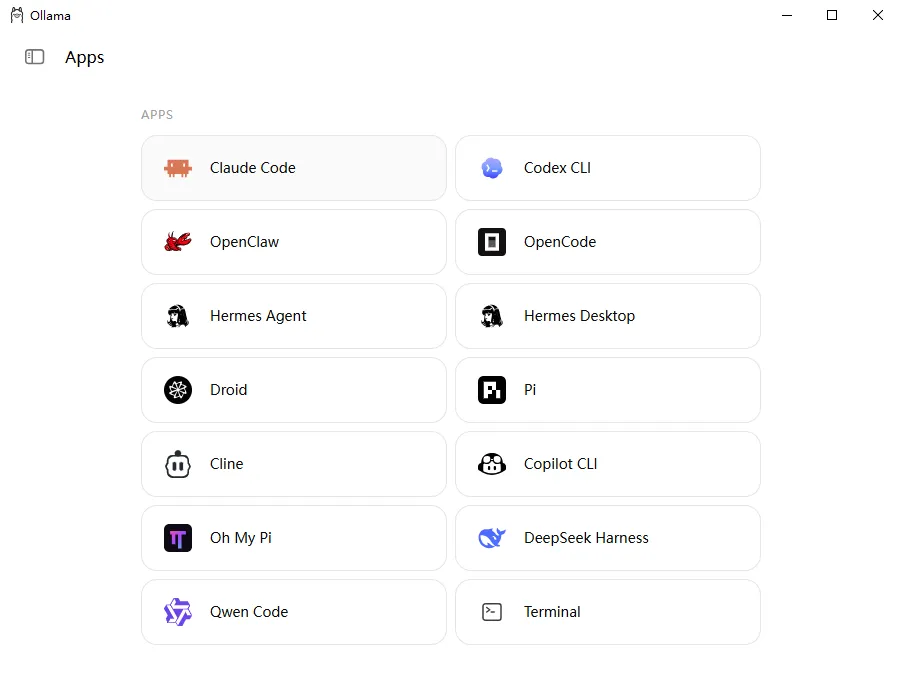
图9:当前是Apps页,点击左上角按钮展开侧栏。
侧栏选 Chat,输入框右下角选择 qwen3:4b。刚下载后暂时没出现,可以重新打开Ollama,再看模型名是否一致。
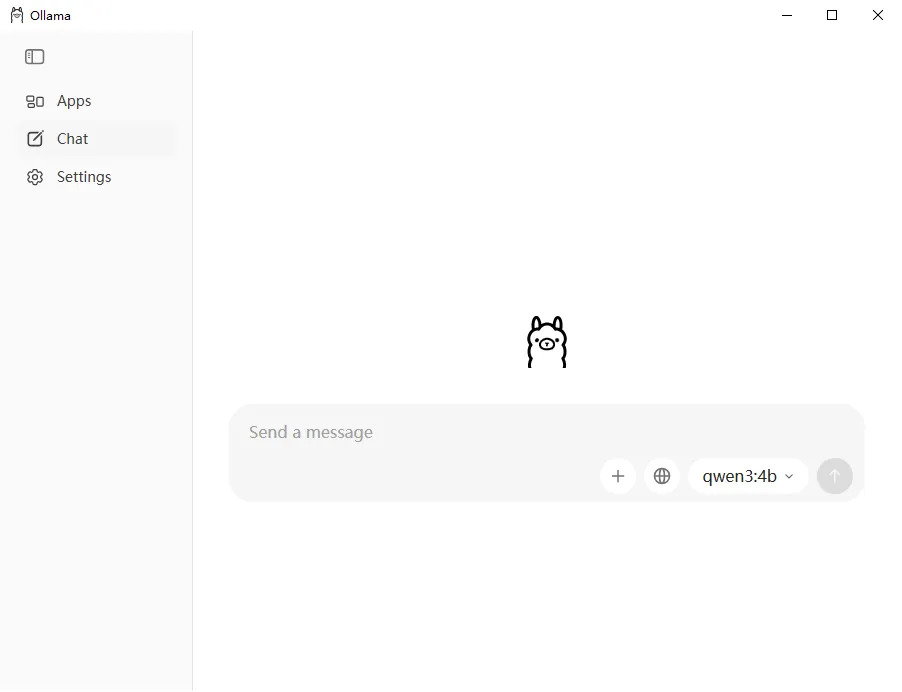
图10:选择Chat,确认当前模型为qwen3:4b。
在输入框写“你好”,点击发送。开头那张截图就是这次收到的回复。回答前可能先显示思考状态,所需时间会随电脑配置和问题变化。
接下来可以换成具体任务。比如写工作通知时,把原话贴进去:
请把下面的话改成一条简短的工作通知,保留时间和要求,不添加信息:周五下午三点开会,请各位提前把本周进度发给我。
整理零散记录时,也可以要求它“列出待办,不确定的内容单独写出来”。这两个例子供你尝试,截图展示的仍只是前面的问候对话。实际用到日期、数字和安排,要再核对一遍。
终端聊天时,下面这种 Thinking 内容是模型还在处理问题的状态,最终回答尚未完成。想确认正在用哪个模型,查看启动命令或运行状态,不靠它对自己的介绍判断。
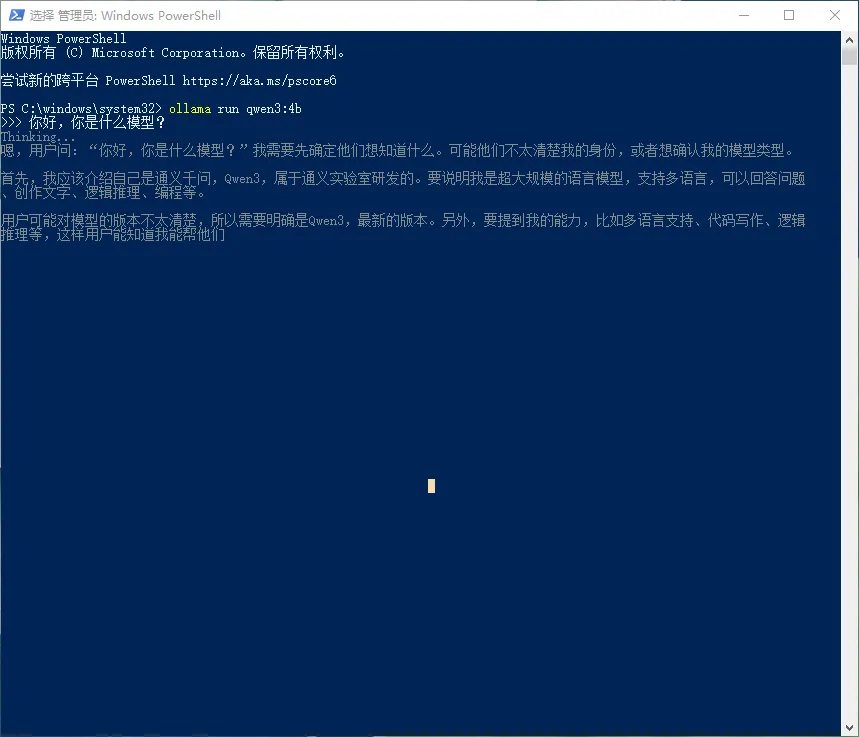
图11:run启动后出现>>>,可输入中文;截图尚处于思考输出。
回复慢,或者模型找不到了
第一次加载模型可能要等一会儿。聊得很长、其他程序占着内存,或主要使用CPU计算时,回复也可能变慢。先发一句短消息看看,暂时保留原来的上下文设置。
想看模型有没有下载、现在由什么设备运行,可以新开一个PowerShell窗口:
| 命令 | 看什么 |
| ollama list | 本地有哪些模型、各自占多少磁盘空间 |
| ollama ps | 当前运行哪个模型,以及CPU/GPU使用方式 |
图里还出现了两个管理命令,按需要使用:ollama stop qwen3:4b 用来停止模型,释放运行占用,文件还在。ollama rm qwen3:4b 会删除本地模型,之后再用要重新获取。只查看状态,执行上面的list和ps即可。
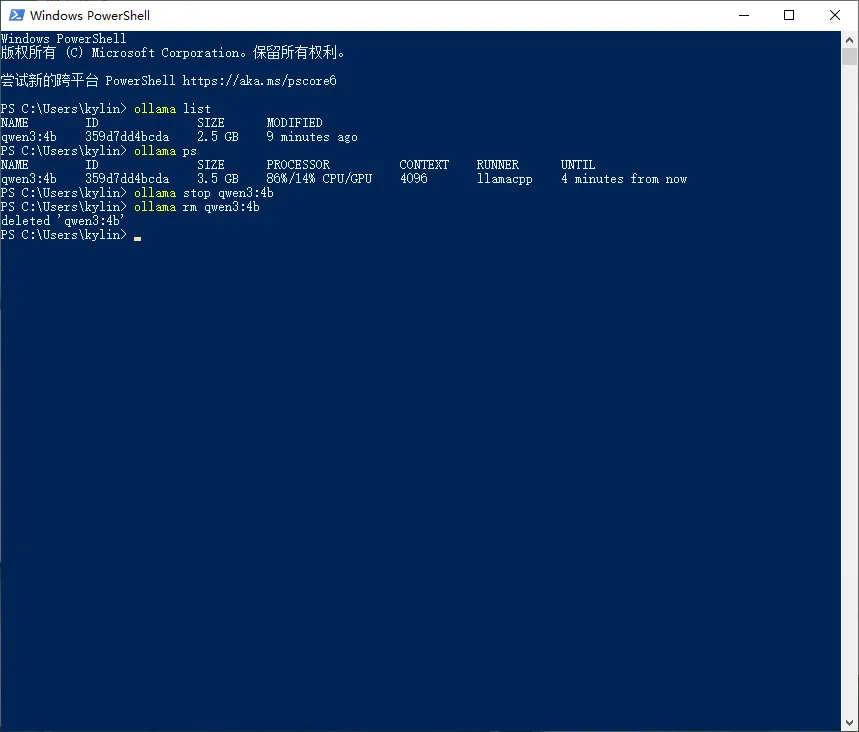
图12:list显示模型,ps显示本次CPU/GPU混合运行;图中最后执行rm,已删除qwen3:4b,不是常规必做步骤。
这次ps显示CPU/GPU混合运行。最后一行的 deleted 则是执行rm的结果;照着删过的话,模型从列表消失是正常的,重新pull才能再次使用。
“找不到ollama命令”时,确认安装完成,再关掉终端重开。Mac检查首次添加命令行工具的提示。若提示无法连接,Windows先打开Ollama,Linux检查服务是否启动,避免重复开启服务。
下载中断,可以重新执行同一个pull命令,让Ollama检查已有文件。持续失败时再按错误信息检查网络和磁盘空间,先保留已下载内容。
list能看到模型,Chat里却没有,看看模型名是否一致,重新打开应用刷新列表。改过 OLLAMA_MODELS 的,再确认Ollama和终端都已经退出重开。
需要关闭Ollama云端功能时,可以设置 OLLAMA_NO_CLOUD=1,保存后重启。不关闭也可以选择本地模型,这个配置不是开始聊天的必做步骤。
如果你想尝试本地AI,可以先保留这一份Qwen3 4B,用自己的几段文字试试。速度和回答效果满足需要,再考虑其他模型;偶尔使用、也不想管理文件的话,在线AI仍然是更省事的选择。
