AI客服刚开口,用户一句“等等”为什么可能拦不住它?

简介: 语音Agent的“打断”是涵盖VAD识别、响应取消、播放停止、工具终止与上下文清理的完整链路。仅测转写准确率易漏掉重复播报、误提交或后台静默执行等高危问题。需从声音、语义、副作用三层断言,确保用户随时重获控制权。

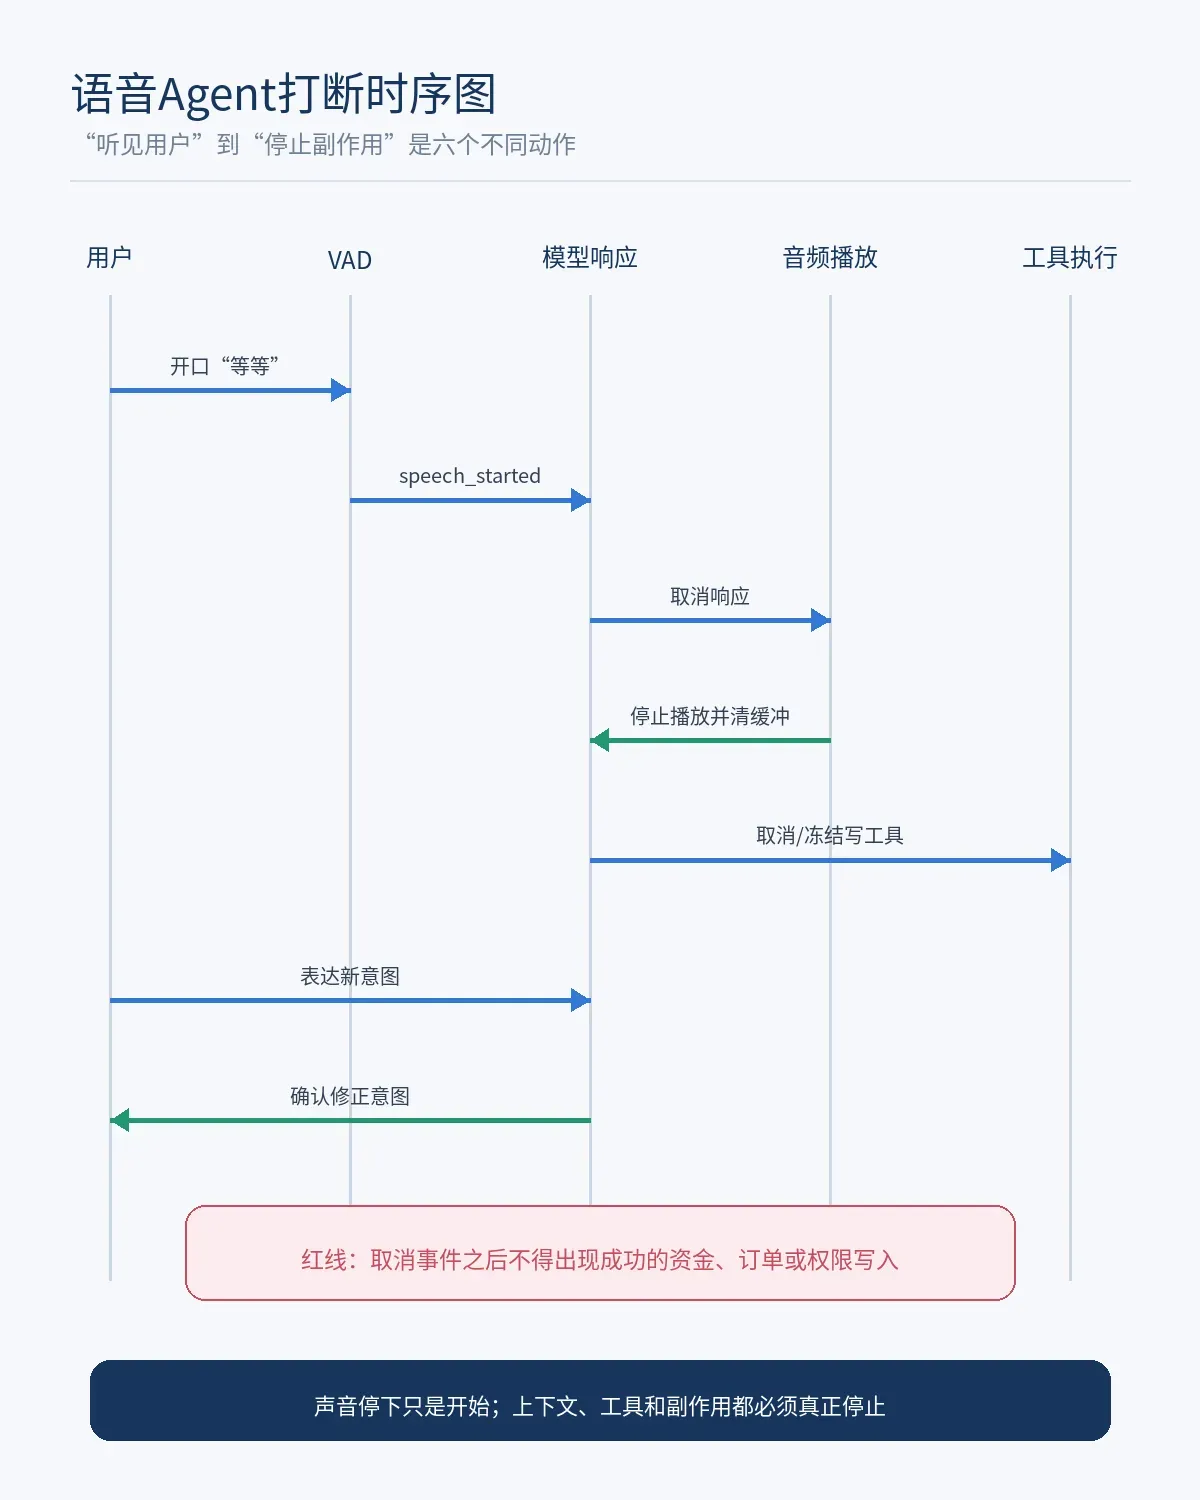
摘要:语音Agent的“打断”不是一个按钮,而是一条从用户开口、VAD识别、取消生成到停止播放和清理上下文的链路。只测转写准确率,很容易漏掉重复播报、错误提交和仍在后台执行的工具调用。
image.png

OpenAI Realtime API文档公开了server VAD与semantic VAD等轮次检测方式:前者依据声音活动判断开始和结束,后者结合语义估计用户是否说完;interrupt_response决定检测到用户新语音时,是否自动取消正在输出的响应。文档也提示,semantic VAD更自然,但可能带来更高延迟。

基于这些公开机制,可以构造一个常见客服用例:Agent正在说“我将为你提交退款”,用户插话“等等,我只是想查进度”。测试若只听到声音停了就判通过,会漏掉后台工具调用已经发出、对话上下文仍保留“确认退款”或下一轮继续播报旧音频。

一次打断要拆成五个可观察点

  1. 用户语音开始事件是否被识别;
  2. 当前响应是否收到cancel;
  3. 客户端播放缓冲是否清空;
  4. 未完成工具调用是否取消或转人工确认;
  5. 新一轮上下文是否以用户修正意图为准。
故障 表面现象 真正风险
VAD没触发 Agent继续说 用户无法接管会话
只停播放 设备安静了 后台仍可能执行退款
取消过晚 听起来已打断 工具副作用已经发生
上下文没清理 下一轮能回答 仍按旧意图继续操作
误打断 环境噪声触发 回答频繁被截断、体验下降

image.png

用“声音—语义—副作用”三组断言

声音层测不同音量、背景噪声、口头停顿和连续说话;语义层测试“嗯……我想一下”不应过早结束轮次,“等等、取消、别操作”应快速打断;副作用层则断言取消后不得调用写操作。

def assert_barge_in(trace):
    assert trace.time("speech_started") < trace.time("response_cancelled")
    assert trace.time("response_cancelled") < trace.time("new_turn_started")
    assert not trace.successful_tool_call_after(
        "response_cancelled", risk="write"
    )

还要做两个反常用例:在工具调用前1毫秒插话,确认系统的审批点能拦住;在Agent停止播报后恢复网络,确认旧音频和旧工具结果不会补发。延迟指标也要分段记录,不能只看端到端平均值。

语音Agent最难测的不是“它听懂了多少字”,而是用户能否在任何时刻重新取得控制权。测试团队下一步可以录制十组真实打断音频,保留事件时间戳、取消结果和最终副作用,建立一套可重复播放的语音行为回归集。

打断用例不能只用安静录音棚

真实电话里有键盘声、电视声、回声、儿童说话、方言和网络抖动。准备四类音频:清晰短指令;有犹豫词的长句;背景中有人声但用户未发言;用户在Agent关键动作前突然否定。每类改变音量、语速和延迟,观察VAD是否误触发或漏触发。

server VAD依赖声音阈值和静音时长,semantic VAD还会判断语义是否结束。两者没有绝对优劣:简单VAD可能更快但容易把停顿当结束;语义VAD更自然,却可能延后响应。测试报告应同时给出误打断率、漏打断率、用户开口到停止播放的延迟,以及用户开口到写工具真正停止的延迟。

轮次边界错了,会污染后面整段会话

用户说“我想退货……嗯,先查一下订单”,中间停顿可能让Agent提前提交前半句。下一轮即使识别准确,系统上下文已经多出一个错误退款意图。测试要检查被截断文本是否进入Conversation,取消后的响应是否仍作为后续输入,以及新一轮是否能覆盖旧意图。

设计成对用例:同一句话分别连续说、停顿500毫秒、停顿1秒、加入“嗯”。期望最终意图一致;若系统在不同停顿下走向不同工具,说明轮次检测影响了业务行为。

工具调用需要自己的取消协议

模型响应可以cancel,不代表外部API支持取消。查询类工具可以允许完成并丢弃结果,资金与订单写入则应在执行前设置确认点、幂等键和短时撤销。若工具已不可逆地执行,Agent必须如实告诉用户并进入补救流程,不能假装“已经取消”。

把工具分为只读、可撤销写入、不可撤销写入三类,为每类定义打断策略。测试故意在调用前、请求已发出、服务返回前和返回后四个时刻插话,验证状态与话术一致。

网络抖动下还要防旧音频“复活”

客户端收到cancel后如果网络缓存里仍有音频分片,连接恢复时可能继续播放旧回答。每个响应分配response_id,播放器只接受当前有效ID;取消后丢弃旧分片。自动化测试可注入乱序、重复和延迟事件,断言旧response_id永不重新进入播放队列。

最小发布门禁

高风险语音Agent上线前至少满足:明确取消词能在团队设定时间内停止播放;取消后没有成功写副作用;噪声不会频繁打断;长停顿不会擅自提交关键动作;会话上下文不保留已取消意图;网络恢复不补播旧音频。

这套门禁同样适用于会议助手、车载语音和智能硬件。产品不同,用户夺回控制权的要求相同:系统不仅要听见人说话,还要在动作层真正服从停止。

本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。
相关文章
|
19天前
|
运维 监控 安全
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
智能体上线评审常陷“五人五义”困局。全国首个五级智能体评测证书揭示破局关键:将主观判断拆为功能性、稳定性、安全、工程化、场景适配五大可证维度,每维设独立判据与证据链,推动验收从经验走向可审计、可复现、可追责。(239字)
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
|
1月前
|
JavaScript 前端开发 测试技术
对比度不足、缺 alt、缺 label:把 axe-core 挂进 Playwright,用 CI 门禁拦下 WCAG 违规
本文详解如何将 axe-core 无障碍扫描集成到 Playwright 测试中,利用浏览器原生 accessibility tree 自动检测 WCAG 违规(如对比度不足、缺 alt/label、标题跳级等),并通过 CI 基线门禁拦截新增问题,让无障碍从“上线后被投诉”变为“合并前被拦截”。
对比度不足、缺 alt、缺 label:把 axe-core 挂进 Playwright,用 CI 门禁拦下 WCAG 违规
|
1月前
|
自然语言处理 安全 测试技术
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
本文揭示RAG客服应用因缺乏Prompt注入防护而致系统提示词泄露的事故,指出问题根源在于测试只关注“答得对”,却忽视“会不会答不该答的”。提出将注入测试升级为可回归的红队用例集:结构化存于jsonl,覆盖四类注入;用pytest参数化断言输出、工具调用与拒答行为;接入CI自动拦截。安全不是模型天赋,而是靠可执行、可演进的断言守出来的。
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
|
1月前
|
消息中间件 安全 测试技术
只断言最终态等于放弃中间可测性:把 Behavioral Evaluation 翻译成 pytest 里的 Trajectory
本文介绍Agent测试新范式——行为评估(Behavioral Evaluation):摒弃仅校验最终结果的“outcome-only”方式,转而对工具调用轨迹(Trajectory)进行三层断言——工具选择、调用顺序与参数、过程与结果一致性。通过jsonl落库、pytest回归、CI门禁,实现可复现、可归因、防蒙对的高可信测试,让Agent能力而非运气成为上线依据。
只断言最终态等于放弃中间可测性:把 Behavioral Evaluation 翻译成 pytest 里的 Trajectory
|
1月前
|
人工智能 缓存 数据库
常青翻新|Mock 不是万能替身:Dummy/Stub/Spy/Mock/Fake 五种 Test Double 的边界与踩坑
本文厘清测试替身的五大分类(Dummy/Stub/Spy/Mock/Fake),指出滥用“万能Mock”导致测试脆弱或假绿的根源:混淆“提供数据”与“验证交互”。强调选型核心原则——**先明确断言对象(数据?交互?真实行为?),再决定替身类型**,并结合AI场景(如Agent轨迹验证、假模型替代)赋予经典模式新生命力。
|
27天前
|
人工智能 测试技术 开发工具
Google 开源 ARTEMIS:AI Agent 如何接管 Android 真机测试?
Google开源AI测试框架ARTEMIS,支持自然语言驱动Android真机自动化:理解任务、识别界面、跨App操作、自动截图/日志采集并生成报告。原生集成MCP,可接入Antigravity等AI IDE,实现“描述目标→自主执行→分析结果”闭环。(239字)
Google 开源 ARTEMIS:AI Agent 如何接管 Android 真机测试?
|
27天前
|
人工智能 安全 开发者
Jev 发布不到一周,为什么它这么快进入 Agent 工程?
Jev 是专为 Agent 设计的轻量级决策模型,不生成文本,专注快速输出 Choice/Score/Boolean。它被 Vercel AI Gateway、LangChain 等迅速集成,用于路由、流程控制、安全守卫和评估等高频判断场景,显著降本增效,推动 Agent 架构向“分层智能”演进。
Jev 发布不到一周,为什么它这么快进入 Agent 工程?
|
27天前
|
人工智能 数据挖掘 开发工具
RAG 不一定需要大模型重排:Jev 能不能做 Context Filtering?
RAG中检索易召回冗余内容,Jev作为决策层可精准筛选高相关Chunk,替代简单Top-K输入。它支持多维度判断(如版本、时效性),提升Context质量与LLM答案准确性,降低幻觉与Token成本。(239字)
RAG 不一定需要大模型重排:Jev 能不能做 Context Filtering?
|
28天前
|
SQL 人工智能 安全
Agent Harness 又要多一层?Jev 开始接管这些高频判断
本文探讨Agent架构新范式:LLM专注复杂推理,而高频判断(如Tool/Skill路由、上下文过滤、安全守门、执行复核)可交由轻量级“System One Model”(如Jev)高效处理。这将重塑Agent Harness设计,推动分层智能协作。
Agent Harness 又要多一层?Jev 开始接管这些高频判断