
前言
很多刚接触AI的同学,最先被绕晕的概念就是人工智能、机器学习、深度学习。 网上不少文章讲得晦涩抽象,或者只放一张嵌套图就草草结束。本文从本质出发,理清三者的包含关系,重点拆解机器学习与深度学习最核心的差异,同时结合工业落地场景讲选型思路。
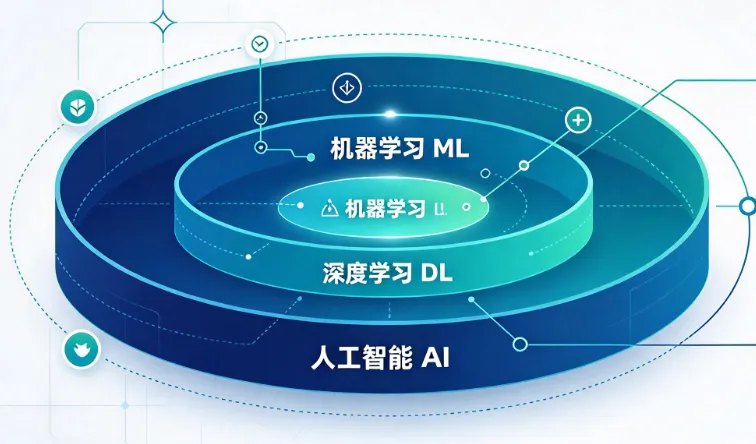
三者嵌套关系:人工智能⊃机器学习⊃深度学习
三者是层层包含的集合关系。机器学习是实现人工智能的路径之一,而深度学习又是机器学习的一个分支。
一句话提炼核心差异:
机器学习与深度学习之间最本质的区别只有一个:特征是谁提取的——机器学习靠人,深度学习靠机器自己。
- 人工智能(AI):让机器具备智能行为的总体目标。
实现路径不止机器学习,还有符号主义、专家系统等方案。
机器学习(ML):实现 AI 的其中一条路径。核心思路是不显式编写固定规则,让计算机从数据中自动学习规律。
深度学习(DL):机器学习下的分支,依靠多层神经网络学习数据规律,核心能力是自动完成特征提取。
形象比喻:AI是我们想要抵达的目的地;机器学习是通往目的地的一条主干道;深度学习,是这条道路上目前跑得最快的一辆车。 车再快,依然在这条路上;这条路再好,也只是通往终点的其中一种方式。
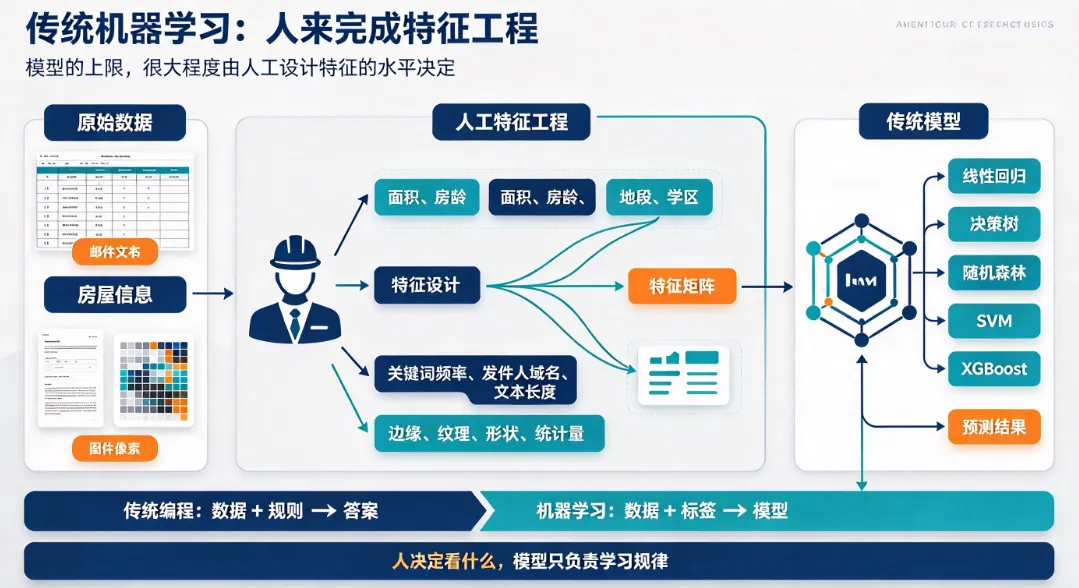
传统机器学习:人来完成特征工程
传统编程和机器学习的逻辑是反过来的:
- 传统编程:输入【数据 + 人工编写规则】→ 输出【答案】
- 机器学习:输入【数据 + 标注答案】→ 输出【模型(学到的规则)】
举个垃圾邮件识别例子: 我们不会硬编码规则:"邮件包含'中奖'二字就判定为垃圾邮件"。而是给模型十万封已经标注好正常/垃圾的邮件,让模型自己总结规律。
但传统机器学习有个硬性前提:特征工程。 模型不能直接读取原始数据,需要人手动设计特征:
- 房价预测:人工构造面积、房龄、地段、学区等特征;
- 图像识别猫:人工设计耳朵形状、胡须长度、纹理统计量等特征。
模型效果的上限,很大程度取决于做特征工程的工程师水平。
代表算法:线性/逻辑回归、决策树、随机森林、SVM、KNN、XGBoost、LightGBM。
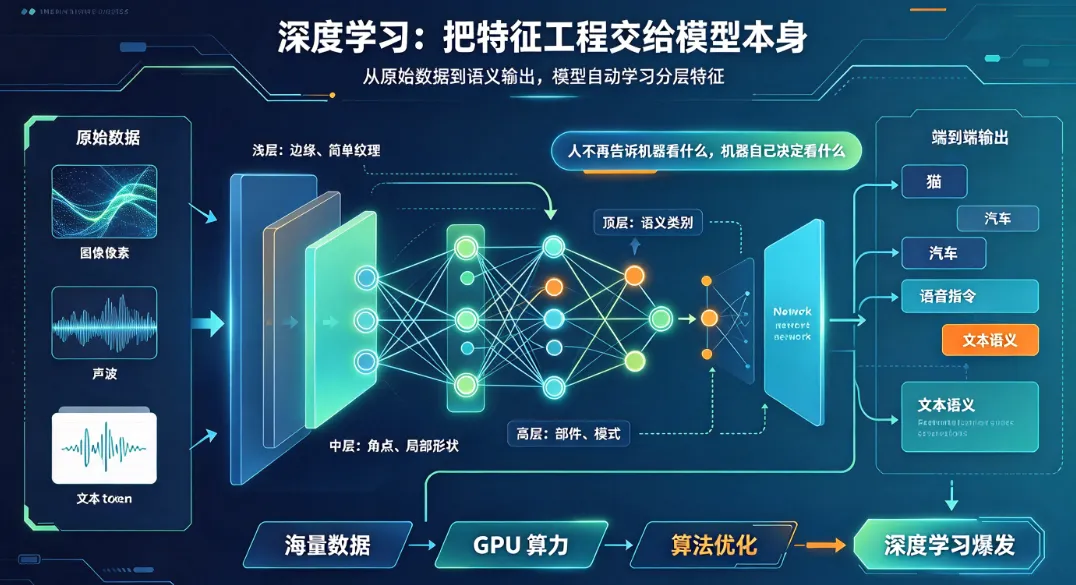
深度学习:把特征工程交给模型本身
深度学习本质是多层的神经网络,"深度"指网络层数多。它最大的突破就是表征学习——自动提取特征,实现端到端训练。
以图像识别为例,网络分层自动学习:
浅层学习边缘线条 → 中层学习纹理、角点 → 高层学习物体部件(眼睛、车轮) → 顶层学习语义信息(猫、汽车)
人不再告诉模型"需要重点观察什么",模型自主学习数据里的特征,也就是常说的端到端学习。
这套神经网络理论几十年前就已经提出,为什么直到 2012 年之后才爆发? 三个必要条件全部成熟:海量互联网数据、GPU 带来的强大算力 、算法持续优化(反向传播工程落地、ReLU 激活、残差连接等)。 2012 年 AlexNet 在 ImageNet 图像竞赛大幅降低识别错误率,是深度学习时代公认的引爆点,后续一路发展到 Transformer,直到如今的大模型时代。
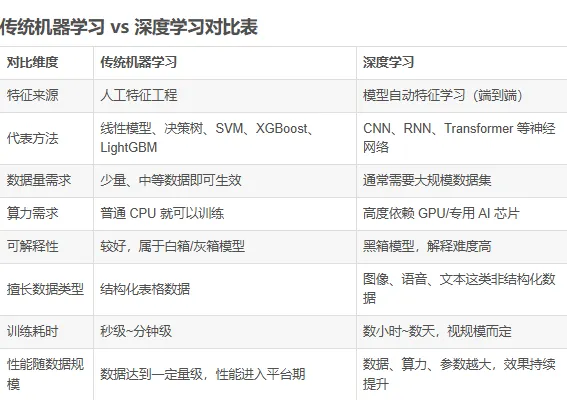
传统模型数据量到一定程度就达到上限;深度学习可以做到"大力出奇迹",这也是当前大模型的底层逻辑。
通俗类比:
- 传统机器学习:老师傅带徒弟。师傅提炼经验做成口诀(特征),徒弟依靠口诀判断。口诀质量决定上限。
- 深度学习:海量题海训练。不给口诀,直接看百万样本,自主总结规律。样本不足很难学懂;样本足够,总结出的规律甚至超越人工口诀。
机器学习与深度学习的联系:不是替代关系,是传承互补
子集关系
深度学习属于机器学习的子集,不是机器学习的替代品,是机器学习领域一次范式升级,把特征提取工作从人转移到模型。共享基础理论
两者核心目标都是提升泛化能力,在未见过的测试数据上取得好效果;共享损失函数、梯度下降、正则化、过拟合/欠拟合、数据集划分、评估指标等整套理论。学会传统机器学习,再学习深度学习,大部分基础概念可以复用。技术历史一脉相承
深度学习属于机器学习里面连接主义(神经网络)分支:
1958 感知机 → 1986 反向传播算法 → 2006 Hinton 预训练 → 2012 AlexNet → 2017 Transformer → 现代大模型。
不是凭空诞生的技术,蛰伏数十年,等到数据、算力条件成熟才爆发。
- 工业界落地互补使用
- 金融风控、销量预测、用户流失这类表格业务,工业界主流依旧是 XGBoost/LightGBM:小数据、可解释性强、上线稳定;
- 图像、语音、文本、AIGC 生成场景,是深度学习主场;
- 很多项目链路会混合方案:深度学习负责特征提取,传统机器学习作为分类头或者排序层。
工程选型建议(实战向)
样本几千条以内、表格结构化数据、要求可解释性、业务稳定优先 → 优先传统机器学习;
图像/语音/文本生成任务、数据充足、具备 GPU 算力 → 选择深度学习;
拿不准方案:先用简单机器学习模型搭建 Baseline 基准,验证业务可行性,再评估是否升级深度学习。新手最容易踩坑:业务初期直接上复杂深度模型,浪费算力与时间。
机器学习回答的问题:能不能让机器从数据中自主学习规律。 深度学习回答的问题:能不能连"需要学习哪些特征"这件事,也交给机器自主完成。
机器学习是一门学科,深度学习是这门学科里当下最锋利的工具。工具再强大,数据、目标函数、评估体系这些根基,依旧属于机器学习的范畴。

