
文中项目数据取自 AI Tutor 的真实配置文件(21 个业务场景、663 行 YAML、467 个节点)。性能与收益数字为量级估算。
一、坐标系:四级成熟度
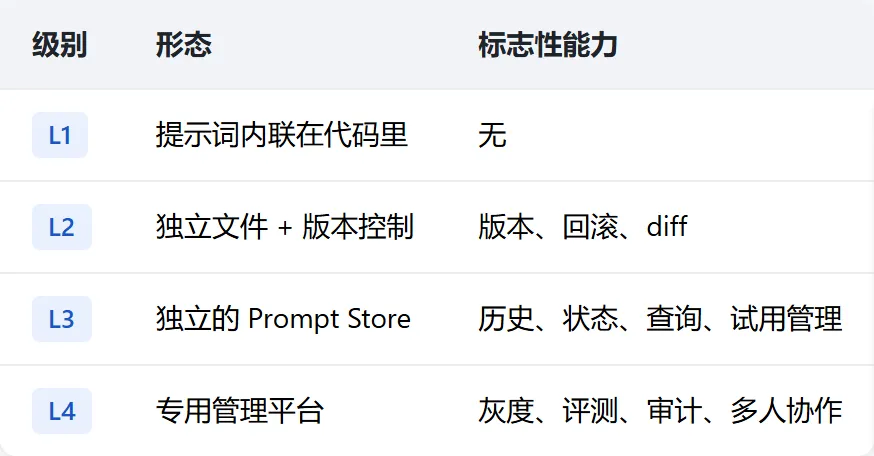
这是四个阶段,不是四个方案。第一个问题是「我在哪一级」。
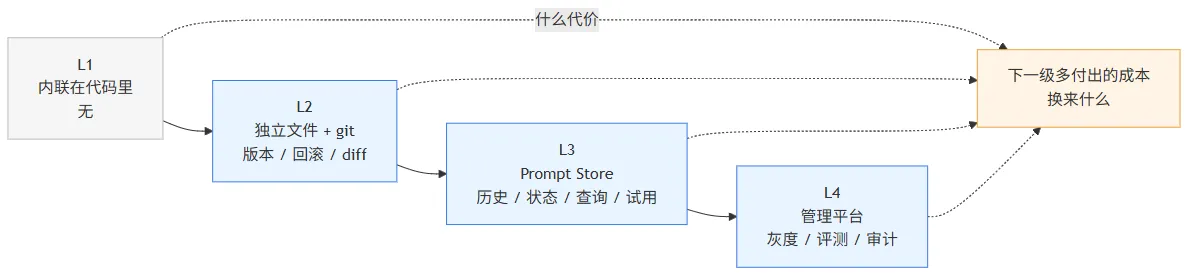
二、L3 和 L4 是同一个数据模型
Nacos 的配置数据本身就在数据库里(嵌入式或外部 MySQL)。它和自建表的区别不在存储层,在于上面预置了什么:管理界面、灰度规则、审计日志、可视化调试。
L3 = 存储 + 版本,界面自己写
L4 = 别人建好了存储 + 界面,你直接用
所以选型不是「数据库还是平台」,而是:存储 + 版本必做,界面 + 灰度 + 审计要不要买。
三、选型判据
理由一:改一次 prompt 要付多少部署成本
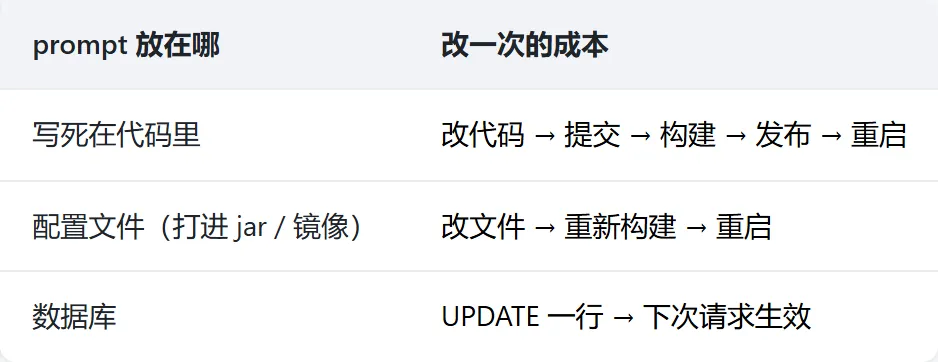
prompt 是 AI 项目里改得最频繁的东西,所以:
主要成本 = 变更频率 × 部署成本
这个乘积和 prompt 有几个无关。反过来推更反直觉:1 个 prompt 每天改,一年 365 次发版;20 个每天改 3 个,也是一年 365 次。
数量少不是停留在 L1 的理由,反而是最容易陷入反复发版的形态。
理由二:一条写错,炸多大范围
这是配置文件方案被低估的成本。
YAML 是应用启动时全量解析的,所以格式错误 = 解析失败 = 服务起不来。而 prompt 里全是自然语言,触发格式错误的概率不低:
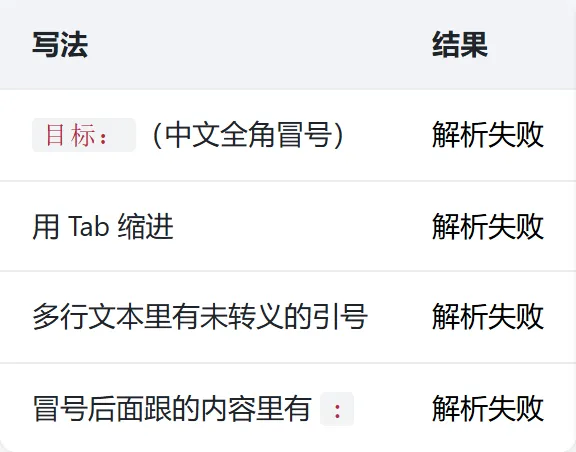
而且是全量解析——20 个场景里有 1 个写错,20 个都读不出来。
表里存的是 MEDIUMTEXT,数据库不管内容格式,解析延后到你渲染那一条的时候:
YAML:格式错 → 启动失败 → 全服务不可用
表:  格式错 → 那一条解析失败 → 只有它不可用
差别不只是「容错」,是爆炸半径。表里那条坏掉的还能在应用里兜个默认值,接口照常返回;YAML 里一条坏了,服务根本起不来。
这也是很多团队上了配置文件之后又回到数据库的原因——不是嫌不好管理,是提示词里全是中文和 {
{变量}},格式风险太高。
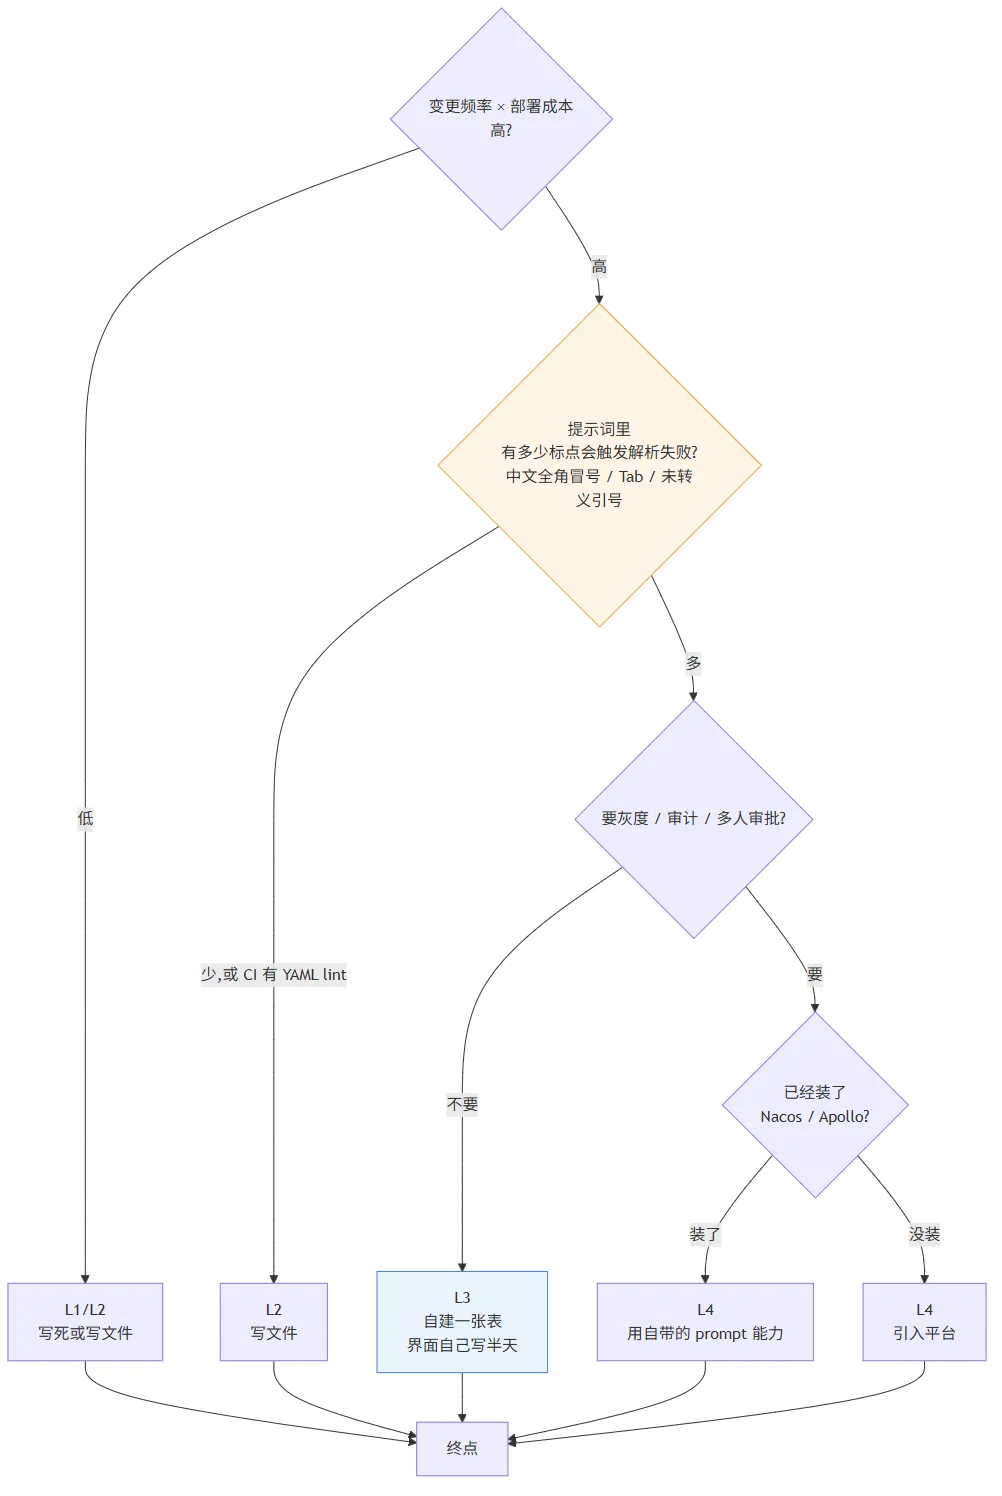
判据
变更频率 × 部署成本 > 建库 + 维护界面的成本
不需要 prompt 数量做门槛。
顺带一提,部署轻的项目可以直接停在 L2:
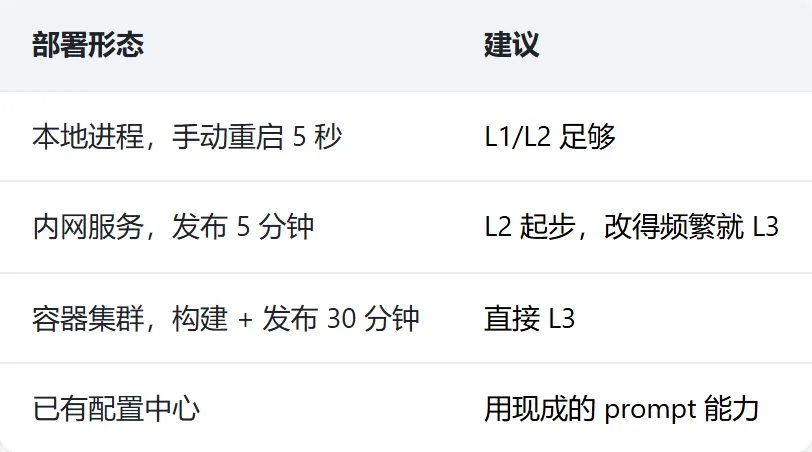
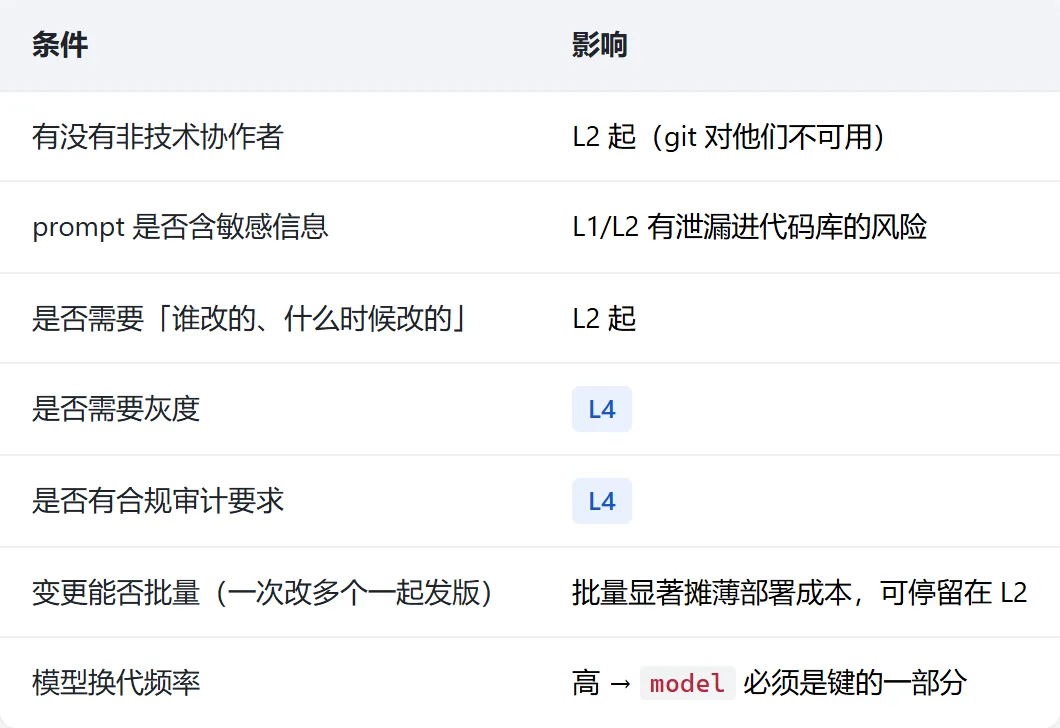
还要考虑的条件
四、结构:分层写还是拍平写
YAML 是一层层嵌套的,进了表就是几个字段。这是同一个结构的两种写法,不是两个方案。
4.1 文件里分层
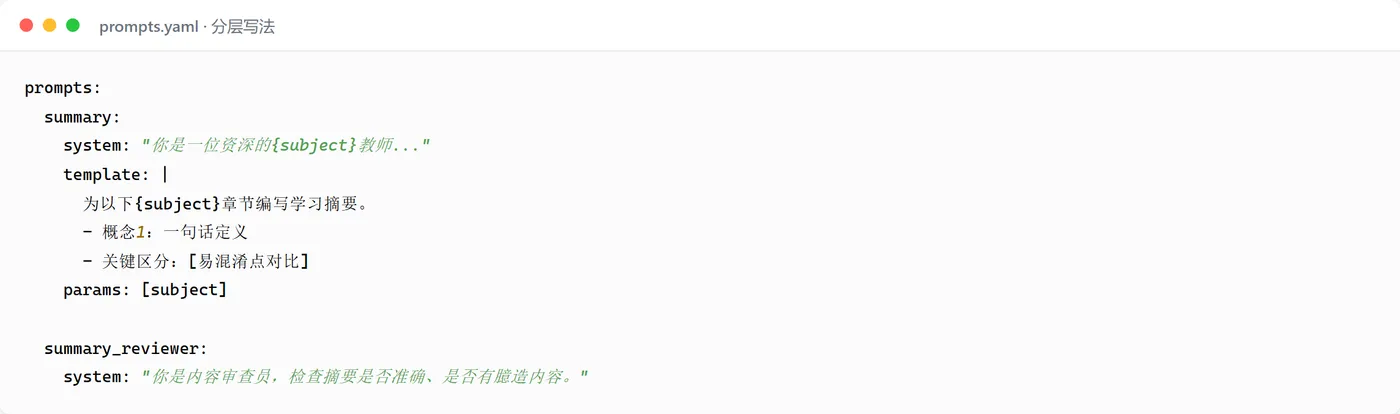
场景按职责命名,不按调用方命名。
AI Tutor 里的 reviewer 就是按这个规则成族扩展的:
summary_reviewer content_reviewer mindmap_reviewer
knowledge_reviewer animation_reviewer exam_points_reviewer
六个同后缀的场景,六个不同角色——summary_reviewer 审摘要,knowledge_reviewer 审知识讲解,职责边界一眼可见。叫 rev1 / rev2 就全混了。
这一族的价值不只是命名整齐,还有个副作用:新增场景时你知道该往哪放。 看到一个新需求先判断是生成还是审查,key 直接拼出来,不用回头翻命名规范。
key 独立天然隔离,改一条只影响一条。但隔离来自命名,不是来自格式——key 写成 p1 / extract_final_v2,21 个场景就找不着了。
4.2 同样的内容进表
分层拆成字段,层级用分隔符压进 key:
prompts.summary.system → business_code='summary' + 一行记录
prompts.summary_reviewer.system → business_code='summary_reviewer' + 一行记录
表不需要复刻层级,它只需要一个能唯一定位的 business_code。
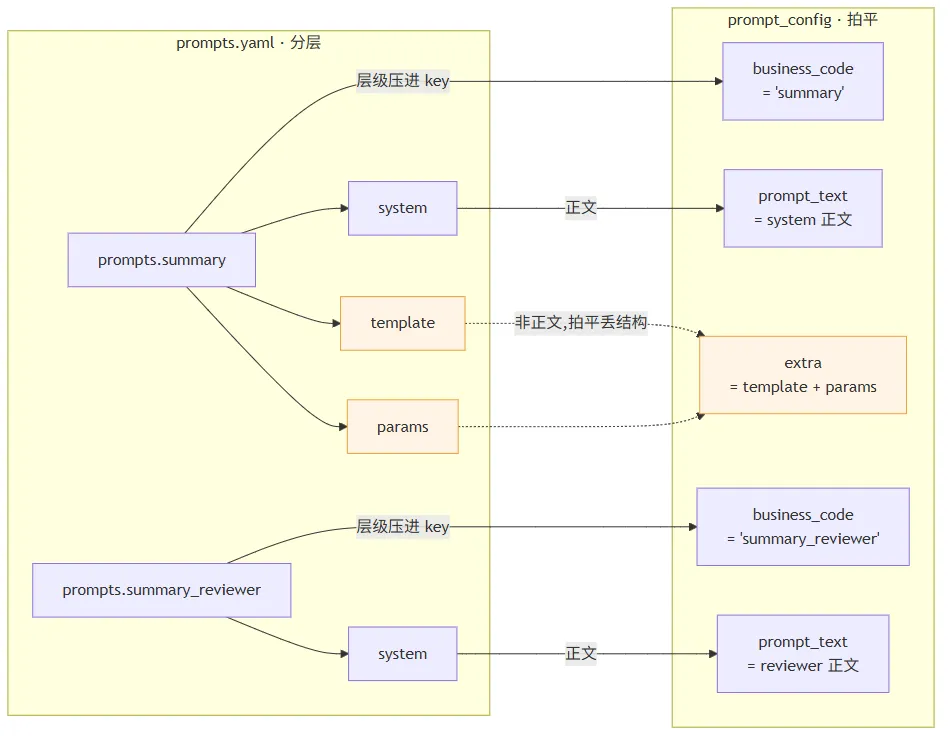
读图要点:拍平是有损的。 template / params 这类结构化内容在表里没有专门字段,只能塞 extra 或者拆成独立列。所以进表那一刻要做的决定只有一个:哪些内容需要单独查询或约束,值得占一列;其余全进 extra。
4.3 文件方案唯一的陷阱:YAML anchor
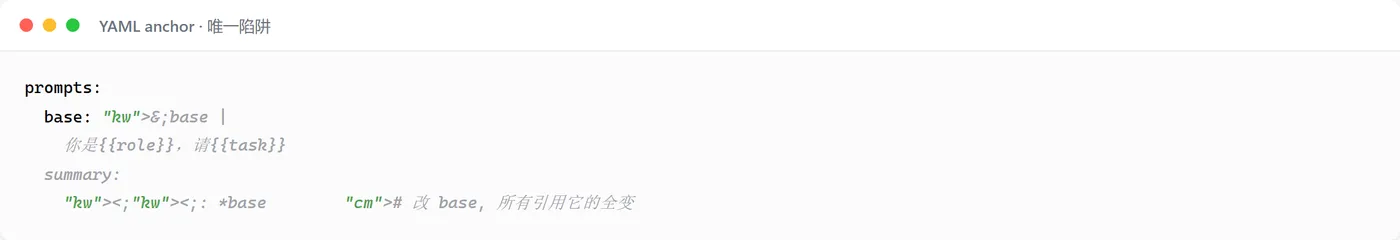
anchor 看起来是 DRY,实际引入了共享。共享意味着将来想只改其中一个,改不了。
它最隐蔽的地方在于格式上是对的:review diff 看到的是「改了一处」,运行时受影响的是 20 处。替代方案就是复制,多打几行字换彻底隔离。
五、表设计
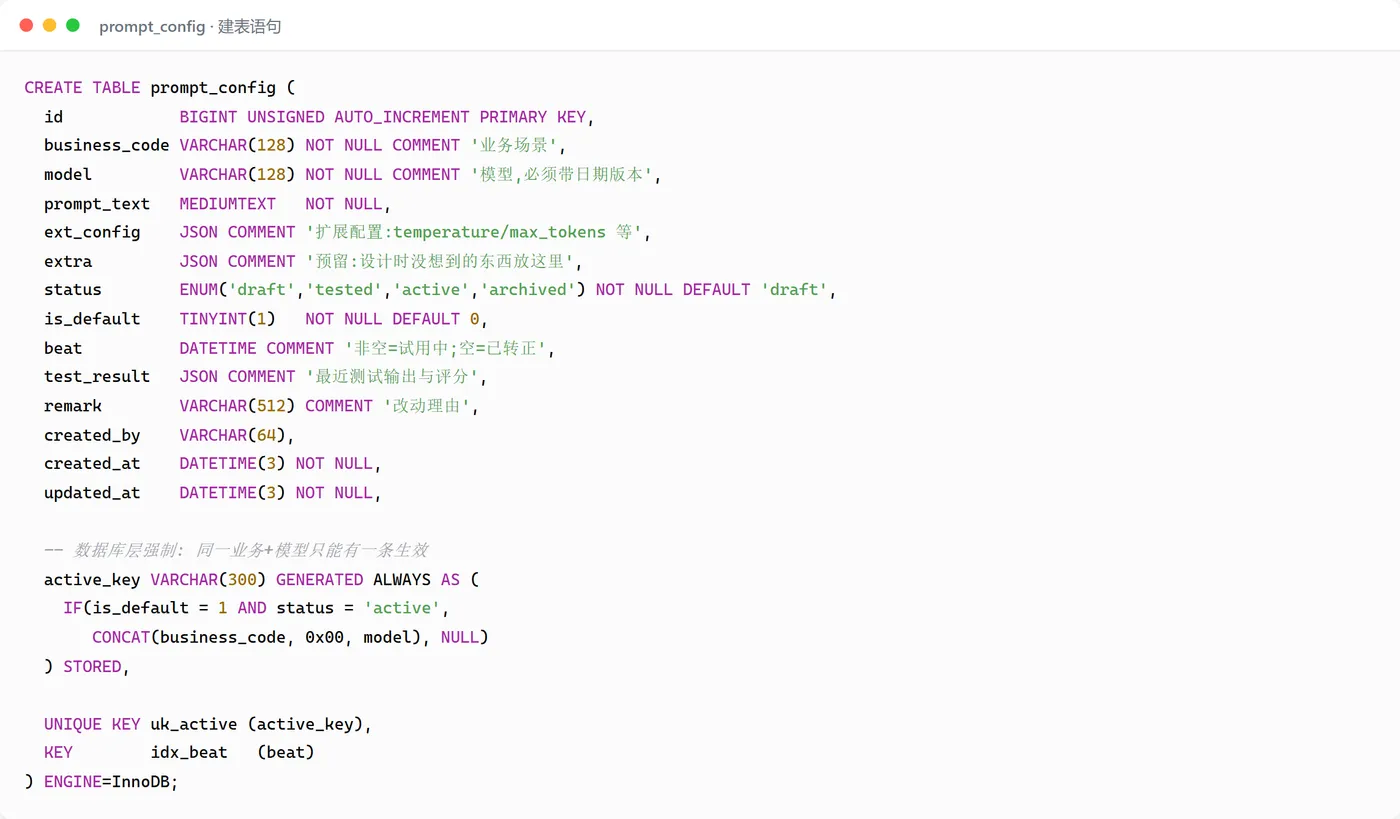
ext_config 和 extra 分开:前者是模型参数,后者是留给设计时没想到的东西。表结构不可能一次想全,预留一个字段比以后加列迁移便宜。
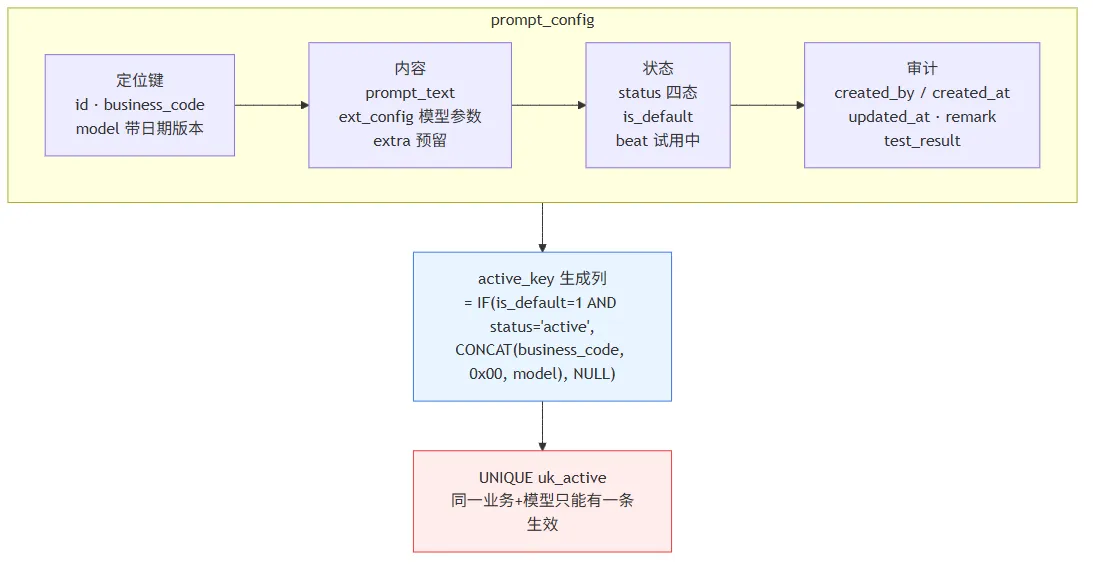
五个取舍
不要版本号。 时间戳排序就够。真正必需的是 append-only——改内容是插入新行 + 旧的转 archived,不是原地 UPDATE。允许原地更新,加了时间戳也救不回来。
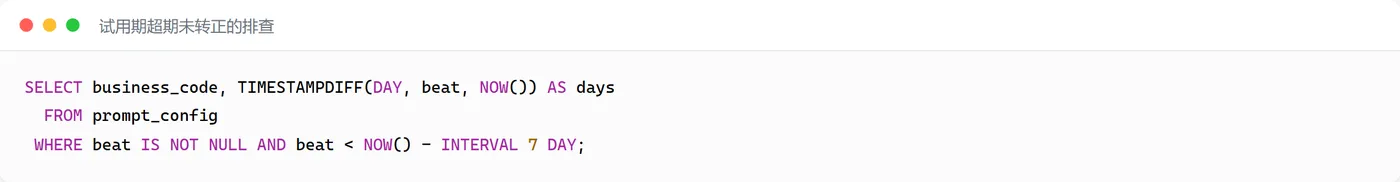
不要灰度表。 灰度不是常态,一个可空 beat 够用:非空 = 试用中,值 = 开始试用时间。它还能顺便查出试用超期没转正的记录:
status 和 is_default 分开。 is_default 管「现在跑哪个」,status 管「走到哪一步」。合并成一个字段,要么把没测的设成默认,要么把测好的设成非默认。
用生成列做唯一约束。 「同一业务+模型只能有一条生效」交给数据库比交给应用层可靠。应用层漏了,唯一索引冲突直接报错,而不是静默产生两条默认。
business_code 不拆成两列。 拆了查询就是三段复合键,还得维护层级一致性。扁平命名配唯一索引,查询是单键,扩展时不用改表。
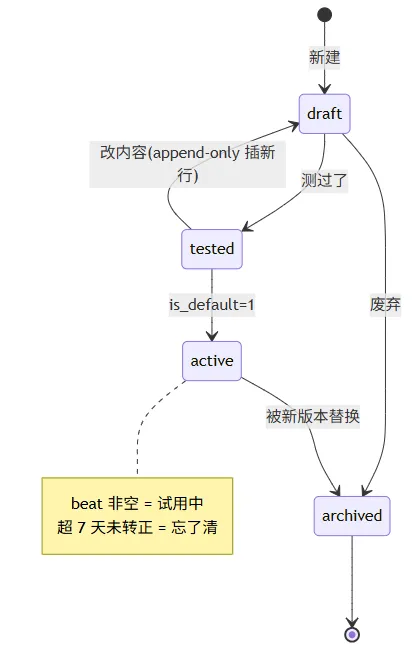
红线是 tested → draft 那条边。 改内容不是 UPDATE 原地覆盖,而是插入新行 + 把旧的转 archived。一旦允许原地更新,加 updated_at 也救不回来——历史被覆盖,加时间戳没有意义。
无论存在哪里都要自己写的一条
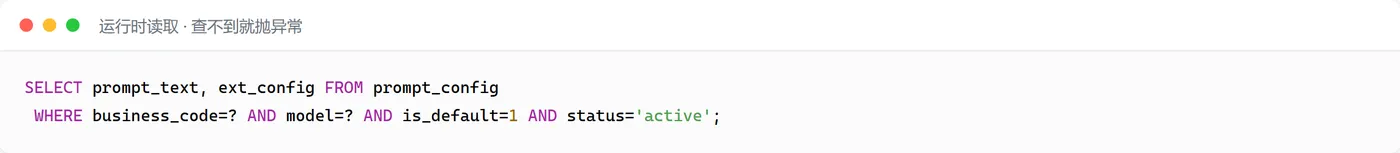
查不到就抛异常,禁止 fallback 到「通用 prompt」。这条平台不管——Nacos 也不会校验「你请求的模型和 prompt 绑定的模型是不是同一个」,用配置文件时同样要写。
原因是 fallback 是 AI 侧最隐蔽的故障:不报错,只是慢慢变差,等发现时已经跑了几天。
六、模型维度
model 要带日期版本,因为同一个模型不同版本 prompt 也不一样:
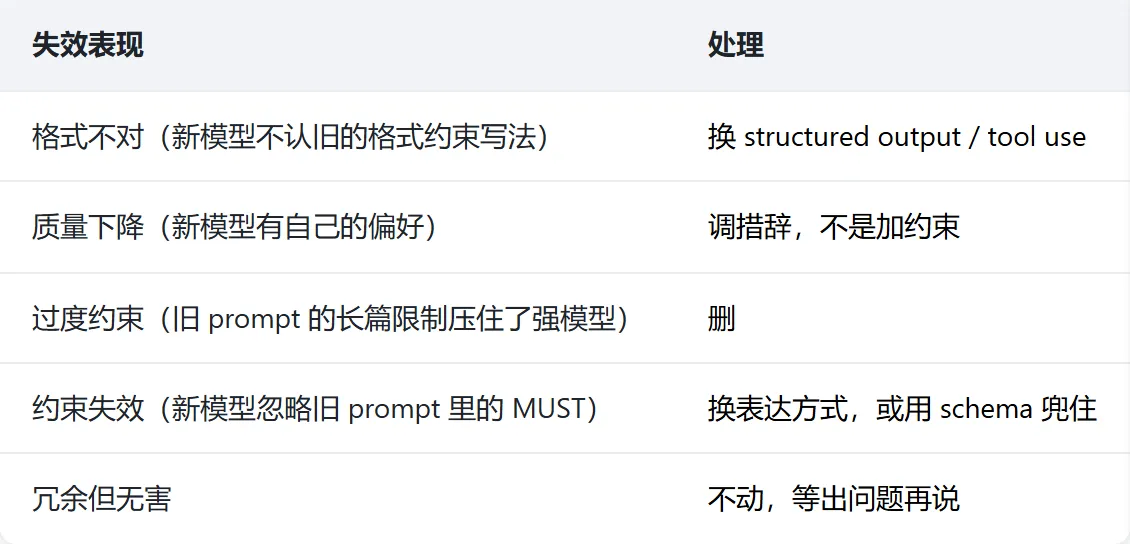
失效方向是双向的:新模型可能不需要旧约束,也可能不遵守旧约束。所以「模型换代就套用强模型 prompt」是错的,得先测出是哪一类。
写法上就是 claude-opus-4-20260514,不能只写 claude-opus-4。不带日期后缀,等于这个键只有一半。
七、L3 还是 L4
数据模型一样,剩下的就是「界面 + 灰度 + 审计这层要不要自己写」。
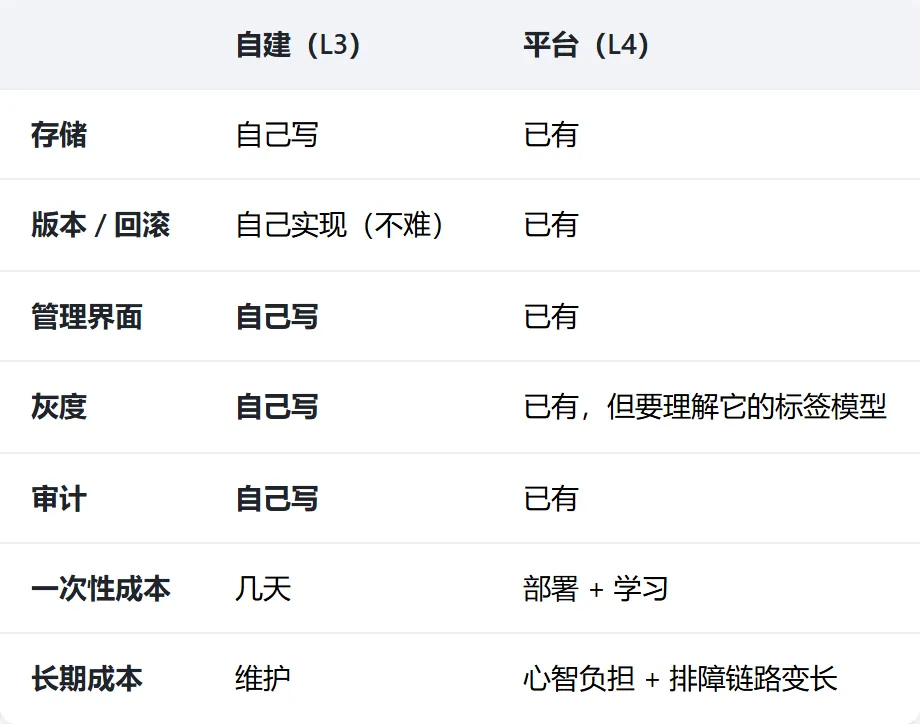
几条判断:
- 已经装了配置中心的项目,直接用它自带的 prompt 能力,别为 prompt 单独引一个平台
- 单人项目、prompt 改得频繁 → 自建,只需要存储 + 版本,界面自己写半天就够
- 团队 + 审批 + 审计 → 平台,那几层自己写的成本远超许可费
- 平台最大的隐性成本是排障链路:prompt 不生效 → 查应用 → 查配置中心 → 查命名空间 → 查 dataId → 查灰度规则,每多一层就多一节排查时间
八、三个可证伪的判断
架构类文章最容易变成正确的废话。所以把这篇文章的结论写成可以被推翻的形式。
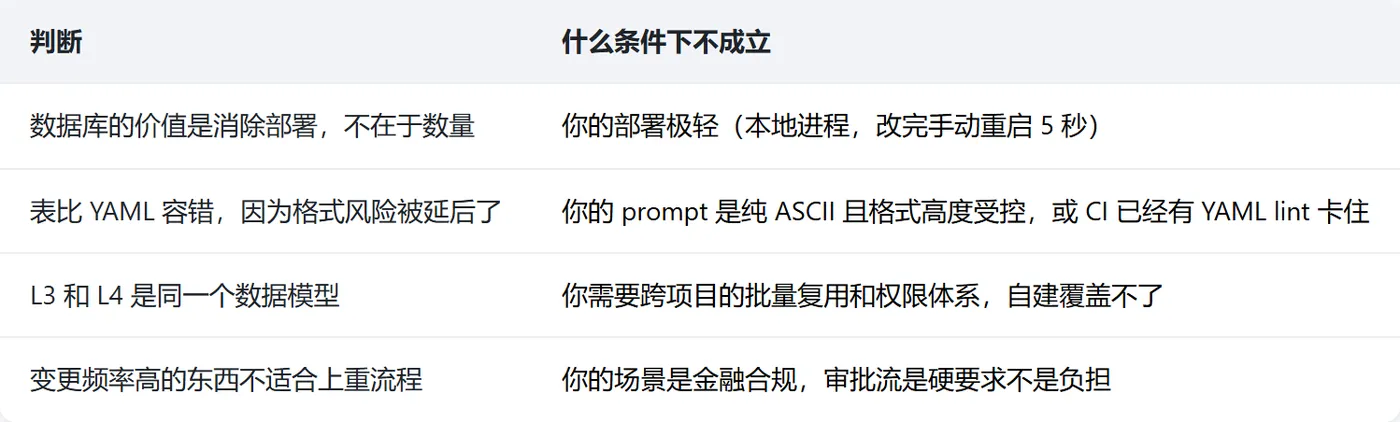
能找到反例,说明上面某条该改。
九、最后
指南已经很成熟(就是第一节那四级),工具也很多。这篇补充三件指南不会讲的事:
- 升级的第一判据是部署成本,不是 prompt 数量——数量少反而是最高频发版的形态
- 配置文件的风险被低估了——提示词里全是中文和
{ {变量}},一条格式错误就能让服务起不来,而表里只会坏一条 - L3 和 L4 是同一个数据模型——选型只是决定那层界面要不要自己写
先算清楚改一次 prompt 要付多少部署成本,再看一眼提示词里有多少标点符号能触发解析失败,方案基本就定了。
。这篇补充三件指南不会讲的事:
- 升级的第一判据是部署成本,不是 prompt 数量——数量少反而是最高频发版的形态
- 配置文件的风险被低估了——提示词里全是中文和
{
   {变量}}
,一条格式错误就能让服务起不来,而表里只会坏一条 - L3 和 L4 是同一个数据模型——选型只是决定那层界面要不要自己写
先算清楚改一次 prompt 要付多少部署成本,再看一眼提示词里有多少标点符号能触发解析失败,方案基本就定了。

