一个最典型的故障现场
周五晚上,订单同步任务突然停了。
日志里没有报错,任务显示"正常运行中"。第二天早上才发现:过去 14 个小时的订单,一条都没进来。
查到最后,原因是一行不起眼的变化——访问令牌过期了。
系统早就实现了自动续期,但续期逻辑只写在"用户请求"这条链路上。后台的定时任务用的是启动时拿到的那个令牌,跑了两小时后它悄悄失效了,而任务本身没有任何感知。
这就是鉴权类故障最讨厌的地方:它不报错,它只是静默地停止工作。
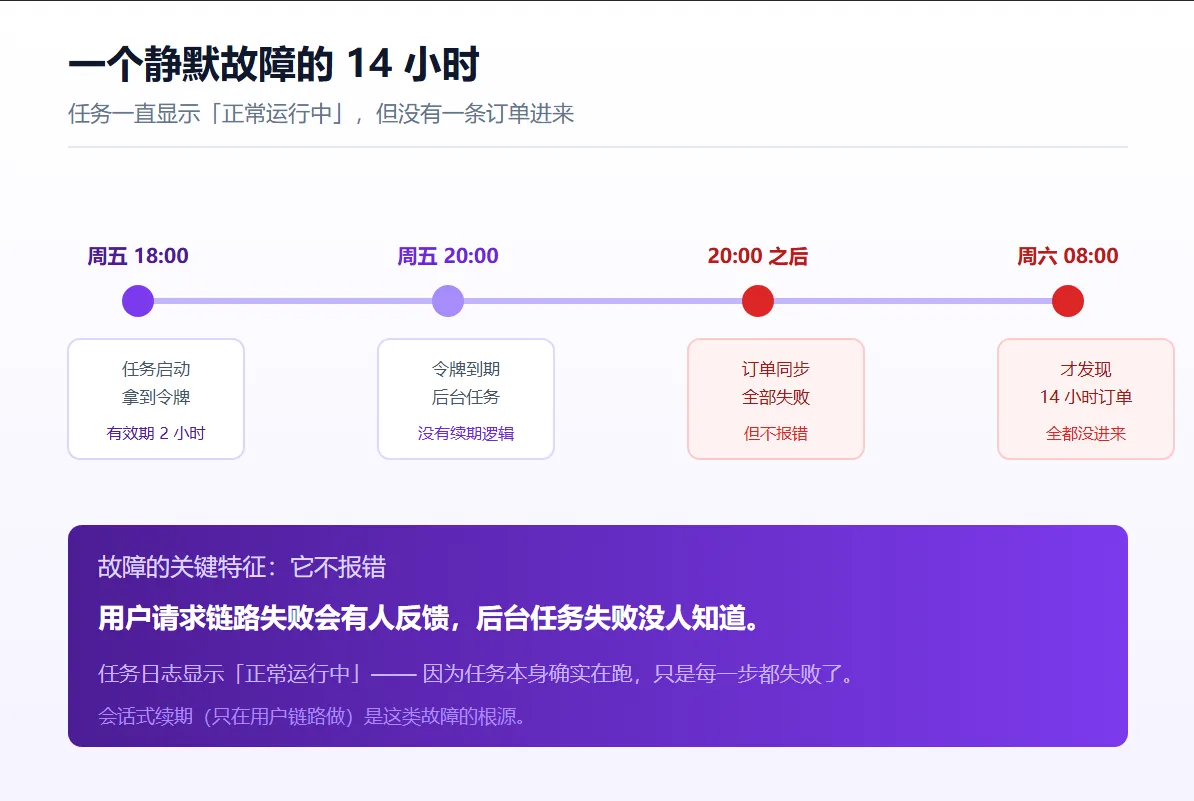
图 1 · 任务日志显示「正常运行中」,但每一步调用都失败了——没人知道
下面把接口鉴权里最容易踩的五个陷阱拆开讲。这些不是理论问题,每一条都对应过真实的线上事故。
陷阱一:把"令牌获取"和"令牌使用"分开处理
这是最常见的设计缺陷。
很多系统的做法是:
# 启动时获取一次
token = get_token()

# 之后所有地方都用这个 token
def call_api(...):
    return request(..., headers={"Authorization": token})
问题在哪? 这个 token 是进程启动那一刻的快照。它有有效期,可能是 2 小时,可能更短。
一旦过期:
- 用户主动请求的链路 → 至少会报错,用户会反馈
- 后台定时任务 → 没人看,静默失败
正确的做法:令牌必须是一个"按需获取"的资源,不是一个"启动时加载"的变量。
def get_valid_token():
    if cache.token is None or cache.expires_at < now() + 300:
        cache.token = refresh_token()      # 提前 5 分钟续期
        cache.expires_at = now() + ttl
    return cache.token
关键在于:每次调用前都问一次"当前令牌还有效吗",而不是假设它一直有效。
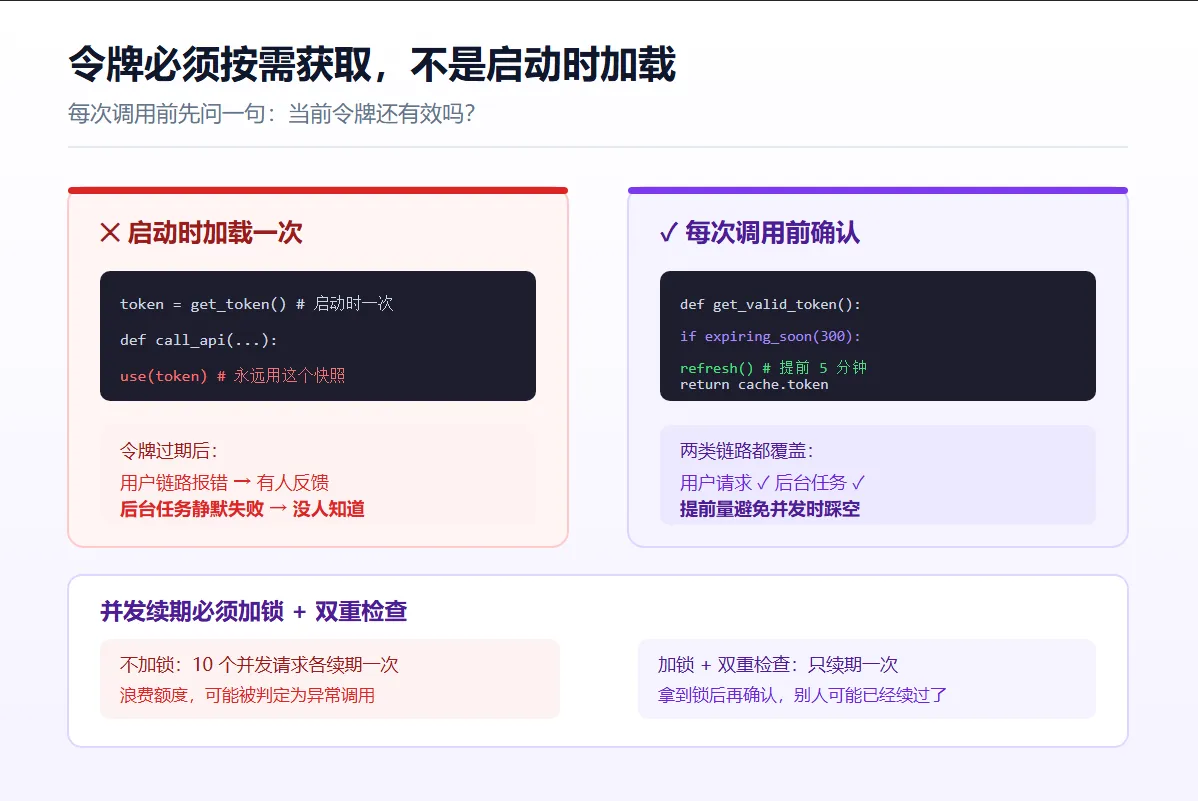
图 2 · 左侧是启动时加载一次(覆盖不到后台任务),右侧是每次调用前确认
陷阱二:续期没有提前量
有人会说:那我在令牌过期的那一刻续期不就行了?
不行。 因为"过期那一刻"你很可能正在并发调用。
考虑这个时序:
时刻 |
事件 |
T |
令牌过期 |
T+0.01s |
请求 A 带着旧令牌发出 → 失败 |
T+0.02s |
请求 B 带着旧令牌发出 → 失败 |
T+0.03s |
续期逻辑才开始执行 |
续期必须提前。 业内常见的做法是留 5–10 分钟的安全窗口,在过期前就换好新令牌。
更要命的是并发续期:如果 10 个并发请求同时发现"令牌要过期了",它们会同时去续期——触发 10 次续期请求。轻则浪费额度,重则被对方判定为异常调用。
解法是加锁:只允许一个请求去续期,其他请求等待它的结果。
def refresh_with_lock():
    with lock:
        # 双重检查:拿到锁后再确认一次,可能别人已经续过了
        if cache.expires_at > now() + 300:
            return cache.token
        cache.token = do_refresh()
        return cache.token
那个"双重检查"很关键——不加的话,10 个请求排队进来会依次续期 10 次。
陷阱三:把令牌写进了日志
这个坑不涉及功能,涉及安全,但极其普遍。
调试的时候,为了方便排查,有人在请求日志里打了完整的 header:
INFO request headers: {"Authorization": "Bearer eyJhbGciOi...(完整令牌)"}
这一行日志,等于把你们的访问凭证公开了。
任何能看到日志的人——运维、其他开发、日志收集系统、甚至日志被误传到某个排查群——都能拿到这个令牌,用你们的身份去调用接口。
几个基本要求:
- 日志里令牌一律脱敏,只保留前后几位(如
eyJhbG...****) - 令牌不要出现在 URL 参数里(URL 会被完整记录在网关日志、浏览器历史)
- 报错堆栈里如果带上了完整请求对象,同样要处理
判断标准很简单:你愿意把这行日志贴到公开群里吗? 不愿意,就不该打。
陷阱四:只处理"过期",不处理"被提前吊销"
很多系统的续期逻辑只考虑一种情况:令牌到期了,换一个新的。
但现实中还有另一种情况:令牌还没到期,但已经不能用了。
可能的原因:
- 对方平台做了安全策略调整,主动吊销了旧令牌
- 用户在其他设备上重新授权,导致旧的授权失效
- 权限范围(scope)被修改
这时候你拿着一个"有效期还没到"的令牌去调用,会收到 401 或 403。
如果你的代码只判断"时间到了才续期",那遇到这种情况就会一直用这个废令牌去撞墙——每一秒撞一次,撞到时间过期为止。
正确做法:把 401 / 403 也作为续期的触发条件。
resp = call_api(using=token)
if resp.status in (401, 403):
    token = force_refresh()      # 不管时间到没到,直接换
    resp = call_api(using=token)  # 重试一次
注意"重试一次"就够了——如果换了新令牌还是 401,那问题不在令牌,继续重试只是浪费。这时候应该告警。
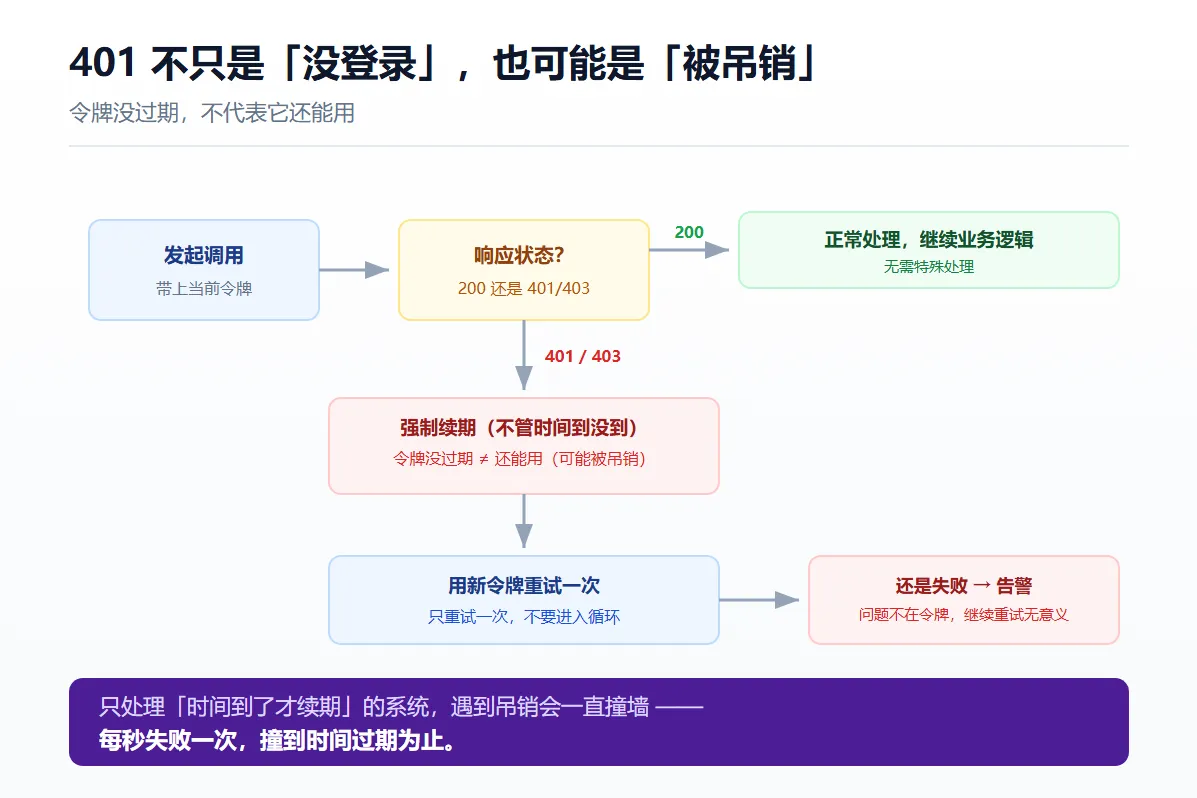
图 3 · 401/403 也要触发续期,不能只等时间到期
陷阱五:权限范围设计成"全都有"
最后一个坑在申请阶段,但影响最长远。
很多人在申请接口权限时,习惯性地把所有权限都勾上——"反正不用白不用"。
代价是什么?
- 安全面扩大了。令牌一旦泄露,对方能动的范围就很大(对应陷阱三,风险被放大)
- 审计时说不清。企业客户做安全评估时,会问"你们申请这么多权限干什么用"——答不上来就是扣分项
- 改起来麻烦。权限申请容易,回收往往要走流程
原则:按最小必要申请。
每个权限都应该能回答:"这个权限对应我们哪个具体功能?"
答不上来的,就不该申请。
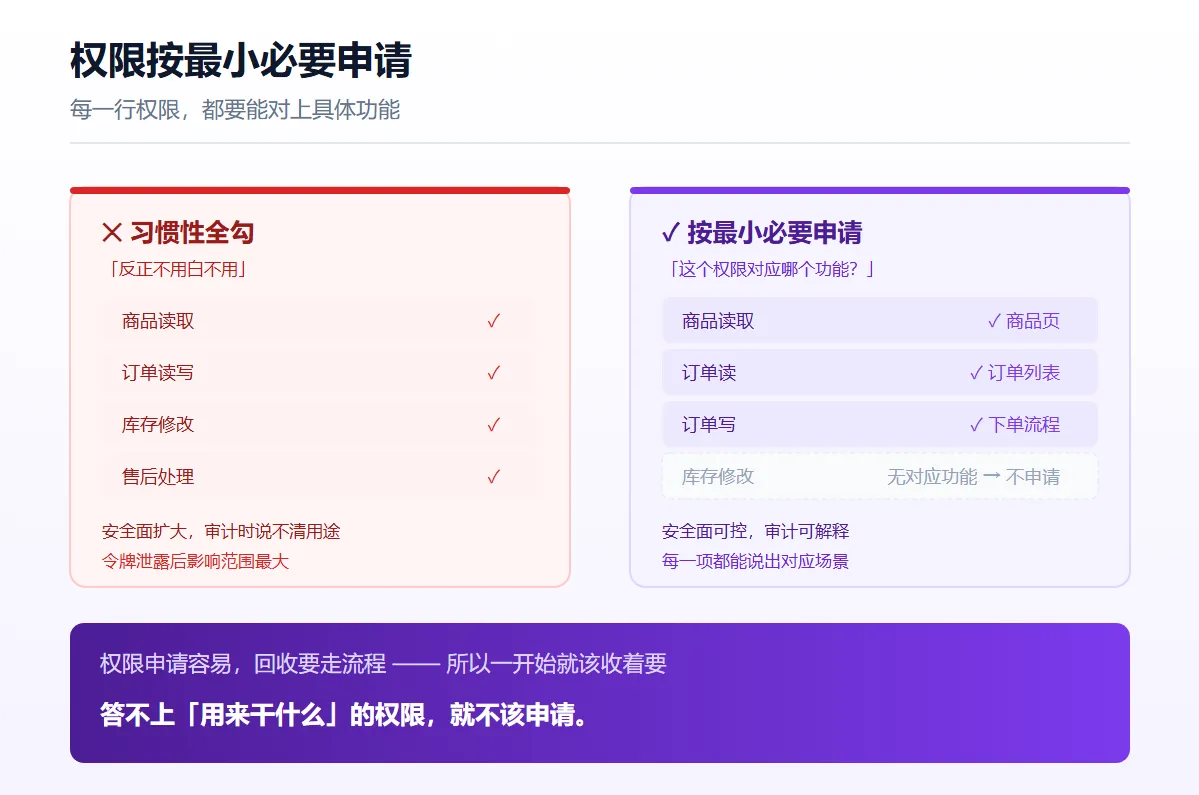
图 4 · 每一项权限都要能对上具体功能,答不上来的就不申请
一张自检表
上线前过一遍这五条:
- 令牌是按需获取的,不是启动时加载一次?
- 续期有提前量(比如提前 5 分钟)?
- 并发续期加了锁,且有双重检查?
- 日志里的令牌做了脱敏?
- 401 / 403 会触发强制续期,而不是干等到期?
- 续期失败时有告警吗?(不是静默重试到天荒地老)
- 申请的权限范围,每个都能对上具体功能?
最后两条最容易被忽略:一个是没有告警——故障发生了你根本不知道;一个是权限泛滥——平时看不出问题,出事时才知道代价。
小结
回到开头那个故障现场。
真正的问题不是"令牌会过期"——这是设计如此,很正常。真正的问题是:
我们把令牌当成了一直有效的常量,而不是一个需要管理的资源。
接口鉴权这件事,难的地方从来不在算法(签名怎么算、加密怎么做),而在边界的处理:
- 过期与续期的边界
- 并发与加锁的边界
- 正常与异常的边界
网络和令牌都不会按你的假设工作。
所以正确的姿势不是"相信它一直有效",而是"每一次调用前都确认它还活着"。