先说一个反直觉的结论
很多团队对接电商开放平台时,会做这样一件事:请求失败了就重试。
听起来很合理,甚至像是"健壮性"的体现。
但如果没有做幂等控制,重试会让故障从"一次失败"放大成"三笔重复订单"。
这不是极端情况。这是分布式系统里最常见的坑之一,而且它有个特点:平时不出问题,一出就是资损。
一、超时到底意味着什么
先建立一个认知:超时 ≠ 失败。
当你发起一个下单请求,超时了,可能有三种情况:
实际发生了什么 |
你看到的 |
你以为是 |
请求根本没到对方 |
超时 |
失败 |
对方处理到一半崩了 |
超时 |
失败 |
对方处理成功了,但响应包丢了 |
超时 |
失败 ← 最危险 |
第三种情况下,对方系统里已经有一笔订单了。你的程序以为失败,于是重试——对方又创建了一笔。
重试 3 次,就是 3 笔订单。客户只买了一件。
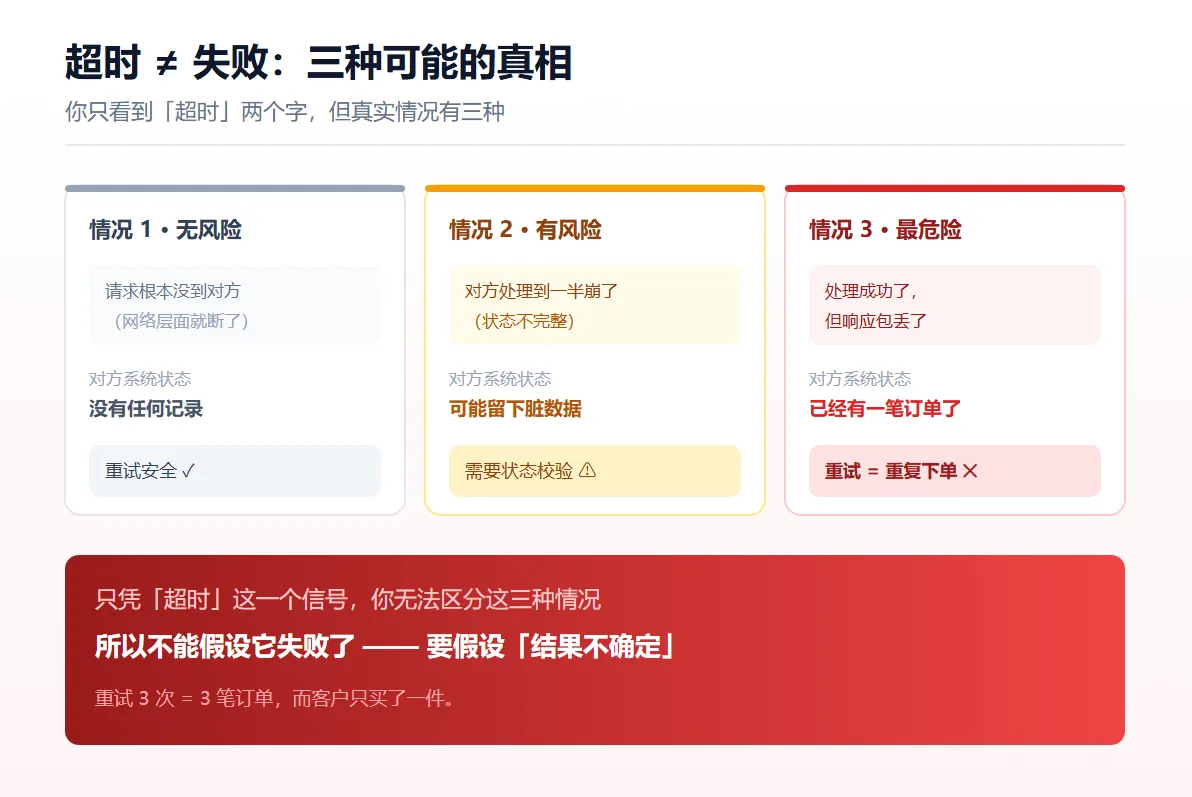
图 1 · 你只看到「超时」两个字,但真实情况有三种——只凭这个信号无法区分
二、为什么"加个重试"解决不了
有人会说:那我加退避重试、加指数间隔,是不是就安全了?
退避解决的是"别把对方打崩",不解决"重复提交"。
这两个问题经常被混为一谈:
问题 |
手段 |
解决的是 |
重试太密,把对方接口打限流 |
退避 + 限速 |
压力控制 |
重试导致重复写入 |
幂等 |
数据正确性 |
它们是两件事。 只做退避不做幂等,等于给一辆没有刹车的车装了更好的油门控制。
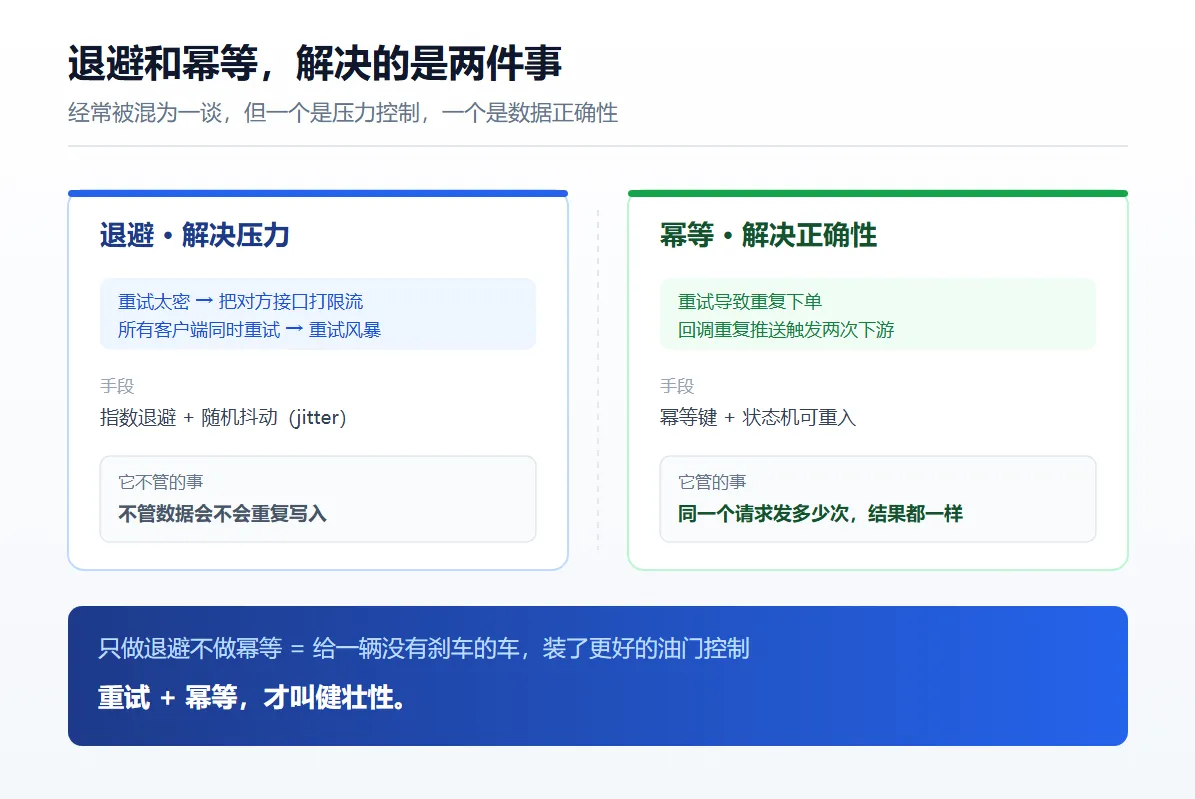
图 2 · 退避管「别把对方打崩」,幂等管「别重复写入」——两者不可互相替代
三、幂等的三种实现方式
幂等的核心思想很简单:让同一个请求,无论发多少次,结果都一样。
具体怎么做,取决于对方平台支持到什么程度。
方式一:客户端生成唯一请求号(推荐)
在发起请求时,自己生成一个全局唯一的 request_id(也叫幂等键),随请求一起发出去。
- 第一次请求:对方创建订单,记录下这个
request_id - 重试请求:对方发现
request_id已存在,直接返回上一次的结果,不再重复创建
关键点:这个 ID 必须由客户端生成,且必须在第一次请求前就生成好——如果每次重试都重新生成,那等于没做。
一行代码的位置差别,决定的是会不会重复下单。
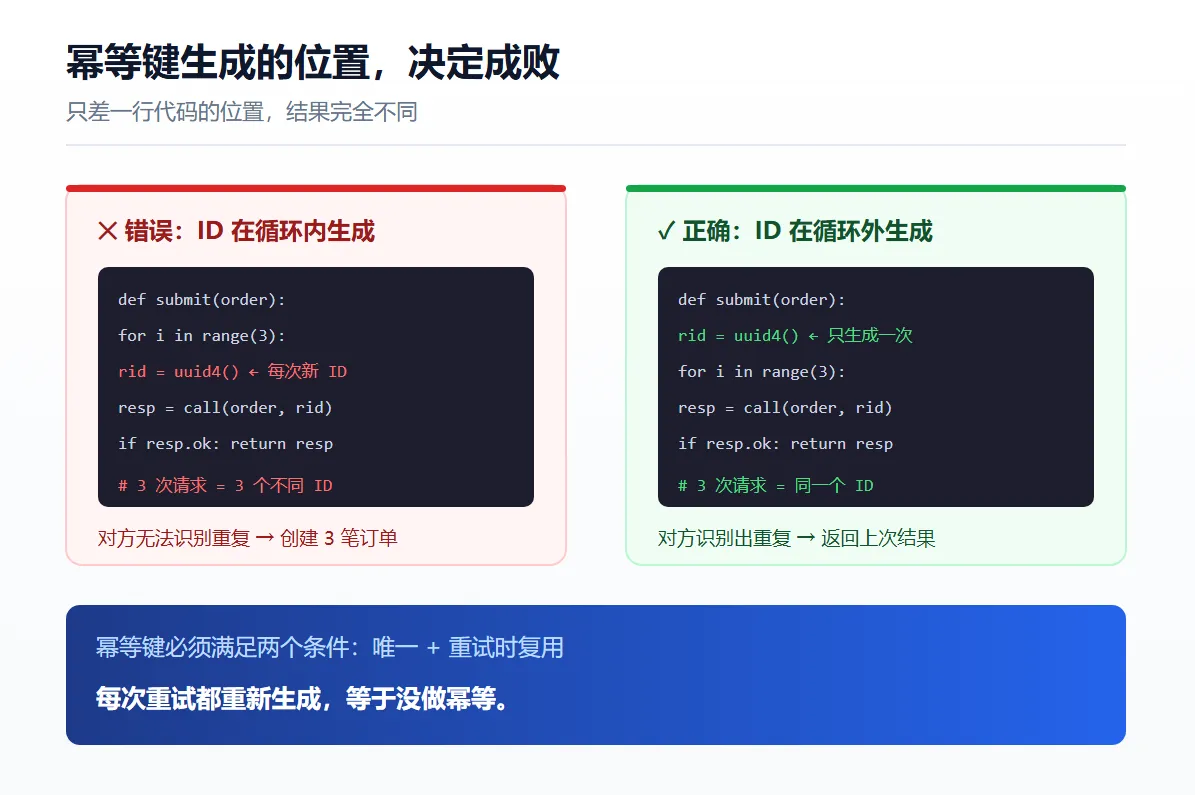
图 3 · 幂等键在循环内还是循环外生成,决定重试能不能被识别为重复
方式二:业务唯一键
如果对方不支持自定义请求号,就用业务上天然唯一的字段做去重依据。
比如:客户ID + 商品ID + 下单时间窗口。
这需要你这边维护一张去重表,在提交前先查一次"这个业务键是否已经提交过"。
注意:业务键的选择很关键。选得太宽(比如只用客户ID),会把客户正常的多次购买误判为重复;选得太窄(比如带上毫秒时间戳),又起不到去重作用。
方式三:先查后写(补偿式)
重试前先查询一次:"这笔单子到底建成功了没有?"
- 查到 → 说明上次其实成功了,直接用查询结果
- 查不到 → 再重试提交
这种方式最保险但成本最高,每次重试都多一次查询。适合那些一旦重复后果特别严重的场景。
四、一个容易被忽略的细节:状态机
光有幂等键还不够。你的订单状态机必须能处理"重复回调"。
场景:你提交了订单,对方返回成功,同时通过回调把状态推给你。如果网络抖动导致回调推了两次呢?
如果你的回调处理逻辑是"收到回调 → 更新状态 → 触发下游动作",那下游动作会被触发两次。
正确的做法是:
核心原则:状态流转必须是"不可逆 + 可重入"的。 同一个状态不能被处理两次。
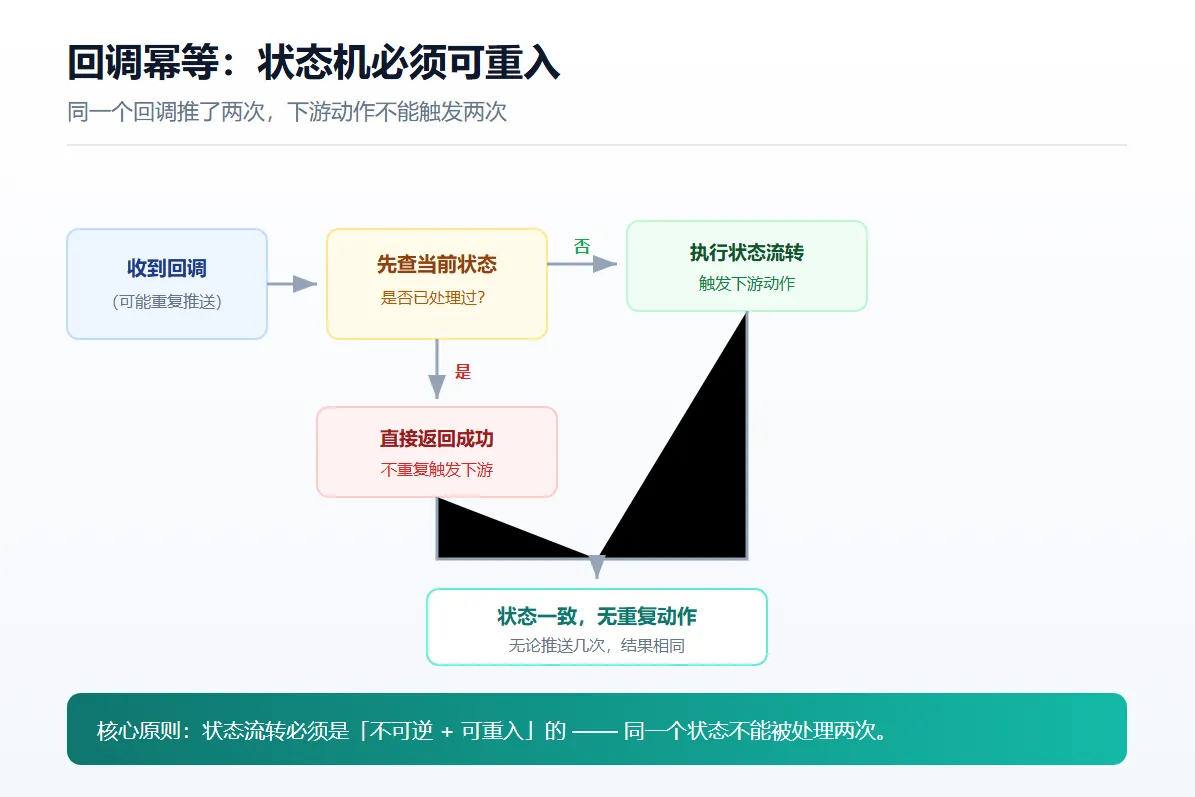
图 4 · 收到回调先查状态:已处理过就直接返回,不重复触发下游动作
五、限流与重试的配合
幂等解决了正确性,但还有一个问题:重试的时机和频率。
几个实践要点:
- 区分可重试与不可重试的错误
- 超时、5xx、限流 → 可重试
- 参数错误、鉴权失败、业务校验不通过(4xx)→ 重试没用,重试一百次还是错
- 退避要带随机抖动(jitter)如果所有客户端都在 1s、2s、4s 重试,它们会在同一时刻一起打过去,形成"重试风暴"。加一点随机偏移能打散这个峰值。
- 重试要有上限,并记录日志无限重试比不重试更糟——它会把一个明确的失败变成一个永远查不清的问题。
- 限流响应要区分对待对方返回限流时,说明问题在频率不在内容。这时应该降低并发,而不是持续重试。
六、上线前的自检清单
对接前把这几条过一遍,能避开大部分资损级别的坑:
- 重试时复用的是同一个幂等键吗?(不是每次新生成)
- 超时被当作"结果未知"处理,而不是"失败"?
- 回调处理是幂等的吗?(重复推送不会触发两次下游)
- 4xx 类错误没有进入重试循环?
- 退避是否带了随机抖动?
- 重试次数有上限吗?超限后是告警还是静默丢弃?
- 有没有一张表能查"某个请求号最终结果是什么"?
- 每天是否与对方系统对一次账,确认订单数一致?
最后两条最重要。 前六条是预防,后两条是兜底——预防做再好也要有兜底,因为你无法保证对方的系统不出问题。
小结
回到开头那个结论:
重试不是健壮性,重试 + 幂等才是。
单独看,"加个重试"是在提升可用性;但在没有幂等的前提下,它实际上是在放大故障的影响面。
分布式系统里有一条朴素的道理:
只要涉及网络,你就无法确定"没收到响应"到底意味着什么。
所以正确的姿势不是"假设它失败了所以重试",而是"承认结果不确定,然后用幂等让重复无害"。