摘要:YARN-Cluster 是生产环境中 Spark 应用的终极部署方案。它的核心特征是——ApplicationMaster 不再只是资源代理,而是承担完整的 Driver 职责。SparkContext、DAGScheduler、TaskScheduler 全部运行在 AM Container 中,spark-submit 提交后可立即退出。本文从 AM=Driver 的设计哲学、12 步启动流程、四种模式终极对比、YARN 资源隔离四个维度,配合 2 张原创深色架构图 + 源码级分析,带你彻底吃透 YARN-Cluster 模式。
关键词:Spark on YARN, YARN-Cluster, ApplicationMaster, Driver on AM, ResourceManager, Container, HDFS 本地性, 生产环境
一、开篇:终极生产模式
经过前三篇文章的铺垫(Standalone-Client、Standalone-Cluster、YARN-Client),我们终于来到了 Spark 部署模式的终极形态——YARN-Cluster。
它融合了前面所有模式的优势:
YARN-Cluster = YARN-Client 的资源隔离       (Container 级别)
             + Standalone-Cluster 的去客户端化 (Driver 在集群内)
             + YARN Queue 多租户              (企业级)
             + HDFS 数据本地性                (零拷贝)
用一句话概括:
YARN-Cluster 是生产环境中唯一推荐的 Spark 部署模式。
二、YARN-Cluster 核心设计哲学:AM = Driver 🔥
这是 YARN-Cluster 与 YARN-Client 最本质的区别。
2.1 AM 角色的反转
| 模式 | AM 的角色 | 是否包含 Driver |
|---|---|---|
| YARN-Client | ExecutorLauncher(轻量代理) | ❌ Driver 在客户端 |
| YARN-Cluster | 完整 Driver | ✅ SparkContext + DAGScheduler 全在 AM 中 |
// 源码:ApplicationMaster.scala - 关键分支
def run(): Unit = {
  if (isClusterMode) {
    runDriver()           // 🔥 YARN-Cluster:AM 启动完整 Driver
  } else {
    runExecutorLauncher() // YARN-Client:AM 仅负责申请资源
  }
}
2.2 整体架构图
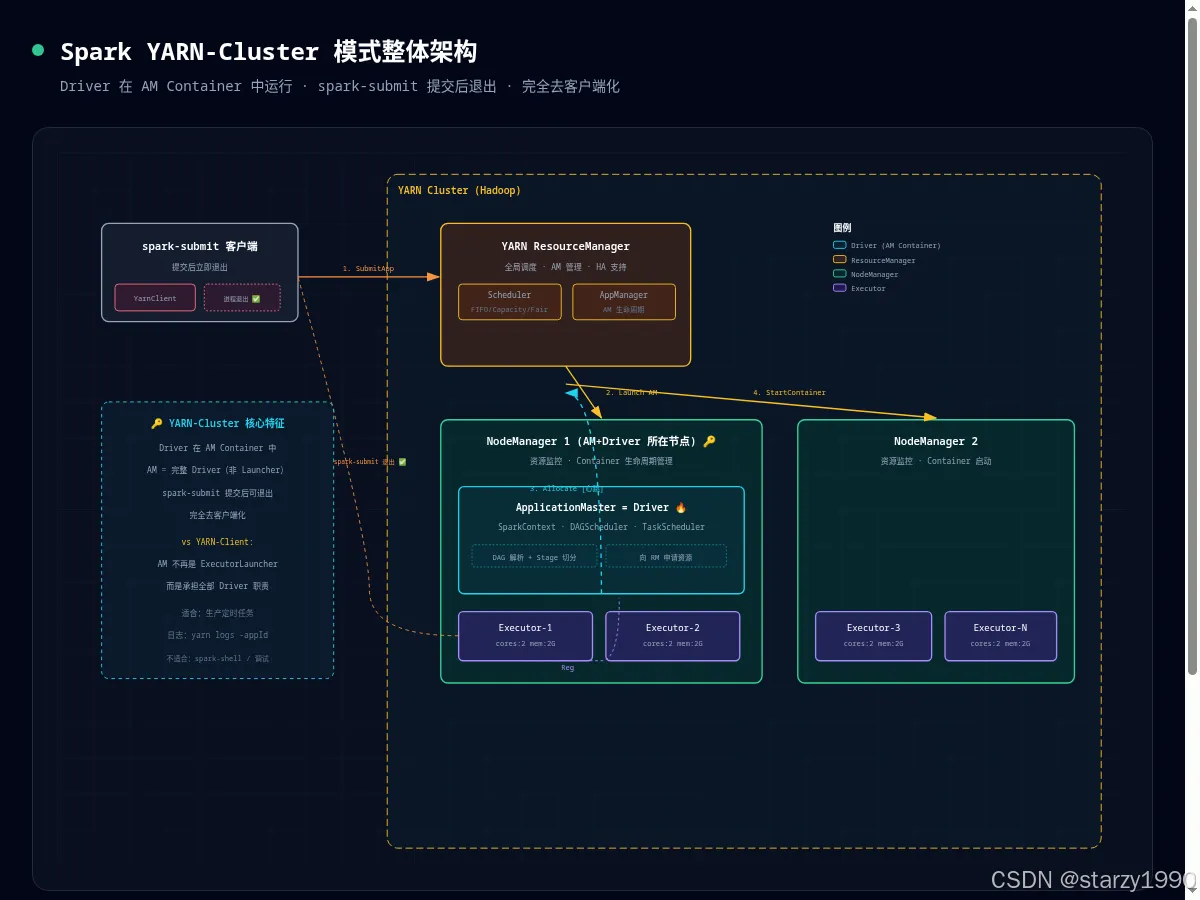
三条核心设计原则:
AM Container 就是 Driver:SparkContext、DAGScheduler、TaskScheduler、SchedulerBackend 全部运行在 YARN Container 中,享有 Container 级别的资源隔离。
spark-submit 是"甩手掌柜":提交完应用、确认 RM 收到后即可退出。后续一切由 AM(Driver) 自主管理。
全生命周期由 YARN 托管:Driver 故障 → RM 自动检测 → 可配置 AM 重试(
yarn.resourcemanager.am.max-attempts)。
三、YARN-Cluster vs YARN-Client:一张表搞清
| 对比维度 | YARN-Client | YARN-Cluster |
|---|---|---|
| Driver 位置 | 提交客户端 JVM | AM Container 内 🔑 |
| AM 角色 | ExecutorLauncher(轻量) | 完整 Driver(重量) |
| spark-submit | 必须全程存活 | 提交后可退出 🔑 |
| 日志查看 | 控制台 | yarn logs -applicationId <appId> |
| 适用场景 | spark-shell / 交互式 / 调试 | 生产定时任务 / 大批量作业 |
| 网络要求 | Driver ↔ Executor 互通 | 集群内部闭环 |
| Driver HA | ❌ | ✅ AM 重试机制 |
四、YARN-Cluster 启动流程:12 步完整拆解 🔥

4.1 Phase 1-2:提交与 AM(Driver) 启动
Step 1-3: spark-submit → RM: SubmitApplication → RM 分配 appId → RM Scheduler 分配 AM Container → NM 分配资源并 fork AM JVM。
spark-submit \
  --master yarn \
  --deploy-mode cluster \      # 🔑 Cluster 模式
  --executor-memory 4G \
  --num-executors 8 \
  --conf spark.yarn.maxAppAttempts=2 \
  my-app.jar
# ← 提交完成后 spark-submit 可退出
Step 4: AM 启动时调用 runDriver()(而非 runExecutorLauncher()),在 Container 内初始化 SparkContext:
// ApplicationMaster.scala - runDriver()
private def runDriver(): Unit = {
  // 1. 在 AM Container 内启动用户 main 方法
  val mainMethod = userClassLoader.loadClass(args.mainClass)
                       .getMethod("main", classOf[Array[String]])
  // 2. 用户代码中的 new SparkContext() 将在 AM 中初始化
  // 3. 初始化完毕后,AM = 完整 Driver
  mainMethod.invoke(null, userArgs)
}
4.2 Phase 3-4:AM 心跳循环 + 启动 Executor
Step 5-6: AM 向 RM 发送 RegisterApplicationMaster → 进入心跳循环 allocate()/allocateResponse() → RM 分批返回 Container → AM 通过 NM 启动 Executor。
与 YARN-Client 的关键区别:AM(Driver) 直接知道 Executor 的分配情况,反向注册流程在集群内部闭环,无需经过客户端。
4.3 Phase 5-6:反向注册 → 任务执行 → 结束
Executor → AM(Driver): RegisterExecutor → Driver 确认 → LaunchTask → StatusUpdate → 应用结束 → KillExecutors → FinishApplicationMaster → RM 回收全部 Container。
五、四大部署模式终极对比 🏆
| 维度 | Standalone Client | Standalone Cluster | YARN Client | YARN Cluster |
|---|---|---|---|---|
| 资源管理 | Master | Master | RM | RM |
| 资源隔离 | ❌ | ❌ | Container | Container |
| 多租户 | ❌ | ❌ | ✅ Queue | ✅ Queue |
| Driver 位置 | 客户端 | Worker | 客户端 | AM Container |
| 去客户端化 | ❌ | ✅ | ❌ | ✅ |
| HDFS 亲和 | ❌ | ❌ | ✅ | ✅ 最优 |
| Driver HA | ❌ | supervise | ❌ | AM 重试 |
| 生产推荐 | ❌ | 小规模 | 交互式 | ⭐ 首选 |
六、生产环境最佳实践
6.1 关键配置
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --executor-memory 4G \
  --executor-cores 2 \
  --num-executors 10 \
  --driver-memory 2G \                 # AM(Driver) 内存
  --driver-cores 1 \                   # AM(Driver) 核心数
  --conf spark.yarn.am.memory=2G \     # 同上,显式指定
  --conf spark.yarn.am.cores=1 \
  --conf spark.yarn.maxAppAttempts=2 \ # AM 最大重试次数
  --conf spark.yarn.queue=production \ # 指定 YARN Queue
  --conf spark.eventLog.enabled=true \ # 日志聚合到 HDFS
  --conf spark.eventLog.dir=hdfs:///spark-logs \
  my-app.jar
6.2 常见故障排查
故障 1:AM 容器被 YARN Kill
Container [pid=xxx] is running beyond physical memory limits
解决:AM 内存 = Driver 内存 + overhead(约 10%)。增大 spark.yarn.am.memory 或在 yarn-site.xml 中调整 yarn.scheduler.maximum-allocation-mb。
故障 2:日志在哪?
# 查看应用日志
yarn logs -applicationId <appId>

# 查看 AM(Driver) 日志
yarn logs -applicationId <appId> -containerId <amContainerId>

# Web UI 查看
# http://rm-host:8088 → 应用详情 → Logs
故障 3:AM 重试次数耗尽
ApplicationMaster failed 2 times. Failing the application.
解决:增大 spark.yarn.maxAppAttempts 或排查 AM 失败根因(OOM、代码 Bug、资源不足)。
七、总结
| 要点 | 一句话总结 |
|---|---|
| AM = Driver | YARN-Cluster 的 AM 是完整 Driver,非轻量 Launcher |
| 去客户端化 | spark-submit 提交后可退出,Driver 在 YARN 中托管 |
| 资源隔离 | AM + Executor 全部在 Container 中运行 |
| 生产首选 | 唯一推荐的生产部署模式 |
| 日志 | yarn logs -applicationId <appId> |
金句:如果说 YARN-Client 的 Driver 是你手中的风筝,那么 YARN-Cluster 的 Driver 就是放飞到云端的无人机——它完全自主飞行,而你的终端早已关闭。
作者:starzy | AI Data Engineer / 大数据技术实践者
博客:blog.starzy.cn | GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践