
Kestrel(红隼):1.35 MB 单文件,在一块 RK3588 上跑通多模型推理协作平台
纯 C11 · 零第三方运行时 · ARM 边缘推理
开源协议:Apache License 2.0 | 代码仓库见文末
摘要
大模型推理常被默认为「GPU / 数据中心专属」。本文介绍我们自己做的 Kestrel(红隼):一个纯 C11、零第三方运行时依赖的 ARM(aarch64)多模型推理协作平台——单文件可执行程序仅约 1.35 MB(板端实测 1,355,096 B),在同一块 16 GB 内存的 RK3588 开发板上,同一进程内原生承载五类模型:
- 多模态 LLM:Qwen3-VL 2B / 8B(文本 + 图片 / 视频问答)
- MoE 大模型:Qwen3-30B-A3B(稀疏专家推理)
- 句子向量嵌入:Qwen3-Embedding-0.6B(语义检索 / 知识库)
- 非自回归决策:Laya(ModernBERT-large + 决策头)
- 目标检测:YOLO v5 / v8 / v11
对外提供标准 OpenAI 兼容 API 与对话 / 知识库 / 决策 / 检测 / 管理页面;计算上同时给出纯 CPU(NEON/dotprod)与自研 NPU 直驱两条路径;安全上自带国密三道防线(SM2 / SM3 / SM4)。全部数据均为 RK3588 板端实测。
一、为什么做这件事
大模型推理往往被默认为「GPU / 数据中心专属」。主流推理栈(vLLM、llama.cpp 等)要么依赖 CUDA/ROCM 与高内存服务器,要么虽可 CPU 运行,却在大模型(尤其 MoE)场景下受限于内存常驻:一个 17.66 GB 的 Qwen3-30B-A3B 权重文件,放在一台 16 GB 内存的 ARM 开发板上,几乎无法稳定服务。
而真实的边缘场景需要的往往不止「一个会聊天的模型」,而是检测、检索、决策、生成多类模型协同——它们各有各的权重格式与运行时依赖,逐一套框架部署成本极高。
Kestrel 问的问题是:能不能用一块普通 ARM 开发板(例如 RK3588 / Orange Pi 5 Plus,16 GB RAM),把多类模型统一跑起来,并且跑得又快又稳?
答案是可以,而且我们把它做到了 1.35 MB 的单文件里。
二、总体设计
1. 总体形态
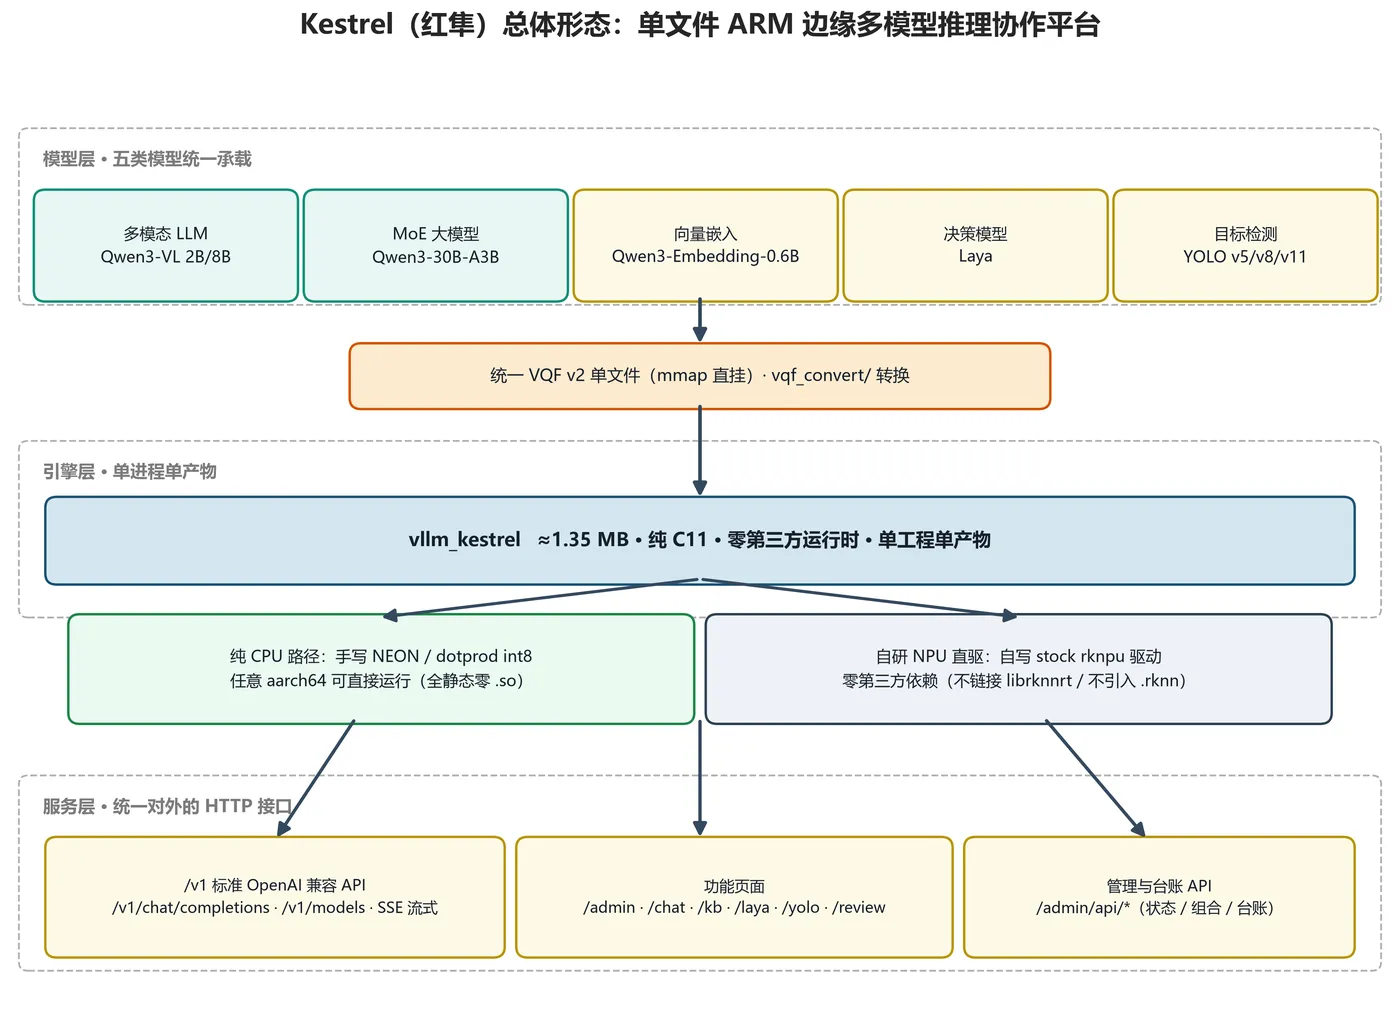
图 0:Kestrel 总体形态——五类模型经 vqf_convert/ 统一转成单文件 VQF v2,由单进程引擎承载,计算上分纯 CPU 与自研 NPU 两条路径,对外提供标准 OpenAI 兼容 API 与各功能页面。
- 单产物:
vllm_kestrel一个可执行文件即是完整 HTTP 服务,拷到任意 aarch64 Linux 即可运行; - 自研权重格式 VQF v2:safetensors / GGUF 转成单文件 VQF,mmap 直挂、按需建页;支持 SM4-CTR 存储加密与 SM2 供应链签名;
- 自研内核:手写 NEON 量化 GEMM/GEMV、自研线程池(替代 OpenMP)、自研国密 SM3/SM4/SM2;
- 零第三方运行时:不依赖 Python/PyTorch/vLLM 栈、GPU 栈、ggml/OpenBLAS、OpenSSL/GmSSL、OpenCV/FFmpeg。
2. 多模型能力矩阵:一个引擎,五类模型
Kestrel 不是单一推理引擎,而是同一进程内统一承载多类模型的平台:五类模型共用一套权重格式(VQF v2)、一套线程池与一套 HTTP 服务,业务侧只对接一套接口,即可按需自由组合调用。
| 模型族 | 形态 | 代表模型 | 用途 | 对外入口 |
|---|---|---|---|---|
| 多模态 LLM | 自回归生成(文本/图片/视频) | Qwen3-VL 2B / 8B | 图文 / 视频问答 | /v1/chat/completions、/chat |
| MoE 大模型 | 自回归生成(稀疏专家) | Qwen3-30B-A3B | 30B 级文本推理 | /v1/chat/completions |
| 句子向量嵌入 | 非生成(last-token + L2 归一化) | Qwen3-Embedding-0.6B | 语义检索 / 知识库 | /kb、/admin/api/kb/* |
| 非自回归决策 | 非生成(决策头输出) | Laya(ModernBERT-large) | 决策 / 分类 | /laya、/admin/laya |
| 目标检测 | 非生成(卷积前向) | YOLO v5 / v8 / v11 | 目标检测 | /yolo、/admin/yolo |
接入即全栈适配:引擎有三条红线——自研 VQF 格式(不引入 ONNX /
.rknn作载体)、零第三方依赖(不链接librknnrt、不依赖 torch/ultralytics 运行时)、板端优先。「适配一个模型」不是调库,而是从权重解析器到 NEON/dotprod 内核的全栈工程(例如向量模型需把引擎分词器从贪心最长前缀改造为 byte-level BPE)。
3. 双计算路径:纯 CPU 与自研 NPU
同一套模型,引擎给出两条可选计算路径,可实测对比后择优:
| 路径 | 实现 | 特点 |
|---|---|---|
| 纯 CPU | 手写 NEON / dotprod int8 内核 | 全静态零 .so,任意 aarch64 可直接运行;无提交开销 |
| 自研 NPU 直驱 | 自写 stock rknpu 内核驱动交互 | 零第三方依赖,仅走系统内核公共 UAPI |
反直觉实测:YOLO 检测上,我们自己的 CPU 路径(约 142 ms)反超我们自己的 NPU 路径(约 232 ms)——因为 NPU 路径需 im2col + 371 次提交/回读,而 CPU dotprod 把全部算力压在 4×A76 上、没有提交开销。平台同时提供两条路径,正是为了按模型实测择优。
4. 统一对外的标准 OpenAI 兼容 API
引擎自带标准 OpenAI 兼容接口,现有 OpenAI 生态(官方 SDK / LangChain / 各类前端)可直接接入,无需改代码:
POST /v1/chat/completions——兼容请求 / 响应格式,支持 SSE 流式输出;GET /v1/models——模型列表(--model-id为对外标识);- 自研
select轮询 HTTP + SSE 与最小 JSON 解析,不引入任何 Web 框架。
5. 核心能力模块
| 模块 | 能力 |
|---|---|
| 纯自研权重格式 VQF v2 | 单文件 mmap 直挂、按需建页,冷启动约 2 s |
| 逐层推理(分层驻留) | 权重常驻与模型体积/层数解耦,算完即 MADV_DONTNEED |
| KV v2 惰性分配 + L3 分层驻留 | 长上下文 + 多轮前缀复用 |
| 稀疏注意力长度门控 | decode / prefill 双轴长度门控,长上下文显著加速 |
| MoE 加速 | 路由 + 逐专家 FFN、批式专家处理、激活 int8 近似轨 |
| 可验证推理 attestation | SM2 签名护权重 + 逐请求出证 |
| NPU 直驱(可选) | 自研写 stock rknpu 内核驱动,零第三方依赖 |
| 分布式专家并行 EP(可选) | MoE 专家分片跨机协同,仅限可信网络 |
| 自研 FHE 密文推理链 | RNS-CKKS 密文推理内核,层链驱动已跑通 |
三、关键实测数据(全部为 RK3588 板端实测)
测点口径(诚实声明):测点平台 RK3588(Orange Pi 5 Plus,15.9 GB RAM,governor=performance,全程无降频)。性能数据分三类——受控 A/B(可复现到 1%)、serve 新测点(单次非受控)、跨引擎对照(与 llama.cpp 权重公平 A/B),三类不可混引。原始产物、复现脚本均在仓库。
1. 逐层推理:让「放不下」的大模型放得下
VLLM_VQF_STREAM=1 让每层权重只在参与计算时建立文件页,算完立即 MADV_DONTNEED,仅 keep 层常驻。权重常驻内存不再随模型体积线性增长,且输出逐位一致。
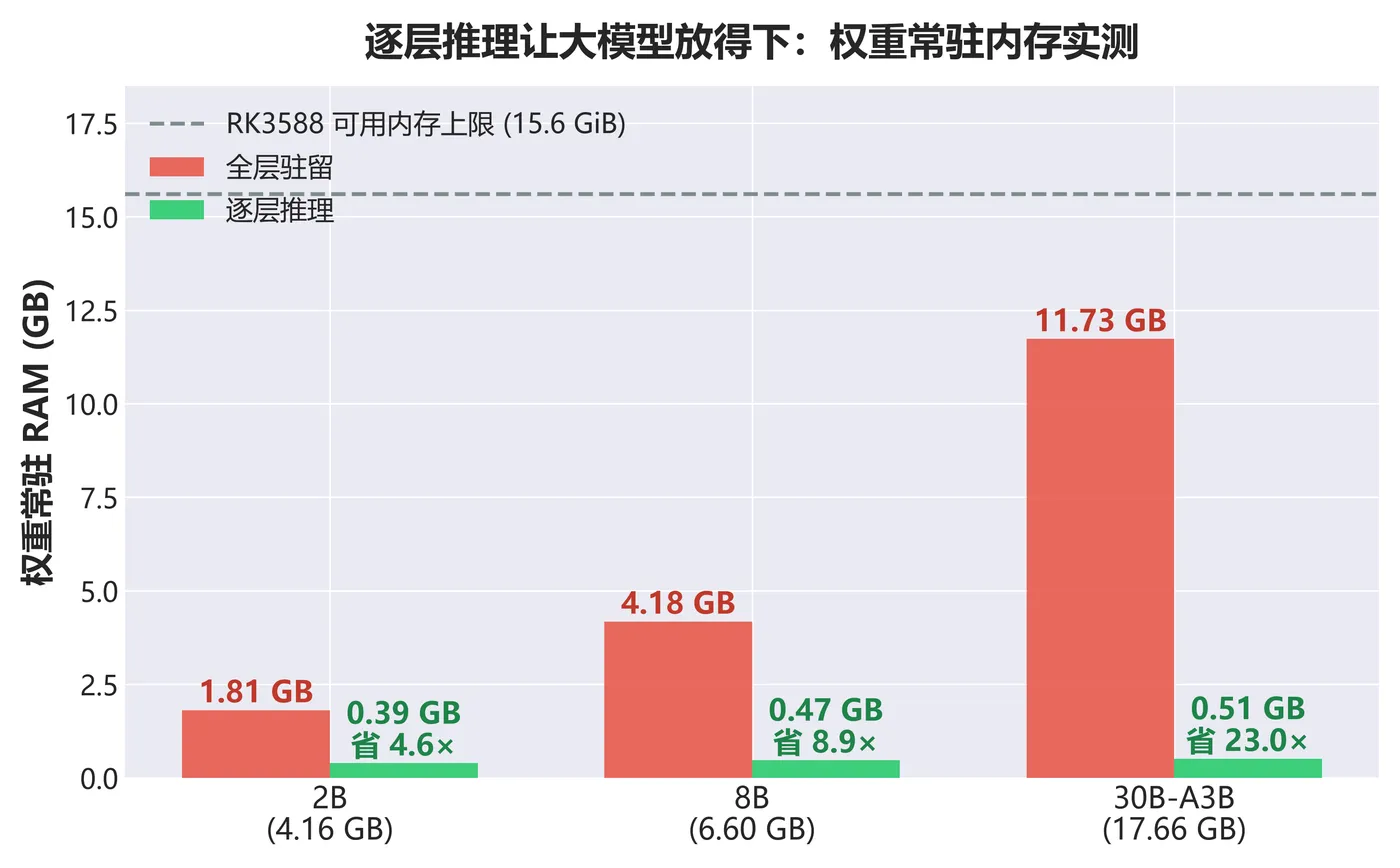
图 1:逐层推理把权重常驻内存与模型体积解耦,30B-A3B 常驻从 11.73 GB 压到 0.51 GB(省 23.2 倍)。
| 模型(单文件 VQF) | 全层:权重常驻 / 峰值 | 逐层:权重常驻 / 峰值 | 常驻内存倍率 |
|---|---|---|---|
| 2B Qwen3-VL(4.16 GB) | 1.81 GB / 2.76 GB | 0.39 GB / 0.63 GB | 4.6× |
| 8B Qwen3-VL(6.60 GB) | 4.18 GB / 4.22 GB | 0.47 GB / 0.59 GB | 8.9× |
| 30B-A3B MoE(17.66 GB) | 11.73 GB / 12.70 GB | 0.51 GB / 0.71 GB | 23.2× |
典型价值:30B-A3B 权重单文件 17.66 GB,全层档 serve 峰值高达 14.2 GB;逐层档把同一模型的 serve 峰值压到 1.11 GB,余量充足、可在 16 GB 板卡上稳定服务(板端核验实测 0.79 GB,量级一致)。
2. prefill 与 decode 实测(受控 A/B)
同一块板、同一次会话内交错、每点 2 轮;冷 = 每点前 drop_caches,热 = 不 drop 且先跑丢弃预热。
8B(Qwen3-VL-8B,q4,6.60 GB)
| 驻留 | 线程 / 缓存 | prefill | decode |
|---|---|---|---|
| 全层 | t4 / 热 | 1.594 s | 185 ms/tok |
| 全层 | t8 / 热 | 2.127 s | 468 ms/tok |
| 全层 | t8 / 冷 | 71.10 s | 470 ms/tok |
| 逐层 | t4 / 热 | 1.707 s | 320 ms/tok |
| 逐层 | t8 / 热 | 2.220 s | 581 ms/tok |
30B-A3B(MoE,q4,17.66 GB)
| 驻留 | 线程 / 缓存 | prefill | decode |
|---|---|---|---|
| 全层 | t4 / 热 | 6.67 s | 324 ms/tok |
| 全层 | t8 / 冷 | 213.70 s | 986 ms/tok |
| 逐层 | t4 / 热 | 6.93 s | 564 ms/tok |
| 逐层 | t8 / 冷 | 215.15 s | 1,387 ms/tok |
解读:8B 属带宽受限(稠密),务必
--threads 4——t8 会拉进 4 个 A55 小核,decode 反而慢约 2.5 倍;30B 属计算受限(MoE 每 token 只激活 top-8 专家),decode 收益显著。
3. 长上下文与多轮追问:prefill 最高省 96%
组合①(L3 驱逐 × 前缀复用)下,多轮追问轮 prefill −80% ~ −96%;30B 再叠 MoE 组合后,追问轮 prefill 仅 3.2~5.3 s(相对基线 −99.3%)。
4. 与 llama.cpp 的权重公平 A/B
同一块板、同一份 4-bit 权重、各自开各自优化。
decode 速度(token/s,越大越好)
| 档 | llama.cpp Q4_0 | 本版逐层 | 本版全层 | 领先 |
|---|---|---|---|---|
| 2K | 2.61 | 2.28 | 2.79 | 全层 1.07× |
| 4K | 1.50 | 2.16 | 2.54 | 1.69× / 1.44× |
| 8K | 0.94 | 1.94 | 2.27 | 2.41× / 2.02× |
| 16K | 0.48 | 1.42 | 1.74 | 2.96× / 3.63× |
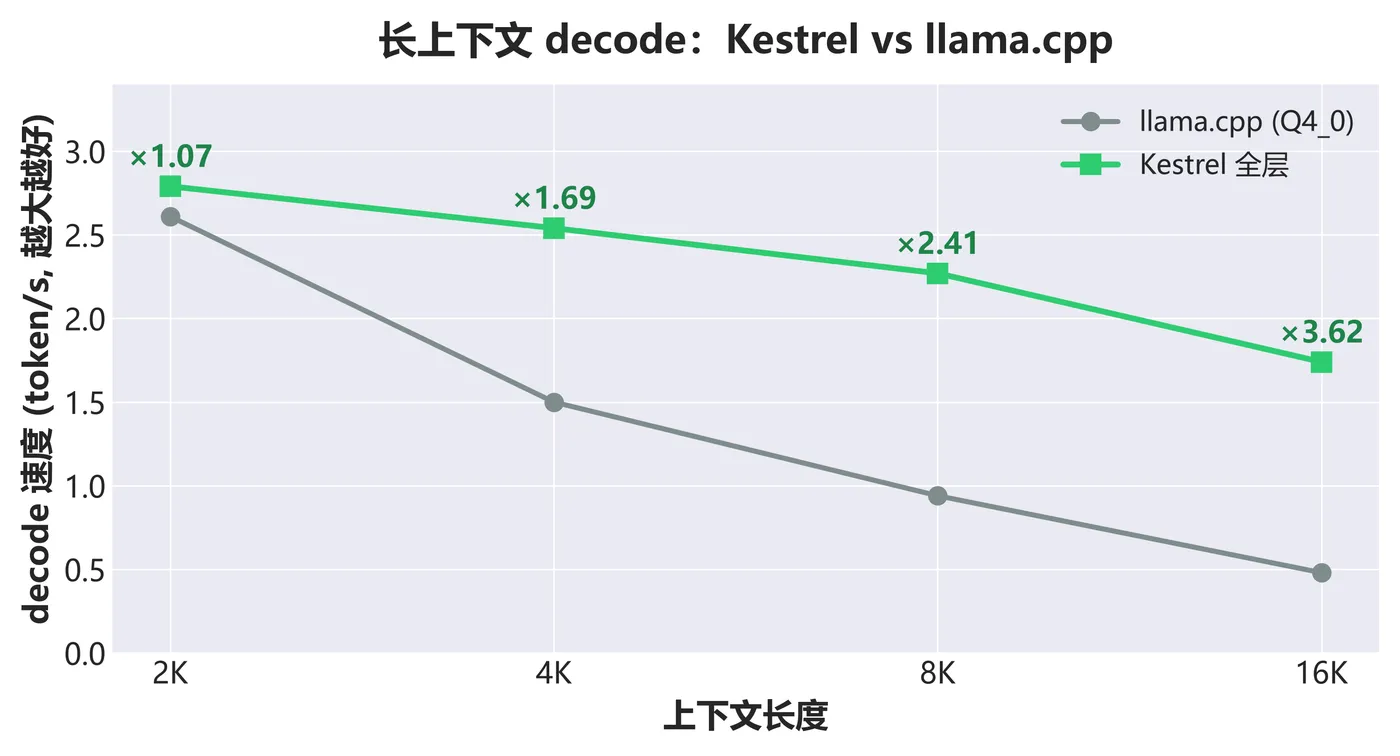
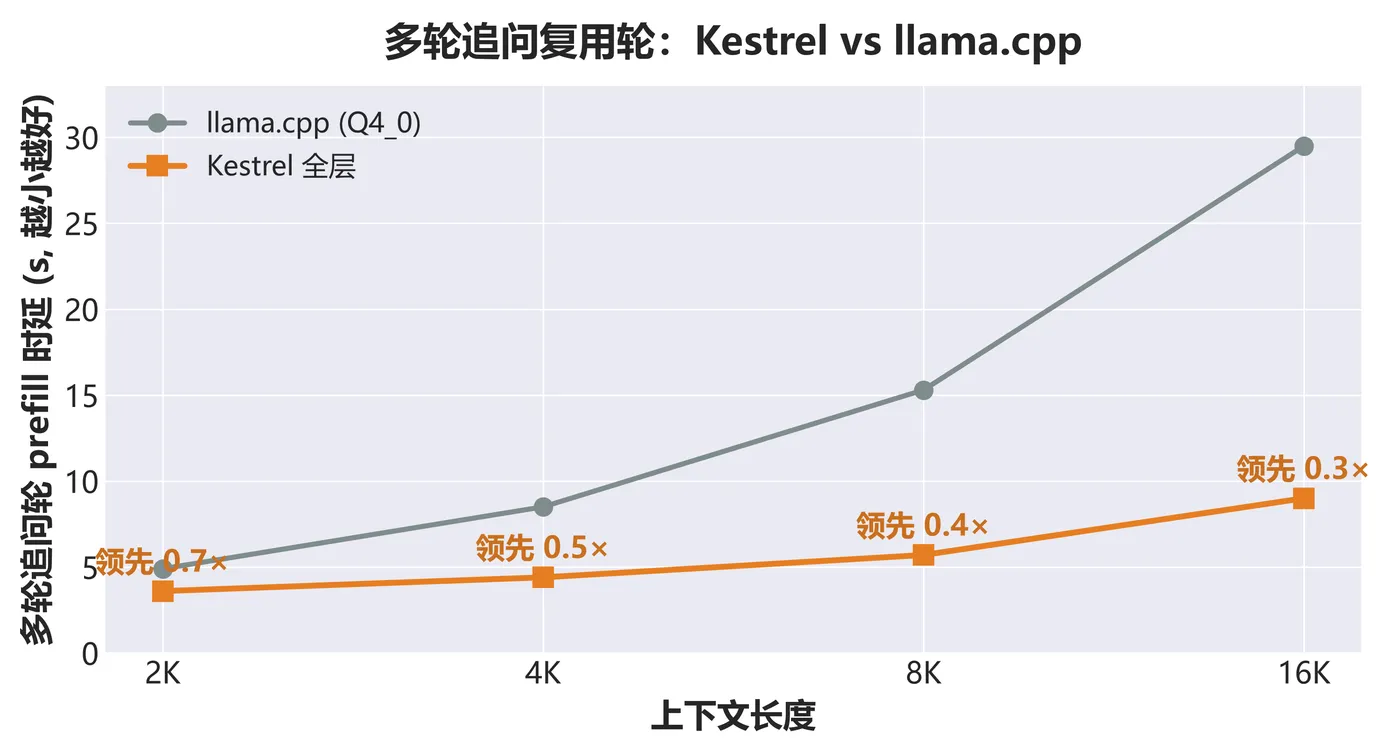
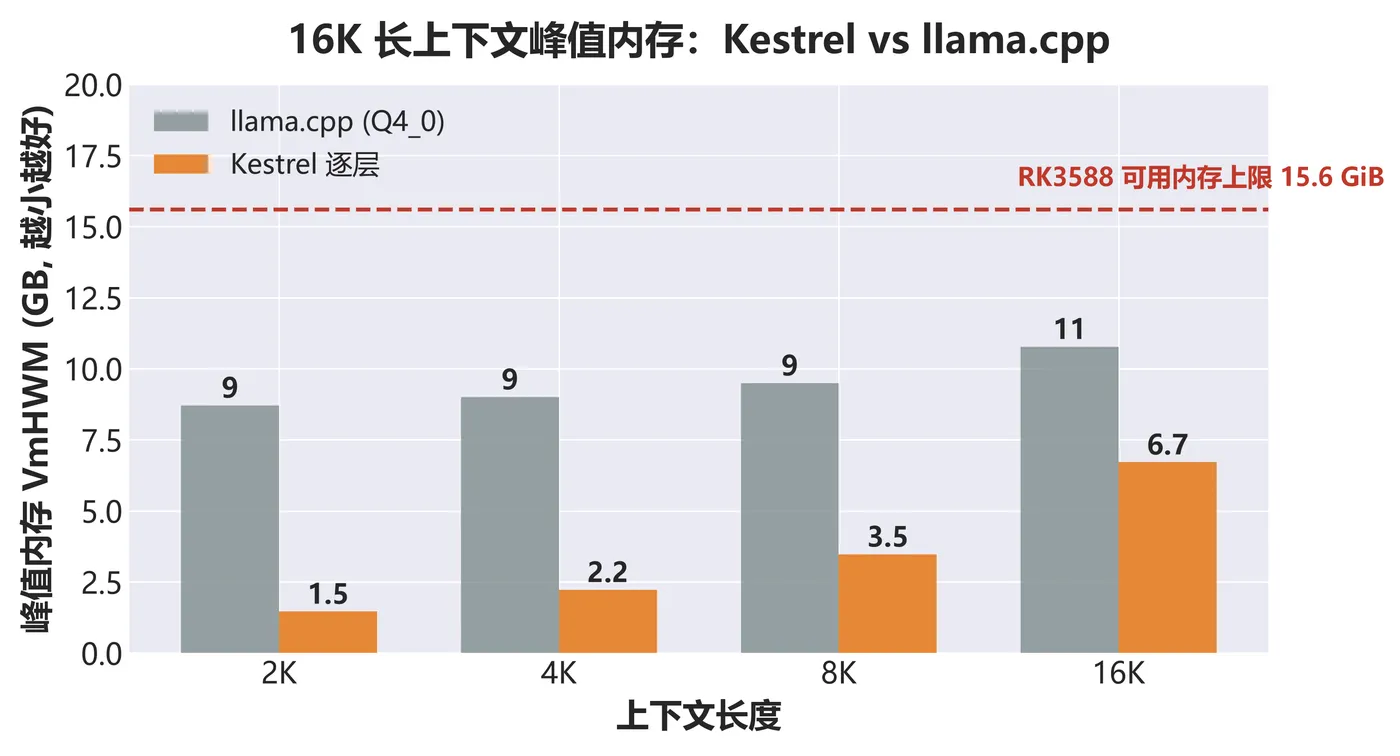
图 2/3/4:decode 随上下文领先单调放大,16K 全层达 3.63 倍;多轮追问复用轮 16K 领先 3.2~3.4 倍;16K 峰值内存 6.71 GB vs 10.77 GB。
本项目是唯一在 16 GB ARM 开发板上把 16K 长上下文 30B MoE 跑出可用性的对比口径;llama.cpp 在本板无同等的逐层/L3 复用手段。
5. 多模型适配与优化:向量嵌入 / Laya / YOLO
除 LLM 外,平台把向量检索、非自回归决策、目标检测三类模型也从官方权重一路适配到可用(口径:governor=performance + 4×A76 绑核 + warmup 后取中位):
| 模型 | 形态 | 适配 / 优化结果 | 质量门 |
|---|---|---|---|
| Qwen3-Embedding-0.6B | 句子向量 | byte-level BPE 分词;prefill 位级不变 | 分词 20/20 位级;E2E 余弦 0.994~0.997;检索 3/3 |
| Laya(ModernBERT-large + 决策头) | 非自回归决策 | 短 state 3 问 58.0 s → 0.963 s(60.2×);RSS 1.66 → 0.47 GB | 决策 96/96 与 F16 golden 一致 |
| YOLO(v5 / v8 / v11) | 目标检测 | 混合模式(官方 RKNN 前向 + 自研 decode/NMS)最快,板端实测 43 ms/图;自研 CPU int8 dotprod 142 ms;自研 NPU 直驱 431 ms | 三模式检出集 5/5 一致 |
YOLO 四模式实测:一个「反直觉」的诚实结论
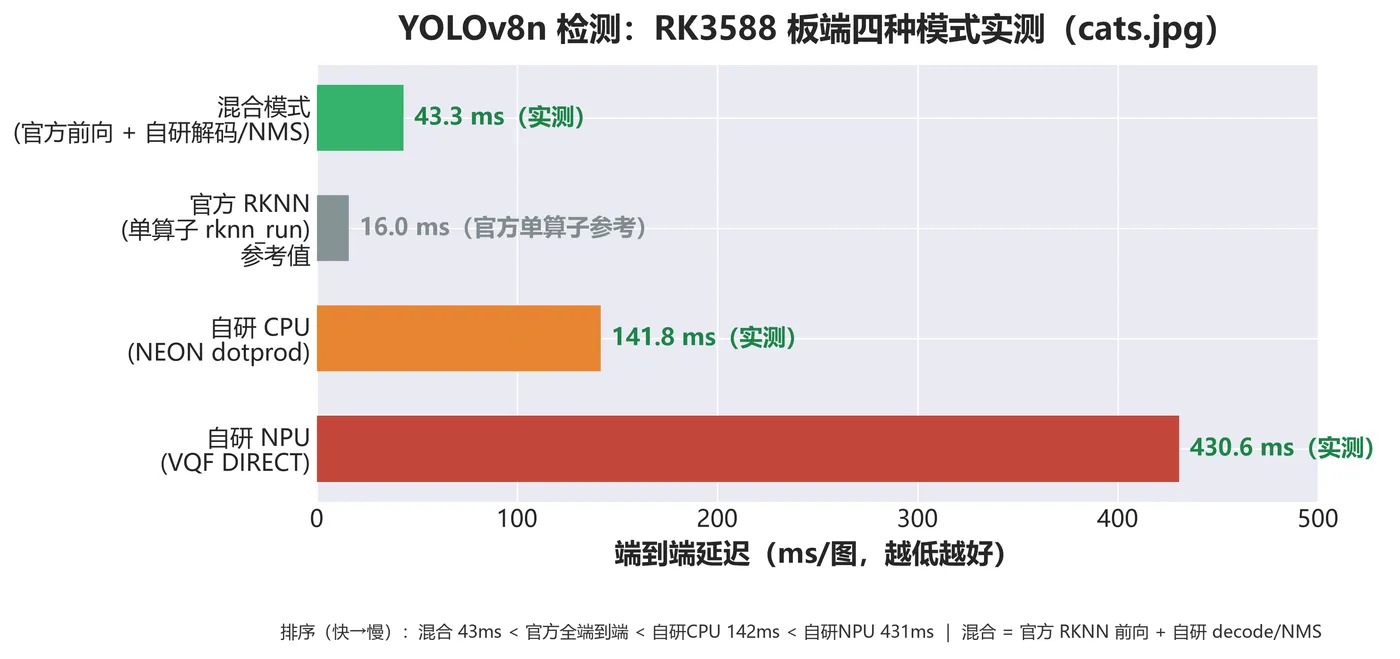
图 5a:YOLOv8n 检测在 RK3588 板端四种模式的端到端实测(cats.jpg,serve 墙钟中位)。混合模式(官方前向 + 自研解码/NMS)最快 43 ms;自研 CPU 142 ms;自研 NPU 431 ms;官方单算子 rknn_run 16 ms 为参考。
纠偏(诚实口径):早期图把「自研 NPU ≥5×」画成一路向上的收益条,易误导。实测自研路径并未超过官方——自研 NPU(寄存器驱动未标定真卷积)反而最慢(431 ms),自研 CPU(NEON dotprod)居中(142 ms),最优是「官方 RKNN 前向 + 自研 decode/NMS」的混合模式(43 ms)。工程上取长补短:用官方算力做卷积、用自研做灵活的检测后处理。
Laya:非自回归决策优化进程
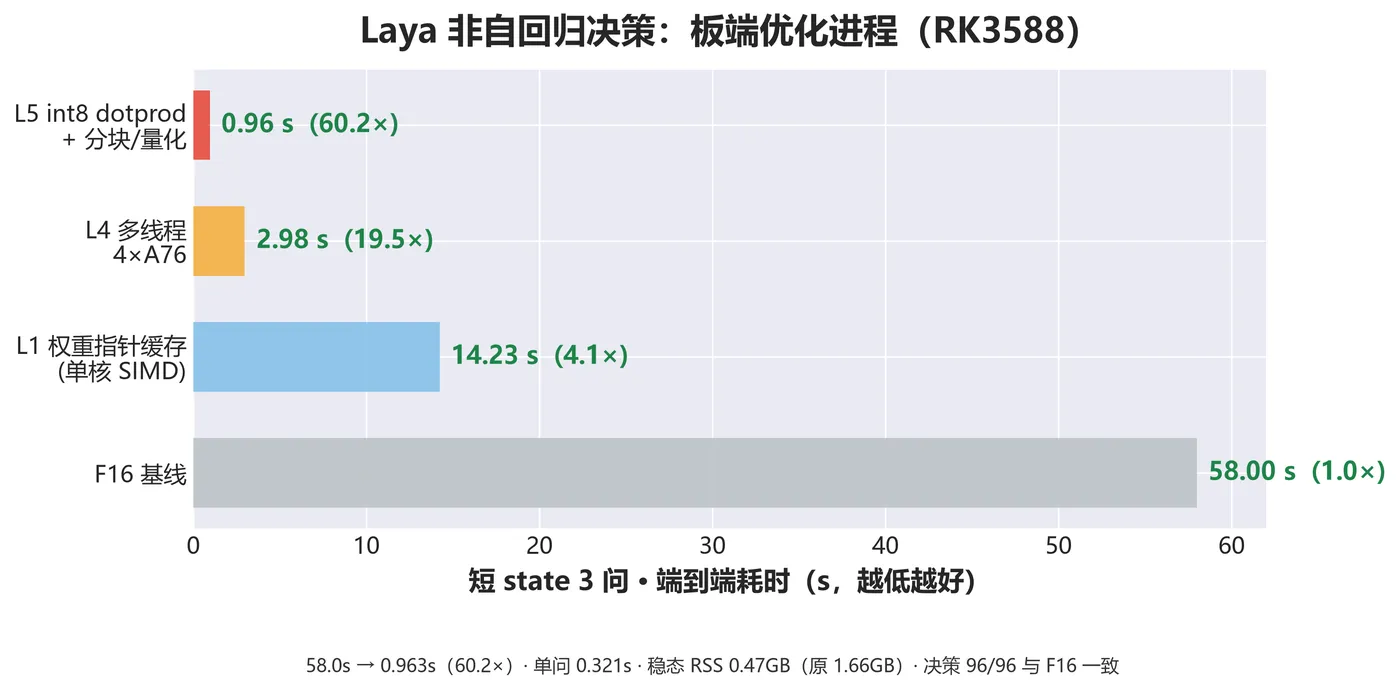
图 5b:Laya 非自回归决策在板端的优化进程——短 state 3 问 58.0 s → 0.963 s(60.2×),单问 0.321 s;RSS 1.66 → 0.47 GB。
向量模型:prefill 线程扩展
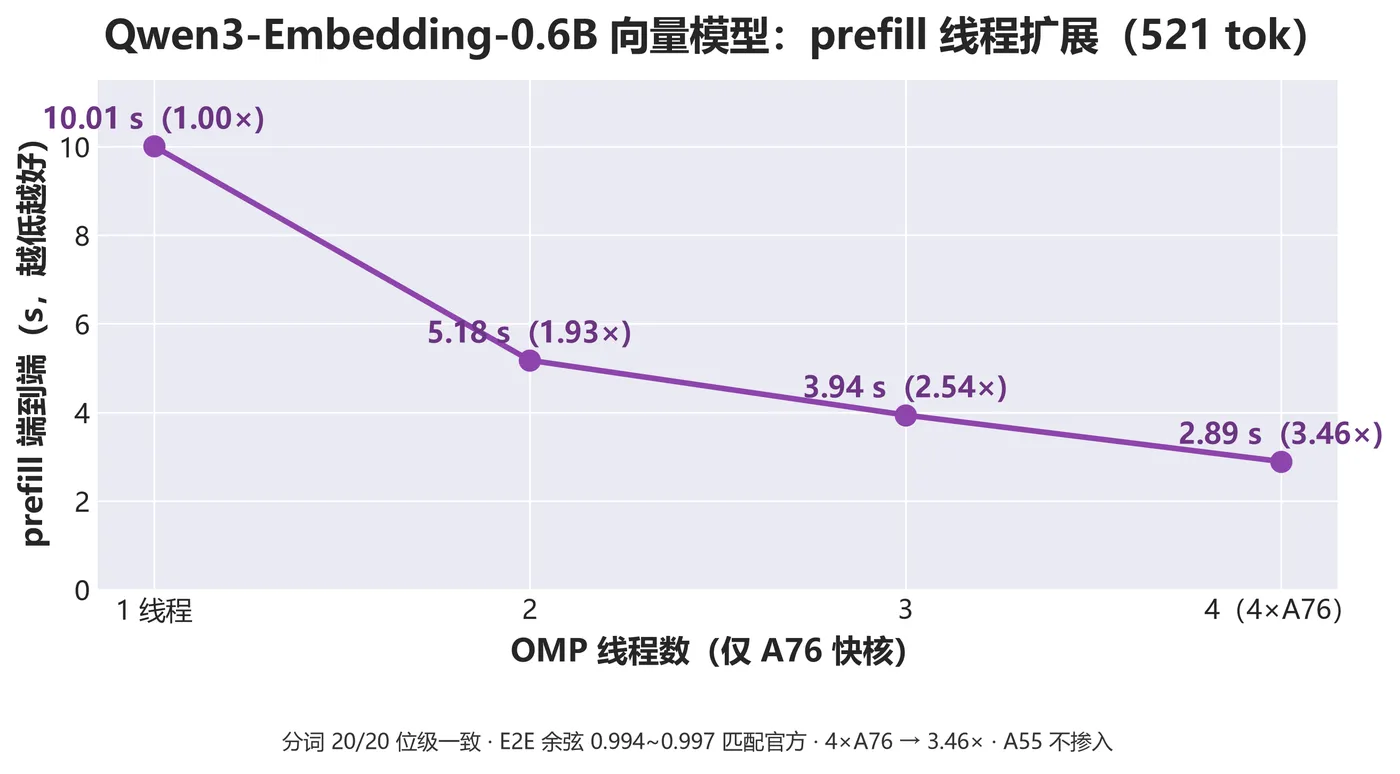
图 5c:Qwen3-Embedding-0.6B 向量模型 prefill 线程扩展(521 tok)——OMP 1→4 线程 10.0 s → 2.89 s(3.46×),A55 不掺入;分词位级一致 20/20、E2E 余弦 0.994~0.997 匹配官方。
统一联合接口(/v1/ask 单入口编排)
五个模型不是「五个孤立端点」,而是由一个统一编排器按请求特征自动路由,对外只暴露一套接口:
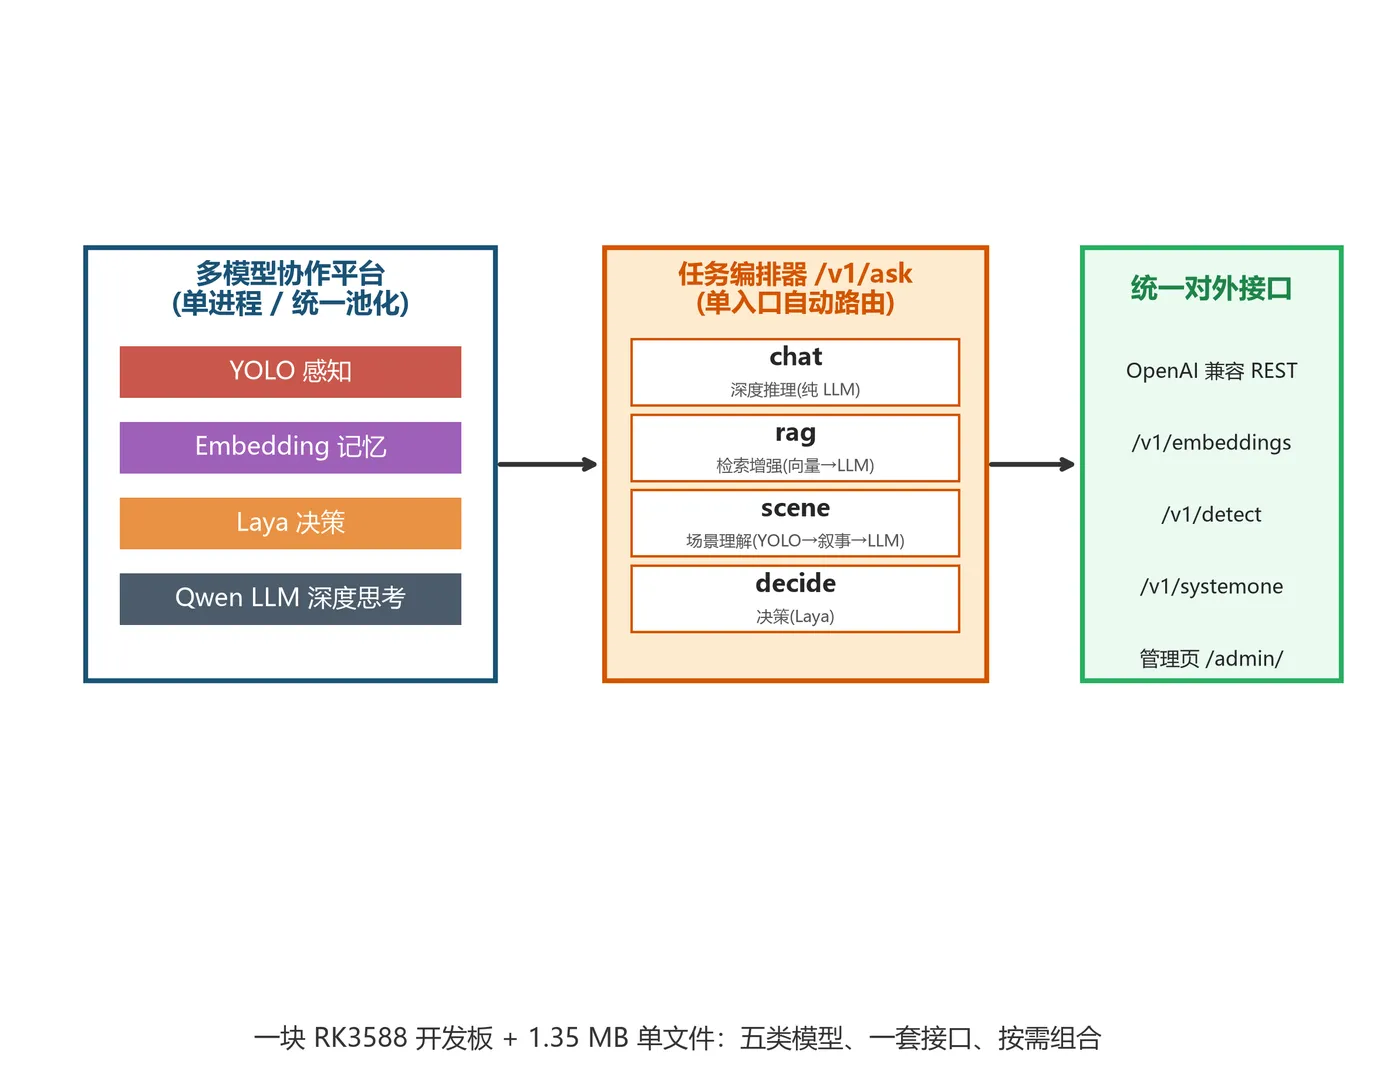
图 5d:统一联合接口——五类模型经单进程承载,POST /v1/ask 按显式字段自动路由到 chat / rag / scene / decide 四条链,对外统一 OpenAI 兼容 REST + 各页面。
一条请求即可按需组合模型;路由只认显式字段、不做语义猜测,失败显式报错(绝不静默降级):
curl http://<host>:8099/v1/ask -H 'Content-Type: application/json' \
  -d '{"query":"2 + 3 = ?"}'                              # route=chat   深度推理(纯 LLM)
curl ... -d '{"query":"...","kb_dir":"/kb/a.vkb","top_k":3}'   # route=rag    检索增强(向量→LLM)
curl ... -d '{"image":"data:image/jpeg;base64,...","query":"图里有什么?"}'  # route=scene 场景理解(YOLO→叙事→LLM)
curl ... -d '{"state":"...","questions":{...}}'           # route=decide 决策(Laya)
J5 实测路由开销 ≈0.2 ms(≈0%);各链错误码原样透传,坏 kb_dir → 404、坏图 → 400、空 body → 400,均显式可辨。
6. 纯自研的「小而全」:约 1.35 MB 装下全套能力
一个可执行文件 ≈1.35 MB(动态构建,板端实测 1,355,096 B,含内嵌管理/对话/检测页面;全静态构建略大,ldd 零 .so 依赖),28 个 C 文件、C11、单工程单产物,同时具备五类模型推理、标准 OpenAI 兼容 HTTP 服务、自研线程池、自研国密安全栈、可验证推理出证等能力。
四、自研国密安全栈:三道防线
Kestrel 全链路国密(SM2 / SM3 / SM4),纯 C11 零外部依赖、无内联汇编;位级正确性由国密标准 KAT 向量(GB/T 32905-2016 SM3、GB/T 32907-2016 SM4、GM/T 0003-2012 SM2)逐字节验证。围绕「权重资产 / 模型来源 / 推理输出」三类威胁,设三道独立防线:
| 资产 | 威胁 | 防线 | 机制 |
|---|---|---|---|
| 权重文件(拷走 / 拔卡 / dump eMMC) | 离线破解 | A. 存储态加密 | SM4-CTR 密文落盘 + HMAC-SM3 防篡改 |
| 模型(被替换 / 投毒 / 掉包) | 伪模型以假乱真 | B. 供应链签名 | SM2 对权重明文摘要签名,公钥验签 |
| 推理输出(记录被改 / 出处伪造 / 抵赖) | 归档不可信 | C. 推理出证 | SM3 转录摘要 + SM2 设备签名,逐请求发凭证 |
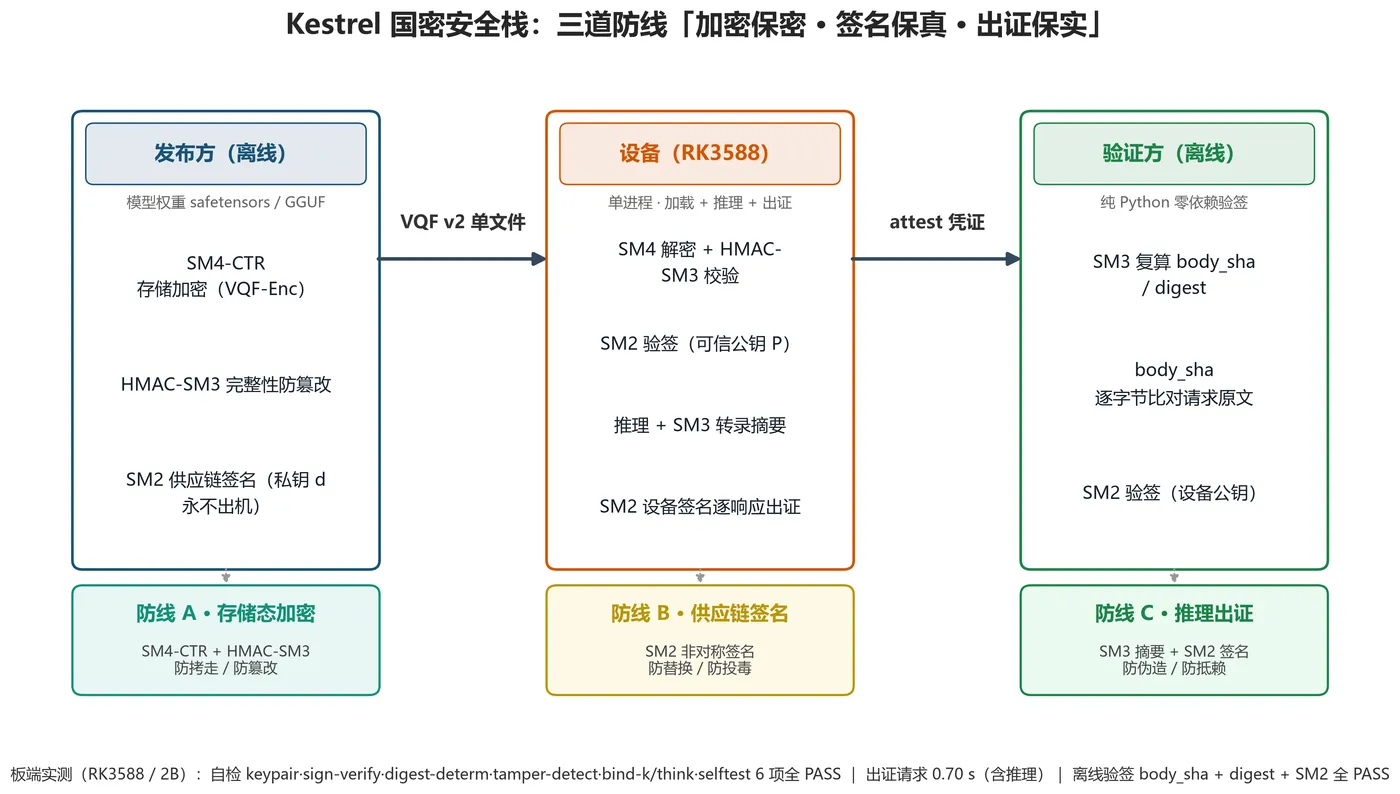
图 6:Kestrel 国密安全栈三道防线——发布方离线「加密 + 签名」、设备「解密 + 验签 + 出证」、验证方离线「复算 + 验签」。加密保密、签名保真、出证保实,三者层次不同、互不替代。
板端实测(RK3588 / Qwen3-VL-2B,2026-10-15):
| 测点 | 结果 |
|---|---|
| 引擎体积 | 1,355,096 B(1.35 MB) |
| 密码学自检(KAT) | keypair / sign-verify / digest-determ / tamper-detect / bind-k/think / selftest 6 项全 PASS |
| 出证端到端 | 单请求 0.70 s(含推理 + SM2 出证),凭证含 model_fp / body_sha / digest / signature |
| 离线验签 | body_sha 复算 + digest 复算 + SM2 验签全 PASS(纯 Python 零依赖,篡改任一字节即 FAIL) |
三道防线正交、独立开关、默认全关,失守任一不自动连坐其余;诚实边界:加密为「存储态 + 加载解密」(非密态计算);出证证明「记录完整 + 来源真实」,不证明「结论正确」。
五、应用场景
- 边缘 / 离线大模型推理:无网、无 GPU 的工业现场、车载、机务、驿站等,本地跑开源模型;
- 硬约束下的数据主权:矿场、政务、医疗等对数据不出域 / 模型不出域要求极高的场景,配合自研国密加密与可验证推理,实现「模型本地跑、推理可举证」;
- 资源受限的大模型部署:单张 16 GB 开发板即可承载 30B-MoE / 16K 长上下文服务,极大降低大模型的硬件门槛与部署成本;
- 多模型协作的边缘 AI:在同一块板上按需组合调用 YOLO 目标检测、向量检索、决策 / 文本生成等多类模型,构建视觉质检、安防巡检、智能终端等端到端应用;标准 OpenAI 兼容 API 让既有业务系统零改动接入;
- 教育 / 科研 / 开发者工具:完整教程、Wiki 与复现脚本,适合做边缘 AI 实验平台与教学载体。
六、开源与代码
| 项 | 内容 |
|---|---|
| 开源协议 | Apache License 2.0(SPDX:Apache-2.0,含明示专利授权) |
| 代码仓库 | Gitee 主仓库:https://gitee.com/pei-xiaoguang/kestrel-llm(GitHub 镜像同名项目) |
| 代码规模 | 约 28 个 C 文件,C11,单工程单产物 |
| 第三方组件 | 仅 stb_image.h(MIT)与 llama.cpp 派生 4x4 asm 内核(MIT),均与 Apache-2.0 兼容 |
| 文档 | docs/(技术文档 / 性能基准报告 / 方案书)+ Wiki 导航页 |
| 复现 | 关键结论均附板端脚本、原始归档与一键复现入口(sh tools/bench/bench_value.sh),坚持「先冻结判据、再看数据」的测量纪律 |
围绕引擎开发,我们已在 CSDN 博客(https://blog.csdn.net/weixin_55790517)发布 150 篇系列教程文章,覆盖 CUDA、MCU、同态加密推理、ARM 等专栏,其中包含向量嵌入 / Laya 决策 / YOLO 检测三类模型「适配 + 优化」的完整教程(原理 + 实测数据 + 复现路径)。
结语
Kestrel 的核心主张很简单:边缘多模型推理不必是「GPU 专属」,也不该是「一堆框架的拼盘」。 一个 1.35 MB 的单文件、一套接口、五类模型、双计算路径、三道国密防线——全部数据板端实测、负结果与正结果同等登记。欢迎对边缘 AI、ARM 推理、国密安全、开源协作感兴趣的朋友一起参与共建。
- 研究方向合作 / 复现数据 / 交流:398152090@qq.com;Gitee 站内私信作者亦可。

