
导读:Apache Doris 5.0 多模湖仓预告(7)|技术解析篇:随着自动驾驶等多模态应用的发展,大规模数据查询需要同时满足向量检索、条件过滤和业务分析需求。Apache Doris 集成 Lance,支持直接查询 Lance 数据集,并通过并行检索、提前过滤、按需读列和缓存优化提升查询效率。本轮测试中,在 10 亿规模智能驾驶数据的四条件向量检索场景下,Doris + Lance 用时 2.32 秒,相比 Ray + pylance 提升约 10.87 倍。本文将介绍 Doris 与 Lance 的集成机制、查询能力及性能表现。
作者:李文强,SelectDB 多模湖仓负责人
在智能驾驶、多模态搜索等场景中,数据规模正在快速增长。一条查询往往不只是“找最相似的几个样本”,还需要同时满足车型、时间、设备、区域等业务条件,并进一步完成关联、统计和分析。
这类查询对传统向量检索方案提出了新的挑战。很多方案通常把向量搜索作为独立服务:应用先调用检索系统得到结果,再把结果交给数据库或分析引擎继续处理。随着数据规模扩大,数据搬运、结果拼接和多套系统之间的协同都会增加额外开销。
Doris 与 Lance 的结合提供了一种不同方式:让 Lance 负责多模态数据存储和向量、全文索引,让 Doris 负责查询规划、分布式执行以及后续 SQL 分析。用户可以直接查询已有 Lance 数据集,在一次 SQL 中完成条件过滤、向量检索、关联、聚合和排序。
为了验证这种方式在大规模场景下的效果,本文使用真实智能驾驶数据进行了测试。在 10 亿规模数据上执行“向量检索+四条件过滤”查询时,Doris + Lance 用时 2.32 秒,Ray + pylance 用时 25.228 秒,后者耗时约为前者的 10.87 倍。测试条件为 Top-K 20,000、召回率 95%、开启缓存、无并发。(完整测试详见后文)
要理解这些性能差异,需要先了解 Doris 如何读取 Lance 数据、如何规划检索任务,以及向量检索结果如何继续参与 SQL 查询。下面先介绍 Doris 与 Lance 的整体架构。
一、整体架构
要让 Doris 直接查询 Lance 数据,首先需要理解两者在查询链路中的职责划分,以及一次查询如何从数据读取进入 SQL 执行流程。
一个 Lance 数据集包含数据文件、数据版本信息、数据分片(Fragment)和索引。Doris 会读取这些信息,再决定如何执行查询。其中,FE 负责规划任务,BE 负责读取数据和执行检索。检索结果可以直接交给 Doris 的其他算子,继续做关联和聚合。
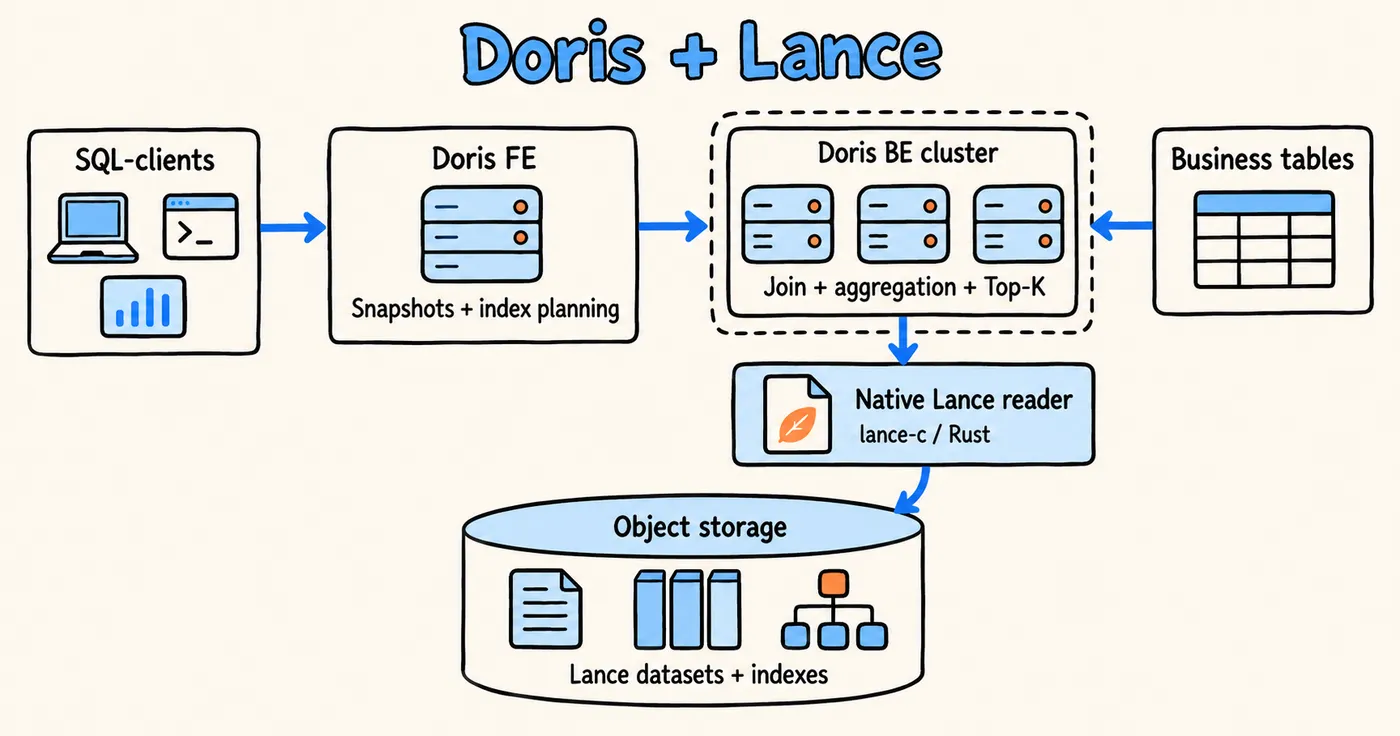
Doris 提供两种 Catalog 接入方式:Filesystem Catalog 通过目录查找数据集,REST Catalog 通过 Lance Namespace 服务查找数据集。底层数据可以放在本地文件系统、S3 兼容对象存储或 OSS 中。临时查询时,也可以使用支持 Lance 格式的文件表值函数(TVF)直接访问数据集。
Doris 通过 vector_search() 提供向量检索,通过 full_text_search() 使用 Lance 全文索引(FTS)。全文检索支持匹配任一关键词(Match OR)、全部关键词(Match AND)和短语(Phrase)。短语查询要求索引保存词的位置;默认的严格覆盖模式要求当前数据版本中的所有分片都有索引,缺少索引的分片不会自动补做 Flat Search。两种检索入口都能接入后续 SQL 分析;如果需要合并向量与文本排名,需要明确设计结果合并和打分规则。
一条查询主要经过三个步骤:
规划任务。FE 读取表结构、数据版本、分片列表和索引覆盖范围,确定列类型、需要读取的列,以及任务如何拆分。一次查询使用固定的数据版本。
执行读取。BE 通过 lance-c 调用 Lance,读取 Arrow 格式的数据,再转换成 Doris 内部使用的 Block,交给后续算子处理。
继续分析。检索结果可以用于关联(Join)、聚合、排序和分页,也可以与 Doris 内表或其他 Catalog 中的数据一起查询。
这样,检索和后续分析就可以在 SQL 中完成。应用无需先取出 Lance 的结果,再另写一套关联和统计逻辑。
二、并行检索
架构确定了查询链路后,下一步的问题是:如何让大规模数据上的向量检索充分利用集群资源。
要让多个 BE 一起检索,首先要把任务分好。如果任务划分不合理,多个任务可能重复读取同一段索引;如果任务太少,又难以充分利用多个 BE。
Doris 按 Lance 的物理索引段拆分检索任务。索引段是索引的一部分,Fragment 是数据分片,两者的划分方式不同:一个索引段可以覆盖多个 Fragment。Doris 会读取它们的对应关系,再安排扫描任务。
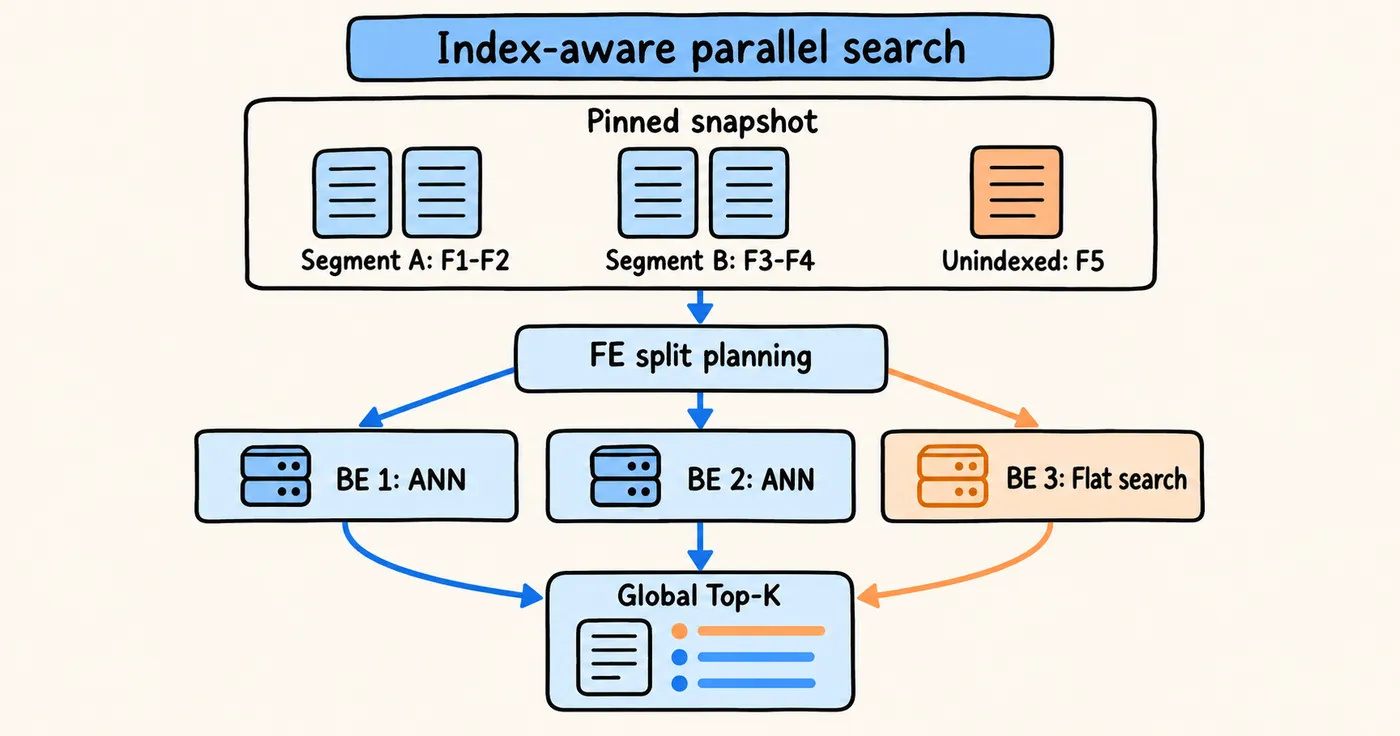
执行向量检索时,FE 先找到与查询列、距离计算方式匹配的索引,再把索引段分配给 BE 并行检索。对于当前数据版本中尚未建好索引的分片,Doris 会安排 Flat Search,也就是直接扫描数据来搜索。这部分结果也会参与最后的合并。
各个任务返回候选结果后,Doris 会统一排序,选出全局 Top-K,即候选中排名最靠前的 K 条记录。因此,已有索引的数据可以走索引检索,未被索引覆盖的数据也能参与查询。向量检索使用近似最近邻搜索(ANN)时,召回率仍取决于索引类型和搜索参数。
普通的条件查询也能利用索引。例如,部分等值、范围、IN 和数组标签匹配条件,可以使用 Lance 的 BTree、Bitmap 或 LabelList 索引。满足条件时,Doris 同样按索引段组织扫描,并扫描未被索引覆盖的数据。能否使用索引,取决于具体条件和索引类型。
索引分段会影响并行效果。分段合理,多个 BE 就能分担工作;分段过细,则会增加任务调度、索引打开和结果合并的开销。实际配置时,需要结合数据分布、BE 数量和查询并发来选择。
三、检索前过滤
并行能够提高计算资源利用率,但如果搜索范围本身过大,仍然需要处理大量无关数据。因此,对于带业务条件的向量检索,过滤发生的时机会直接影响查询效率。
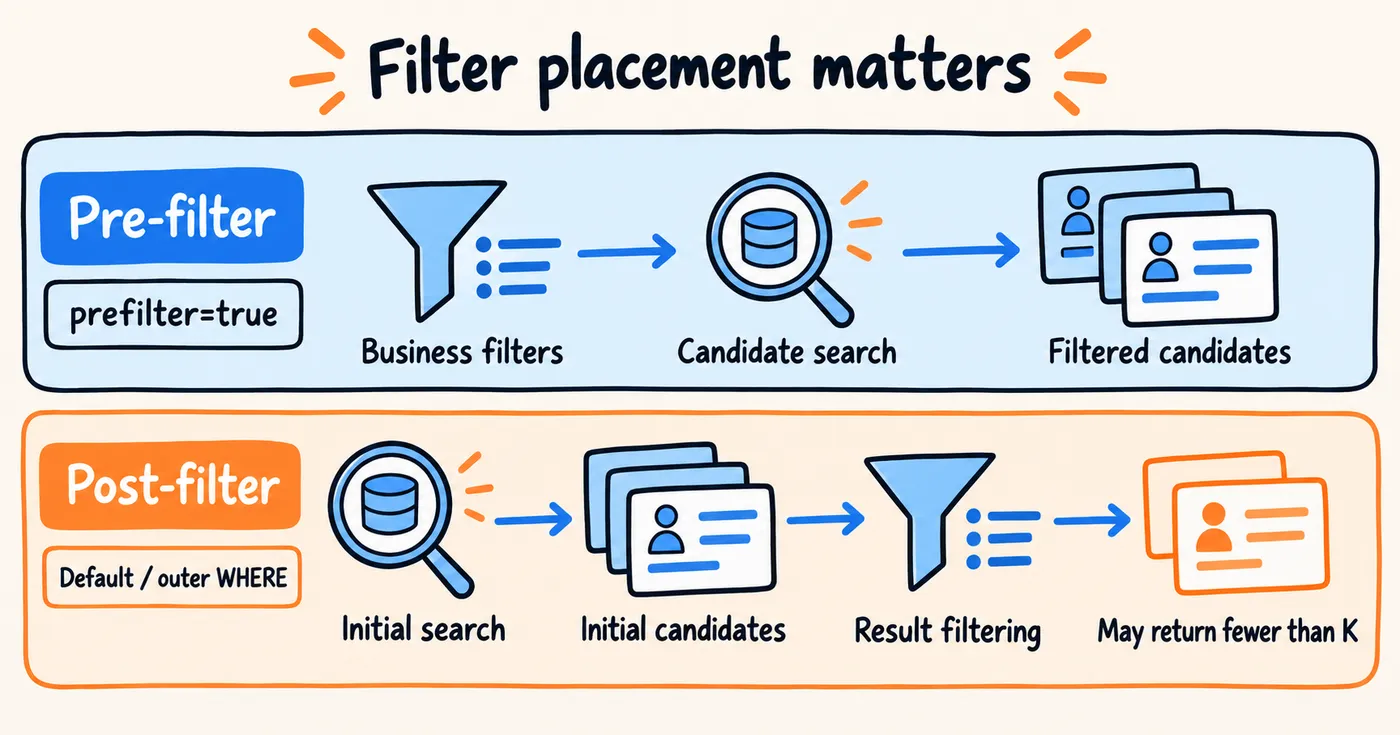
带条件的向量检索,关键在于过滤发生的时间。例如,只查某种车型时,可以先限定车型,再搜索相似记录。如果先找出相似记录、再删除车型不符的结果,就可能得不到足够多的结果。
Doris 的 vector_search() 和 full_text_search() 用 filter 指定过滤条件,用 prefilter 控制何时过滤。默认情况下,prefilter 是 false。需要先过滤再检索时,应明确设置 "prefilter"="true"。
下面的 SQL 演示如何在指定车型和区域内搜索。示例使用四维向量,返回 Top-20;后文性能测试的 Top-K 为 20,000。表名、列名和值均为演示数据,实际使用时,向量维度和距离计算方式 metric 应与数据及索引匹配。
SELECT scene_id, scene_text, resource_uri, _distance
FROM vector_search(
    "table" = "lance_demo.autodrive.scene_samples",
    "column" = "embedding",
    "query_vector" = "[0.12, 0.34, 0.56, 0.78]",
    "top_k" = "20",
    "metric" = "cosine",
    "filter" = "vehicle_type = 'sedan' AND region_code = 'zone_a'",
    "prefilter" = "true",
    "use_index" = "true"
)
ORDER BY _distance ASC, scene_id;
设置 prefilter=true 后,Lance 会先应用函数中的过滤条件,再选择检索候选。如果条件能用上标量索引,就可以通过索引缩小搜索范围;否则,仍可能需要扫描数据来判断条件。过滤能节省多少工作,取决于索引是否可用,以及能排除多少数据。
默认的 prefilter=false 会先选出候选,再应用函数中的 filter。写在函数外层的 SQL WHERE 则由 Doris 继续过滤返回结果。这两种方式都可能删掉已经找到的记录,使最终结果少于 K 条。
对于普通 Lance 扫描,Doris 也能把支持的 SQL 过滤条件交给 Lance 执行,尽早减少读取的数据。Join 过程中产生的部分 Runtime Filter(运行时过滤条件),也可以转换成 IN 或范围条件交给 Lance。这取决于条件和数据类型是否兼容;使用检索函数时,仍需通过 prefilter 明确控制过滤顺序。
四、按需读列
除了搜索范围,数据读取方式也会影响查询性能。向量检索通常只需要计算距离和排序,但最终返回结果时又需要展示大量文本和属性信息。如果这些列过早读取,会造成额外的数据访问成本。
检索结果往往还要展示文本、标签和资源路径。如果每个任务一开始就读取这些列,很多数据会在 Top-K 排序后被丢弃,白白增加读取和传输的开销。
Doris 可以把符合条件的向量检索和全文检索分成两次读取:先选结果,再补读展示列。
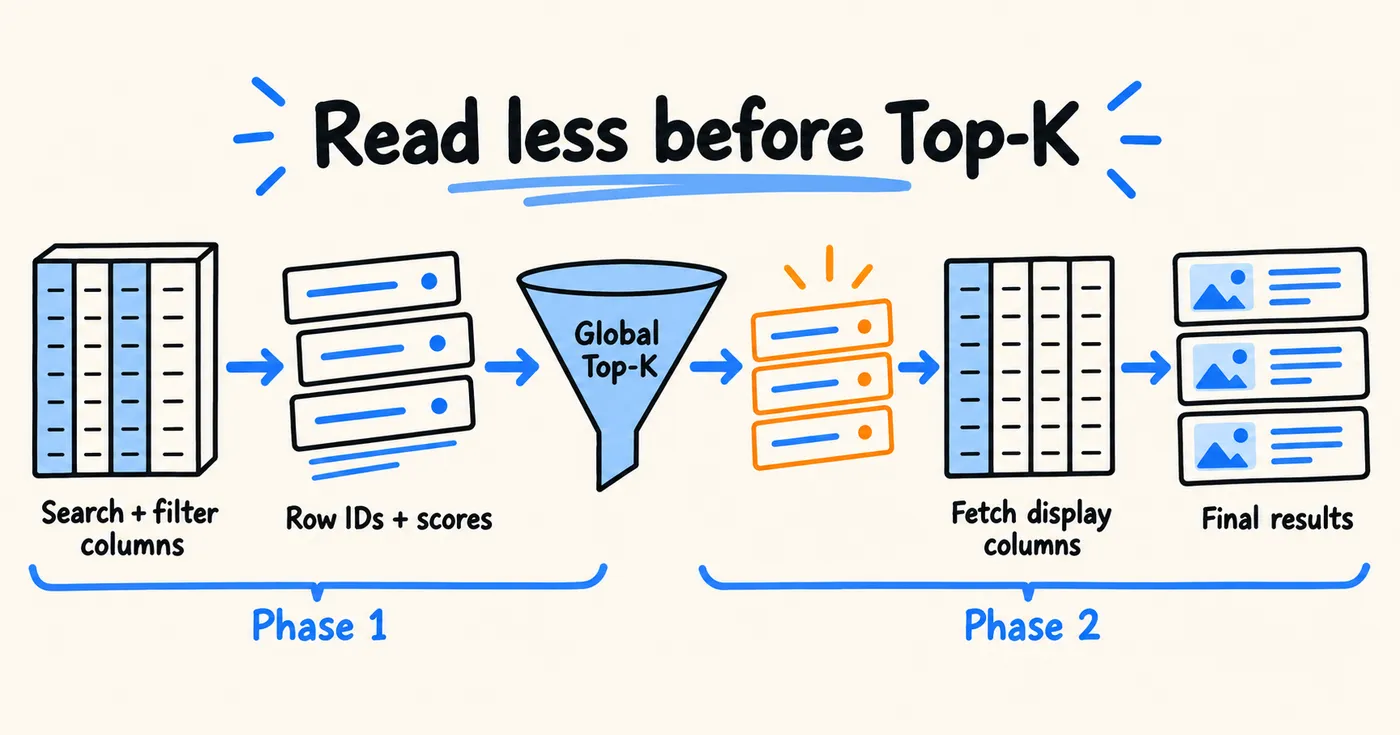
第一次读取检索、过滤和计算必需的数据,返回行号、距离或分数,以及后续计算需要的列。等 Doris 选出全局 Top-K 后,第二次再按行号读取这些记录的其他展示列。
这样,最终未入选的记录就可以少读、少传一些列。查询仍会读取检索和过滤所需的数据,节省的是可以推迟到最后读取的部分。返回记录较少、每条记录附带的文本或属性较多时,这项优化尤其有用。
两次读取使用同一个数据版本,保证先检索到的记录与后面补读的内容一致。Doris 还支持按版本、时间或命名引用选择 Lance 快照,方便重复查询同一版本的数据。
五、缓存与诊断
前面的优化主要减少单次查询需要处理的数据量,而缓存进一步减少重复查询中的固定开销。
连续查询同一个数据集时,往往会反复访问相同的索引和文件。缓存可以减少重复加载索引、解析元数据,以及从对象存储读取数据的开销。
Doris 在每个 BE 内共享 Lance Session。普通扫描、向量检索、全文检索和按行号补读数据,都可以复用其中相应的缓存。
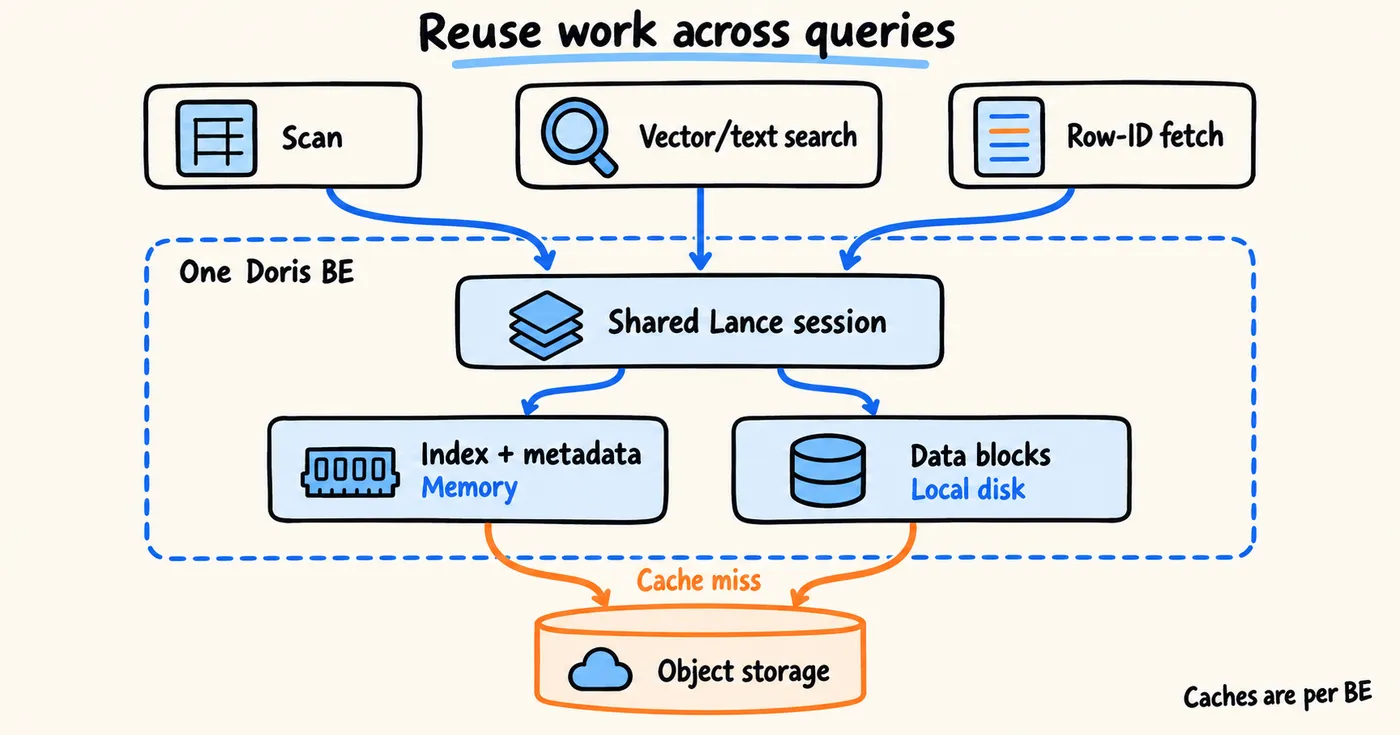
每个 BE 分别管理自己的缓存,BE 之间不共享缓存池。缓存容量也只是内存使用的一部分:扫描任务、数据预读和排序等操作还会占用额外内存。
查询慢在哪里,可以通过 EXPLAIN、Query Profile 和 BE 指标来查看。执行计划能帮助检查任务划分;Profile 可以进一步查看打开数据集、加载索引、远端读取、格式转换和补读列等环节的耗时。索引和元数据缓存的命中率、占用量是 BE 级别的统计,可能包含多个查询的访问。
排查时,可以先确认查询用了索引还是 Flat Search,再看时间主要花在过滤、数据读取、检索还是补读列上。这样更容易找到需要调整的环节。
六、SQL 分析
向量检索的最终目的通常不是返回几个相似结果,而是基于这些结果继续完成业务分析。因此,检索结果能否直接参与 SQL 执行,是衡量一体化查询能力的重要环节。
向量检索或全文检索返回的结果,可以像表一样参与 SQL 查询。Doris 将检索输出交给后续的关联、聚合和排序算子处理。例如,先从 Lance 中找出相似样本,再关联 Doris 内表中的标签,最后统计这些样本的类别分布。这些操作可以写在一条 SQL 中,由 Doris 执行。
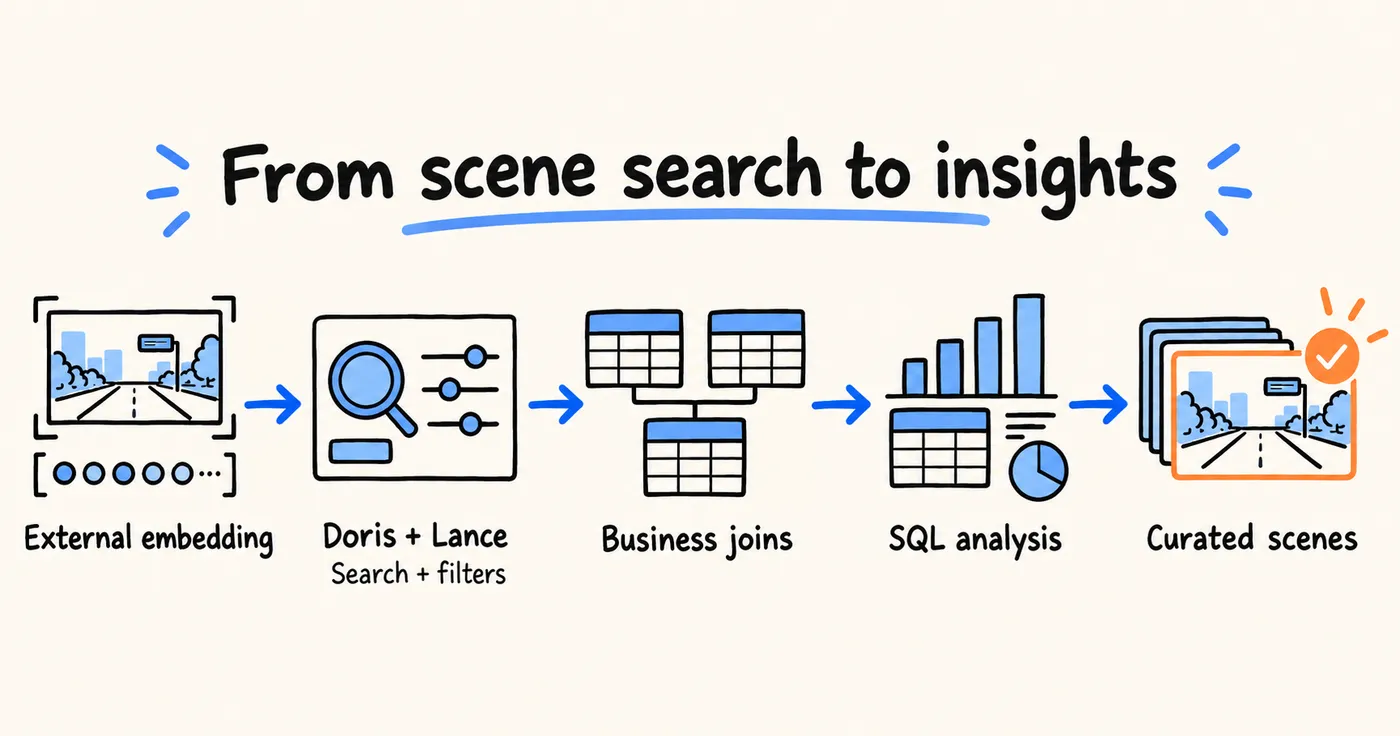
下面的示例先检索符合车型和区域条件的 Top-20 样本,再关联 Doris 内表 internal.demo.scene_labels,按场景类别统计数量。假设 Lance 数据集中的 scene_id 唯一,标签表也为每个 scene_id 保存一条记录。表名、字段和值均为演示数据,四维向量和距离计算方式需要按实际数据及索引调整。
WITH candidates AS (
    SELECT scene_id
    FROM vector_search(
        "table" = "lance_demo.autodrive.scene_samples",
        "column" = "embedding",
        "query_vector" = "[0.12, 0.34, 0.56, 0.78]",
        "top_k" = "20",
        "metric" = "cosine",
        "filter" = "vehicle_type = 'sedan' AND region_code = 'zone_a'",
        "prefilter" = "true",
        "use_index" = "true"
    )
    ORDER BY _distance ASC, scene_id
    LIMIT 20
)
SELECT
    COALESCE(l.scene_type, '未分类') AS scene_type,
    COUNT(*) AS sample_count
FROM candidates c
LEFT JOIN internal.demo.scene_labels l
    ON c.scene_id = l.scene_id
GROUP BY COALESCE(l.scene_type, '未分类')
ORDER BY sample_count DESC, scene_type;
这条 SQL 分三步执行:candidates 定义检索结果,LEFT JOIN 按样本 ID 补充类别,GROUP BY 统计各类样本的数量。没有匹配标签或类别为空的样本归入“未分类”。应用直接获得统计结果,无需先取回样本,再逐条查标签和计数。
这里统计的是本次返回的 Top-K 样本,反映这批相似样本的类别分布。如果要统计整个数据集,应直接扫描 Lance 表并聚合。示例中的车型和区域条件放在检索函数内,确保在选择候选时就限定搜索范围。
七、性能对比
前面的章节介绍了 Doris + Lance 在查询执行中的几个关键机制:并行检索提高资源利用率,提前过滤减少搜索范围,按需读列降低数据读取成本,缓存减少重复访问开销。下面通过实际测试,观察这些机制组合后的查询效果。
下面是一组来自真实智能驾驶场景的测试结果。
测试对比 Doris + Lance 和 Ray + pylance,数据规模分别为 1 亿、5 亿和 10 亿。查询包括纯向量检索,以及叠加设备、时间、车型、地理和四项组合条件的检索,共六类。
测试条件为 Top-K 20,000、召回率 95%、开启缓存、无并发,耗时单位为秒。Ray 在 1 亿规模使用 4 个 actor,在 5 亿和 10 亿规模使用 16 个 actor。开启缓存不代表每次查询都命中缓存。现有记录未提供双方硬件配置、Doris BE 数量和耗时统计方式,以下结果仅用于比较本次测试的查询耗时。
10 亿规模
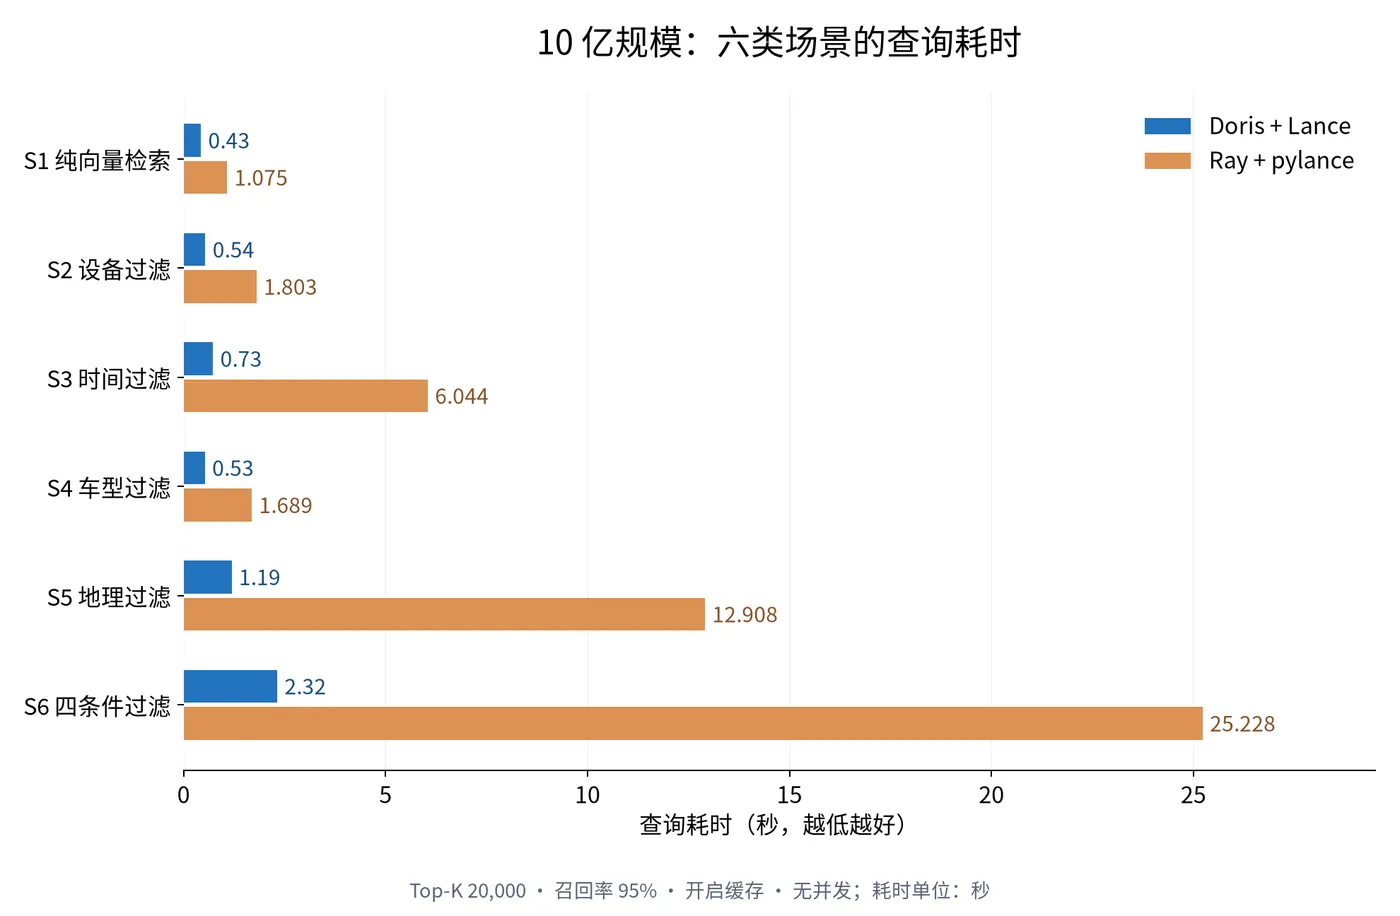
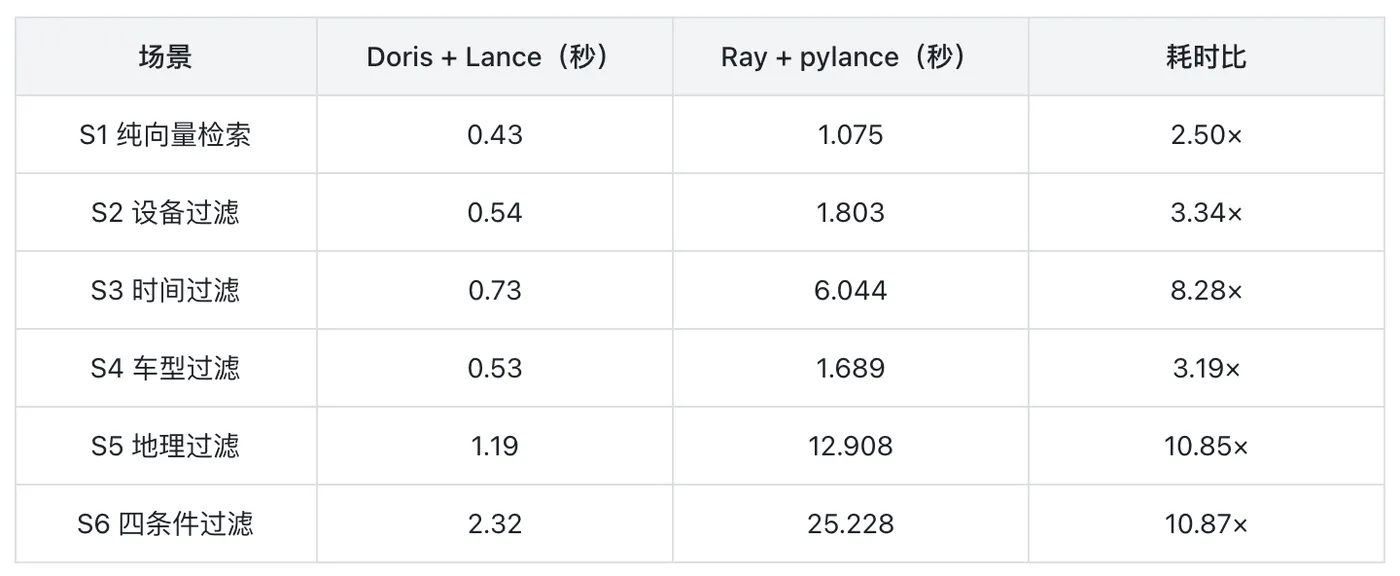
10 亿规模下,Doris 在地理过滤和四条件过滤查询中分别用时 1.19 秒、2.32 秒,相比 Ray + pylance,耗时均减少约 90.8%。时间过滤查询从 6.044 秒降至 0.73 秒,两者耗时比约为 8.28 倍。
这组结果说明,Doris 在本次“向量检索+条件过滤”测试中表现较好。前文介绍的索引规划、提前过滤、并行检索和按需读列,共同组成了这类查询的执行过程。由于测试没有逐项关闭这些优化,无法单独计算每项优化的贡献。
全部测试结果
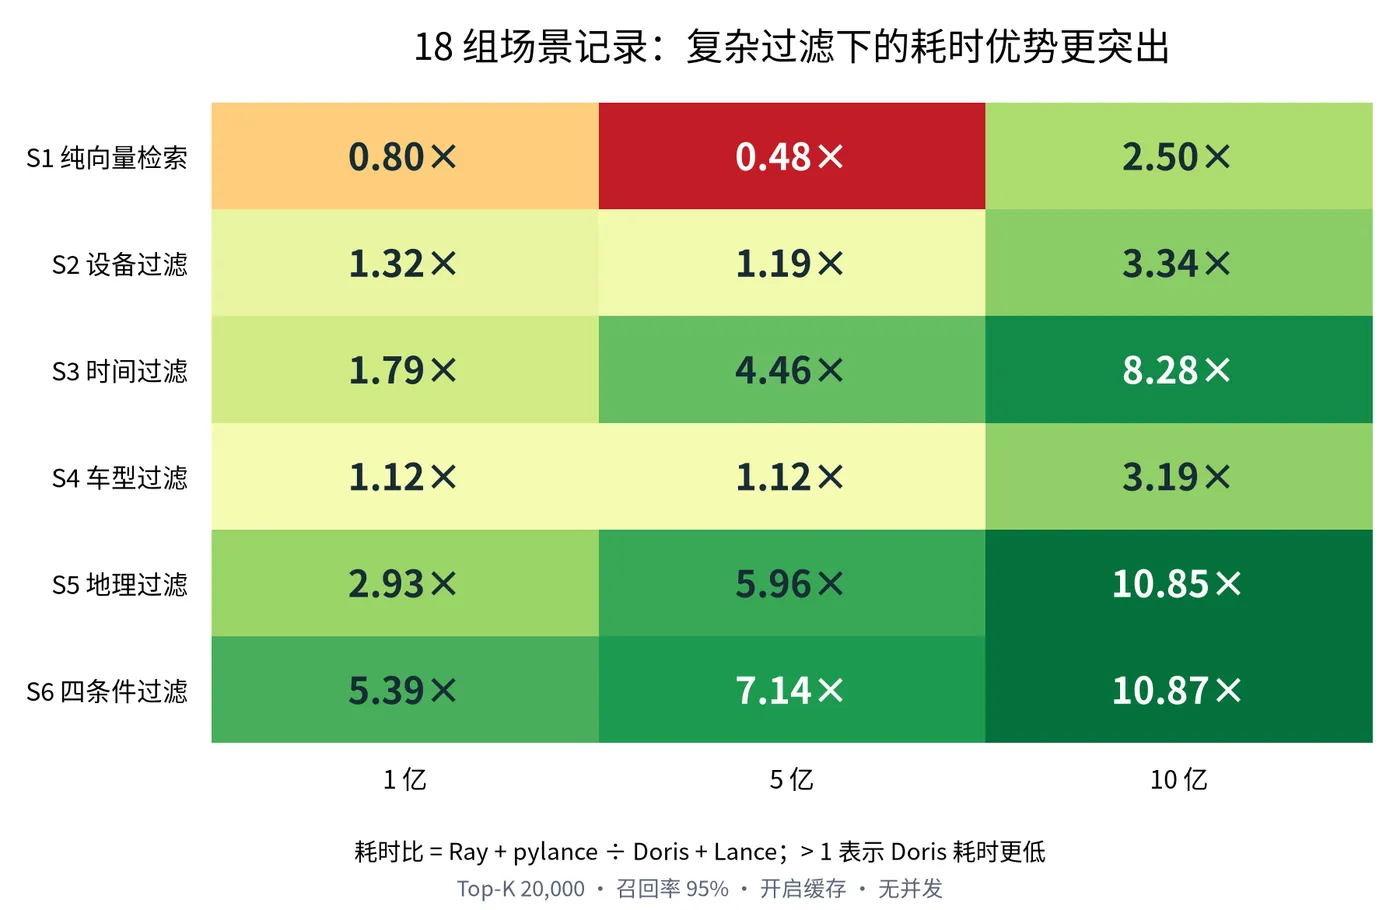
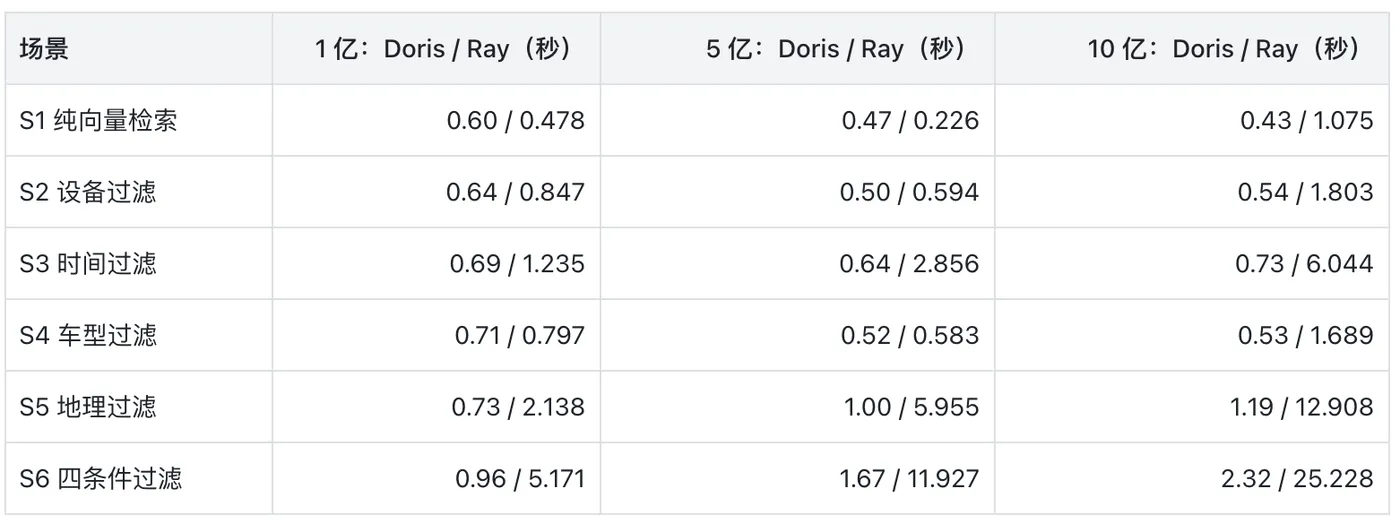
文中“耗时比”按 Ray + pylance 耗时除以 Doris + Lance 耗时计算,大于 1 表示 Doris 更快。18 组测试中,Doris 有 16 组耗时更低。四条件过滤在 1 亿、5 亿和 10 亿规模下的耗时比分别约为 5.39、7.14 和 10.87 倍。
八、总结
该能力预计可于 10 月底发布的 Apache Doris 4.2 版本中提供体验。Doris 对 Lance 的集成深入到了查询执行的各个环节:按索引段分配任务,让多个 BE 并行检索;提前应用过滤条件,缩小搜索范围;选出 Top-K 后再补读展示列,减少数据读取和传输;通过缓存复用索引、元数据和文件内容。这些机制让 Doris 能够直接利用已有的 Lance 数据和索引,完成检索与分析。
在本文的测试条件下,Doris + Lance 在 18 组查询中有 16 组耗时更低。10 亿规模的“向量检索+四条件过滤”用时 2.32 秒,Ray + pylance 用时 25.228 秒。这组结果体现了 Doris 处理大规模向量检索与条件过滤组合查询的能力,实际收益仍需结合数据、索引和部署配置评估。
对于社区用户,这意味着可以继续使用 Lance 存储多模态数据,同时通过 Doris 的 SQL 接口完成检索、关联和统计。已有的 Lance 数据集由此可以直接服务于样本筛选、数据探索和业务分析,减少应用侧的数据搬运与结果处理工作。

