
@[toc]
摘要:大模型能力已经不稀缺了,稀缺的是「能安全落进企业业务里」的那一层。智枢 AI Agent Hub 是一套面向企业的智能体应用开发与运行平台,把大模型端点、工具、知识库(RAG)、数据源(NL2SQL)、可视化工作流、人工审批、行级数据权限与 iframe 嵌入收进同一个可治理的运行时。本文从落地痛点出发,拆解产品定位与八项核心能力,给出 10 张真实系统截图,并深入到后端 Java 与前端 TypeScript 的关键实现与工程实践。
一、引言:企业落地智能体,到底难在哪
过去两年,「做一个企业智能助手」的技术门槛被迅速抹平:调一个 OpenAI 兼容端点、接一个向量库、写一段 Prompt,一个 Demo 就能跑起来。但把 Demo 推进到生产,几乎每个团队都会撞上同一堵墙。我们把这堵墙拆成五类问题:
| 痛点 | 典型症状 | 根因 |
|---|---|---|
| 模型绑死 | 换了供应商就要改代码、重测;想同时用两个模型做不到 | 模型调用散落在业务代码里,没有端点抽象层 |
| 知识接不进来 | 文档上传了但检索不准;Word/Excel/PDF 读出来是乱码 | 只支持纯文本抽取,没有真正的文档解析管线 |
| 数据查不到也管不住 | 问「我部门上月销售额」答不上来;能查到的又可能越权 | 没有 NL2SQL 通道;有通道的又缺行级数据权限 |
| 流程不可控 | 智能体直接改了业务数据,出事找不到人 | 缺人工审批节点与执行留痕 |
| 与既有系统割裂 | 智能体是独立网站,员工要在两个系统间来回切 | 没有低改造成本的嵌入与单点登录方案 |
更麻烦的是,这五类问题不是并列关系,而是串联关系:模型输出喂给工具,工具读知识与业务库,结果进流程,流程要能审批,最终还要嵌回 OA。缺任何一环,上一环的投入都会打折。
智枢 AI Agent Hub 的目标很直接:把这条链路做成一套工程化平台,而不是五个各写一遍的模块。
二、产品概述:智枢 AI Agent Hub 是什么
智枢 AI Agent Hub 是一套独立的企业级智能体平台,覆盖从「用户与权限」到「安全嵌入」的完整链路:
用户与权限 → 大模型端点 → 工具注册 → 知识库(RAG) → 数据源(NL2SQL)
          → 多智能体编排 → 可视化工作流 → 人工审批 → 附件理解 → 安全嵌入
2.1 定位:不是又一个聊天窗口,而是智能体的「运行时 + 控制台」
平台分两层看:
- 运行时:一次对话进来后,由哪个智能体接待、能调哪些工具、能检索哪些知识、能查哪些表、查出来的行是不是你有权限看 —— 全部由平台在服务端裁决,而不是靠 Prompt 约束模型「请你不要回答」。
- 控制台:运营方像搭积木一样,把大模型端点、业务接口、私有知识与企业数据组合成智能体,配好即用、改完生效。
2.2 与 OA 等既有系统的关系:解耦,而非侵入
这一点在架构上被明确写死:平台与 OA(如 JeecgBoot 体系)完全解耦,仅通过 API / 网关对接,不共享数据库、不修改既有系统代码。二者之间只有两条通路:
- 嵌入通路:既有系统用一行
<iframe src="https://agent-host/embed">把对话窗口装进自己的页面,员工在 OA 里直接对话,零改造接入(详见第七节的 CSP 设计)。 - 组织通路:通过
OrgAdapter防腐层,把外部系统的组织模型(OA / EAS / SCIM)同步成平台内部的 canonical 组织模型。外部系统怎么变,平台内部的权限计算口径不变。
这个解耦决策带来的直接收益是:平台的迭代、发版、故障,都不会传导到 OA;而 OA 升级也不会打断智能体。
三、核心能力:八项
下表给出八项核心能力,以及它们在本文截图巡览中的对应位置(截图按「图 N」编号,统一在第四节集中展示):
| # | 核心能力 | 说明 | 对应截图 |
|---|---|---|---|
| 1 | 多智能体编排 | 每个智能体可绑定专属知识库、工具集与工作流,支持默认智能体与按业务场景分发 | 图 7 |
| 2 | 可插拔工具 | 内置工具注册中心,HTTP / 函数类工具即配即用;既可作为工作流节点,也可在对话中被模型直接调用 | 图 6 |
| 3 | 知识库 RAG | 支持 txt / md / doc / docx / xls / xlsx / pdf 抽取、分块、向量化与检索增强生成 | 图 3 |
| 4 | 数据源 NL2SQL | 接入多数据源,自然语言转 SQL 查询企业业务库,并叠加行级数据权限防护 | 图 9 |
| 5 | 可视化工作流 | llm / tool / condition / human / end 等节点拖拽编排,支持 Workflow-as-Tool 嵌套复用 |
图 8 |
| 6 | 人工审批 | 工作流中可插入人工节点,关键动作经审批后继续,形成业务闭环 | 图 8 |
| 7 | 行级数据权限 | RBAC 叠加组织维度行级数据权限:canonical 组织模型 + OrgAdapter + SQL dataScope 注入 + RAG 标签过滤 | 图 4 |
| 8 | 安全 iframe 嵌入 | 可信三方域名白名单 + CSP frame-ancestors 控制,既有系统零改造接入 |
图 10 |
其中第 7 项(行级数据权限)是这套平台与普通「Agent 脚手架」最大的分水岭,第六节会展开源码实现。
四、系统截图巡览
以下 10 张截图均来自本地运行实例的真实界面(对话与知识库为深色主题,后台管理为浅色主题)。
图 1 · 登录页
品牌化深色登录页。除了账密登录,这一屏背后还挂着两件事:登录审计留痕,以及 ?redirect= 回跳参数的安全校验——后者在早期版本里是一处真实的开放重定向缺口,第七节会讲我们怎么把它收敛成单一实现。
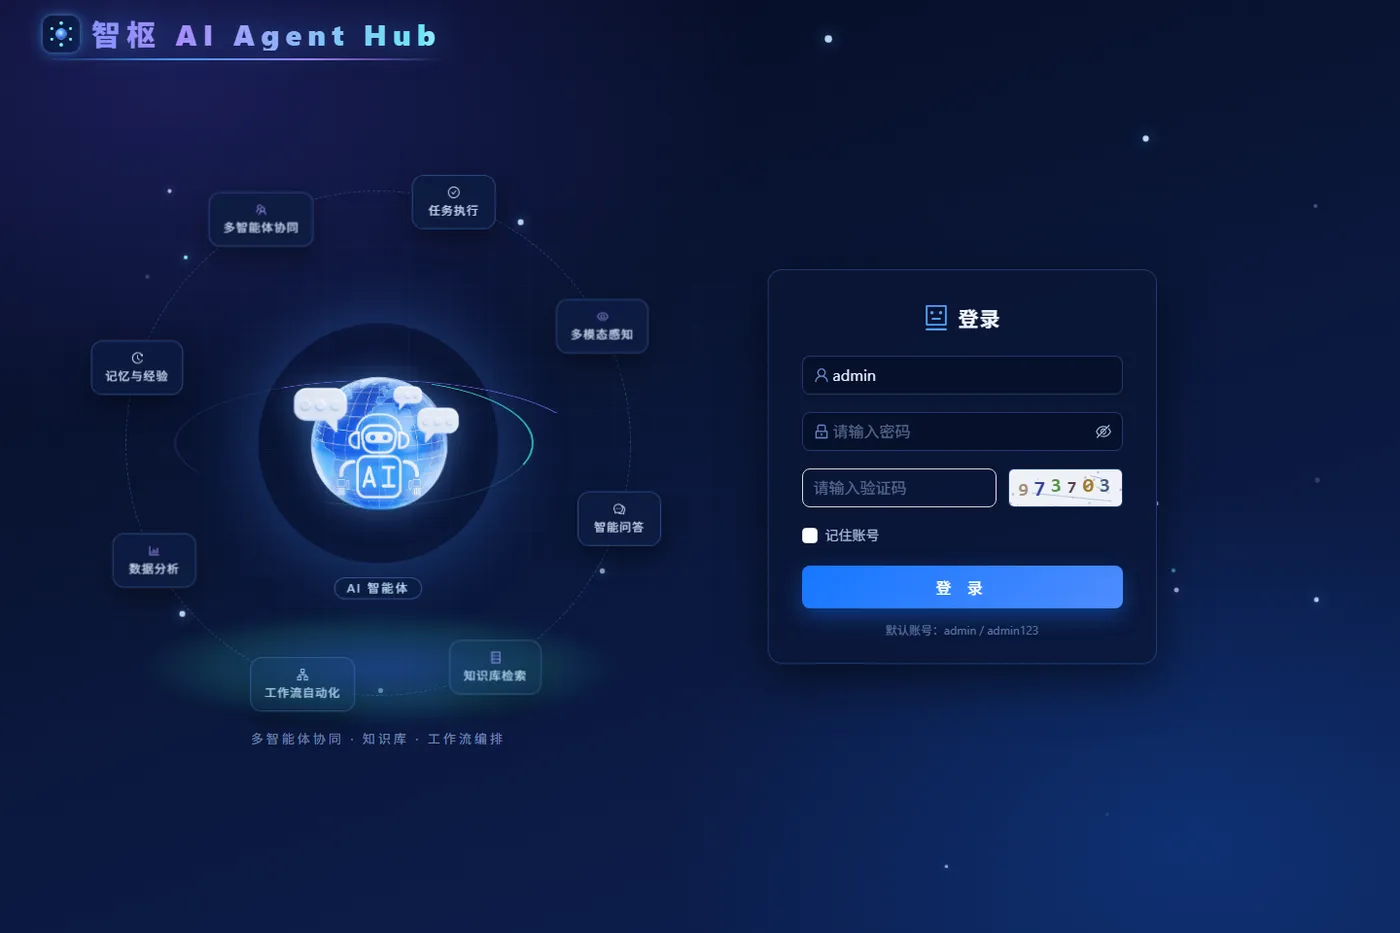
图 2 · 智能对话
主对话界面,SSE 流式输出。左侧会话历史、中间消息区(含「思考中」过程框)、右侧智能体上下文;回答下方给出 RAG 引用来源(citations),用户能直接看到答案出自哪篇文档的哪个分片。
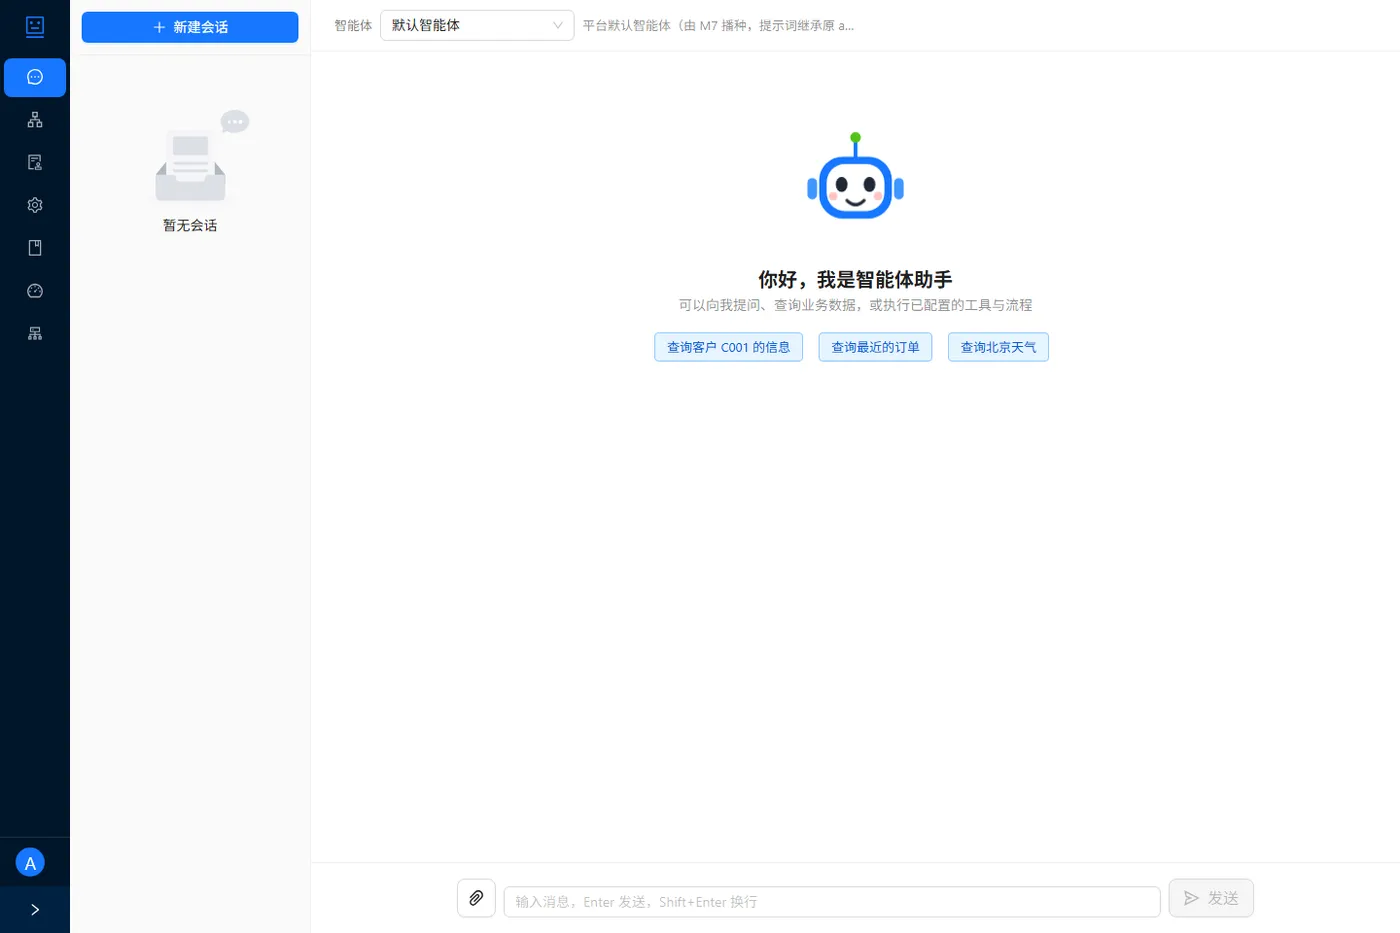
图 3 · 知识库管理
知识库已从「管理后台的一个 Tab」提升为一级功能路由 /kbs。这一屏管理知识库本体(分块大小、重叠窗口、向量维度),以及库内文档的上传、抽取状态(uploaded / indexed / failed)与索引重建。
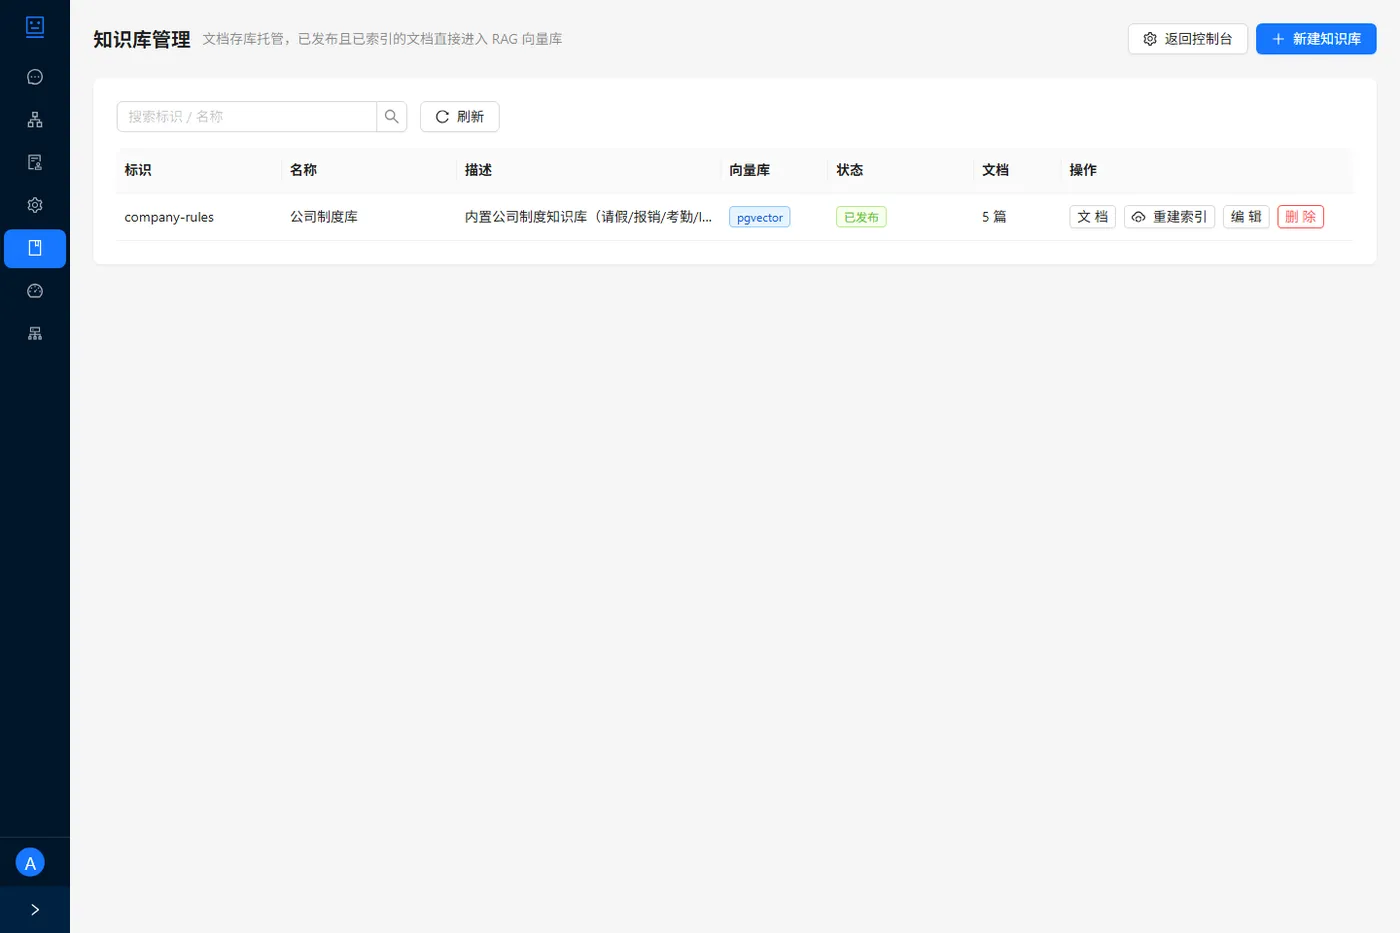
图 4 · 用户与权限
用户 / 角色 / 权限点管理。角色上挂着 data_scope 字段(ALL / COMPANY / SUBTREE / NODE / POSITION / SELF),这是行级数据权限的唯一配置入口。注意:只有管理员角色可被显式配置为 ALL,普通角色的存量 ALL 已在 Flyway V10 迁移中被收紧为 SELF。
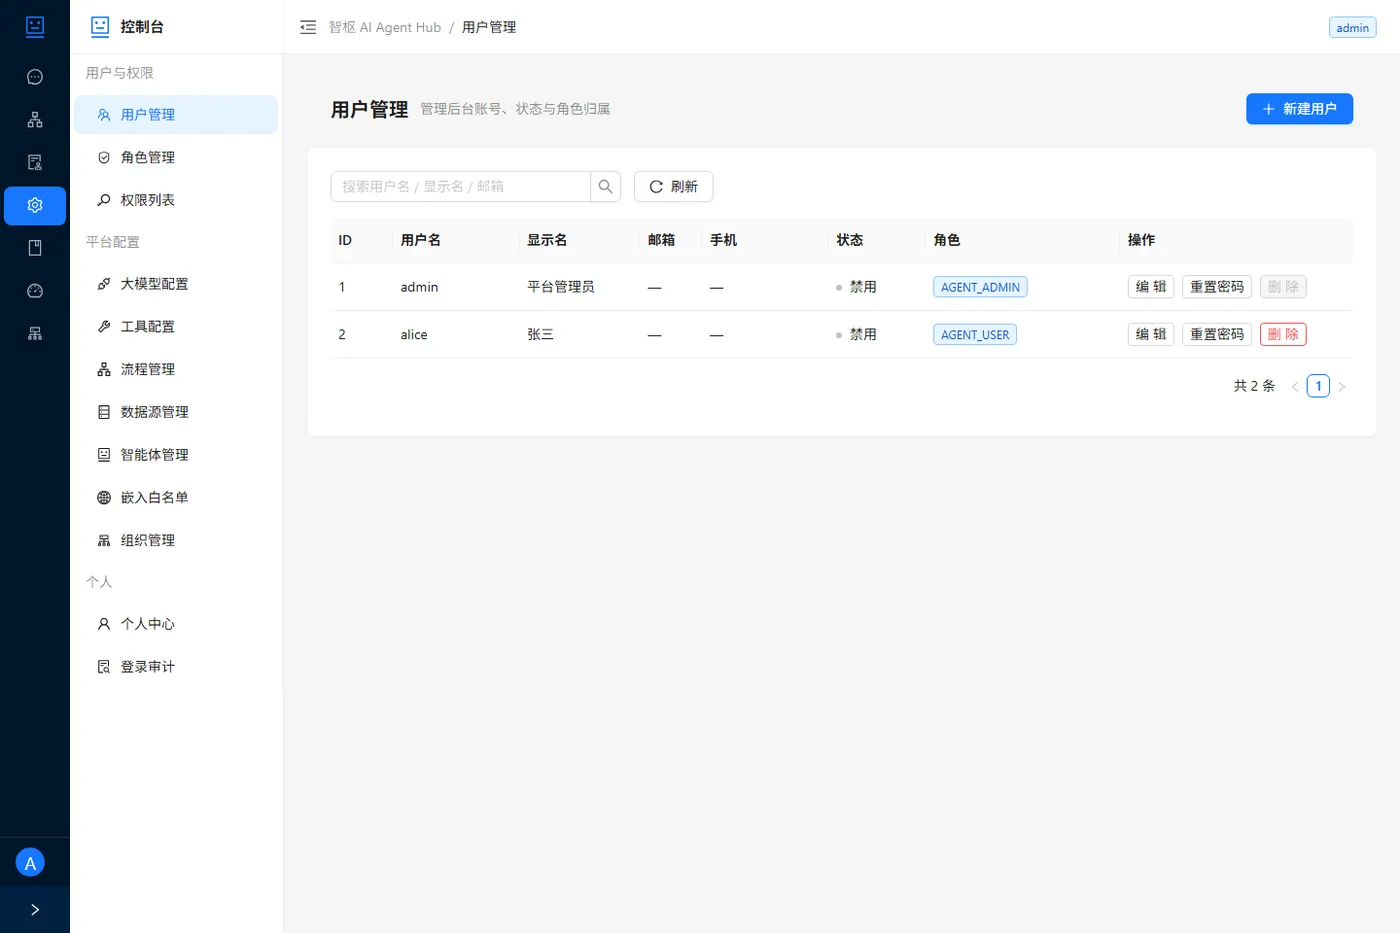
图 5 · 大模型端点
LLM 端点管理:多端点并存、启停切换、连通性测试、思考链开关。端点统一走 OpenAI 兼容协议,因此换供应商只改配置、代码零改动(阿里云 MaaS / DashScope / DeepSeek / 混元 / SCNet 均已验证)。
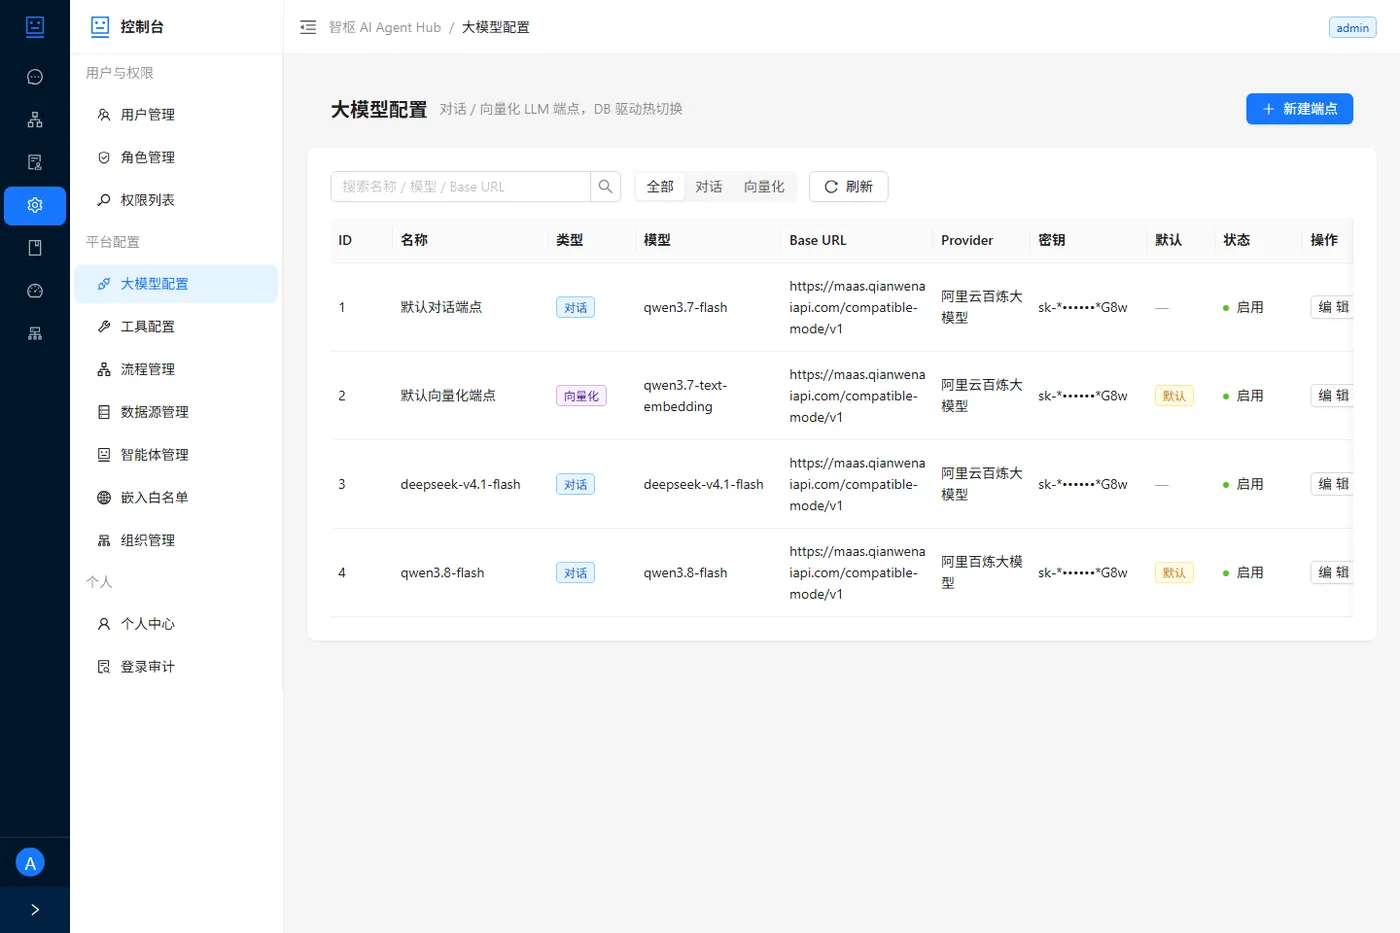
图 6 · 工具配置
可插拔工具注册中心。每个工具登记参数 Schema、执行类型(http / sql / 内置函数)与结果映射;SQL 类工具还能额外声明 dataScope 数据范围节点。注册好的工具同时暴露给「对话调用」与「工作流节点」两种消费方式。
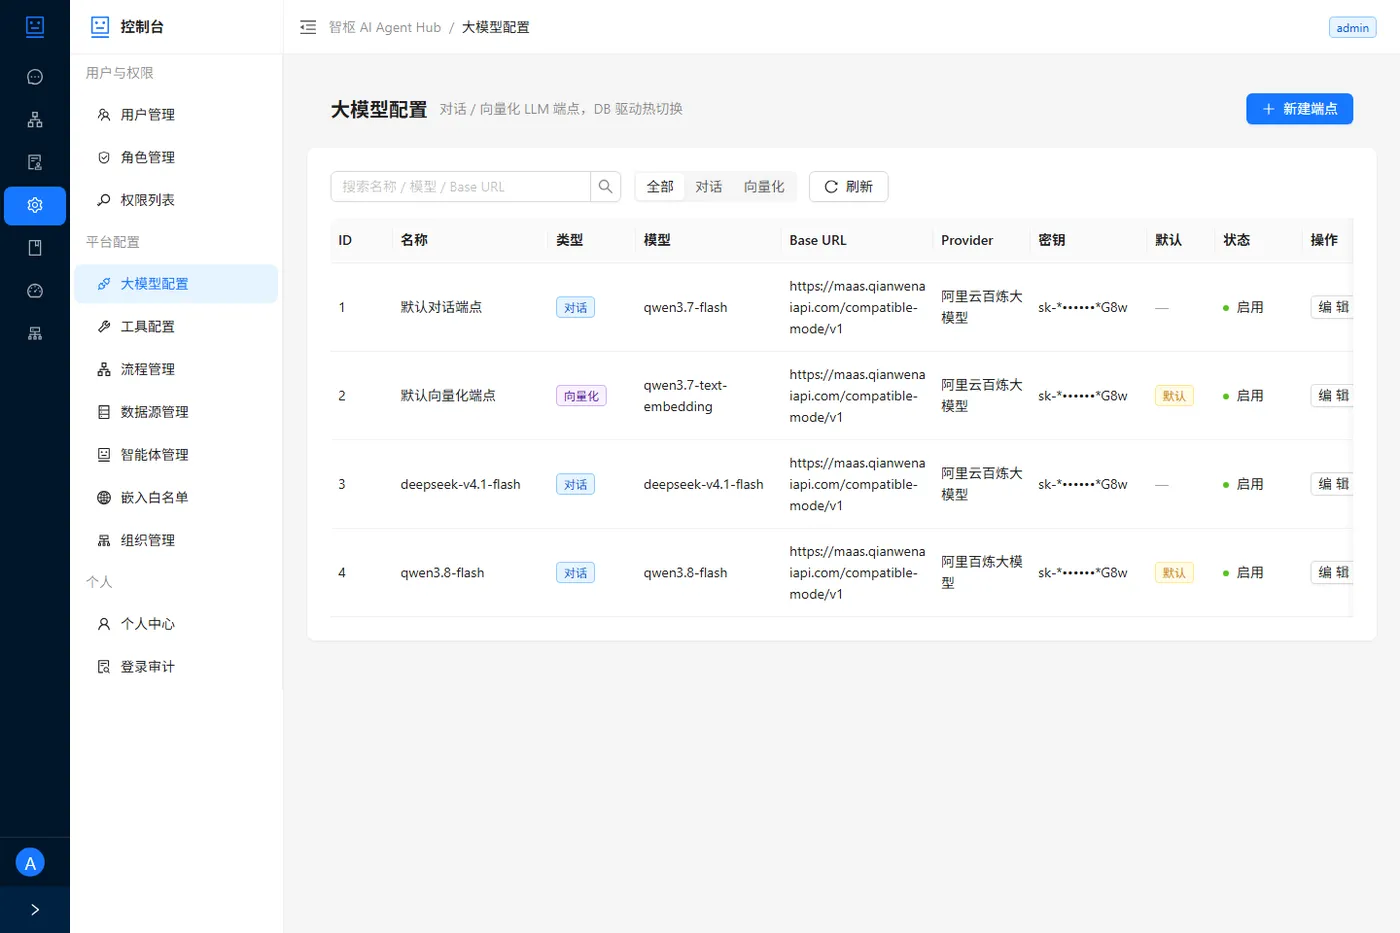
图 7 · 智能体管理
多智能体编排:一个智能体 = 一个大模型端点 + 一组工具 + 若干知识库 + 可选的默认工作流 + 人设 Prompt。支持指定默认智能体,未指定 agentKey 的请求由平台按 is_default 兜底——这条兜底正是 iframe 嵌入能「零参数接入」的前提。
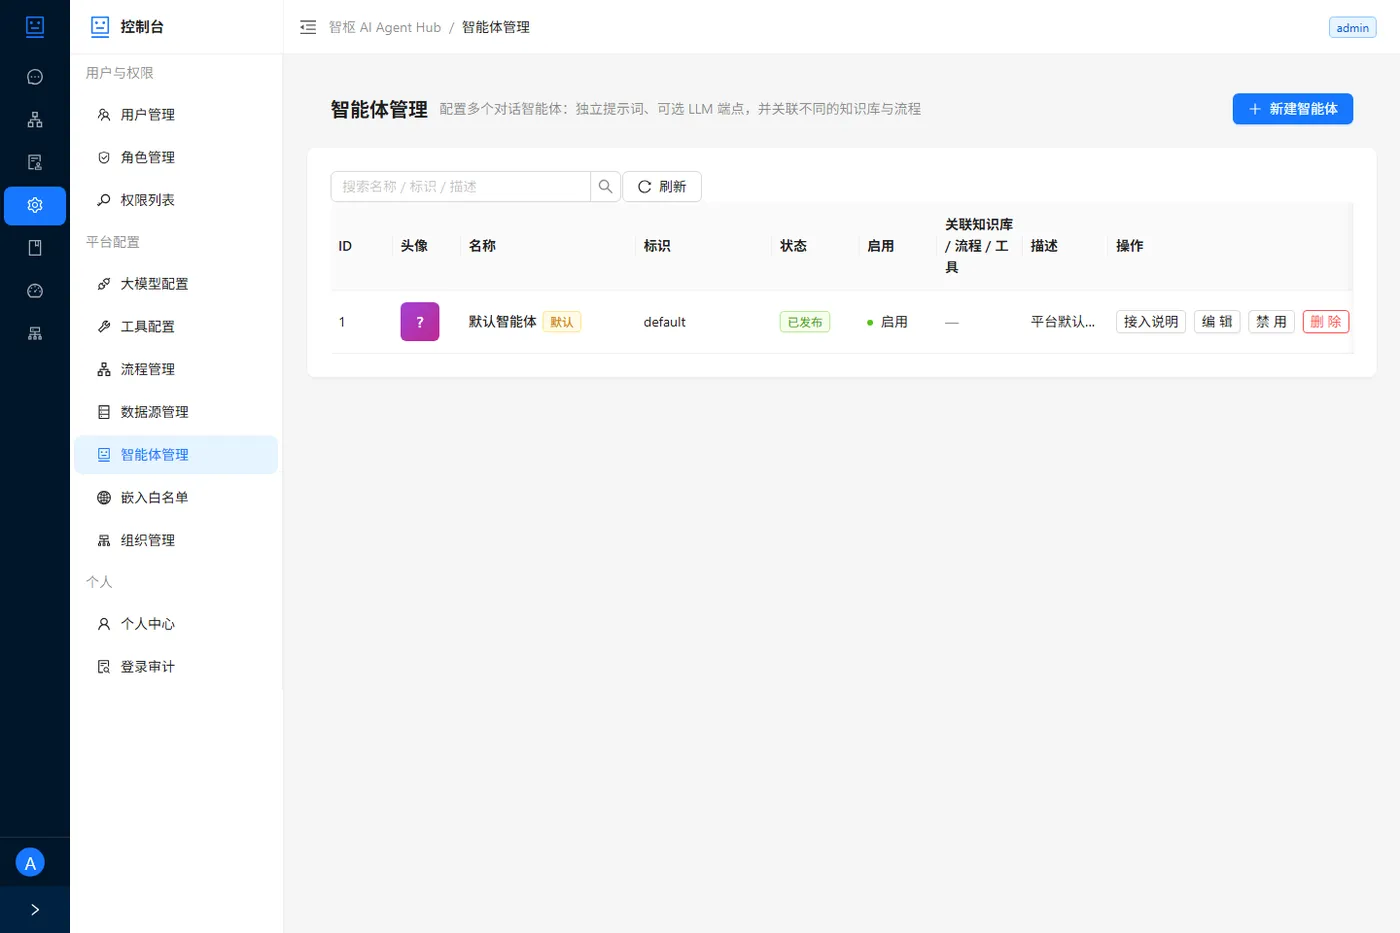
图 8 · 流程管理
可视化工作流编排(AntV X6 图编辑器)。节点类型含 llm / tool / condition / approval / end,支持条件分支与人工审批。编排好的流程可被包装成工具(Workflow-as-Tool)再被上层智能体调用,实现嵌套复用。
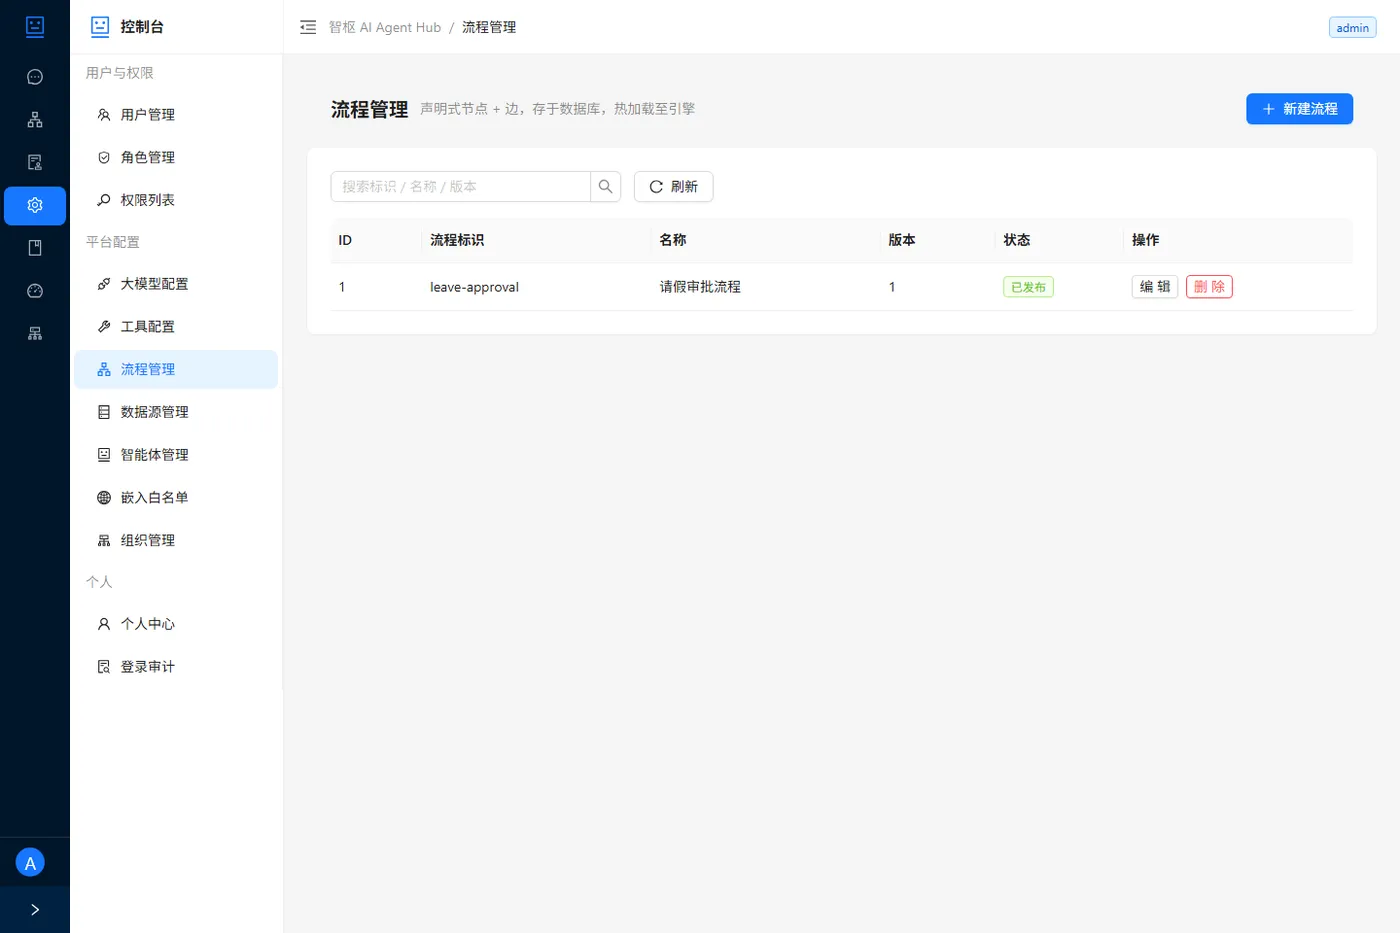
图 9 · 数据源管理
多数据源接入:MySQL / PostgreSQL / Oracle / SQLServer / 达梦 / 人大金仓六类 JDBC 驱动内置。除连接信息(加密存储)外,还可为每张表补充业务语义元数据供 NL2SQL 使用——这是把「能生成语法正确的 SQL」提升为「能生成业务正确的 SQL」的关键。
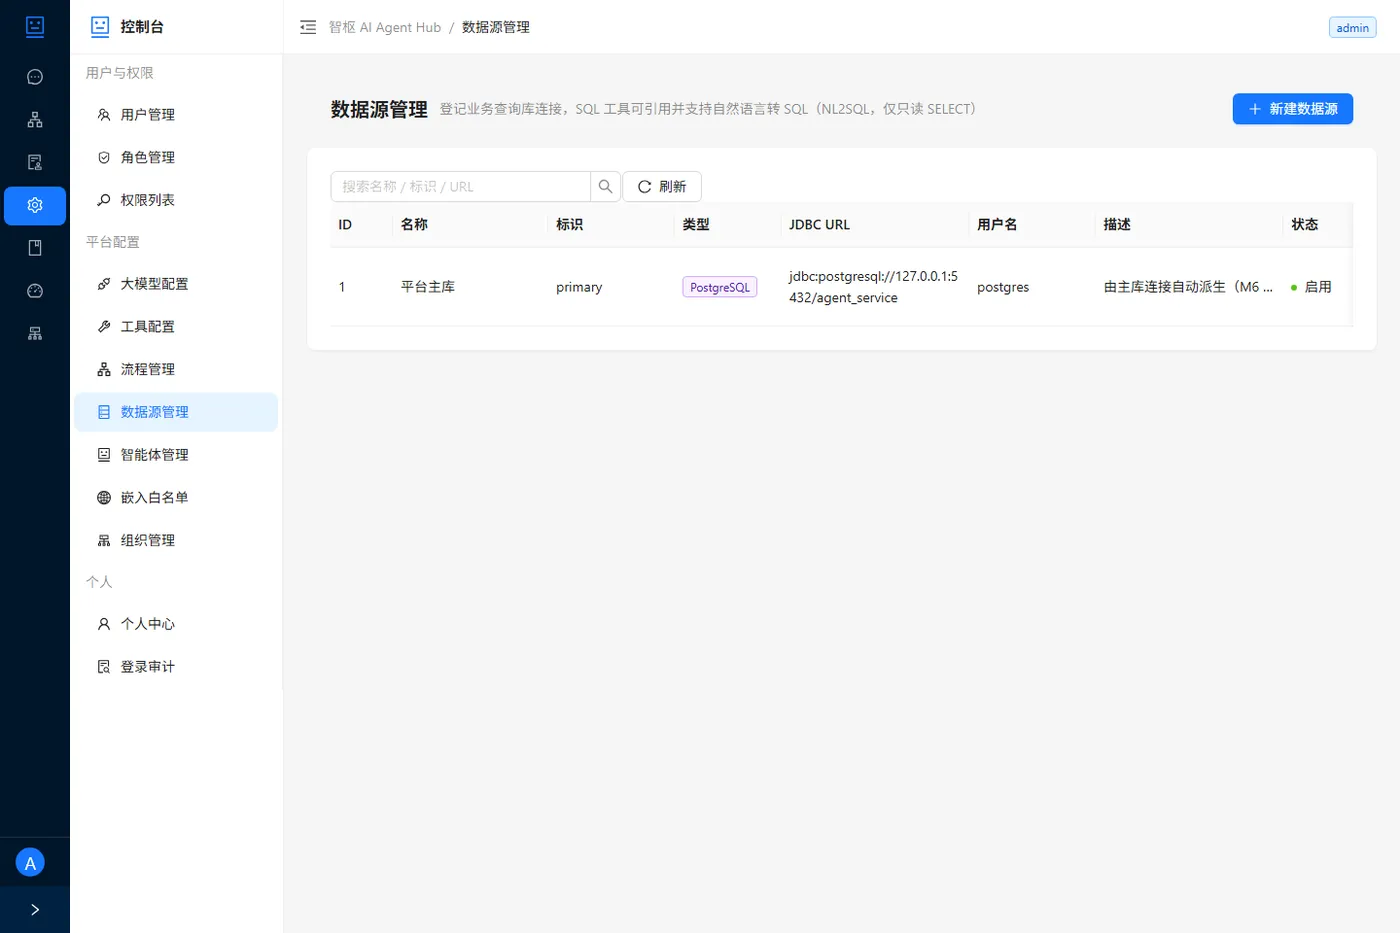
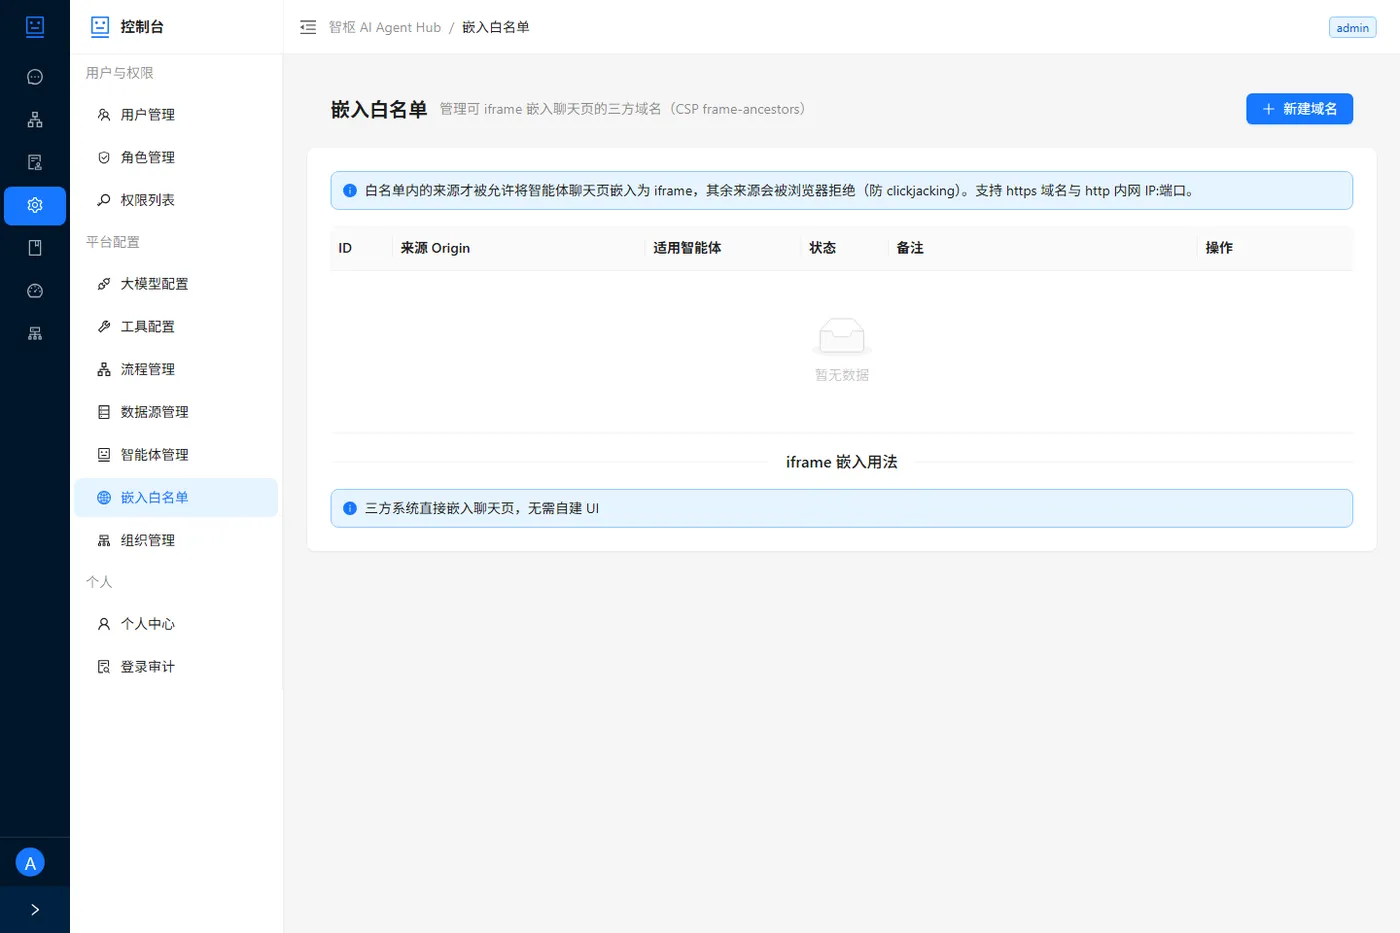
图 10 · 嵌入白名单
iframe 可信三方域名管理。白名单存表且热改生效、无需重启;命中白名单的父页才会拿到 Content-Security-Policy: frame-ancestors 头。白名单为空时策略为 'none',即默认拒绝任何嵌入。
五、技术架构与选型
5.1 后端 · agent-service
| 组件 | 版本 | 为什么这么选 |
|---|---|---|
| Java | 17 | Spring Boot 3.x 的基线;record + switch 表达式让 DataScope 这类枚举逻辑写得更紧凑 |
| Spring Boot | 3.3.4 | Web 框架(Spring Framework 6.1.13)。选 3.x 是为了 jakarta.* 命名空间与云原生生态对齐 |
| LangChain4j | 1.12.2 | AI 编排框架。关键理由:它是「可被替换的抽象」而非「全家桶」——ContentRetriever、ChatModel 都是接口,我们才能在 RAG 检索链上插入自有权限过滤器(见 6.4) |
| langchain4j-pgvector | 1.12.2-beta22 | 向量库集成。1.x 阶段用 beta 版本号、不受 BOM 管理,需显式锁版本 |
| Shiro | 2.0.0(仅 core) | 鉴权。刻意不用 shiro-spring-boot-starter:starter 会引入 javax.servlet 依赖,与 Boot 3 的 jakarta 冲突;改用程序化 Realm + 自定义 TokenAuthFilter |
| jjwt | 0.12.6 | JWT 签发与校验(Shiro 只负责鉴权语义,Token 解析由 jjwt 承担) |
| MyBatis + Flyway | 3.0.3 / 9.22.3 | 持久层 + 版本化迁移(前者为 mybatis-spring-boot-starter,后者为 flyway-core)。选 MyBatis 而非 JPA:NL2SQL 与 dataScope 注入需要大量动态 SQL 与原生 JDBC(NamedParameterJdbcTemplate),JPA 的抽象在这里是负资产。Flyway 的上限由 flyway-mysql(本地仓库仅 9.22.3)而非 flyway-core 决定——core 与数据库插件必须严格同版本,故显式钉 9.22.3 而非跟随 BOM 默认的 10.10.0 |
| PostgreSQL + PGVector | 42.7.7 | 业务库与 RAG 向量库分离部署。业务库用关系模型,向量库专供 embedding 检索,互不争抢资源 |
| H2 | runtime | 零安装自测(仅 h2 profile),让 CI 无需外部依赖即可跑全量测试 |
5.2 前端 · agent-front
| 组件 | 版本 | 为什么这么选 |
|---|---|---|
| Vue | 3.4.38 | 组合式 API 便于把鉴权状态抽成 useAuth() 可组合函数,被路由守卫与组件共用 |
| TypeScript | 5.5.4 | 前端与后端的 DTO 契约靠类型系统落地,改接口能在编译期暴露 |
| Vite | 5.4.8 | 冷启动速度。默认 optimizeDeps.entries = **/*.html 会把 dist 备份、QA 夹具、甚至 Chrome 扩展 profile 全当入口去爬,vite.config.ts 注释里记着实测单次 Scan completed in 93466ms(93.5s)并阻塞首个请求;收敛到 entries: ['index.html'] + server.watch.ignored 后,实测 scan 93.5s → 42.2s、首请求 93s → 42.5s |
| Ant Design Vue | 4.2.6 | 按需引入(unplugin-vue-components + AntDesignVueResolver)。整库全量注册会把组件全部打进主入口 chunk;按需后由 agent-front/dist/assets/ 实测,主入口 chunk 为 506KB(518,538 bytes),其余 chunk 均在 200KB 以下 |
| AntV X6 | 2.18.1 | 流程编排图编辑器。必须动态 import(419KB),静态引入会把它打进路由 chunk |
| vue-router | 4.4.5 | history 模式 + 全局守卫承载权限拦截 |
5.3 模块矩阵(M1–M12)
| 模块 | 能力 |
|---|---|
| M1 | 用户与鉴权(登录/登出/改密/JWT/RBAC 权限点) |
| M2 | 大模型端点(多端点、启停、连通性测试、思考链开关) |
| M3 | 工具(注册、参数 Schema、HTTP 执行) |
| M4 | 流程引擎(DSL 定义、节点编排、执行、运行日志) |
| M5 / M5c | 知识库 RAG / 行级数据权限 |
| M6 | 数据源(多库接入、元数据、NL2SQL) |
| M7 | 多智能体 + Workflow-as-Tool |
| M8 | 人工审批(任务、指派、决策) |
| M9 | 头像(内置资产、上传、Lottie 动效) |
| M10 | NL2SQL 元数据增强 |
| M11 | 对话附件上传与理解(POI + PDFBox) |
| M12 | iframe 安全嵌入 |
六、核心代码实现
以下四段代码均取自本仓库真实源码。
6.1 后端:SPA 路由回落,为什么只登记精确路径
前端用 createWebHistory()(history 模式)后,首屏内的跳转是纯 history.pushState,不经过服务端;只有刷新 / 直达 / 分享链接才会真正向服务端 GET 该路径。服务端没有同名静态文件,本仓的 404 又是 JSON 错误体,浏览器会把它当文档渲染——实测在 /chat 刷新,整屏只剩下:
{
   "error":true,"code":"NOT_FOUND","message":"资源不存在:chat"}
修法是在服务端做回落。WebMvcConfig.java:
private static final List<String> SPA_ROUTES = List.of(
        // 未登录直达 / 被路由守卫重定向后的落点。必须可达:否则「守卫跳 /login → 服务端又 404」
        // 会形成死循环,用户在地址栏看到的永远是那段 JSON。
        "/login",
        "/chat",
        "/admin",
        "/kbs",
        "/ops",
        "/workflow",
        "/approval",
        "/org",
        "/embed");

/**
 * SPA(history 模式)路由回落 —— 遍历 {@link #SPA_ROUTES}。
 * ...
 */
@Override
public void addViewControllers(ViewControllerRegistry registry) {

    for (String route : SPA_ROUTES) {

        registry.addViewController(route).setViewName("forward:/index.html");
    }
}
源码注释里钉死了三条硬约束,值得单独强调:
- 只用精确路径,绝不用通配(
"/*"、"/{path:[^\\.]*}")。通配回落会吞掉/api/**、/avatars/**、/assets/**等真实资源,把「接口 404」变成「返回一份 HTML」,排障成本极高。这条由SpaRouteFallbackQaTest用反向断言钉死:真实资源路径必须仍然 404。 - 前端新增一级路由时,只在
SPA_ROUTES补一项。早先只有/embed一条被硬编码在方法体里,改为清单后,「新增路由要改两处」收敛成了一个常量。 /embed与其余几条的唯一差别是它额外带 CSP 头(由EmbedCspFilter注入),回落机制相同,故并入同一清单。
6.2 前端:/kbs 一级路由与它的权限守卫
知识库管理原先是 AdminView 里的一个 Tab,后来提升为一级功能路由(agent-front/src/router/index.ts):
{

  // 知识库管理:已从「管理后台」提升为一级功能(原在 AdminView 内以 tab 形式承载)。
  path: '/kbs',
  name: 'kbs',
  component: () => import('@/views/KbAdminView.vue'),
},
配套的权限守卫:
// 知识库管理需要 kb:manage 权限(已从管理后台独立为一级功能)
if (to.name === 'kbs' && !auth.hasPermission('kb:manage')) {

  return {
    name: 'chat' }
}
同一份守卫里还有两个看似简单、实则踩过坑的点:
其一:已登录访问登录页要先送走,且必须放在 meta.public 放行之前。
// 已登录态访问登录页 → 直接送走(用户裁定:已登录即跳 /chat)。
//
// ⚠️ 必须放在 `to.meta.public` 放行**之前**:`/login` 自身就是 public 路由,
// 若放在其后会被 `return true` 提前放行,回跳永远不生效。
if (to.name === 'login' && loggedIn) {

  return safeInternalRedirect(to.query.redirect, (p) => router.resolve(p))
}
safeInternalRedirect 是从 @/utils/redirect 引入的唯一实现。这里有个真实的开放重定向故事:早先路由守卫里有一份私有副本做校验,而 LoginView.vue 登录成功后那条路径没有校验,于是 /login?redirect=https://evil.example.com 构成了一条完整的钓鱼链路。现在两处共用同一份实现,且 router.resolve 以参数注入,从而 utils/redirect.ts 零依赖、不形成 router ↔ utils 循环依赖。
还有一处细节:返回值用字符串而不是 { path }。vue-router 会把 { path } 里的 ?query 剥掉(resolve() 内部走 parseURL(...).path),只有字符串形式才能完整保留 query / hash。
其二:isLoggedIn 是 ComputedRef,必须取 .value。
// ⚠️ 必须写 `.value`:`isLoggedIn` 是 `computed(() => !!token.value)`,返回
// **ComputedRef 对象**。守卫里是普通 JS 求值(不像模板那样对顶层 ref 自动解包),
// 写成 `!auth.isLoggedIn` 会得到 `!<对象>` === `false`,即**永远判为已登录**——
// 守卫形同虚设:无 token 深链 /chat 也会被放行。
if (!loggedIn) {

  return {
    name: 'login', query: {
    redirect: to.fullPath } }
}
这个 bug 的现象极具迷惑性:清空 localStorage 后冷启动 /chat 会停留在 /chat,而且 /login 页面上还渲染出了 NavBar(只是受 hasPermission 保护的菜单项为 0 个)。
另外,嵌入路由必须在 !loggedIn 之前放行:
// ⚠️ 位置是契约:必须放在下面的 `to.meta.public` 放行**之前**、尤其是下面的
//    `if (!loggedIn)` 之前。放错位置的症状是「iframe 里显示登录页」。
if (to.meta.embed) return true
6.3 行级数据权限(一):DataScopeLevel 的 fail-closed 兜底
权限的失败方向必须收敛到最小可见集。DataScopeLevel.java:
/**
 * 解析角色 {@code data_scope} 配置串,<b>兜底取保守(fail-closed)</b>。
 * ...
 */
public static DataScopeLevel parse(String s) {

    if (s == null || s.isBlank()) {

        return SELF;
    }
    String v = s.trim().toUpperCase();
    if ("DEPT".equals(v)) {

        return SUBTREE;
    }
    for (DataScopeLevel l : values()) {

        if (l.name().equals(v)) {

            return l;
        }
    }
    return SELF;
}
源码注释记录了这段反转:「本方法此前对 null/空/未知值一律返回 ALL(注释写作『保守不过滤』),语义恰好与安全方向相反 —— 字段缺失或拼错词会被静默放大成『全平台数据可见』」。现在只有被显式配置为 ALL 的角色才全放行。
6.4 行级数据权限(二):SQL 侧用「派生表包裹」而非「末尾追加 AND」
SqlToolExecutor.java 的核心取舍写在类注释里,非常值得抄:
/**
 * <p><b>M5c:fixed 模式支持声明式 dataScope 行级过滤(§9.3)</b>。核心实现取「派生表包裹」:</p>
 * <pre>{@code
 * SELECT * FROM ( <原SQL> ) _ds_scope WHERE _ds_scope.dept_code IN (:_dsIds)
 * }</pre>
 *
 * <p><b>为什么用包裹而不是往 SQL 末尾追加 AND</b>:业务 SQL 可能自带 WHERE / GROUP BY / ORDER BY / LIMIT,
 * 直接追加必然语法错;要安全追加就得解析 SQL 结构,而解析正是 §9.3 明令避免的脆弱做法。
 * 包裹法零解析、天然兼容所有子句,且「声明了就一定生效」——不存在漏写占位符导致的静默不过滤。</p>
 *
 * <p>三重防注入:① 列名来自声明且过白名单正则(列名无法参数化,只能硬校验);
 * ② 过滤值走命名参数绑定;③ 系统参数以 {@code _} 前缀隔离,业务入参同名即拒绝。</p>
 */
实现方法:
String applyDataScope(String sql, Map<String, Object> bind) {

    if (!dataScopeEnabled || dataScope == null || !dataScope.isEnabled()) {

        return sql;   // 未声明 dataScope → 存量行为,零影响
    }
    DataScopeLevel level = DataScopeLevel.parse(dataScope.getLevel());
    if (level == DataScopeLevel.ALL) {

        return sql;
    }
    UserContext ctx = UserContextHolder.getOrAnonymous();
    if (ctx.isAdmin()) {

        return sql;   // 管理员放行全部
    }

    String column = dataScope.columnFor(level);
    if (column == null || !COLUMN_PATTERN.matcher(column).matches()) {

        // 列名是唯一无法参数化的拼接点:不合法直接拒绝执行,绝不带着可疑列名下发
        throw new IllegalArgumentException(
                "dataScope 列名缺失或不合法(仅允许字母数字下划线,可带一级 schema 前缀): " + column);
    }

    if (level == DataScopeLevel.SELF) {

        Long uid = ctx.userId();
        if (uid == null) {

            log.warn("[M5c] dataScope=SELF 但当前无可信用户身份,已拒绝查询");
            return denyAll(sql);
        }
        putSystemParam(bind, SYS_USER_ID, uid);
        return wrap(sql, column + " = :" + SYS_USER_ID);
    }

    Set<Long> ids = ctx.visibleIdsFor(level);
    if (ids == null) {

        return sql;   // ALL / 管理员
    }
    if (ids.isEmpty()) {

        // 用户没有任何组织归属:无法计算范围
        if (degradeToAllOnMissingOrg) {

            log.warn("[M5c] 用户 {} 无组织归属,dataScope={} 降级为放行全部(on-missing-org=ALL)",
                    ctx.username(), level);
            return sql;
        }
        log.warn("[M5c] 用户 {} 无组织归属,dataScope={} 拒绝返回数据(on-missing-org=DENY)",
                ctx.username(), level);
        return denyAll(sql);
    }
    putSystemParam(bind, SYS_IDS, ids);
    return wrap(sql, column + " IN (:" + SYS_IDS + ")");
}

/**
 * 派生表包裹:{@code SELECT * FROM ( <sql> ) _ds_scope WHERE <cond>}。
 * 原 SQL 末尾的分号必须剥掉,否则内层语句提前结束导致语法错。
 */
private String wrap(String sql, String cond) {

    return "SELECT * FROM (" + stripTrailingSemicolon(sql) + ") " + WRAP_ALIAS + " WHERE " + cond;
}

/** 无可见范围时的安全兜底:返回空结果集(而不是放行)。 */
private String denyAll(String sql) {

    return "SELECT * FROM (" + stripTrailingSemicolon(sql) + ") " + WRAP_ALIAS + " WHERE 1 = 0";
}
两个设计细节值得留意:
- 派生表别名
_ds_scope不加AS——为了兼容 Oracle / 达梦 DM8 等不支持派生表AS的方言。 putSystemParam会检查业务入参是否占用了_dsIds/_dsUserId这类保留名,占用即抛异常。否则外部可通过同名入参覆盖注入条件,直接绕过数据权限。
6.5 行级数据权限(三):RAG 侧的后置标签过滤
SQL 侧解决「查得到不该查的行」,RAG 侧要解决「检索得到不该看的文档片段」。PermissionFilteringContentRetriever.java:
@Override
public List<Content> retrieve(Query query) {

    List<Content> raw = delegate.retrieve(query);
    if (!enabled || raw == null || raw.isEmpty()) {

        return raw;
    }
    UserVisibility uv = currentUserVisibility(query);
    if (uv == null || uv.admin) {

        return raw; // 无上下文或管理员:放行全部
    }
    List<Content> visible = new ArrayList<>();
    for (Content c : raw) {

        if (isVisible(c, uv)) {

            visible.add(c);
        }
    }
    if (visible.size() != raw.size()) {

        log.debug("RAG 数据权限裁剪:候选 {} → 可见 {}", raw.size(), visible.size());
    }
    // 尊重配置的最大返回条数
    return visible.subList(0, Math.min(visible.size(), Math.max(1, maxResults)));
}

private boolean isVisible(Content c, UserVisibility uv) {

    TextSegment seg = c.textSegment();
    if (seg == null) {

        return true; // 无片段元数据,保守放行
    }
    Metadata meta = seg.metadata();
    // 1) 公开:元数据缺省或值为 true 即视为公开(兼容 classpath 兜底文档无该字段)
    if (!"false".equalsIgnoreCase(meta.getString("is_public"))) {

        return true;
    }
    // 2) 所有者
    String owner = meta.getString("owner");
    if (owner != null && !owner.isEmpty() && owner.equals(uv.username)) {

        return true;
    }
    // 3) 角色白名单:visible_roles 逗号串与用户角色有交集
    String roles = meta.getString("visible_roles");
    if (roles != null && !roles.isBlank()) {

        for (String r : roles.split(",")) {

            String tr = r.trim();
            if (!tr.isEmpty() && uv.roles.contains(tr)) {

                return true;
            }
        }
    }
    // 前三档都没命中,且文档被显式标为非公开 → 继续判断组织维度
    return orgVisible(meta, uv);
}
为什么是后置过滤而不是下推到向量库?源码注释给了答案:角色白名单是逗号串,向量库无法做集合包含下推。因此策略是先多取候选(agent.rag.retrieve-candidates)再裁剪,保证可见结果不丢。
另一个容易漏的场景是流式:worker 线程没有 ThreadLocal,UserContextHolder 取不到上下文。修法是靠 UserContextCarrier 按 query.metadata().chatMemoryId()(即 sessionId)还原上下文——否则流式问答会因「取不到用户」而放大成放行全部。
6.6 iframe 嵌入:CSP frame-ancestors 与它的「两处判据」
EmbedCspFilter.java:
@Override
protected void doFilterInternal(HttpServletRequest request,
                                HttpServletResponse response,
                                FilterChain chain) throws ServletException, IOException {

    String uri = request.getRequestURI();
    // ⚠️ 与 ShiroConfig#embedCspFilterRegistration 的 addUrlPatterns 是**同一份判据的两处副本**,
    //    新增可嵌入路径时两处必须同步(漏改前者 = 不再注入 CSP;漏改后者 = 本方法压根不被调用)。
    if (uri != null && (uri.endsWith("/embed")
            || uri.endsWith("/embed.html")
            || uri.endsWith("/chat.html"))) {

        String value = whitelistService.buildCspFrameAncestors();
        response.setHeader("Content-Security-Policy", "frame-ancestors " + value);
        // 顺便抑制 MIME 嗅探(防御向量收紧,与 CSP 无关但同源页面更稳)
        response.setHeader("X-Content-Type-Options", "nosniff");
    }
    chain.doFilter(request, response);
}
三个要点:
- 用
frame-ancestors而非X-Frame-Options: ALLOW-FROM:后者在 Chrome / Safari 早期已停用,前者是现行标准且行为稳定。 - 白名单为空 →
'none':显式拒绝,禁止任何父页嵌入。 - 两处判据必须同步维护(过滤器内的 URI 判断 +
ShiroConfig的FilterRegistrationBean#addUrlPatterns)。后者是更外层的闸门:路径没注册进来,本方法根本不会被执行——表现为「改了代码、也没报错,但响应里就是没有 CSP 头」。这条由EmbedEntryQaTest钉死。
前端侧,/embed 与 /chat 复用同一个 ChatView 组件,通过 props: { embed: true } 传标志而非让组件自己读 route,从而保持 ChatView 零路由耦合:
{

  path: '/embed',
  name: 'embed',
  component: () => import('@/views/ChatView.vue'),
  props: {
    embed: true },
  meta: {
    embed: true },
},
效果是嵌入版自动具备流式、附件、引用、工具调用与流程能力,不需要像旧版 static/embed.html 那样另行维护一份实现。
七、工程实践与质量保障
7.1 Flyway 版本化迁移:15 版,且是「混合形态」
迁移共 V1–V15 十五版。⚠️ 混合形态容易踩坑:SQL 迁移在 src/main/resources/db/migration/(V1、V3–V6、V11、V12),Java 迁移在 src/main/java/db/migration/(V2、V7–V10、V13–V15)——注意不是 com/example/agent/ 下面,两处都要找,别只看 resources。两者共用同一个版本号空间(spring.flyway.locations=classpath:db/migration 同时收纳 .sql 与编译后的 .class),所以编号不能撞车。
| 版本 | 形态 | 内容 |
|---|---|---|
| V1 | SQL | create_schema 建表 |
| V2 | Java | AddLegacyColumns 兼容列 |
| V3 | SQL | 请假审批流程回填 |
| V4 | SQL | 组织扩展字段 |
| V5 | SQL | 智能体-工具关联 |
| V6 | SQL | 嵌入白名单(iframe 可信三方域名) |
| V7 | Java | 智能体头像 |
| V8 | Java | 数据源元数据配置 |
| V9 | Java | LLM 端点向量维度 |
| V10 | Java | 存量 AGENT_USER 角色 data_scope 由 ALL 收紧为 SELF |
| V11 | SQL | 对话附件表(会话级,上传即解析文本 / 图片走多模态直读) |
| V12 | SQL | 会话持久化(聊天会话元数据,跨设备可见) |
| V13 | Java | agent_kb_doc.content_type 扩宽(知识库多格式文档扩展) |
| V14 | Java | agent_kb_doc.content 由 TEXT(64KB) 放宽到 LONGTEXT |
| V15 | Java | updated_at 触发器(MySQL 的 ON UPDATE CURRENT_TIMESTAMP 在 PG 无对应,改用 BEFORE UPDATE 触发器) |
V14 值得单独一提:真实 Word / Excel / PDF 抽取出的正文很容易超过 MySQL TEXT 的 64KB 上限,直接触发 DataIntegrityViolationException 报 500。而且已经执行过的迁移绝不能改——改了会破坏 Flyway 的 checksum,所以修复方式是另立 V14,而不是回头改 V13。
为什么 V2/V7–V10、V13–V15 用 Java 迁移:H2 profile 靠 Flyway 重放全部迁移来建库,迁移一崩,整个 H2 集成测试的 Spring context 就起不来。Java 迁移便于加守卫与幂等控制——例如 V10 用 WHERE data_scope = 'ALL' 保证幂等,且只动 AGENT_USER、不碰合法的 AGENT_ADMIN。
V10 这一版尤其值得单独说:它是一次权限水位收紧,把历史上「默认全放行」的存量角色一次性收敛到 SELF。这类迁移的价值不在于功能,而在于把安全基线固化成可重放、可审计的一次性动作。
7.2 前端性能:代码分包与懒挂载
管理后台原有 11 个板块(UserAdmin / RoleAdmin / PermAdmin / ProfilePanel / AuditAdmin / EndpointAdmin / ToolAdmin / WorkflowAdmin / DataSourceAdmin / AgentAdmin / EmbedAdmin),若全部静态 import 会打进同一个 chunk。AdminView.vue 改为动态加载器 + defineAsyncComponent:
const SECTION_LOADERS: Record<string, () => Promise<{
    default: Component }>> = {

  users: () => import('@/views/admin/UserAdmin.vue') as unknown as Promise<{
    default: Component }>,
  roles: () => import('@/views/admin/RoleAdmin.vue') as unknown as Promise<{
    default: Component }>,
  // ... 其余 9 个板块同构
}

const sectionComponents: Record<string, Component> = Object.fromEntries(
  Object.keys(SECTION_LOADERS).map((k) => [
    k,
    defineAsyncComponent({
    loader: SECTION_LOADERS[k], loadingComponent: SectionLoading, delay: 100, timeout: 30000 }),
  ]),
)
每个板块单独成 chunk,进后台不再一次性下载全部板块代码。配合另两项优化:@antv/x6(dist 实测 419KB)与 lottie-web(dist 实测 301KB)改为 await import(...);ant-design-vue 改按需引入。构建产物中最大的主入口 chunk 为 506KB。
⚠️ 代价必须记录:异步化会使「库未加载完时的用户操作」被永久丢弃。涉及此模式必须登记 pending,待加载完成后补渲染。
7.3 测试基线
| 项 | 数量 | 说明 |
|---|---|---|
后端 @Test 用例 |
841 个,分布在 109 个测试类 | JUnit5 + MockMvc + @ActiveProfiles("h2");全仓无 @Disabled,即 841 个全部实际执行 |
| 前端用例 | 69 条,分布在 6 个 spec 文件 | Vitest;覆盖 http(11) / embed bootstrap(17) / embedGuard(12) / composerReset(17) / enterKey(5) / runtimeMode(7) |
几条被写进仓库约定的测试纪律,都是从真实事故里长出来的:
- 一律用
mvn clean test,不要只编译——增量编译在「改源码 → 还原」后会跳过重编译,产生陈腐字节码,让测试假绿。 - MockMvc 断言中文必须用
getContentAsString(UTF_8),否则乱码导致断言误判。 - 护栏型测试要用「反向断言」——例如 SPA 回落测试不仅断言
/chat返回 200,还要断言/api/**仍然 404,防止有人图省事改成通配。 - 变异测试是唯一能证明「护栏非空转」的手段;mock 把异步建成同步会掩盖真实缺陷。
7.4 真实数据库校验
平台在数据库选型上经历了从 MySQL 到 PostgreSQL 的迁移,方案与校验记录沉淀在 docs/mysql-to-postgres-migration-plan-20261013.md。三条约束:
- H2 用于零安装自测,但 H2 与 PG 在类型、方言、向量扩展上并不等价,因此关键路径必须在真实 PostgreSQL 上复验,尤其 PGVector 的维度与索引行为。
- 业务库与 RAG 向量库分离,迁移时可分别推进、分别回滚。
- 多数据源(Oracle / SQLServer / 达梦 / 人大金仓)靠各自 JDBC 驱动内置,版本在
pom.xml中显式锁定,避免传递依赖漂移。
八、总结与展望
8.1 这套平台做对了什么
回到第一节的五个痛点,逐一对照:
| 痛点 | 平台给出的答案 |
|---|---|
| 模型绑死 | 端点抽象 + OpenAI 兼容协议,换供应商只改配置 |
| 知识接不进来 | POI + PDFBox 真实抽取七种格式;RAG 侧后置标签过滤保证「只看该看的」 |
| 数据查不到也管不住 | NL2SQL + 元数据增强;dataScope 派生表包裹做行级过滤,fail-closed 兜底 |
| 流程不可控 | 可视化工作流 + 人工审批节点 + 审计留痕 |
| 与既有系统割裂 | CSP frame-ancestors 白名单 + /embed 复用主站组件,零改造嵌入 OA |
更本质的一点是安全方向的一致性:SQL 侧 denyAll 返回空集而不是放行、RAG 侧无组织上下文时按不可见处理、DataScopeLevel.parse 未知值兜底 SELF、回跳校验任何一条不满足即回落 /chat——这四处的失败方向全部收敛到最小可见集。数据权限最危险的失效模式从来不是「报错」,而是静默放大。
8.2 下一步
几条已经在推进或评估的方向:
- 审批闭环的移动端触达——把待办推送到企微 / 钉钉,缩短审批时延。
- NL2SQL 语义层增强——扩充元数据与同义词,把「语法正确」推向「口径正确」;并探索执行前静态风险校验(如禁止无
LIMIT的全表扫描)。 - 多模态附件理解——M11 已打通附件文本抽取,下一步让图片类附件也进入检索链路。
- 可观测性——把 SSE 首字节时延、RAG 裁剪率、工具调用成功率做成标准看板,让「为什么慢 / 为什么答错」可定位。
- 组织同步适配器扩充——在 OA / EAS / SCIM 之外,覆盖更多自研组织模型。
附:配图清单
发布时请把
./images/0N-xxx.png替换为 CSDN 图床链接(拖拽或 Ctrl+V 粘贴进 CSDN 编辑器即自动上传并生成链接)。下表 10 项与正文引用一一对应,不重不漏。
| 占位符 | 本地文件 | 建议图注 |
|---|---|---|
| 图 1 | ./images/01-login.png |
登录页:深色品牌化登录,登录审计与 ?redirect= 回跳校验入口 |
| 图 2 | ./images/02-chat.png |
智能对话:SSE 流式输出、思考过程框、RAG 引用来源 |
| 图 3 | ./images/03-kbs.png |
知识库管理:一级路由 /kbs,文档抽取状态与索引重建 |
| 图 4 | ./images/04-users.png |
用户与权限:用户/角色/权限点管理,角色 data_scope 配置 |
| 图 5 | ./images/05-endpoints.png |
大模型端点:多端点管理、启停切换、连通性测试 |
| 图 6 | ./images/06-tools.png |
工具配置:可插拔工具注册中心,参数 Schema 与执行类型 |
| 图 7 | ./images/07-agents.png |
智能体管理:多智能体编排,绑定工具/知识库/工作流 |
| 图 8 | ./images/08-workflows.png |
流程管理:可视化工作流编排,含条件与人工审批节点 |
| 图 9 | ./images/09-datasources.png |
数据源管理:多数据源接入与 NL2SQL 业务元数据 |
| 图 10 | ./images/10-embed.png |
嵌入白名单:iframe 可信三方域名,CSP frame-ancestors |
说明:本文所有截图来自本地运行实例的真实界面;代码片段均取自本仓库
agent-service与agent-front源码,未做演绎改写。技术栈版本以pom.xml与package.json为准。

