100毫秒,这是人眨一次眼的时间,而50毫秒是推荐系统留给召回环节的时间。作为召回拆解来看,召 是提取检索,回 是返回结果。在眨眼一半的时间里,系统必须从全库上亿条视频中,凭借直觉检索返回你最可能感兴趣的那一千条。
在很多人的想象中,算法应该是个全职的上帝,他先逐帧读懂每一条视频的深意,确认绝对安全且精准后,再把它推到你面前。但在真实的工业界,这种先深度理解后精度推荐的逻辑会带来巨大的计算和时间成本。如果用最先进、最精密的深度学习模型,把全库视频逐一拿出来分析比对,它们跟你过去的每一个点赞、每一次停留是否哪怕有一丁点关联,等结果出来时,视频里的博主可能都已经塌房退网了。所以,推荐系统不是在实验室里做理想化的选优问题,而是在现实的极限时间约束下进行综合平衡的选择。面对亿级候选,需要的不是显微镜,而是一张覆盖面极广、收网速度极快的大网。这张大网在工程里被称为召回,它是整个推荐流程的第一道防线,也是一场舍弃精度换取速度的海选艺术。
推荐系统漏斗架构
推荐系统经典的漏斗架构,是一个分层筛选的倒金字塔。
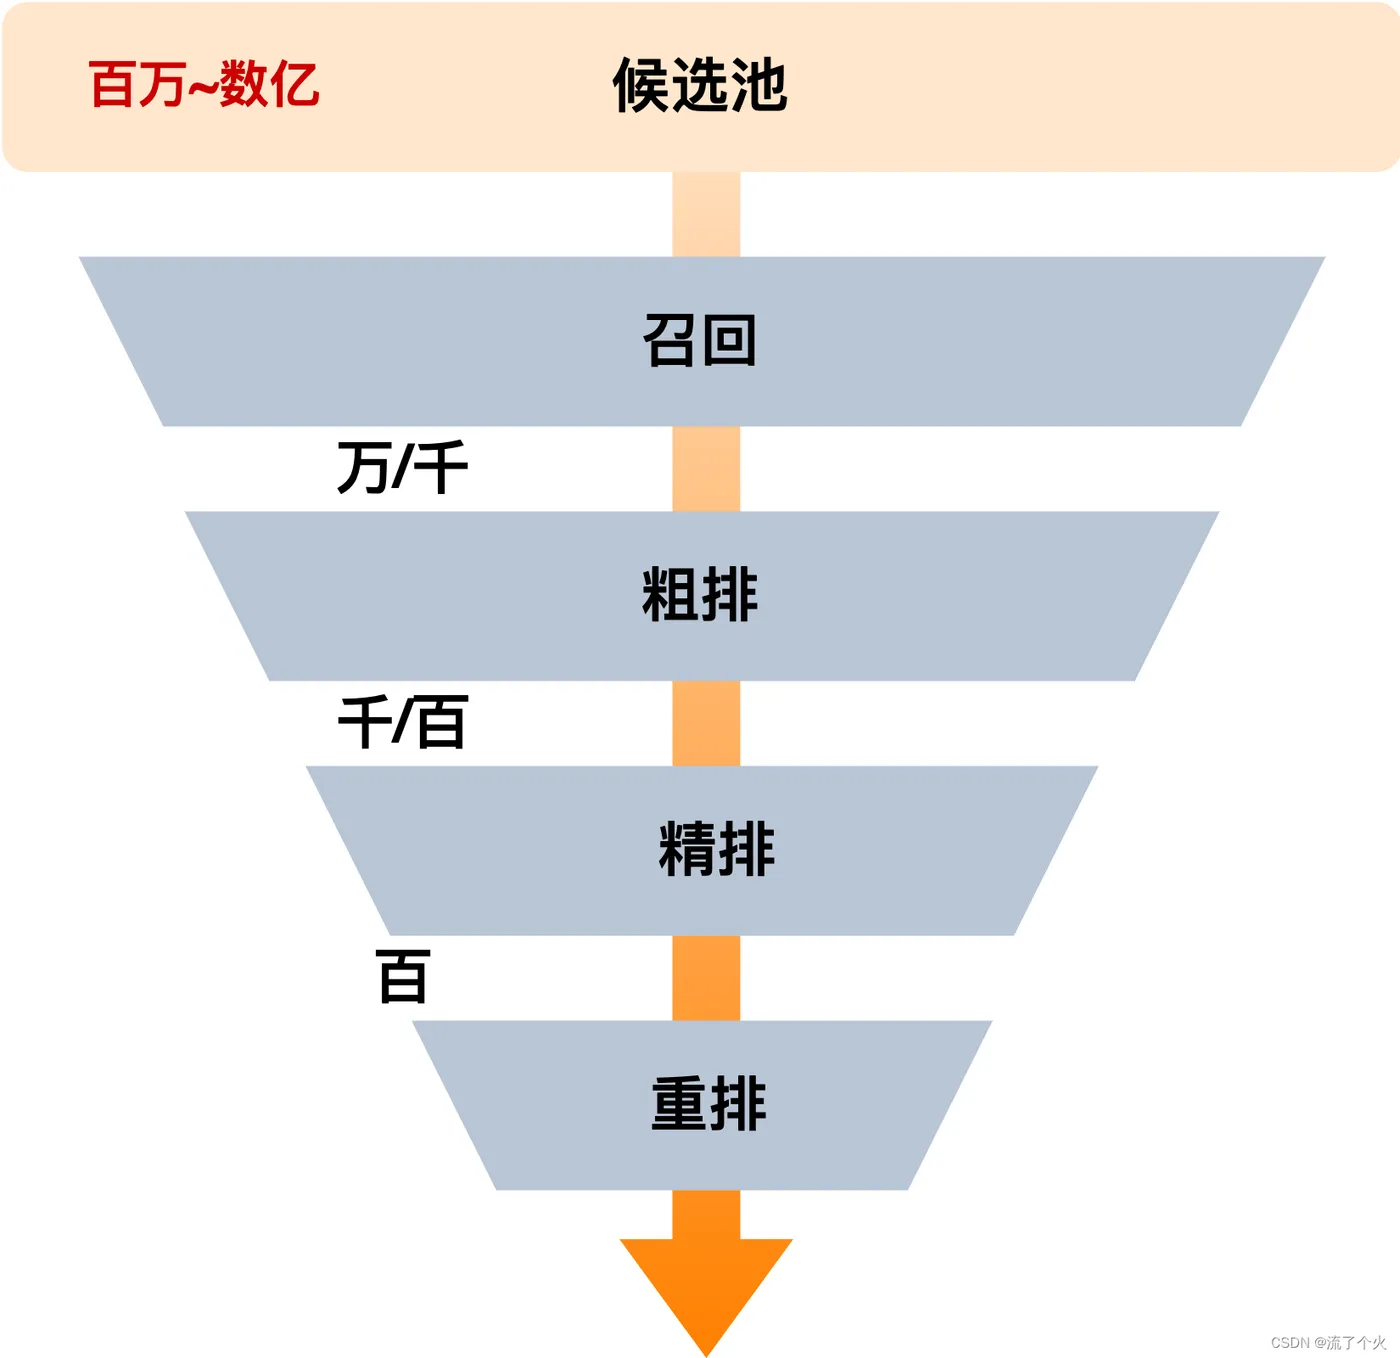
- 最顶层的是召回环节,承担着整场海选最繁重的体力活,将视频数量从亿级瞬间压缩到千级
- 往下一层是粗排和精排,负责从这几千个候选里挑出你最感兴趣那一百个,并以合适的顺序呈现在你面前。
我们会发现每往下一层,计算就会变得越精细,但处理的数据量会指数级骤减。作为整个系统性能的第一道防线,召回有两个极端的要求,一是低延迟。在线计算必须在10到50毫秒内完成。二是高召回率。召回层追求的是全面,排序层追求的是精准
衡量两者的指标分别是召回率和精确率。很多人容易搞混。我们举一个具体的例子,假设库里有1000个视频,其中你真正感兴趣的有100个,召回这一网下去捞上来了200个候选,有80个是你喜欢的,剩下的120个是你没兴趣的。而剩下的那800个没被捞上来的视频里,其实还藏着20个你的真爱,真正过滤的有780个。你会发现召回率上去了,精确率却会随之暴跌。要想把感兴趣的都捞上来,网撒的就得越大。
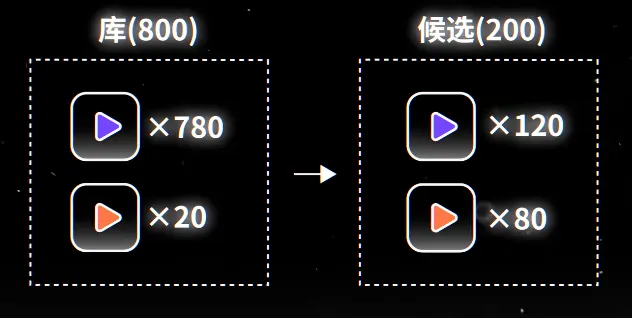
在召回层,我们的口号永远是宁可错捞一千,绝不放过一个。
非个性化策略召回
这类策略完全不看你是谁,只看内容的宏观统计表现。比如
- 热点路,它是为了保证时效性,把全网近期最火的 top 100条视频塞给你,让你不做过任何一个梗。
- 高效率路则只看转化,把那些高点击率、完播率的高分神作捞进来。
- 最后还有运营策略路,这是平台的硬广,比如刚买的电影版权或氪金的作品。
这些策略简单粗暴,保证你打开app时不会看到一片空白,而是能看到这个平台上最稳妥、最受欢迎的内容。
“冷启动”问题的其中一种解决方式,冷启动的解决方案详解请看冷启动(上):没有历史数据,推荐系统如何迈出第一步?
个性化策略召回
但如果只靠非个性化策略,推荐系统就变成了大喇叭广播,毫无灵魂。真正决定用户体验的是第二类个性化的策略,针对你的兴趣实现用户和视频的精准匹配
在逻辑范式上,它通常分为三类:
- UtoI 从你找视频,比如你是个猫奴,系统就去库里给你找猫视频。
- ItoI 从视频找视频,你刚逛完小猫跳舞系统就去寻找内容相似的视频。
- UtoUtoI 通过中间人找视频,得到跟你口味像的人,把他们看过的视频顺手安利给你
为了实现这些范式,我们需要几套硬核的数学工具。
协同过滤
最经典的方法是协同过滤,主要思想是通过群体的行为来找相似性。
基于物品的协同过滤(ItemCF)
基于物品的协同过滤通过物品之间的相似度来推荐,把一些和用户最近看过的物品相似的物品推荐给用户
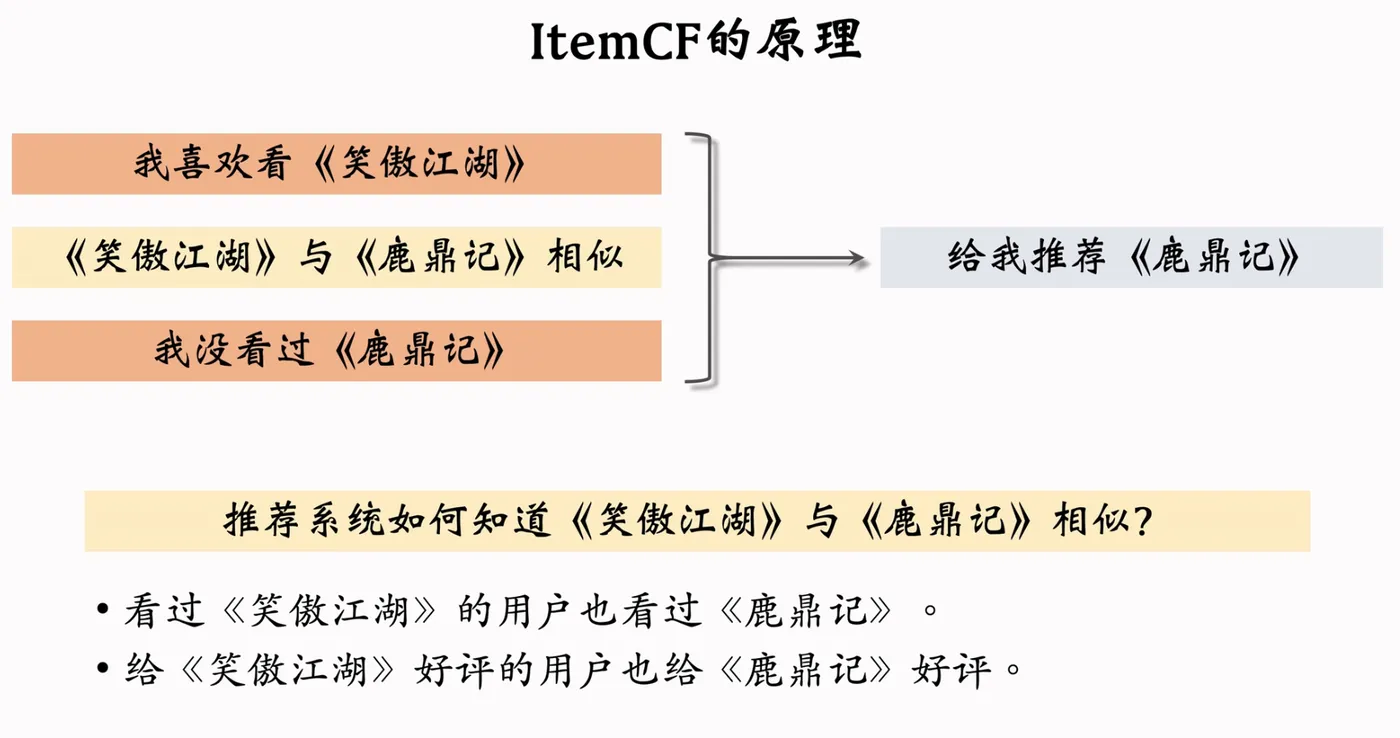
推荐系统如何知道,笑傲江湖与鹿鼎记相似呢?
- 知识图谱:两本书的作者相同,所以两本书相似
- 基于全体用户的行为,判断两个物品的相似性:比如看过笑傲江湖的用户。也看过鹿鼎记,给笑傲江湖写好评的用户,也给鹿鼎记写好评,我们可以从用户的行为中挖掘出物品之间的相似性,在利用物品之间的相似性作推荐
下图中预估用户对该物品的兴趣为: 2×0.1+ 1×0.4 + 4×0.2 + 3×0.6
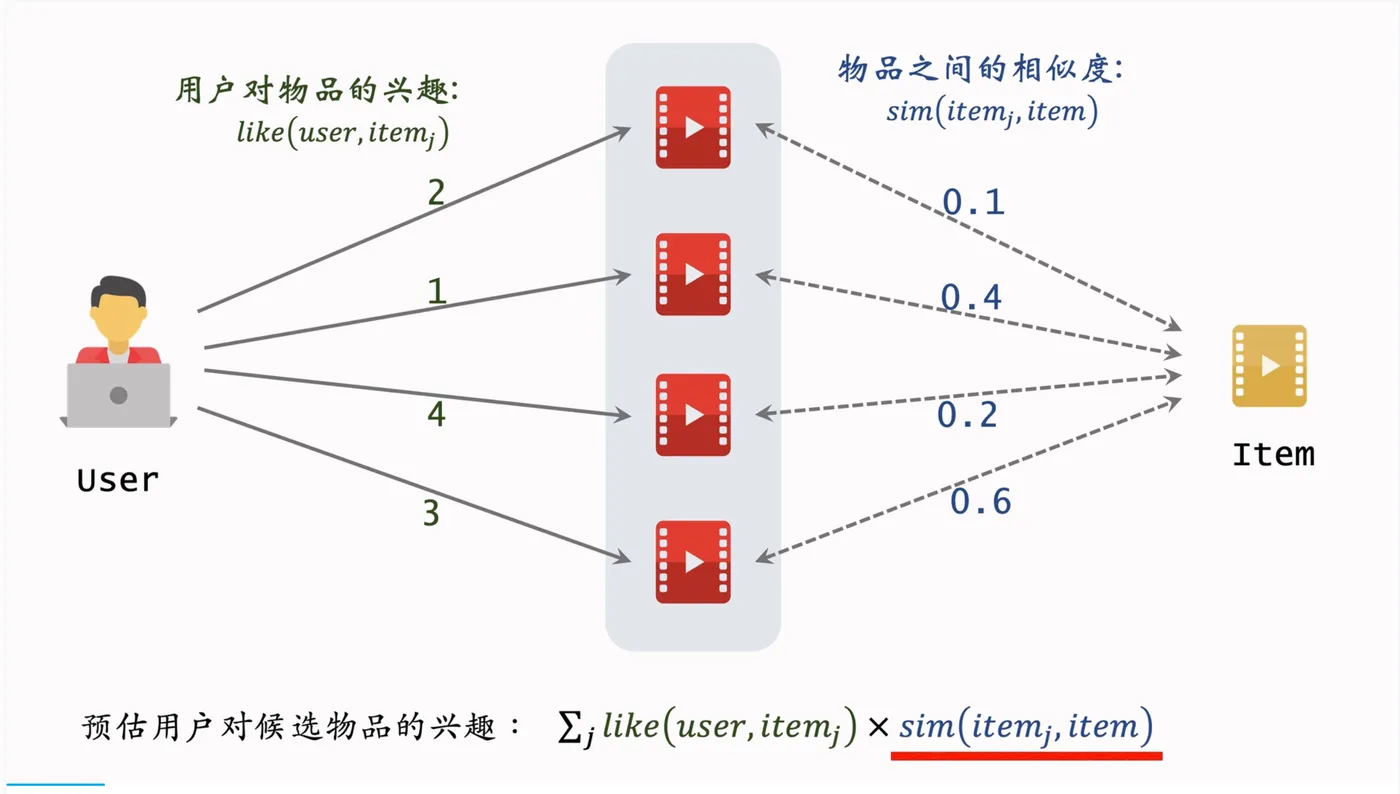
具体如何计算两个物品的相似度?
计算物品相似度的基本思想是 两个物品的受众重合度越高,两个物品就越相似。我们可以从数据中挖掘出物品的相似度。举个例子,喜欢射雕英雄传和神雕侠侣的读者重合度很高,因此可以认为射雕英雄传和神雕侠女相似
不是根据物品的内容判定物品相似,而是根据用户的行为来判定物品相似
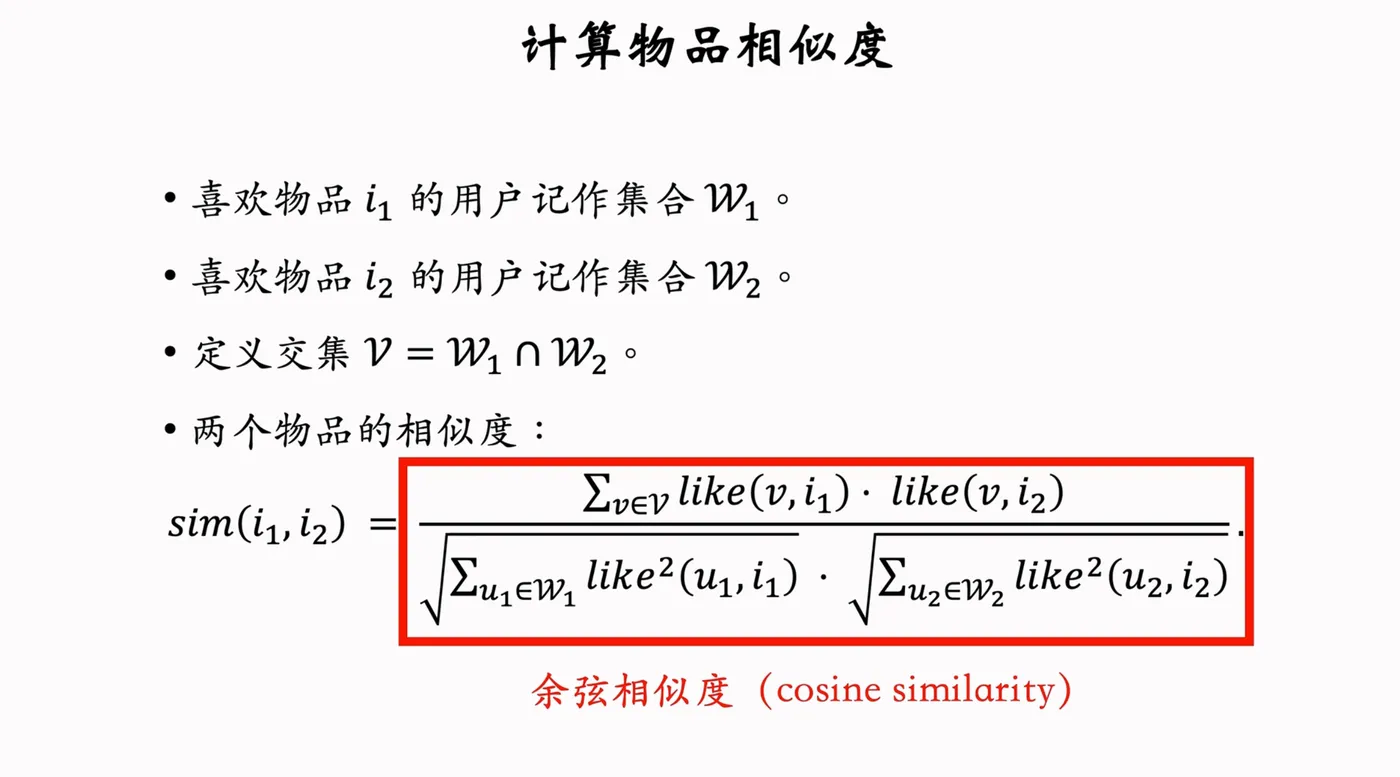
ItemCF 召回的完整流程
离线计算建立索引
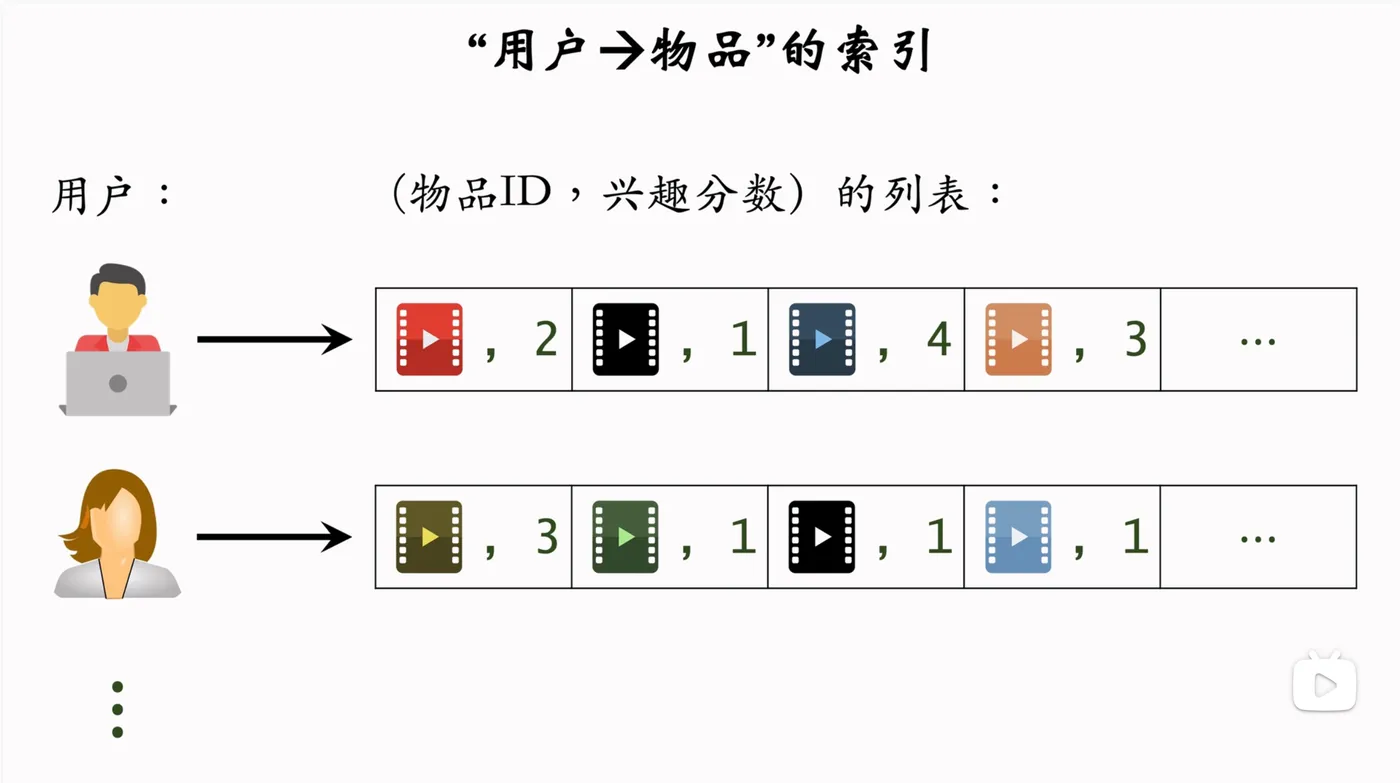
为了能在线上做到实时的推荐,系统必须要事先做离线计算 建立两个索引。一个索引是用户到物品,索引记录每个用户最近点击过交互过的物品的ID,比如最近交互过的200个物品。有了这个索引之后,给定任意用户ID,可以快速返回它近期感兴趣的物品列表。
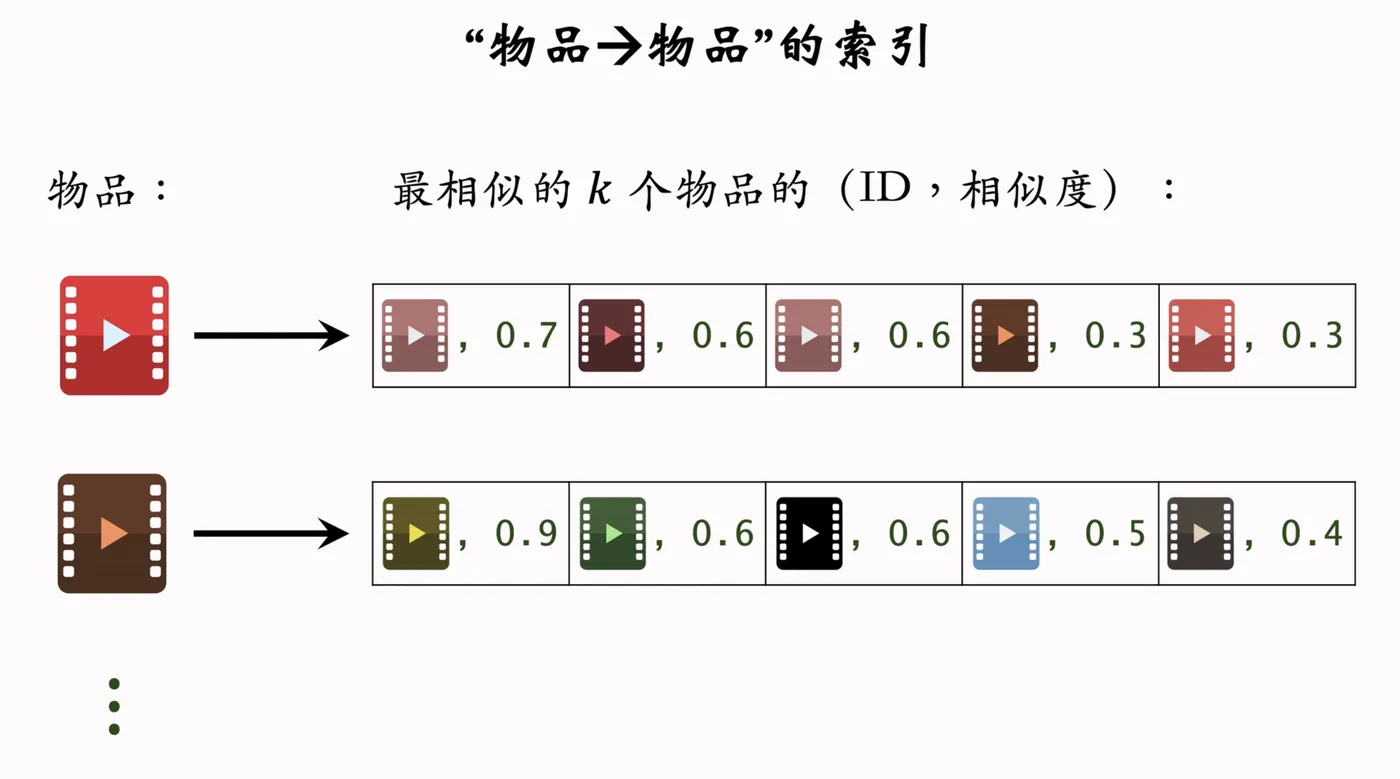
另一个索引是从物品到物品,我们首先要计算物品之间两两相似度,这个计算量会比较大。对于每个物品,索引它最相似的 K 个物品,有了这个索引之后,给定任意物品 ID,可以快速查出它最相似的 K 个物品的 ID,而且知道相似度分数
线上实时推荐
首先查看用户到物品的索引,可以快速找到这位用户近期感兴趣的物品的列表(Last-n),对于 last-n 集合中的每个物品,利用物品到物品的索引,找到 topk 相似物品,用户最近有 n 个感兴趣的物品,我们又找到了每个物品的 topk 相似物品,那么一共取回 n×k 个物品。对于取回的 n×k 个相似物品,预估用户对物品的兴趣分数,按照分数从高到低对物品做排序,返回分数最高的100个物品。
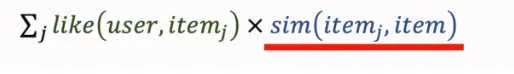
这100个物品就是 itemCF 这个召回通道的输出,会跟其他召回通道的输出融合起来。然后做排序最终展示给用户。为什么要用索引,数据库中有上一亿个物品,如果挨个用公式计算用户对所有物品的兴趣分数。计算量会爆,索引的意义在于避免枚举所有的物品
Swing 召回
在工业界的推荐系统中,ItemCF 是最重要的召回通道之一,为了能在线上非常快速的做召回。ItemCF 的一个变体叫做 Swing,在工业界很常用,Swing 跟 ItemCF 非常像,唯一的区别就是怎么样定义物品的相似度。
item-cf 的不足之处
假如 itemCF 相似度计算里的重合的用户是一个小圈子,小圈子中的分享就会导致系统误判两个物品的相似度。比方有 4个用户都在同一个微信群里面。左边的物品是这样一篇笔记,某网站护肤品打折,右边的物品是笔记字节裁员了。这两篇笔记没有什么相似之处,他们的受众差别很大,但是两篇笔记碰巧被分享到同一个微信群里面。微信群里有很多人同时点开这两篇笔记,这样就造成一个问题,两篇笔记的受众完全不同。但是很多用户同时交互过两篇笔记,导致系统错误的判断两篇笔记的相似度很高
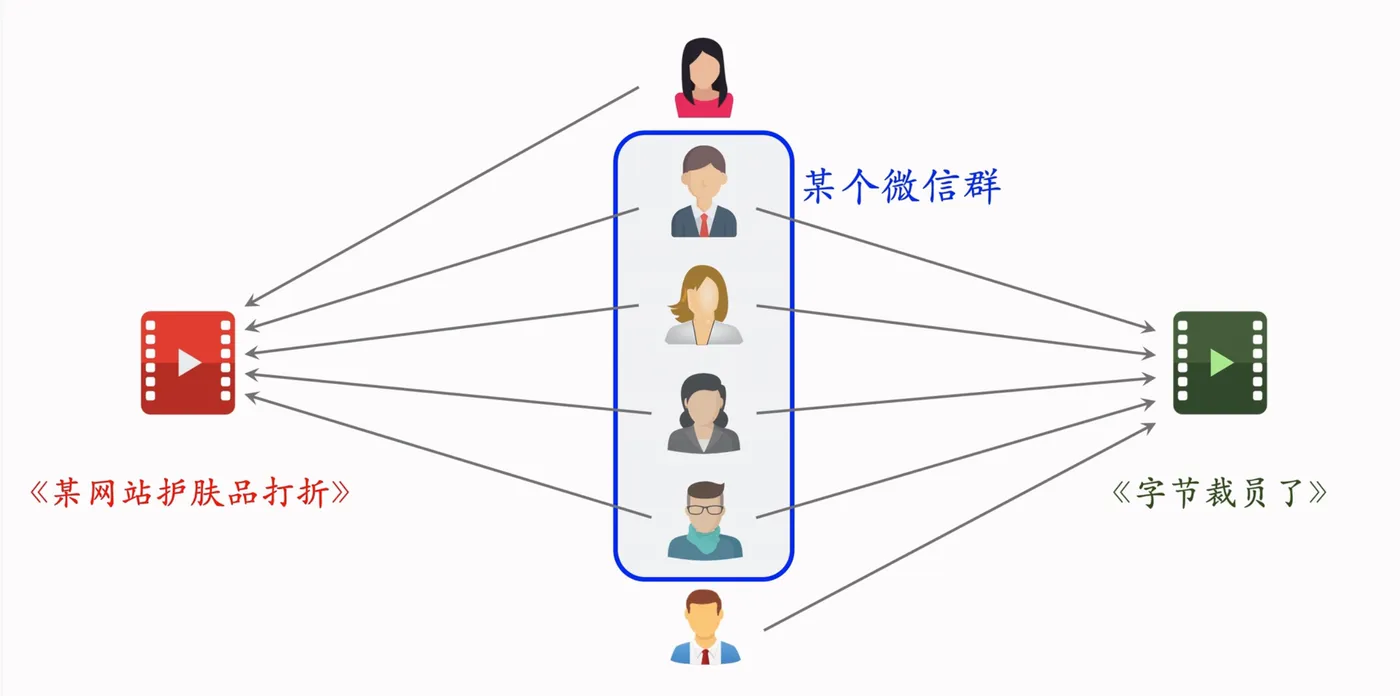
想要解决这个问题,就要降低小圈子用户的权重。我们希望两个物品重合的用户广泛而且多样,而不是集中在一个小圈子里,一个小圈子的用户同时交互两个物品,不能说明两个物品相似。反过来,如果大量不相关的用户同时交互两个物品,则说明两个物品有相同的受众。Swing模型的原理,就是给用户设置权重,解决小圈子问题。
Swing 模型把用户 (U_1) 喜欢的物品记为集合 (J_1),把用户 (U_2) 喜欢的物品记为集合 (J_2)。定义两个用户重合度为j1与j2的交集的大小,记作 overlap(u1, u2) = |(J_1) ∩ (J_2)|。这个值越大,说明两个用户的重合度越高,越有可能是一个小圈子的人。
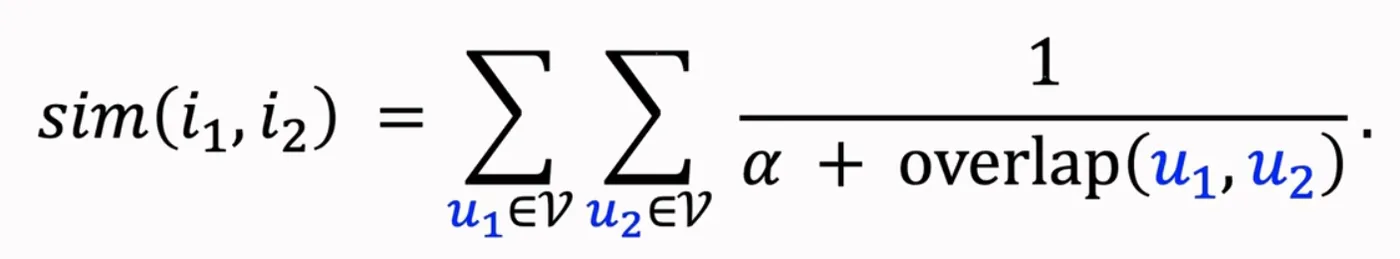
要降低他们的权重,在计算物品相似度的时候,会把 overlap(u1, u2) 放到分母上,重叠大说明两个人是一个小圈子的,那么他们两个人对相似度的贡献会比较小,反过来如果overlap小,那他们对相似度的贡献比较大,用overlap 可以降低小圈子对相似度的影响
把喜欢物品 (i_1) 的用户记作集合 (W_1),把喜欢物品 (i_2) 的用户记作集合 (W_2)。
集合 (V) 是 (W_1) 和 (W_2) 的交集。
总结
swing 和 itemcf 是非常相似的两种方法。他们唯一的区别就是在于如何计算物品的相似度,在计算物品相似度的时候要降低小圈子用户的影响
基于用户的协同过滤(UserCF)
ItemCF 是基于物品之间的相似性作推荐,UserCF 是基于用户之间的相似性作推荐。首先解释 UserCF 的原理:
比如我是小红书的用户,我在小红书的点击点赞收藏转发可以体现出我的兴趣爱好。小红书可以从大数据中挖掘出来和我们兴趣爱好非常相似的网友,今天其中某个跟我兴趣非常相似的网友看了篇笔记,他很感兴趣对笔记点赞转发。于是小红书就知道他喜欢这篇笔记,而我还没有看过这篇笔记,那么推荐系统就有可能给我推荐这篇笔记。推荐的理由就是跟我兴趣爱好相似的网友喜欢这篇笔记推荐系统具体如何找到跟我兴趣非常相似的网友呢?
方法一:判断两个人感兴趣的笔记有多少重合,每个用户都有一个列表,上面存储点击/点赞/收藏/转发的笔记ID。对比两个用户的列表就知道有多大的重合,重合越多说明两个人的兴趣越相似。
方法二:不看笔记的重合而看作者的重合,每个用户都会关注一些作者。对比两个用户关注的作者列表就是到底多少关注的作者是重合的, 关注的作者重合越多说明两个人的兴趣越相似
UserCF 召回的完整流程
离线计算建立索引
一个索引是用户到物品,索引记录每个用户最近点击过交互过的物品的ID,比如最近交互过的200个物品。有了这个索引之后,给定任意用户ID,可以快速返回它近期感兴趣的物品列表
另一个索引记录两个用户之间的相似度。 如果两个用户喜欢的物品重合度非常高,他们的兴趣点相似,他们的相似度就高
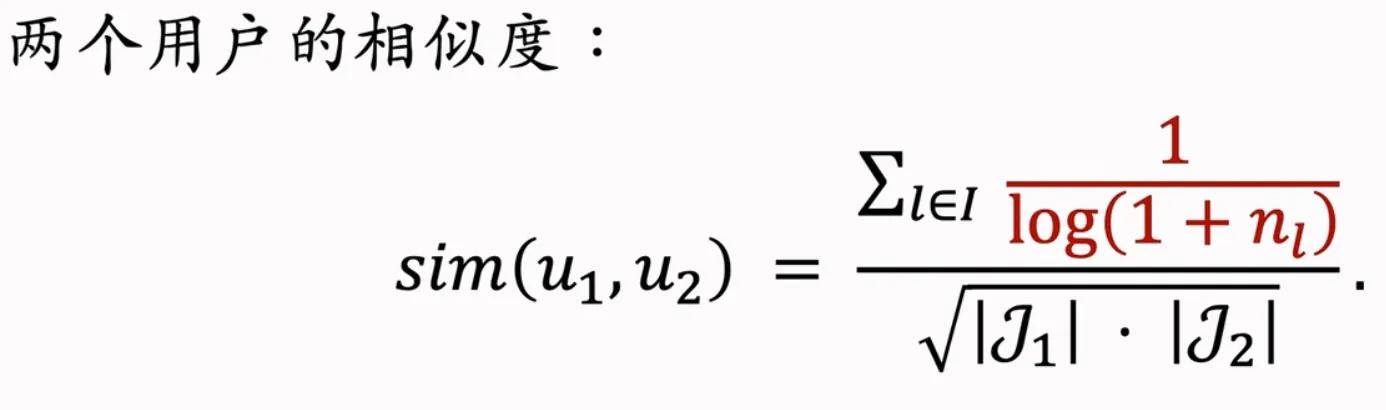
> 把用户U1喜欢的物品寄作集合 \(J_1\)
> 把用户 \(U_2\) 喜欢的物品寄作集合 \(J_2\),
> 交集 \(I\) = \(J_1\) ∩ \(J_2\)
> \(n_l\):喜欢物品 l 的用户数量,反映物体的热门程度
>
> **为什么需要有 \(n_l\) 参数?** 因为公式不能同等对待热门和冷门的物品
>
> 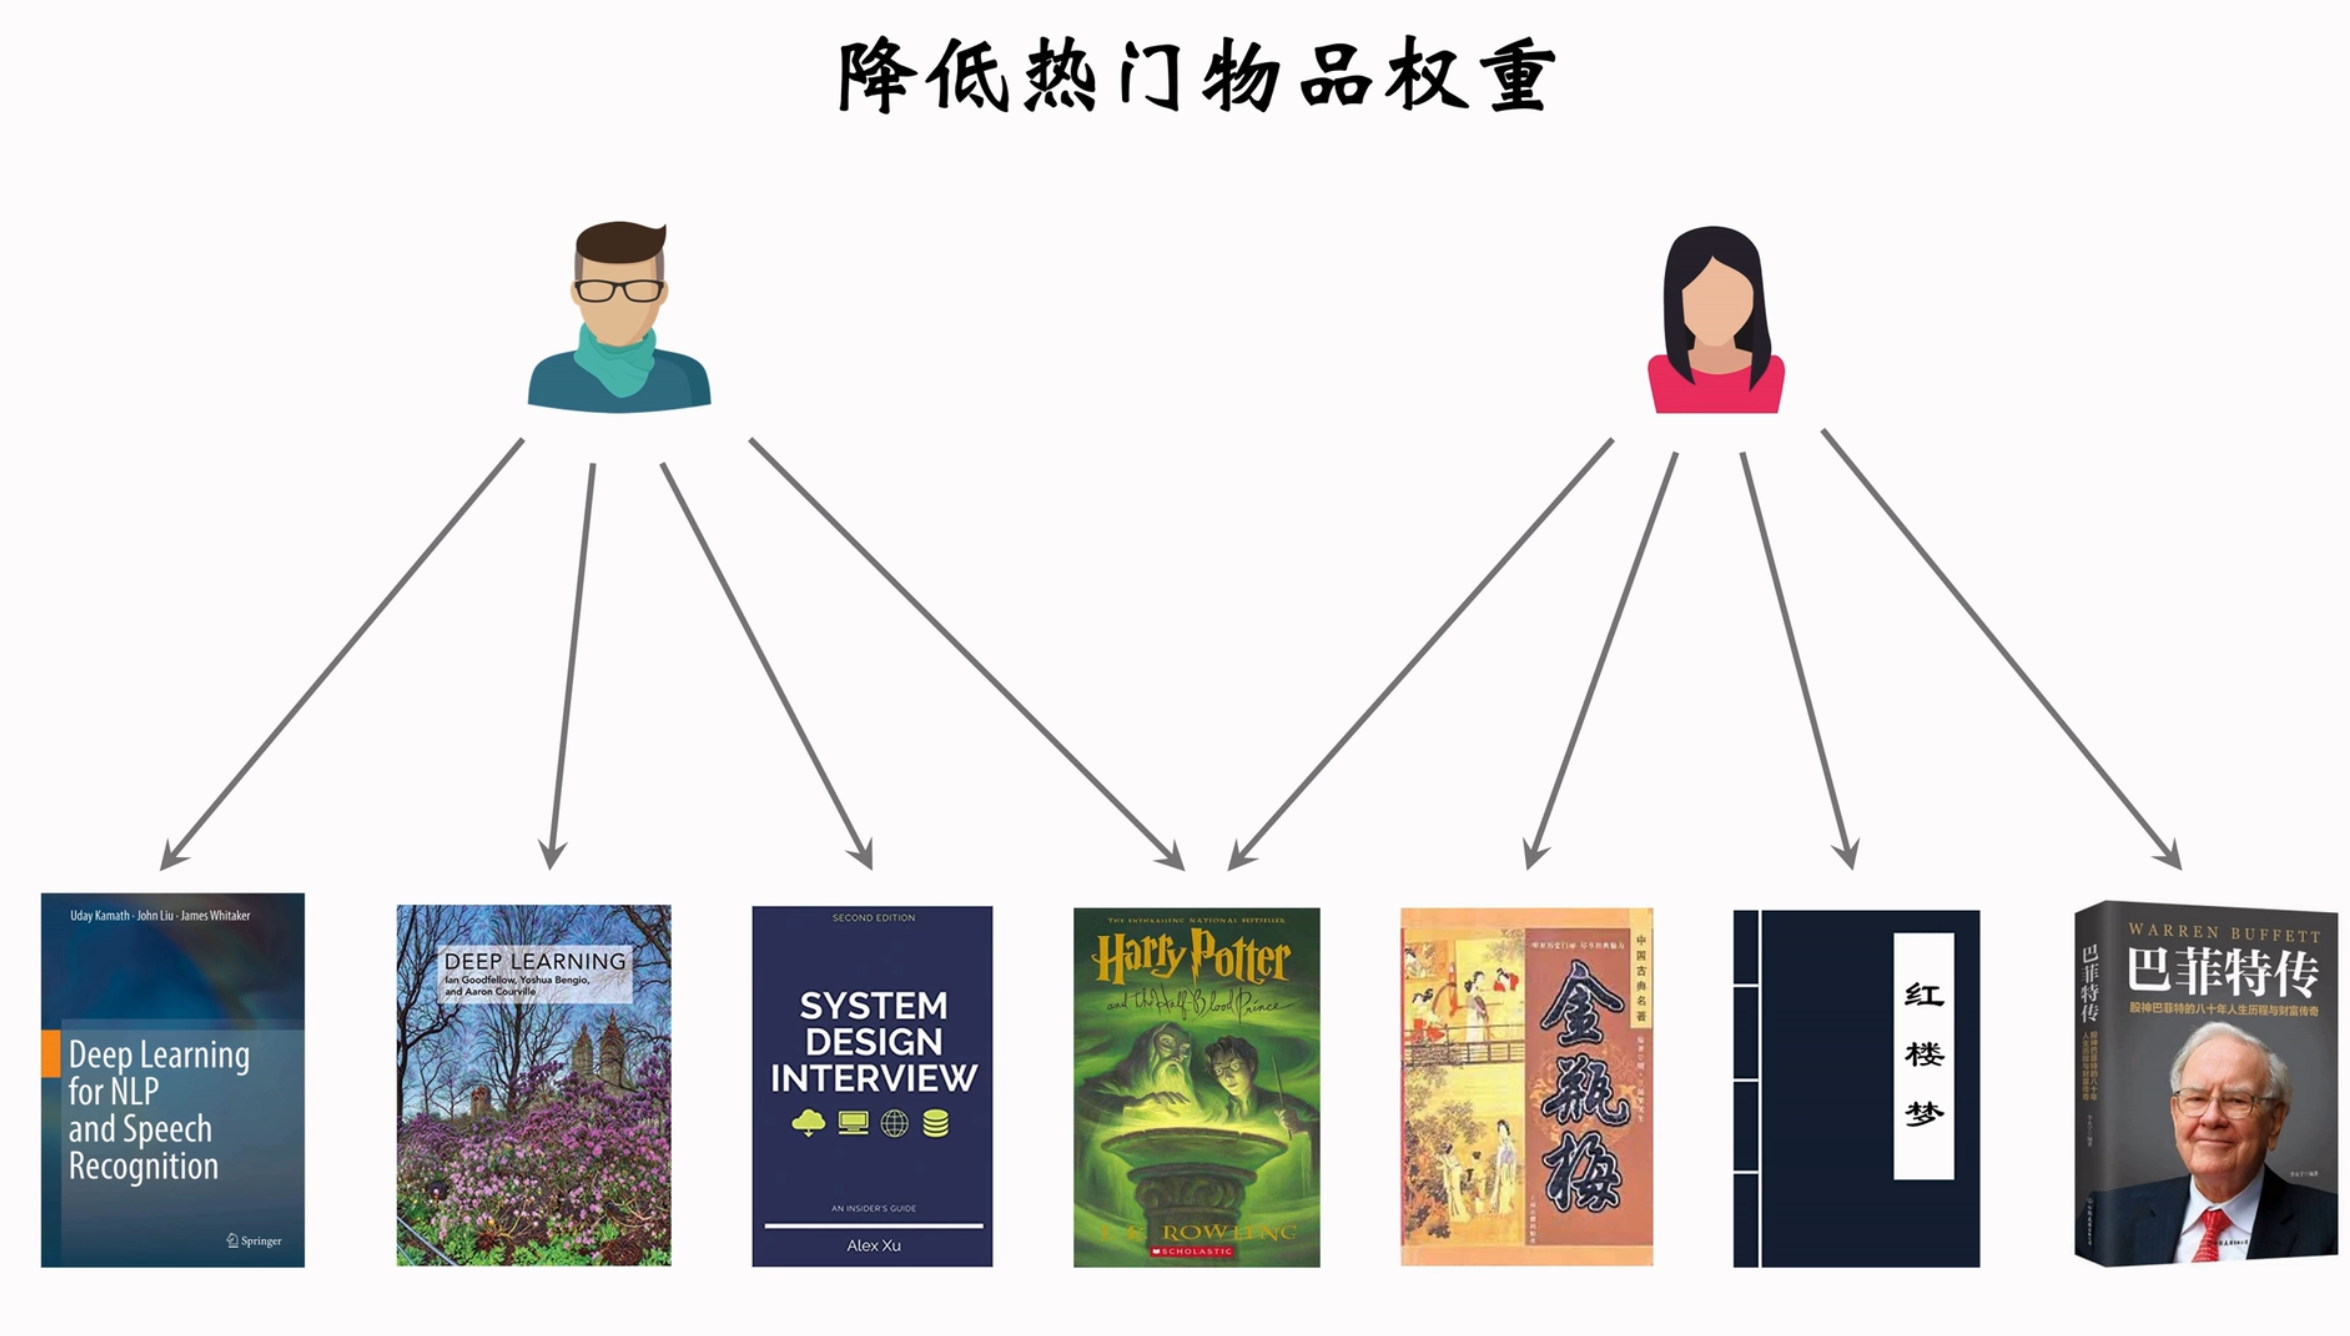
> 拿书籍推荐举个例子。哈里波特是非常热门的物品,不论是大学教授还是中学生都喜欢看哈里波特。既然所有人都喜欢看哈里波特,那么哈里波特对于计算用户相似度是没有价值的。**越热门的物品,越无法反映出用户独特的兴趣,对计算相似度就没有用,反过来,重合的物品越冷门,越能反映出用户的兴趣**。
线上实时推荐
首先找到与这位用户最相似的 K 个用户,对于这 k 个用户,利用用户到物品的索引,找到每个人近期感兴趣的物品的列表(last-n),有了K个相似用户。每个用户有 N 个物品,那么一共取回了 (nk) 个物品,对于取回的 (nk) 个物品。对于取回的 (nk) 个相似物品,预估用户对物品的兴趣分数,按照分数从高到低对物品做排序,返回分数最高的100个物品。
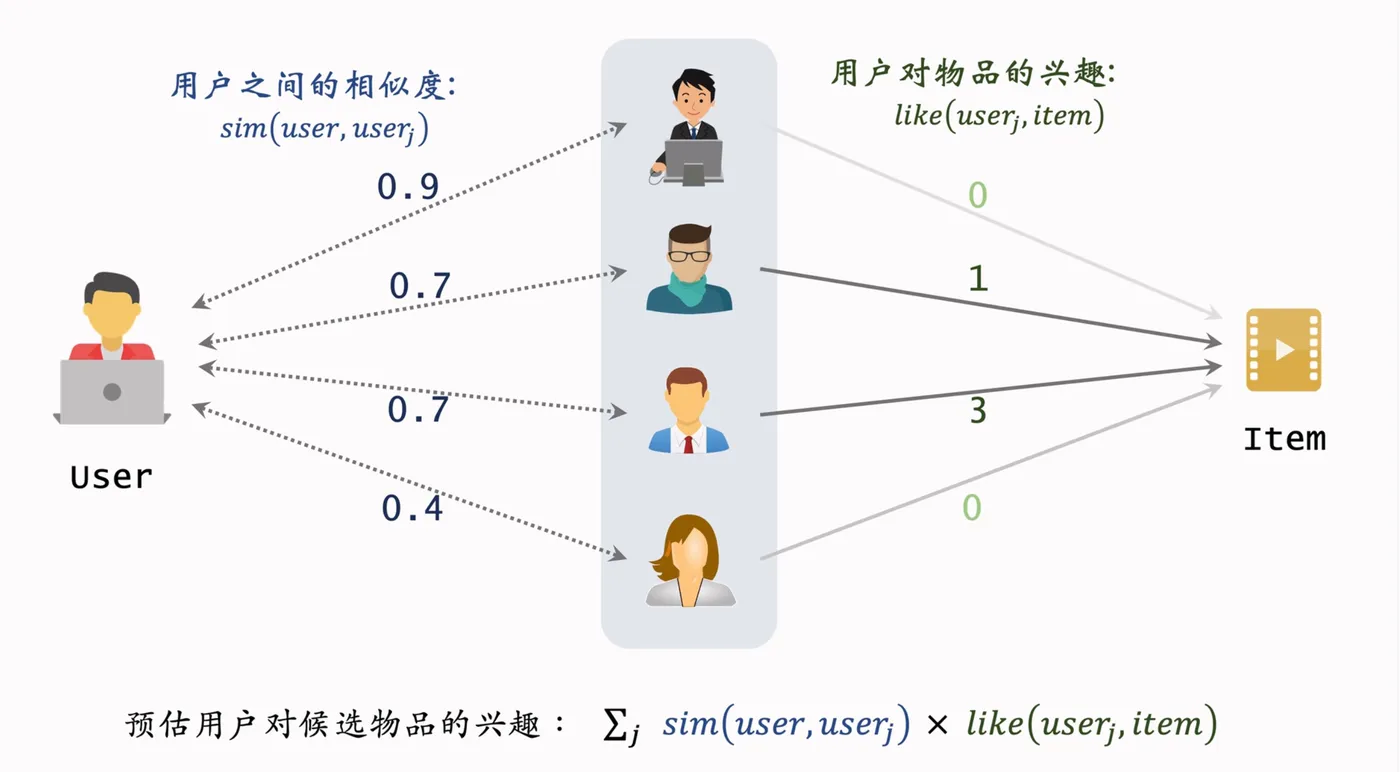
把相似度和兴趣分数相乘。再把所有的成绩都加起来的到总分,表示用户对候选物品的兴趣。
例如,有2000个候选物品。我们逐一计算用户对候选物品的兴趣分数,然后返回其中分数最高的100个物品
基于内容标签召回
第二种方法是内容标签召回,这是 ItoI 逻辑的实现。抖音每天有上一条新视频上传,在他们刚发布的头几分钟里,播放量是0,点赞也是零。此时协同过滤会彻底失效,因为新视频在贡献矩阵里是一篇空白,基于内容特征的召回就成了救命稻草。如果你正在看一条新视频,系统会获取这个视频的内容特征,然后去视频库里检索相似的内容。
也是“内容冷启动”问题的一种解决方式
社交召回
第三种方法是社交召回,它基于你的好友列表社会环境,把他们点击过的视频推荐给你。他利用的是人类的社会属性,同一个圈子的人品位往往也差不多。
作者召回
维护的索引:
- 用户关注的作者
- 作者发布的内容
有交互的作者召回
如果用户对某篇内容感兴趣(点赞、收藏、转发),那么用户可能对该作者的其他笔记感兴趣
维护的索引:
- 用户 -> 关注的作者(需要及时更新,仅保存最近交互过的作者)
相似作者召回
如果用户喜欢某作者,那么用户可能还会喜欢相似的作者
维护的索引:
- 作者 -> 相似作者(作者相似性的计算类似于 ItemCF,如果两个作者的粉丝有很大的重合,那么这两个作者是相似的 )
地理召回
第四种方法是地理召回,它基于你附近3公里的人,把他们点击过的视频推荐给你(因为用户可能对自己附近发生的事感兴趣)。
索引方式:
根据用户定位的GeoHash,取回 k 篇该位置的优质内容列表 (因为这条召回路径没有个性化,所以需要优质内容)
GeoHash:对经纬度的编码,地图上一个长方形的区域
根据用户定位的城市,根据用户所在城市或者曾经待过的城市做召回
缓存召回
缓存召回的基本想法,是复用之前N次推荐系统精排的结果。
比如精排输出了几百篇笔记送入重排,重排做多样性的随机抽样。比如用 DPP 从几百篇笔记中选出几十篇,曝光给用户,也就是说精排的结果有一大半没有曝光 被浪费掉
缓存召回流程
按照精排的分数做排序,获取排名前 xx 中没有曝光给用户的,将其缓存起来,
下次用户刷新的时候,把缓存里的内容取出来,作为一路召回的结果
(精排排名靠前的(比如前 50),一般都是用户非常感兴趣的笔记,值得再次尝试)
【缓存大小固定,需要退场机制】
- 一旦笔记成功曝光,就从缓存退场;
- 如果超出缓存大小,就移除最先进入缓存的笔记
- 笔记最多被召回10 次,达到十次就退场
- 每篇笔记最多保存 3 天,达到 3 天就退场
重排在下文会提到
多路召回
每种单策略召回都像是一张特定形状的渔网,每张网都有它的盲区,内容标签看不懂潜在兴趣,协同过滤搞不定新片,社交召回覆盖不了所有人。
为了不漏掉海里的大鱼,工程师们想出了一个主意,能不能把这些不同形状的渔网叠在一起,同时撒向大海?这就是==多路召回策略==,那么多路齐发,每路都捞回来几百个视频,最后怎么合并成一个统一的后员列表给下一关呢?这个过程在工程上叫合并。
假设我们有四条路,协同过滤路、热点路、内容路和社交路。每一路都已经把捞出来的视频按分数从高到低排好了队。每一轮我们把队头的第一名塞进结果集,直到凑够那一千个名额。
多路召回有一个致命问题,各路之间完全没有统一的度量衡。热点录视频的90分代表的是流行度,而协同过滤算出的90分代表的是行为相似度。他们的物理意义完全不同,无法比较谁更有价值。
向量化召回
为了终结这种混乱,推荐系统需要向量化召回,把用户和视频内容映射到高维空间中,得到用户向量和内容向量。再计算两者之间的向量相似度,召回最相似的 top 1000个视频
要落地这个方案,工程师必须解决两个硬核问题:
一是==如何生产用户和视频的向量==,二是如何==快速计算==向量之间的相似度。
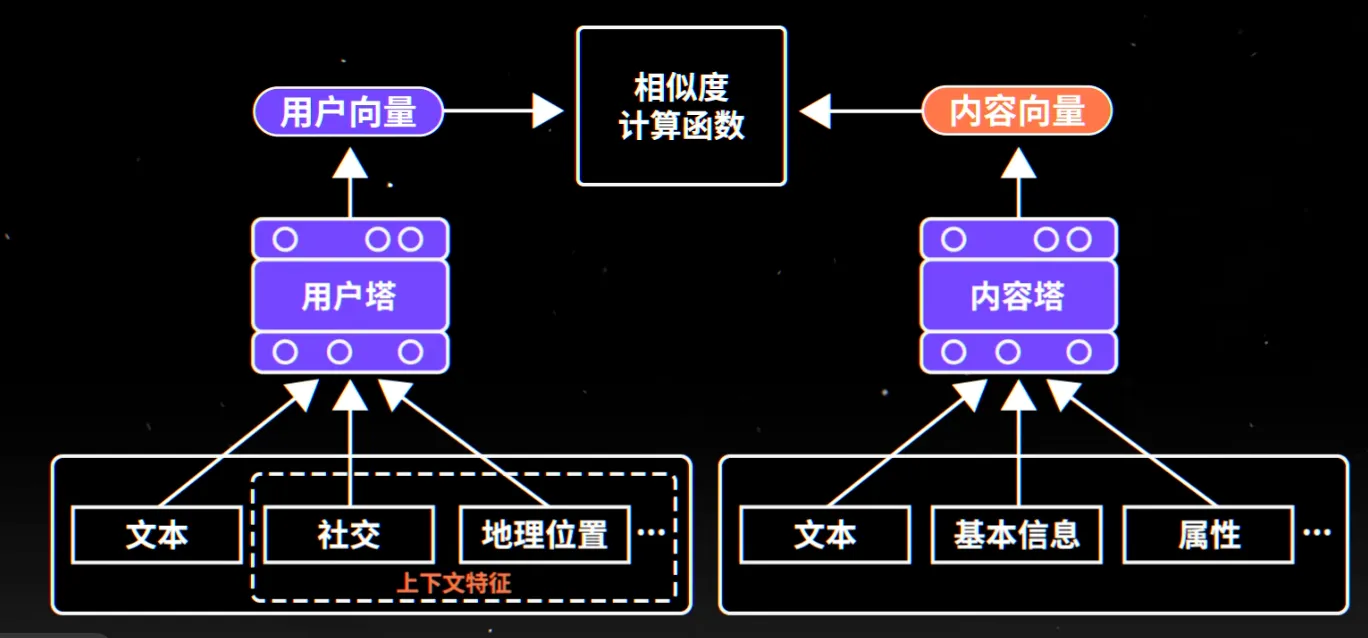
如何生产用户和视频的向量? 工业界最主流的实践方式叫做==双塔模型==。它就像两座独立运作的情报中心,左侧的用户打负责处理你的实时搜索词、地址、行为、上下文等动态特征。而右侧的内容塔负责处理内容特征,包括视频的基本信息和属性的。他们在塔顶各自吐出一个低为稠密向量,分别是用户向量和内容向量,最后计算两个向量的余弦相似度,输出召回的分数(兴趣的预估值)
物品向量通常离线计算存储,用户向量通常线上现算。
- 每一次召回只需要用到一个用户向量,但需要用到几亿个物品向量
- 用户兴趣动态变化、而物品特征相对稳定
但这里引出了第二个问题,如果用暴力搜索上一个视频向量,逐一和用户向量计算相似度,得到精度结果的同时,就损坏了召回阶段所需要的低延迟。为了实现50毫秒召回,工程师采用以精度换速度的策略——近似最近邻搜索(ANN),核心逻辑是 我不需要找出绝对最近邻距,我只要在极短的时间内找出一个大概率最近的一群邻居。
近似最近邻的几种算法
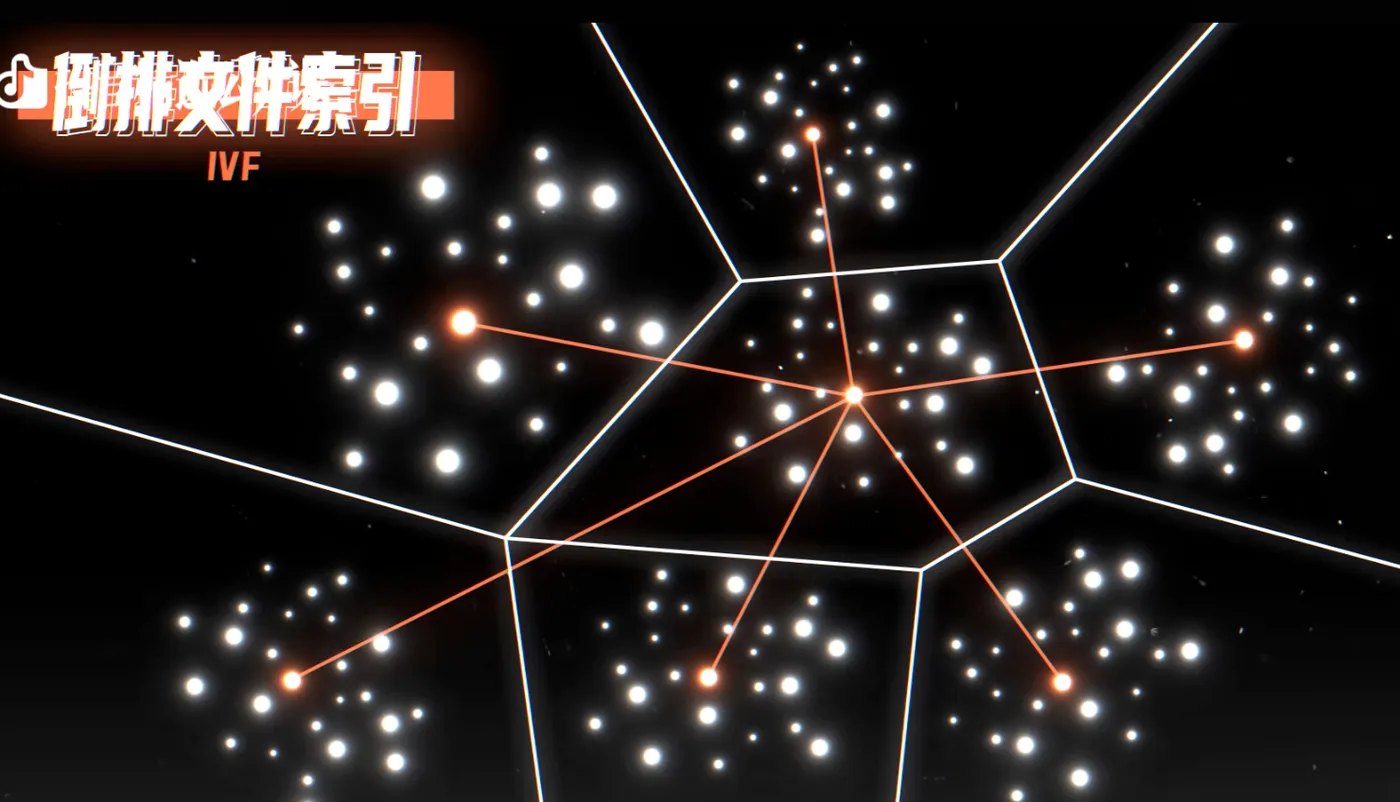
第一种算法基于距离叫做倒排文件索引(IVF)。我们可以把这些高维向量想象成一个巨大的星团,每个用户,每个视频都是这个星团上的一个点。系统会提前把星团划区,每个区选一个代表,检索时用户向量先跟这几万个代表过招,选出最近的几个代表,然后再进入他们所在的特定小区里精准打捞。
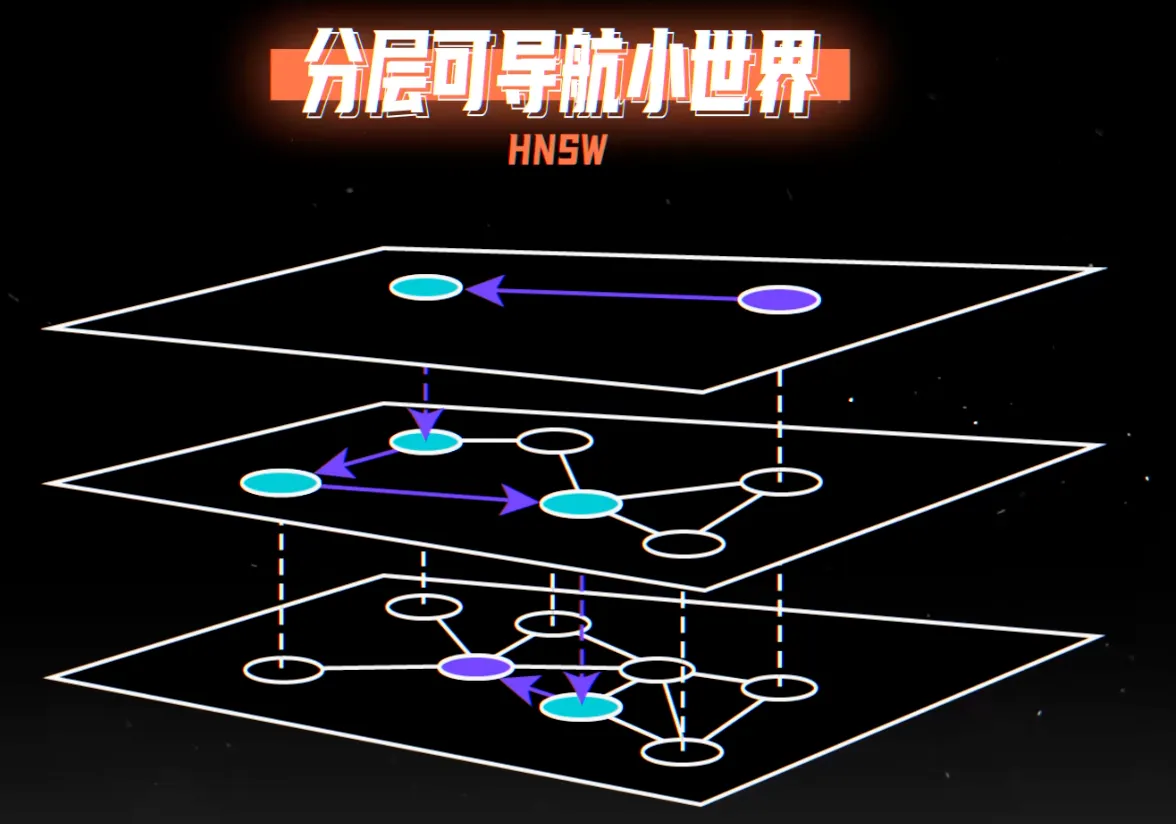
第二种是基于图的算法分层可导航小世界(HNSW)。他借鉴了社交网络里六度分隔理论,世界上任意两个人之间通过最多六个人就能建立联系,在限量空间里也具备这种小世界属性,我们也只需要通过少数几次跳转就能找到离用户向量最近的视频向量。系统会先建立张分层图,底层的节点是所有的视频向量,而上层是下层的随机抽象,所以越往上点越少,点间物理距离越大,每一层的节点都和离自己最近的几个点连线,互称为邻居。
搜索时从顶层的某个起点出发,因为点很少,你可以在空间中实现跨省级别的瞬移。每到一个节点,系统就会询问你的邻居中有离用户更近的嘛,如果有就立刻跳过去,继续进行询问跳跃。如果没有说明这一层已经搜到了头,接着你带着这层最优节点空降到下一层,重复刚才的动作,最终在最底层锁定1000个最近的邻居。
其他低延迟召回的算法
字节
Deep Retrieval
Deep Retrieval pdf经典的双塔模型把用户、物品表示为向量,线上做最近邻查找
Deep Retrieval 把物品表征为路径,线上查找用户最匹配的路径;Deep Retrieval 用路径作为用户和物品之间的中介,双塔模型用向量作为用户和物品之间的中介
阿里的 TDM
那么向量是怎么“学会”的?
向量化召回,通常通过监督学习来实现。监督学习就像做习题,每道题都有标准答案,模型做完一题就对照答案修正结果, 以此多轮训练做题的能力,提升答题的准确率。
在每一次迭代中,模型会被喂入三个样本,用户特征、喜欢的视频特征和无感的视频特征,模型的训练的目标只有几个,拉近你和喜欢视频的距离,推远你和无感视频的距离
这里的难点在于如何科学的定义正负样本。数据分布天然符合28定律,推荐库里80%的视频其实从未获得过曝光。通常我们会把你刷到且点击过的视频定为正样本,而负样本的挑选则是召回算法真正的灵魂
最基础的方法是简单随机采样,从2亿个视频里随机抓几个,这种方法能教模型学会基本的常识,这叫简单负样本。
但真正决定模型水平的是困难负采样。这种采样通常有两种硬核搞法,第一种是全局硬采样。我们用上一版的旧模型跑一遍召回,找出那些排名在第100到500名,看起来很有戏但你最终没点的视频,把它们喂给模型。第二种是曝光未点击,这是那些确实推到你面前,你却无情划走的视频,这是来自用户最真实的拒绝,也是训练模型最有效的苦药。
多路召回和向量化召回的关系
多路召回和向量化召回不是二选一的两种策略,而是不同层级的概念:
- 多路召回说的是组织方式:同时从热点、协同过滤、内容相似、向量检索等通道取候选,再去重、控制各路数量,交给后续排序。
- 向量化召回说的是其中一种取候选的方法:把用户或其近期行为、内容表示成向量,检索相近的内容。它可以是多路召回中的一路,也可以有不止一路。
所以,企业里常见的情况是多路召回中使用向量召回,并保留其他通道。Instagram Explore 公开介绍的系统就是这样:它组合多种候选来源,其中包括双塔模型生成向量并通过 ANN 检索。Meta 工程文章
多路召回决定从哪些渠道找,向量召回决定其中某些渠道怎么找。
曝光过滤的处理
在推荐系统中。如果用户看过某个物品,就不应该再把物品推荐给这个用户(特别对于抖音、小红书这种短视频平台来说),所以一般在做完召回之后, 对召回的物品做曝光过滤,判断每个物品是否已经给该用户曝光过,如果已经曝光过就需要从召回的结果中排除掉。
想要做曝光过滤,需要记录对于每个用户来说已经曝光给他的物品。
一个用户历史上,一个用户历史上看过的物品可能会非常多,不过好在不需要存储所有的历史记录,只需要存储最近一段时间的就行
以小红书的推荐系统为例,只召回发布时间小于一个月的笔记。更老的笔记根本不会被召回,所以就不用对年龄大于一个月的笔记做曝光过滤,只需要记录每个用户最近一个月的曝光历史,用它们做曝光过滤
一位用户看过N个物品,本次召回了R个物品,如果靠暴力对比做曝光过滤,那么需要花费N×R的时间,在小红书,用户一个月的曝光量 N 的量级大约是几千。每次推荐召回量R的量级也是几千,暴力对比的计算量太大了,所以实践中不做暴力对比,而是用布隆过滤器(BloomFuture)
它可以判断一个物品,是否在以曝光的物品集合中。如果BloomFuture的判断是No,那么该物品一定不在集合中。如果BloomFuture的判断是Yes,只能说该物品很可能在集合中,但也存在误判的概率,
所以,根据布隆Filter的判断做曝光过滤,能保证过滤掉所有已经曝光的物品,用户绝对不可能重复看到同一个物品。
从上亿个原始视频到最终入围的1000个候选者,这50毫秒的召回过程,本质上是一场算力成本与推荐精度的极致平衡。现在海选已经结束,种子选手全部就位。接下来的问题是从这些种子选手中如何精确选出那几十个真爱呢?
详见下篇——粗排:如何在毫秒级筛出值得精排的内容?