
从 Muse、Grok Bot 到 Dots,个人 AI Agent 正在成为新的产品热点。这类个人 AI Agent 需要通过长期记忆积累用户的习惯、偏好和个人信息,以便在任务中提供更贴心的个性化服务。但长期记忆也带来了隐私管理问题:如何让 Agent 在需要时使用个人信息,同时避免敏感数据在无关任务中被随意读取?
针对这一问题,论文「[What to Remember, What to Reveal: Privacy-Aware Memory for Conversational Agents]」中提出了 SP-Mem 记忆架构,通过隐私脱敏、分区存储和授权检索,控制长期记忆中敏感信息的访问与使用。
长期记忆的三阶段
SP-Mem 将长期记忆的处理分为三个阶段:隐私感知写入、分区存储和授权检索。
在写入阶段,系统从用户对话中提取需要保留的信息,识别其中的敏感字段并进行脱敏处理。随后,将脱敏后的记忆、隐私映射关系和原始隐私数据分别存储。到了查询阶段,系统会根据当前任务判断是否需要使用具体的隐私信息,并在获得用户授权后,通过映射关系恢复对应的数据。
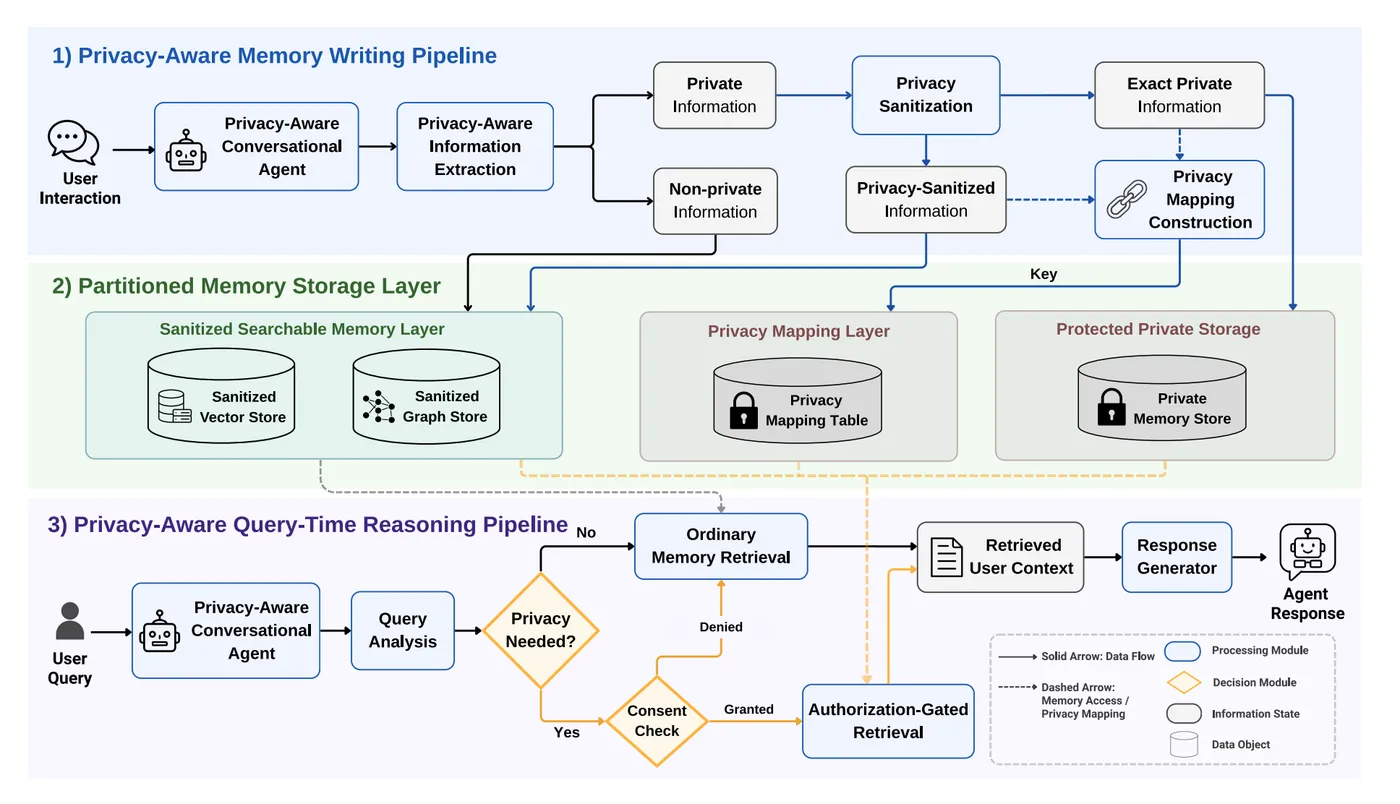
图注:SP-Mem 整体架构,展示了从记忆写入、隐私脱敏、分区存储到授权检索的完整流程。
通过这套机制,Agent 可以在日常任务中正常检索和使用用户记忆,同时减少原始敏感信息进入模型 Context 的机会。例如,系统可以保留用户提供过邮箱地址这一事实及相关信息,但只有在任务确实需要、且获得用户授权时,才会读取完整的邮箱地址。
这样一来,隐私控制就贯穿了记忆的写入、存储和检索过程,后续任务对敏感信息的访问也有了明确的控制环节。
写入阶段的向量和图
SP-Mem 在记忆写入阶段采用双路结构,分别通过 Vector Memory(向量记忆) 和 Graph Memory(图记忆) 保存用户信息。
向量记忆主要保存从对话中提取的自然语言事实,支持语义相似度检索。例如,用户提到自己喜欢披萨,系统会将其整理为「用户最喜欢的食物是披萨」。后续即使用户换一种问法,系统也能通过语义检索找到相关记忆。图记忆则将信息整理为「主体、关系、客体」三元组。同样的饮食偏好,可以表示为:<用户, favorite_food, pizza>这种结构明确记录了用户与食物之间的偏好关系,便于根据实体及其关联信息进行查询。
两种记忆结构相互补充:向量记忆保留自然语言中的语义信息,图记忆则将用户属性和实体关系结构化,支持不同方式的记忆检索。
隐私识别发生在写入前
在提取记忆的过程中,SP-Mem 还会识别其中的敏感信息。论文预先定义了隐私实体的分类体系,用于判断哪些内容涉及个人隐私,并为后续脱敏处理提供依据。
两种记忆结构采用不同的识别方式。对于向量记忆,系统会在提取自然语言事实时,标注其中的敏感值及其类型;对于图记忆,则通过关系类型判断是否涉及隐私,并对相应的客体值进行处理。
例如,用户输入:My email is ca266@gmail.com``. My favorite food is pizza.系统会从中提取邮箱地址和饮食偏好两条信息,并分别转换成自然语言事实和关系三元组。其中,邮箱地址被识别为敏感信息,需要经过脱敏处理;喜欢披萨则属于普通偏好信息,可以直接保存。
处理完成后,两条记忆分支都会保存脱敏后的邮箱信息,完整邮箱地址则交由独立的隐私存储模块管理,供后续授权访问时使用。
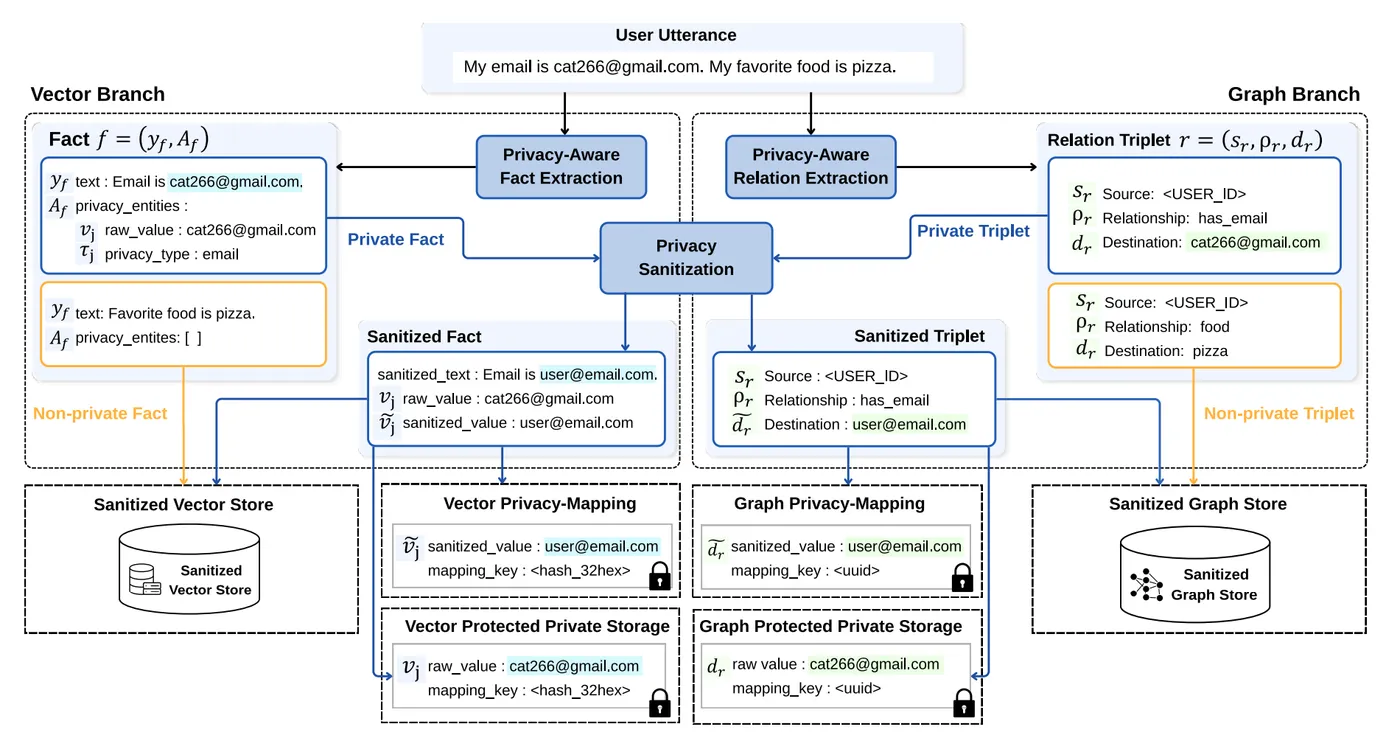
图注:SP-Mem 的隐私感知记忆写入流程。
四种隐私脱敏策略
识别出敏感信息后,SP-Mem 会根据隐私类型,采用不同的脱敏策略。论文主要设计了四种处理方式:
名称或别名替换:使用通用名称或替代标识,隐藏具体身份信息。
部分掩码:遮盖敏感信息中的部分字符,保留必要的格式或后缀。
数值区间化:区间数替代精确数值,例如用收入范围代替具体金额。
LLM 泛化处理:利用大模型将具体信息转换为更宽泛的描述,减少个人信息的暴露。
这四种策略会根据预先定义的隐私类型进行匹配,尽量在隐藏敏感信息的同时,保留对后续任务有用的内容。
例如,邮箱地址经过掩码处理后,系统仍能识别其信息类型;具体收入转换为区间后,也可以用于需要大致经济情况的任务。
不过,脱敏也需要权衡隐私保护与信息可用性。保留的细节越少,部分任务能够利用的信息也就越有限。因此,SP-Mem 会结合不同隐私类型的特点,选择相应的处理方式。
分区存储
完成脱敏后,SP-Mem 会将数据分别保存到三个逻辑存储层:
脱敏记忆层:包含向量记忆和图记忆,保存普通用户信息及脱敏后的敏感信息。Agent 执行日常任务时,主要从这一层检索相关内容,避免直接接触原始隐私数据。
隐私映射层:保存脱敏信息与原始隐私值之间的映射关系,通过映射键将两者关联起来,为后续恢复精确数据提供依据。
受保护的隐私存储层:独立保存邮箱地址、电话号码等完整隐私信息。这些数据不参与常规记忆检索,只有经过授权才能访问。
以邮箱地址为例,脱敏记忆层保存经过处理的邮箱信息,映射层记录它与原始数据的关联,受保护的隐私存储层则保存完整地址。
当 Agent 只需要了解用户的相关背景时,可以直接使用脱敏记忆;如果任务需要填写准确的邮箱地址,则需要经过授权,再通过映射关系获取原始数据。
通过这种分层设计,SP-Mem 将记忆检索与原始隐私数据的访问分开管理,既保留了日常任务所需的上下文,也为敏感信息增加了独立的访问控制环节。
查询阶段
完成记忆写入和分区存储后,SP-Mem 还会在查询阶段增加隐私判断与授权机制,控制原始敏感信息的访问。
当 Agent 收到用户请求时,系统会先分析任务是否需要使用精确的隐私信息。如果只需要普通记忆或脱敏后的内容,就直接从记忆库中检索;如果需要完整的隐私数据,则必须先获得用户授权,再通过映射关系从受保护存储中恢复对应的信息。用户拒绝授权时,系统只能使用脱敏记忆继续处理任务。
例如,用户要求「根据我的饮食偏好推荐几家餐厅」,Agent 可以直接检索历史偏好,无需访问邮箱、家庭住址等敏感信息。如果用户要求「帮我填写一份需要联系邮箱的报名表」,系统会识别出任务需要准确的邮箱地址,经过授权后,再读取对应的原始数据。
此外,SP-Mem 还会限制恢复的数据范围,只提取当前任务所需的隐私项。例如,填写报名表需要邮箱,并不意味着 Agent 可以同时读取用户的银行账户等无关信息。
通过任务需求判断和用户授权,SP-Mem 在常规记忆检索之外增加了一层访问控制,使敏感信息的使用范围能够受到更明确的限制。
隐私保护对 Agent 的影响
为了评估 SP-Mem 的实际效果,研究人员构建了一套隐私感知记忆测试基准,重点考察系统的隐私识别能力、任务完成质量、个性化效果以及不必要的隐私暴露情况。
测试覆盖金融、医疗、教育和心理支持四个领域,通过合成用户画像生成历史对话及对应的测试任务。其中,隐私属性涵盖 8 大类、37 种具体类型,用户偏好包括 14 个通用维度和 4 个领域特定维度。
研究人员选取了 100 名虚拟用户,每名用户包含 21 段历史对话和 54 条测试查询,共计 2,100 段历史对话、5,400 条测试查询。
为了测试不同授权条件下的表现,研究人员将任务分为五类:
| 任务类型 | 需要的信息 | 隐私授权 |
| 仅偏好 | 用户偏好 | 无需授权 |
| 仅隐私 | 精确隐私信息 | 允许 |
| 仅隐私 | 精确隐私信息 | 拒绝 |
| 混合任务 | 用户偏好和隐私信息 | 允许 |
| 混合任务 | 用户偏好和隐私信息 | 拒绝 |
这些任务主要用于验证两个问题:需要隐私信息时,系统能否正确请求授权并完成任务;无需使用隐私信息或用户拒绝授权时,系统能否避免暴露原始敏感数据。
对比方法包括 Full-context、Mem0、Zep 和 MemOS。其中,Full-context 直接将完整历史对话放入模型 Context,其余三种方法使用各自的外部记忆机制。
实验统一使用 GPT-5.2-Chat 构建记忆,并分别使用 GPT-5.2-Chat、Llama-3.1-8B-Instruct、Qwen3-14B 和 DeepSeek-V3.2 生成回答,以观察不同模型使用 SP-Mem 时的表现。
隐私识别的准确率
隐私识别是 SP-Mem 的关键环节。如果在写入阶段遗漏了敏感信息,原始数据就可能直接进入可检索的记忆库,后续的授权机制也就难以发挥作用。
实验结果显示,SP-Mem 在金融、医疗、教育和心理支持四个领域的整体隐私识别准确率达到 99.6%,召回率为 99.2%,精确率为 96.5%。
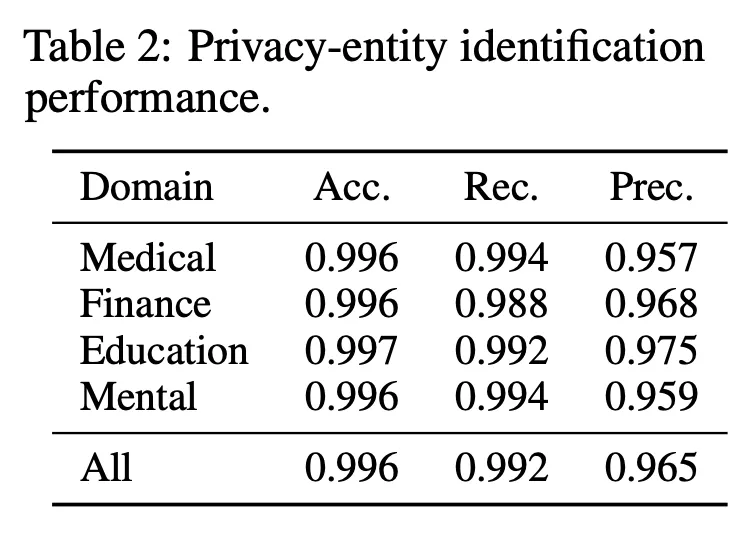
图注:SP-Mem 在四个测试领域中的隐私识别表现。
这一结果表明,SP-Mem 能够识别合成测试数据中绝大多数预定义的敏感信息。不过,99.2% 的召回率也意味着仍有少量隐私信息被遗漏。由于漏检的数据可能直接进入普通记忆库,隐私识别的可靠性仍是实际部署时需要重点考虑的问题。
限制隐私访问后的回答质量
研究人员从任务完成质量(P-TC)和个性化质量(P-PQ)两个维度评估 SP-Mem 的表现。实验采用成对比较的方式,由评估模型对比 SP-Mem 与其他方法生成的回答,判断哪一方表现更好,或两者是否相当。论文报告的主要指标为胜出率与平局率之和。
实验结果显示,在允许使用隐私信息的任务中,SP-Mem 相比 Mem0、Zep 和 MemOS,绝大多数任务的胜出率与平局率之和超过 85%。即使用户拒绝授权,SP-Mem 在任务完成质量和个性化质量上仍保持了较好的表现。
与直接加载完整历史对话的 Full-context 相比,SP-Mem 在任务完成质量上并未全面占优,但个性化质量仍具有竞争力。这说明通过检索相关事实和用户关系,SP-Mem 能够在限制敏感信息访问的情况下,保留较好的个性化能力。
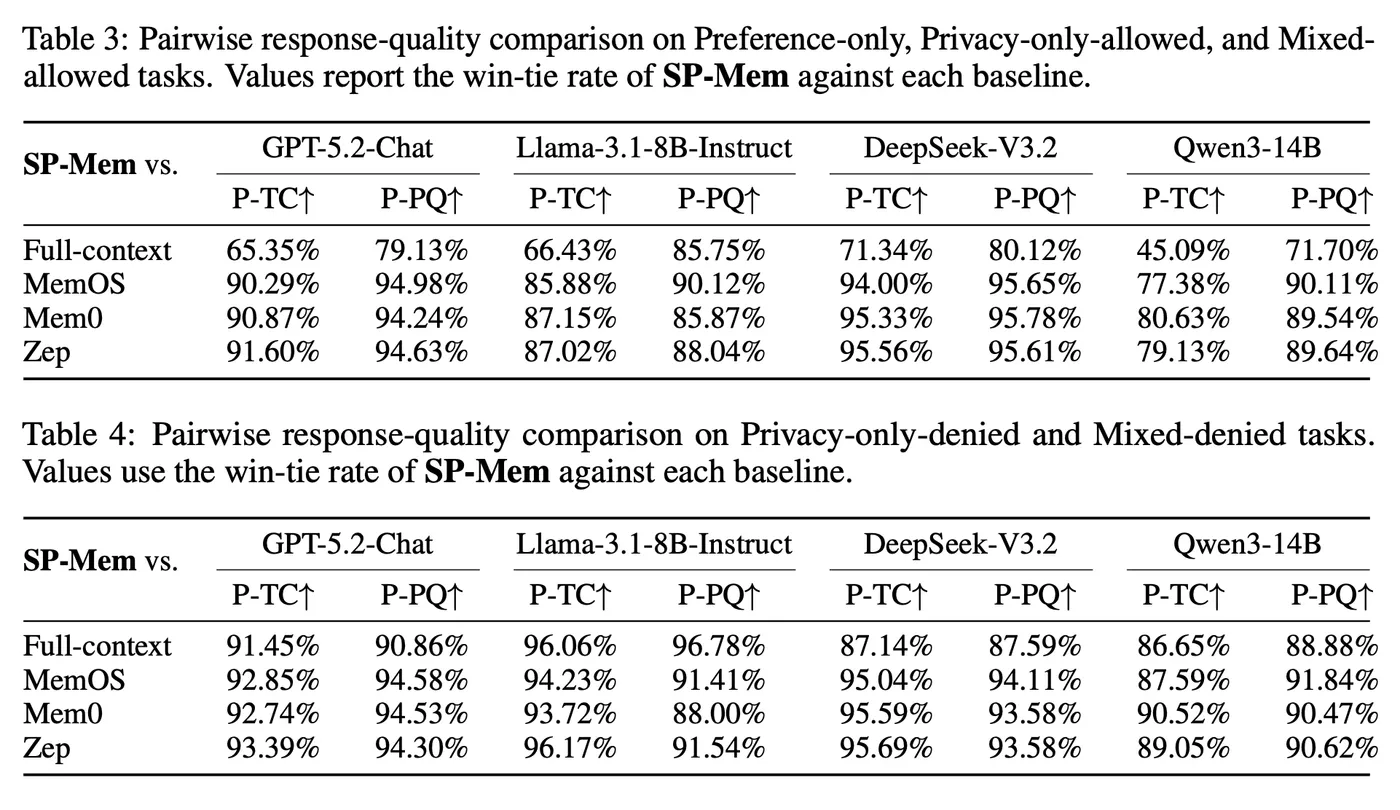
图注:SP-Mem 与四种基线方法在不同隐私授权条件下的任务完成质量和个性化质量对比。
不必要的隐私暴露的上限
为了评估 SP-Mem 的隐私保护效果,研究人员设计了两项指标:
PAR:评估任务需要隐私数据时,Agent 能不能正确发起请求去调用隐私数据。
UPU:评估在任务不需要隐私信息或用户拒绝授权时,Agent 在回答中暴露精确的隐私数据。
实验结果显示,SP-Mem 在四个回答模型上的 PAR 精确率均达到 100%,召回率在 84%~92% 之间。这意味着,在测试范围内,系统发起的授权请求均符合任务需要,但仍有部分需要隐私信息的任务未能触发授权。
在隐私暴露方面,SP-Mem 的改善更加明显。
对于仅需要用户偏好的任务,Full-context 有 16.00% 的回答出现了不必要的隐私信息,而 SP-Mem 将这一比例降至 0.33%。
即使用户明确拒绝授权,SP-Mem 仍能将隐私暴露率控制在较低水平:混合任务为 1.21%,仅隐私任务为 1.12%。
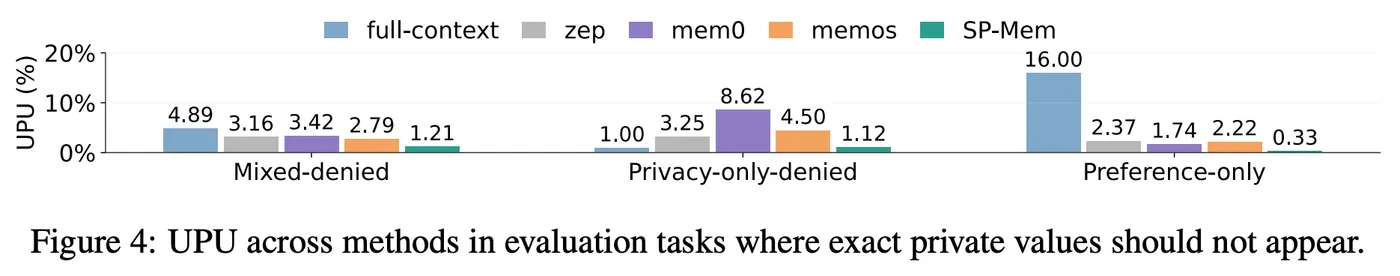
图注:不同记忆方法在无需隐私信息或用户拒绝授权时的隐私暴露率对比。
实验表明,通过脱敏存储和授权检索,SP-Mem 能够显著减少回答中不必要的隐私暴露。不过,暴露率仍未完全降至零,说明这套机制还无法彻底避免敏感信息被意外使用。
双路记忆的必要性与额外成本
SP-Mem 同时使用向量记忆和图记忆,研究人员通过消融实验,验证了两种结构各自的作用。
结果显示,完整的双路记忆方案在任务完成质量和个性化质量上,均优于仅保留向量记忆或图记忆的版本。其中,图记忆对个性化效果的提升更为明显,向量记忆则有助于保留更丰富的语义信息。
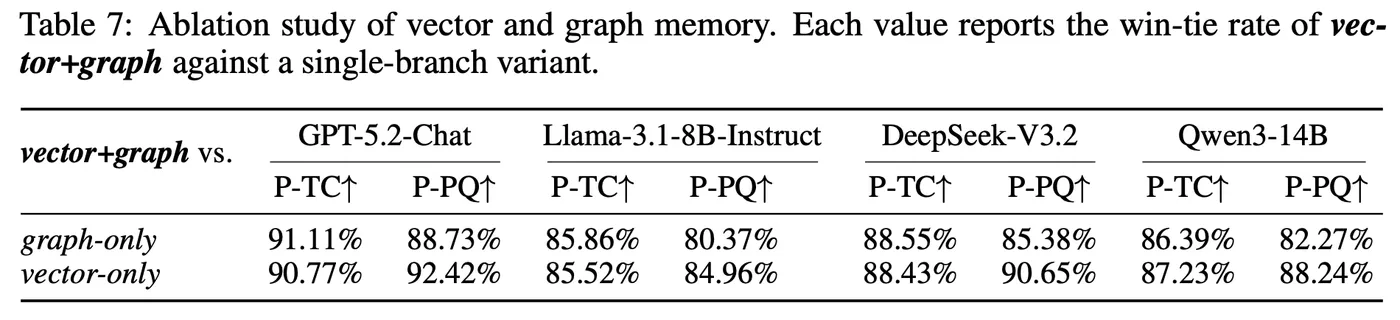
图注:完整 SP-Mem 与单独使用向量记忆、图记忆的效果对比。
在 Token 消耗方面,SP-Mem 的总开销约为 Full-context 的 26%~31%,但高于 Mem0、Zep 和 MemOS 等外部记忆方案。额外的任务分析、隐私判断和记忆处理环节,增加了整体推理成本。
总体来看,双路记忆能够改善任务完成和个性化效果,但也增加了系统复杂度与 Token 开销。SP-Mem 在提升隐私保护能力的同时,仍需要权衡实际部署成本。
局限性
SP-Mem 提供了一套较为完整的长期记忆隐私管理方案,但仍有一些问题需要进一步验证。
首先,实验采用合成用户、模拟对话和预定义的隐私分类体系,尚未经过真实场景验证。实际对话中的敏感信息可能更加隐晦,例如通过就医记录或生活习惯间接反映健康状况,这类隐含隐私的识别能力仍有待验证。
其次,论文主要通过回答中是否出现精确隐私值来衡量隐私暴露情况,对间接推断风险的覆盖有限。即使地址被泛化为城市、收入被转换为区间,多个脱敏字段组合后,仍可能暴露用户身份或其他敏感属性。
此外,SP-Mem 的授权机制依赖模型判断当前任务是否需要使用隐私信息。一旦判断出现偏差,就可能遗漏必要的授权请求,影响后续任务执行。
在实际部署中,还需要进一步解决隐私存储的访问安全、授权有效期、权限撤回以及跨应用访问控制等问题。这些环节尚未得到论文实验的充分验证。
小结
SP-Mem 通过隐私脱敏、分区存储和授权检索,将隐私控制融入 Agent 长期记忆的写入、存储和查询流程。实验表明,这套方案能够在保持较好任务完成质量和个性化效果的同时,显著减少不必要的敏感信息暴露。
这项研究也为个人 Agent 的长期记忆设计提供了一个值得参考的思路:除了考虑哪些信息需要保存、如何高效检索,还需要明确这些信息在什么条件下可以被使用。
随着个人 Agent 接入更多用户数据和外部服务,如何在保留个性化能力的同时,建立可靠的隐私访问控制机制,也将成为长期记忆系统需要解决的重要问题。


