
当用户只说“查一下去会议中心需要多久”或“帮我买一个防水手机壳”时,理想中的 Personal Agent 应该能从过往行为记录中补全出发地、交通方式、设备型号和操作习惯,而不是每次重新询问。
但当它开始通过浏览器替用户执行任务,难点就从“是否积累了用户历史行为数据”升级为:能否从这些数据中找到与当前任务相关的历史交互轨迹、恢复正确偏好,并将其转化为合适的网页操作?
Mila、麦吉尔大学与 ServiceNow 的研究团队在论文 「[AdaptArena: Evaluating Test-Time Personalization of Web Agents]」中提出 AdaptArena,专门评估这条链路。实验显示,依靠用户历史交互轨迹进行个性化的 Web Agent,最高任务成功率只有 15.62%;直接提供当前任务所需的目标偏好时,成功率最高则达到 82.92%。这一差距来自三个连续却相互独立的环节:
与当前任务相关的历史交互轨迹可能没有被找到;
找到了相关轨迹,Agent 的行为也未必符合用户偏好;
行为已经符合偏好,网页任务仍可能执行失败。
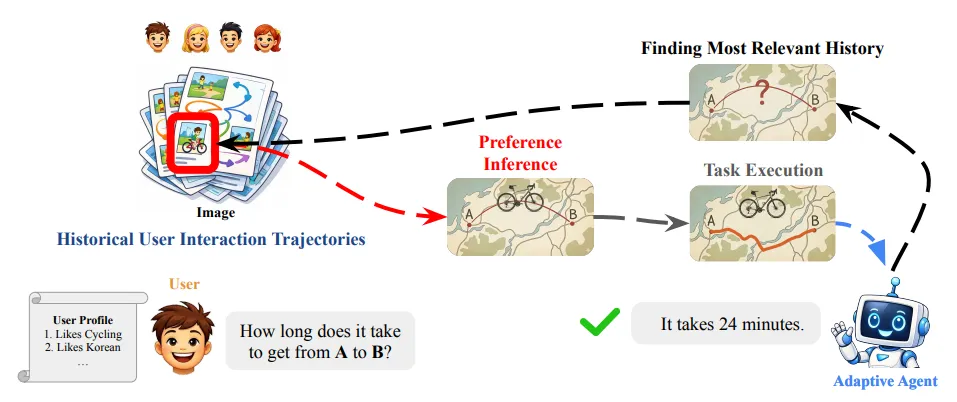
图注:AdaptArena 评测流程:面对缺少交通方式等信息的任务,Agent 需要从用户历史轨迹中恢复骑行等隐式偏好,再完成路线查询。
AdaptArena 如何测试“从用户行为中理解偏好”
AdaptArena 基于 WebArena,在电商商城、Reddit 论坛和 OpenStreetMap 三个沙箱环境中构建任务。
研究团队定义了 10 种用户角色和 12 类偏好,生成 120 条用户历史交互轨迹,并进一步构建 480 个部署任务,其中单偏好和双偏好任务各 240 个。
这些偏好既包括地理位置、手机型号和品牌等静态属性,也包括商品排序、商品过滤、出行方式以及“愿望单还是购物车”等过程偏好。
部署任务会删除显式偏好。例如,完整请求可能是“帮我找一个适合某款手机的防水保护壳”,评测时则只保留“帮我找一个适合我手机的防水保护壳”。
如果 Agent 不知道用户使用什么手机,任务就存在多个合理答案。只有从用户历史行为数据中恢复设备型号,任务才会变得明确。
研究团队还邀请两名与项目无关的标注者查看 60 条被打乱且移除显式偏好信息的原始交互轨迹。人类平均能在 85.83%的样本中恢复目标偏好,说明这些轨迹中确实存在可识别的用户偏好信号。
论文提出的 AdaptiveAgent 框架首先使用 CLIP 对任务指令和历史交互截图进行向量编码,再通过 FAISS 检索两段相关的轨迹前缀;随后由 GPT-5-nano 从轨迹中提取隐式偏好,并将其交给 Web Agent 执行。
本文后续所说的“轨迹”,均指这种按照时间顺序排列的网页交互记录,而不是笼统的浏览器访问记录。
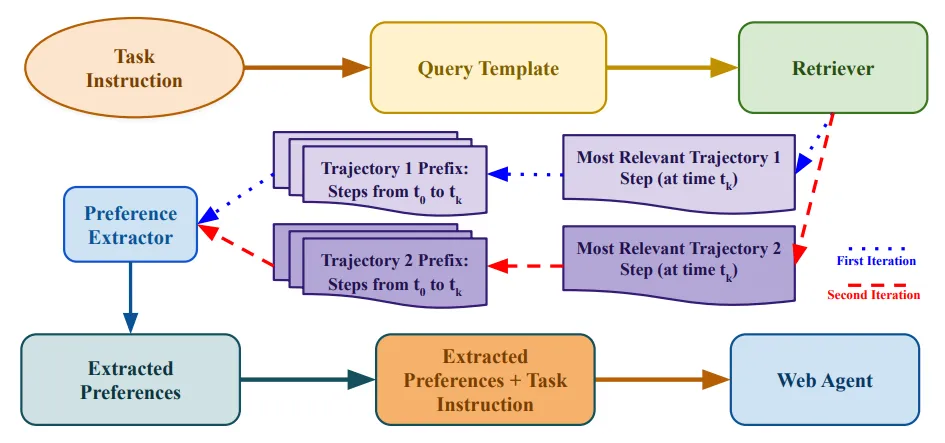
图注:AdaptiveAgent 工作流程:以当前任务为查询,分两轮检索相关的历史交互轨迹前缀,由偏好提取器生成隐式偏好,再与任务指令一起交给 Web Agent 执行。
不同信息条件下,六个底座模型的成功率区间如下:
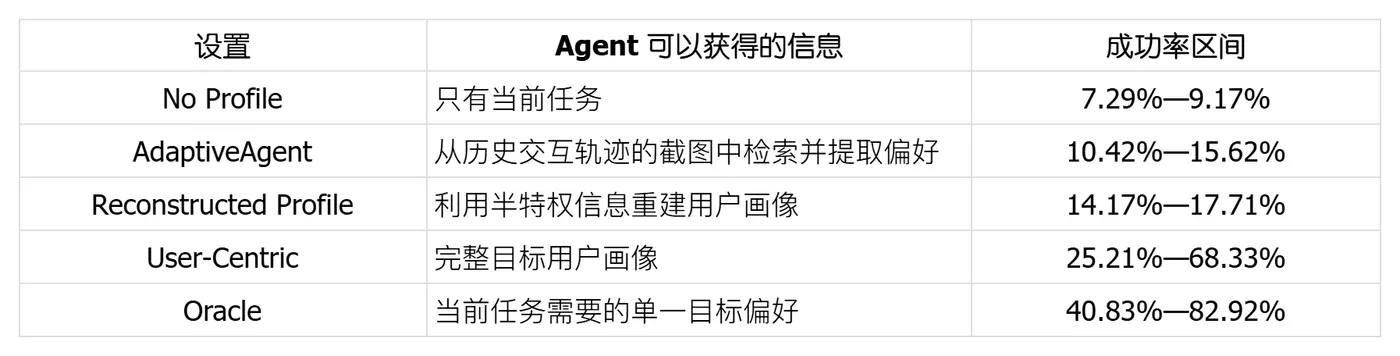
AdaptiveAgent 在六个底座模型上都超过了无画像基线,说明用户历史交互轨迹确实包含有效信号。
但它与 Oracle 之间仍存在巨大差距。以 Gemini-3-Pro 为例,AdaptiveAgent 的任务成功率为 15.62%,Oracle 则达到 82.92%,相差 67.30 个百分点。
这里的 Oracle 会直接向 Agent 提供当前任务所需的目标偏好,跳过轨迹检索和偏好识别,因此,这一结果更适合作为理想化条件下的性能参考上限,而不是 Web Agent 能力的绝对上限。
第一层断裂:相关的用户行为轨迹未必能被找到
前面的端到端结果只能告诉我们 Web Agent 最终失败了,却不能说明信息具体丢在哪一步。为了定位问题,论文沿着“轨迹检索、行为对齐、任务执行”这条链路逐层分析,首先检查系统能否从用户历史行为数据中找到与当前任务相关的交互轨迹。
AdaptiveAgent 每次会返回两条候选轨迹。如果其中至少有一条对应当前任务所需的偏好类别,论文就将其视为一次检索命中,并用 Recall@2,也就是“前两条结果的检索召回率”进行衡量。
在全部 480 个任务中,这一检索命中率为 71.88%;单偏好任务达到 77.50%,双偏好任务则下降到 66.25%。这说明系统在多数任务中能够找到类别相关的交互轨迹,但随着偏好数量增加,检索已经开始变得困难。
更值得注意的是,不同偏好类别之间存在巨大差异:
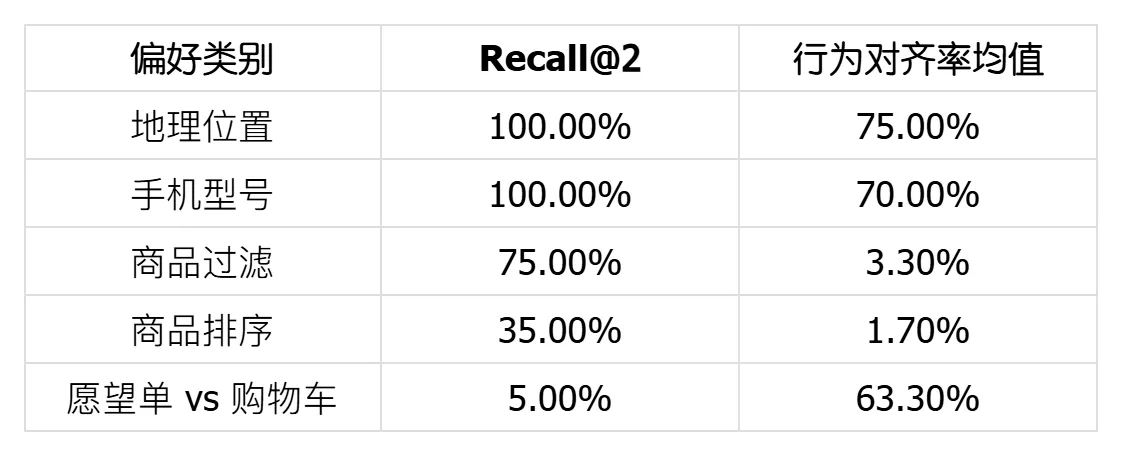
城市名称和手机型号经常直接出现在页面中,因此容易通过视觉相似度命中。排序、过滤和加入愿望单等偏好,则更多体现在用户执行了什么动作,而不是最终页面显示了什么。
这提示了以页面截图为主的轨迹表示的一项局限:页面截图擅长保存“网页中有什么”,却未必能够完整保存“用户为什么这样操作”。
另外,表中的 63.3% 是三个代表性底座模型在该偏好类别上的行为对齐率平均值,不能直接理解成严格的条件概率。它更适合用来说明:愿望单与购物车的主要困难偏向轨迹检索,而商品过滤虽然经常能找到相关轨迹,主要损失却发生在检索之后。
第二层断裂:找到相关轨迹,不等于行为符合偏好
论文使用偏好对齐分数(Preference Alignment Score)判断 Web Agent 的完整交互轨迹是否符合目标偏好。这个指标测量的不是模型能否正确复述用户画像,而是 Agent 最终表现出的导航和操作行为是否与偏好一致。
六个底座模型的行为对齐率只有 22.50%至 29.79%,远低于 71.88%的轨迹检索召回率。说明大量偏好信息不是在检索时丢失,而是在轨迹解释、偏好提取或行为转化过程中被误用。典型错误是,任务需要恢复用户的商品过滤偏好,Agent 却将其识别成商品排序,于是开始调整价格或名称顺序,而不是按照条件筛选商品。
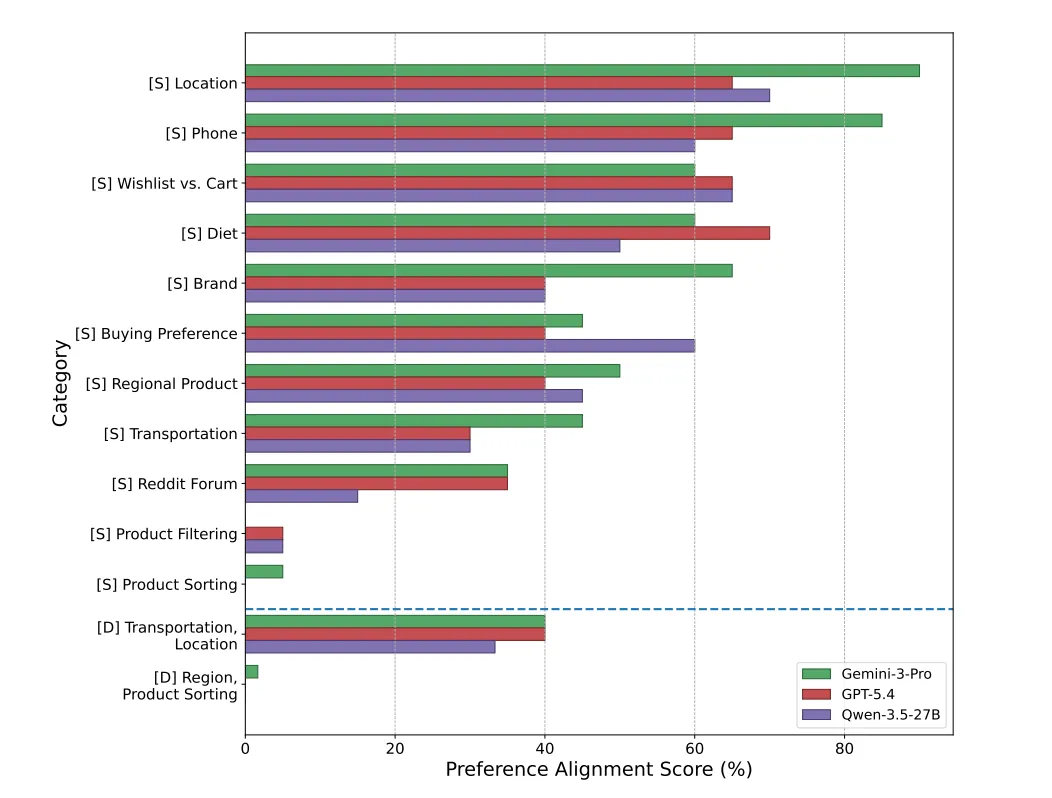
图注:三种代表性底座模型在不同偏好类别上的行为对齐表现:地理位置、手机型号等显式属性表现较高,商品排序、商品过滤等操作型偏好接近零。
复合偏好会进一步放大这一问题。六个模型从单偏好进入双偏好任务后,任务成功率都下降了 10.83 至 15.42 个百分点。交通方式与所在地等组合还能维持一定表现;一旦包含商品排序、商品过滤等困难过程偏好,部分组合的行为对齐率会跌至接近零。
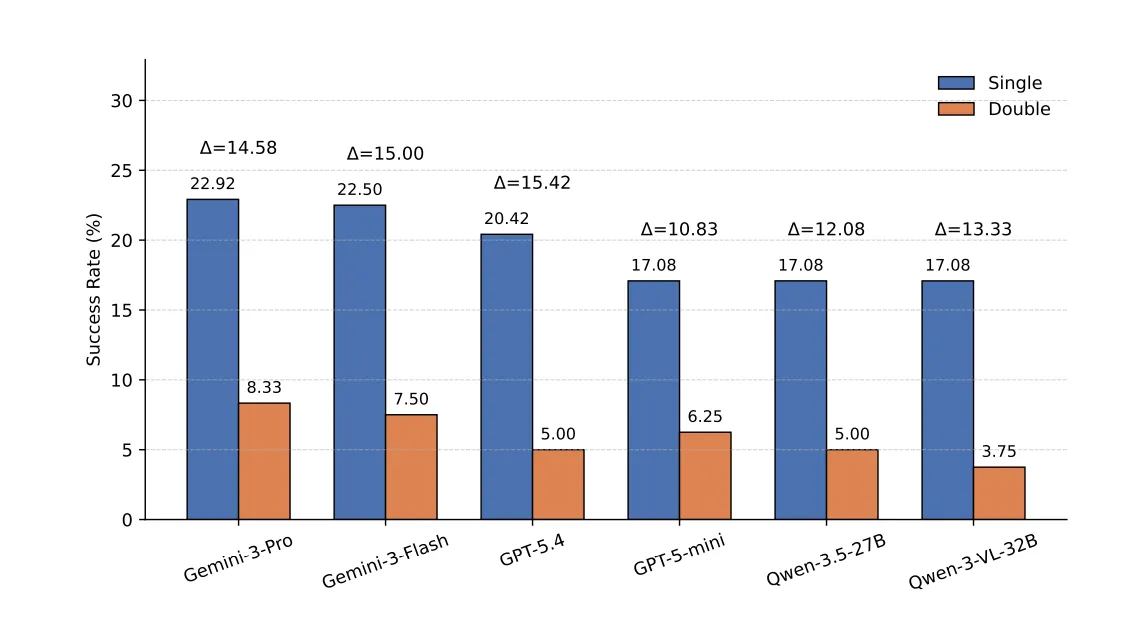
图注:六个底座模型在单偏好和双偏好任务上的成功率:进入双偏好设置后,所有模型都出现 10.83 至 15.42 个百分点的下降。
这说明当前 Web Agent 不仅难以从用户历史行为数据中恢复动作级偏好,也缺少稳定组合多个异质约束的能力。
第三层断裂:行为已经对齐,网页任务仍可能失败
即使 Web Agent 的行为轨迹已经被判定为符合目标偏好,最终任务成功率仍只有 32.12%至 51.72%。偏好对齐与任务完成,是两个不同的能力层。
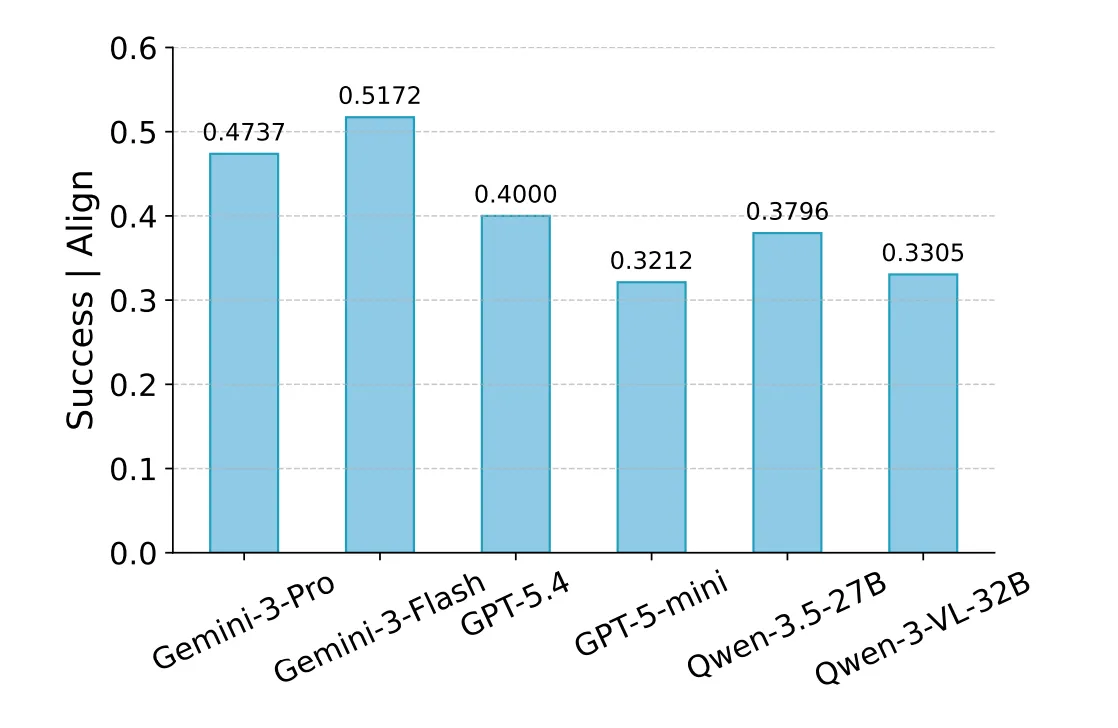
图注:行为轨迹已经被判定为符合目标偏好时,各模型的条件任务成功率仍只有 32.12%至 51.72%,说明网页执行构成了独立瓶颈。
论文将“行为对齐但任务失败”的轨迹分成几类:
动作失败:Agent 的目标方向正确,但预期的 UI 交互没有成功;
终止失败:Agent 没有在适当时机结束任务;
导航循环:Agent 反复访问相似页面状态,却没有取得进展;
其他问题:包括页面加载异常等环境不稳定情况。
在不同模型中,主要失败类型并不相同。例如,GPT-5-mini 的动作失败占 46.75%;Gemini-3-Pro 的终止失败占 44.29%;Gemini-3-Flash 的导航循环占 30.88%。这些比例的分母是“行为已经对齐但最终失败”的样本,而不是全部 480 个任务。
论文还观察到,一些 Agent 能在推理中意识到之前的页面操作没有成功,却依然无法修复操作。语言层面的自我诊断,并不等于执行层面的恢复能力。
个性化不能只是一段 Prompt
AdaptArena 没有给出一套已经在生产环境中验证过的解决方案,但它为系统设计提供了几个明确方向。
第一,用户历史行为数据不能只保留页面截图。生产系统可以同时记录动作类型、动作目标、输入值和操作前后的页面状态变化,用结构化事件补充截图难以表达的过程语义。
第二,复合偏好可以拆成可检查的原子约束。例如,把“指定分类、价格升序、加入愿望单”分别表示成 category、sort_order 和 terminal_action,而不是全部压缩成一段模糊的自然语言画像。
第三,轨迹检索、行为对齐和任务执行需要分别评估。系统失败时,应当能够判断是没有找到相关轨迹、恢复了错误偏好,还是网页动作和终止控制出现问题。
第四,执行层需要显式的状态检查与恢复机制,包括动作结果校验、重复状态检测、完成条件判断,以及失败后的重试或换路。
注意,这些方向是基于论文结果提出的工程推导,不是 AdaptArena 已经验证过的最终架构。
从研究边界回到 Personal Agent
AdaptArena 评估的是个性化 Web Agent,而不是所有 Personal Agent。动作失败、状态循环和终止控制也可能出现在 API Agent、代码 Agent 或桌面 Agent 中,但论文直接测量的只是这些问题在浏览器任务中的表现。
这套基准也存在明确限制:
120 条用户历史交互轨迹由模型在显式偏好条件下生成,比真实用户长期积累的行为数据更加规整;
偏好被建模为相对稳定的离散属性,没有覆盖长期变化和场景漂移;
实验运行于 WebArena 本地沙箱,没有涉及真实公网的登录、动态加载和反自动化机制;
行为对齐依赖 LLM 裁判,虽然经过人类一致性验证,仍存在测量误差;
论文主要报告点估计,尚不足以判断生产环境中的稳定性。
因此,AdaptArena 更适合被理解为一次系统性压力测试,而不是可以直接部署的 Personal Agent 方案。但它清楚地揭示了:当 Personal Agent 开始通过浏览器替用户购买商品、查询路线或办理业务时,“积累了用户历史行为数据”与“真正完成任务”之间,仍隔着一条很长的工程链路。
系统首先要从用户历史行为数据中找到与当前任务相关的交互轨迹,再从轨迹中恢复正确偏好;偏好必须真正进入导航和操作行为,最后还要跨过网页交互、状态控制与任务终止等执行障碍。
决定下一代个人助理能力上限的,不只是它积累了多少用户行为记录。更重要的是,它能否在正确的任务中找到正确的交互轨迹,把用户偏好转化成正确动作,并且真的把事情做完。

