摘要:基于Google公开的夜间自主优化实践,设计候选变更、独立验证与人工发布五道门禁。
Google Cloud在2026年10月13日发布Gemini 4 Argon时,披露了一个很有吸引力的工程场景:Google ADK团队让模型在自动化测试护栏内通宵自主工作,找出并提交性能优化,相关改动已经进入开源项目。文中的性能提升数字属于Google自报,并不自动适用于其他代码库;真正值得测试团队借鉴的是“无人值守探索,但运行在测试护栏内”这条工作方式。
把机制放到常见项目里,可以构造这样的任务:让Coding Agent夜间优化订单服务的批量查询,允许修改缓存和并发策略,但不能改变退款结果、事务边界和权限。早上它给出一份“性能提升、测试通过”的总结。此时最危险的动作,是直接看平均延迟图然后合并。你需要先证明它没有删慢测试、扩大缓存陈旧窗口、改变错误语义,或者只在温缓存下跑出漂亮数字。
无人值守不等于无人验收。更稳妥的设计,是让AI拥有探索权,却没有直接发布权;它的产物停留在隔离分支和候选环境,必须经过五道独立证据门禁。
第一道:执行前冻结任务边界
任务不能只写“让查询更快”。写明允许修改的目录、允许升级的依赖、目标负载和业务红线:退款金额与订单状态不得变化;授权检查不可后移;缓存最多陈旧30秒;失败必须返回原错误码;不得关闭测试或降低断言。
同时准备对照工作负载,包括冷缓存、温缓存、热点用户、大订单、权限失败和依赖超时。Agent可以自由选方案,但不能自由挑数据。否则它很容易只优化最友好的路径。
第二道:环境指纹必须完整
夜间任务跨越数小时,环境漂移会把性能结果变得不可比较。记录代码提交、容器镜像、CPU与内存、依赖锁文件、数据库快照、缓存状态、压测脚本版本和外部服务桩。基线与候选必须在同一环境条件下交叉运行,而不是周一的旧环境对比周二的新环境。
如果Agent临时安装了工具、调整系统参数或复用了本地缓存,这些也必须进入Trace。第二天团队应该能用一条命令从零复现,而不是只能打开昨晚那台机器查看结果。
第三道:差异审查先找越界,再看收益
先扫描删除的测试、放宽的阈值、新增依赖、生产配置、网络权限和数据库迁移。性能优化常见的假成功包括:减少校验、扩大批量但丢失部分失败、用不一致缓存换速度、异步返回却没有最终一致性证据。
可以用一段门禁表达业务底线:
def assert_candidate(candidate, baseline):
    assert candidate.deleted_tests == []
    assert candidate.refund_results == baseline.refund_results
    assert candidate.authorization_denials == baseline.authorization_denials
    assert candidate.partial_failure_semantics == baseline.partial_failure_semantics
    assert candidate.cache_staleness_p99 <= 30
    assert candidate.rollback_verified is True
只有这些条件成立,延迟和成本的比较才有意义。否则更快可能只是少做了应该做的事。
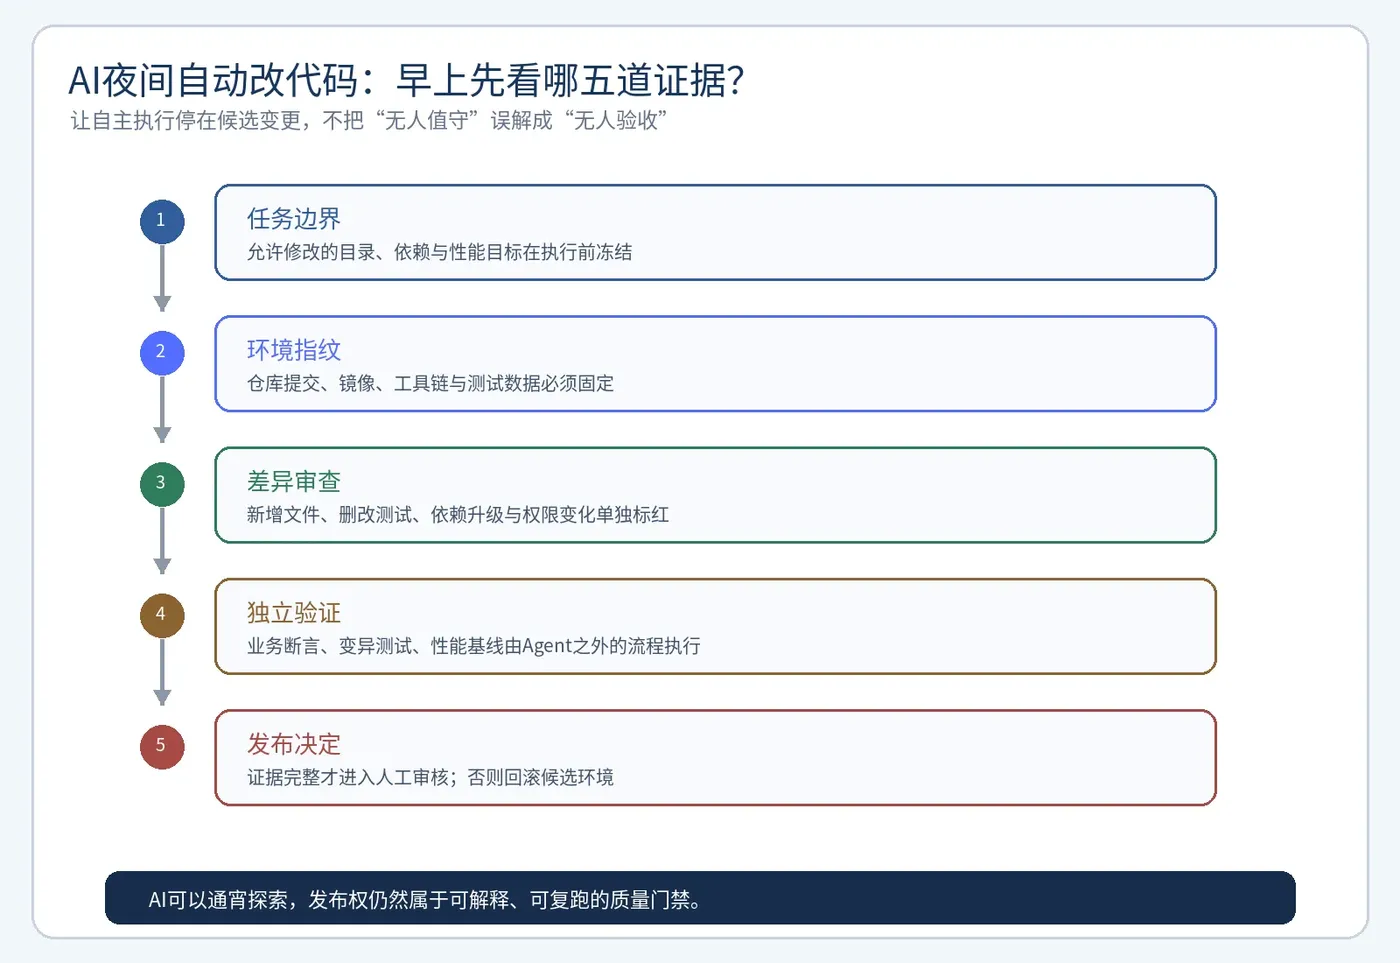
第四道:独立验证器不能由同一个Agent控制
如果Agent写优化、改测试、选压测数据、解释报告,仍然存在同源共错。独立流程至少包含业务契约、变异测试和性能对照。故意注入“跳过权限”“少返回一页”“缓存永不过期”等错误,验证现有测试确实会失败;再用固定负载交叉运行基线和候选,给出分位数而不是只报平均值。
多次重复也很重要。一次快可能来自缓存命中、邻居噪声或幸运调度。对关键场景至少重复,报告中保留方差、失败率与资源使用。当收益小于测量噪声时,结论应是“暂无法证明”,而不是让模型写一段乐观解释。
给候选改动一张证据评分卡,而不是一个总分
评分卡可以分为四栏。正确性栏记录契约通过、变异杀伤和相邻回归;可复现栏记录环境指纹、从零构建和多次方差;风险栏记录权限、依赖、测试删改与回滚;收益栏记录延迟、吞吐、成本和资源。前三栏出现红线时,收益栏再高也不进入发布评审。
人工审查时只看差异最大的单元。例如候选在温缓存下降低延迟,却在冷缓存增加超时;或平均吞吐提升,但P99尾延迟变差。让Agent生成摘要可以节省时间,但摘要中的每个结论必须能点回原始运行、样本与指标。
还要检查“没有变化”是否可信。如果Agent运行一夜只交付一处小改动,可能是谨慎,也可能是它在循环中消耗大量Token。对照Trace中的计划、失败、重试与停止原因,才能判断这次探索是否值得保留,以及下一轮该优化工具还是模型。
最后给夜间任务设置明确停止预算:最大运行时间、最大工具调用、最大成本和连续失败次数。达到上限时保存现场并停止,不允许模型为了追求“最终成功”无限重试。预算门禁既控制成本,也能暴露工具设计或任务拆分不合理的问题。
停止本身是一种正确结果,不应被报表算作无条件失败。
第五道:人工只审高价值差异
自动化门禁通过后,再把人力集中到难以确定性判断的部分:架构是否更难维护、错误恢复是否可理解、缓存策略是否符合产品预期、成本换性能是否值得。人工不必重读全部Trace,报告先标出首个偏离、超出白名单的文件、被杀死的变异和无法稳定复现的指标。
发布也不应从候选分支直接跳到全量。小流量验证时同时看业务不变量、延迟、错误、资源和回滚速度。任何财务、权限或数据完整性红线出现,优先回滚,不让Agent在线继续自我修补。
测试团队能立刻复制什么
第一周只选一个低风险性能任务,固定三组负载和五条业务契约;第二周加入环境指纹、文件白名单和变异测试;第三周再让Agent夜间运行,早上生成证据摘要。不要一开始就授权它合并或部署。
衡量这套流程是否有效,也别只看AI写了多少代码。更重要的是候选被正确拒绝了多少次、复现一次结果需要多久、人工审查集中在哪些差异、线上回归是否进入离线数据集。测试价值不是为Agent背书,而是把长时间自主探索压缩成一份可以信任、可以否决、可以回放的决策材料。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。