
大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。
刚入行那会儿,我特别信备份任务后面那个绿色对勾。它每天按时变绿,我就当数据没事了。直到有次恢复演练,备份导出来,服务是起来了。可一核对才发现,某张表的一批关键行,值居然是错的。更麻烦的是,这个错上一次备份里就已经有了,不是这回才坏的。
从那之后,我就不敢只盯着那个勾了。备份成功,顶多说明文件写出来了。数据对不对,那是另一回事,得自己另外验一遍。
先分两层看可靠性
数据可靠性得拆成两层。一层是可用性,备份能不能把服务拉起来,RTO 够不够短。另外一层是正确性,拉起来的数据,是不是你要的那份。多数团队在监控和演练里,只验了前一层。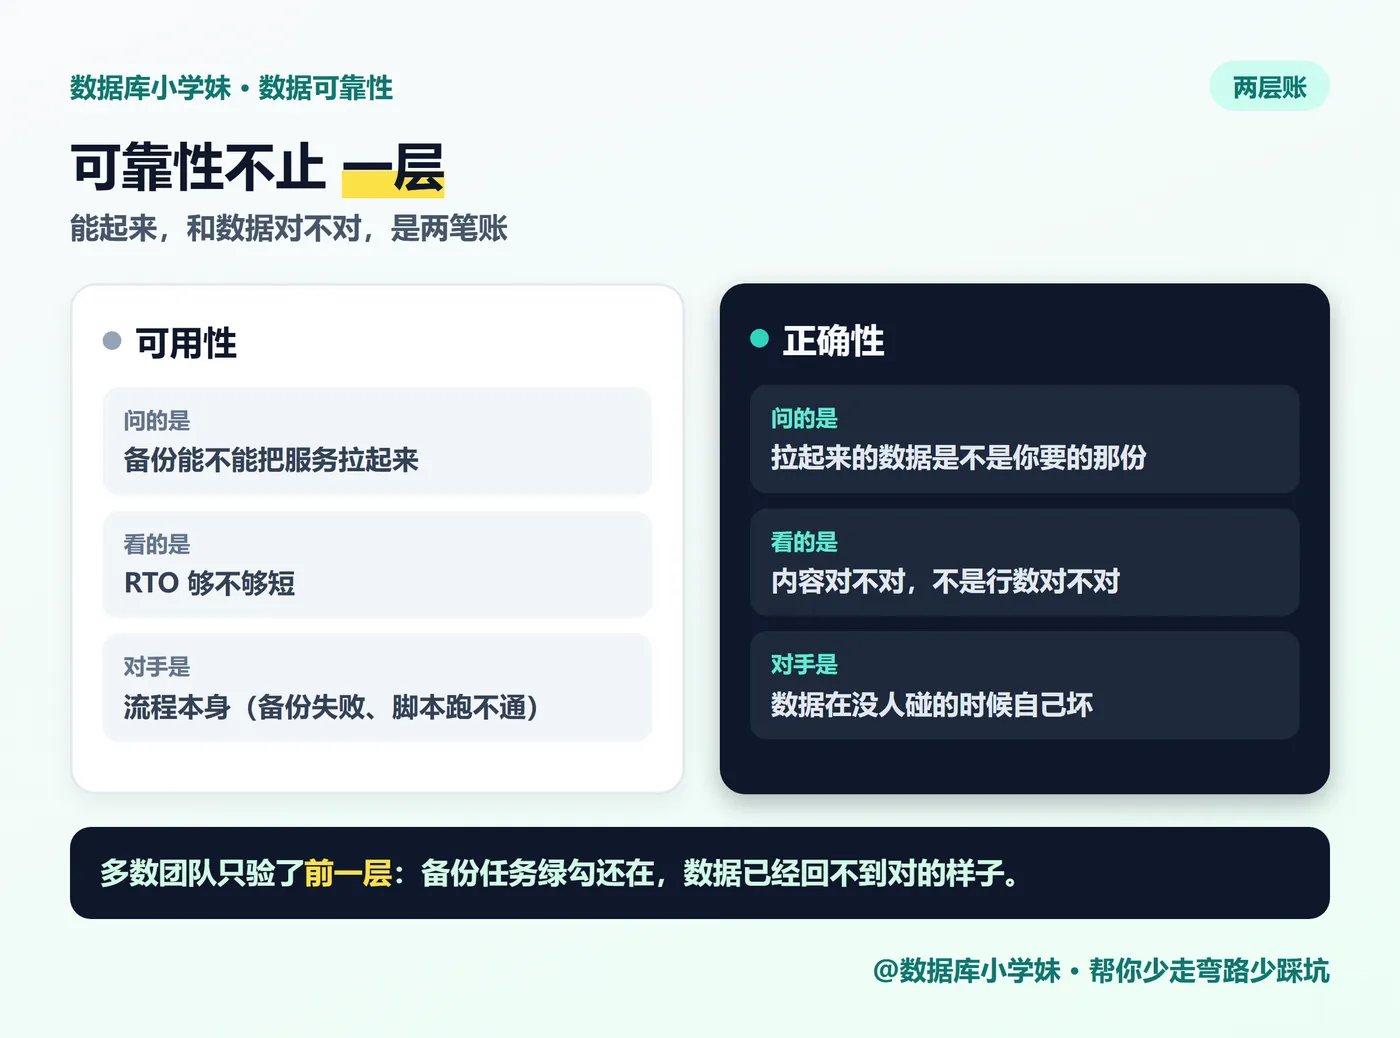
这两层出问题的原因不一样。可用性的敌人是流程,备份失败、恢复脚本跑不通。正确性的敌人更隐蔽,是数据在没人碰的时候,自己坏了。
数据怎么会悄悄坏
损坏的来源大致有三类。第一类是存储层的位翻转,磁盘、控制器、固件上的偶发错误。第二类是内核或异常路径上的 bug,某些边角逻辑写坏了页。最后一类是人为的操作,比如半截的 DDL、直接改数据文件的误操作等。这三类,统称静默损坏。
静默损坏得跟"断电丢不丢数据"分开看。断电是提交语义的问题,日志能兜住。静默损坏不一样,是数据本身变了,系统却以为自己对。日志也救不了它,因为错误一开始就被当成了正常写入。
怎么发现坏页
日志兜不住静默损坏,就只能靠数据自己去发现。常用的是两个机制。一个是页校验和,每个数据页带一段校验值,读页的时候顺带验一遍,对不上就报坏页。另一个是双写,写页之前先写一份到专门的区域,防止写到一半断电,页只写了一半。
校验和也有它的边界。它通常要读到那一页才会去验。一个页几个月没人碰,坏了也没人知道,直到哪天被读到,问题才露出来。还有,不少引擎的校验和默认开着,也有默认关的。接手一套老库,需要先确认它属于哪种情况。
# PostgreSQL:离线校验数据文件的页校验和(需停机,或在副本上做)
pg_checksums --check -D /var/lib/pgsql/data
为什么备份也跟着坏
坏页不只在库里,备份也会把它一起带走,这点最容易被忽略。物理备份是把数据文件原样拷走,坏页也一起拷走。你以为拿到的是一份干净副本,其实坏的地方一个不少。如果是增量或日志备份,损坏还可能沿着时间线一直传下去,越传越深。
所以"备份成功"和"数据可恢复"之间,隔着一次真的验证。我现在的底线是,校验和扫描要定期跑,备份恢复演练要验数据本身。
怎么验才算数
验数据本身,比只看行数麻烦得多。行数对得上,不代表内容对得上。金额被截断、状态映射错,条数照样一条不差。
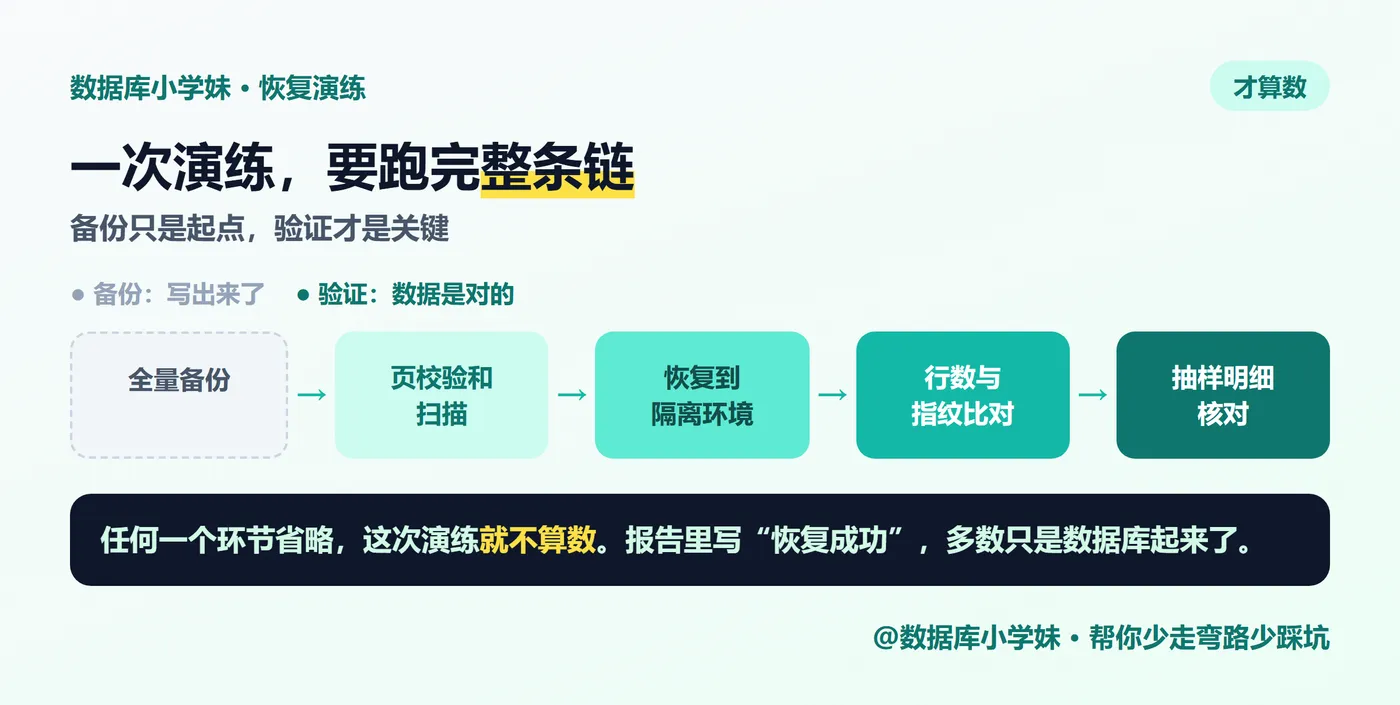
我一般做三层比对。第一层是行数与主键范围,快,但最粗。第二层是字段级指纹,把关注字段拼起来算个校验值,主从比、新旧比。第三层是抽样明细,指纹对不上时,抽样定位到具体是哪些行。
-- 字段级指纹:不只看行数,把关键字段一起算进去
SELECT
  COUNT(*) AS rows,
  BIT_XOR(CRC32(CONCAT_WS('#', id, status, amount, updated_at))) AS fingerprint
FROM t_order;
避坑清单
说了这么多,落到日常,就下面这几条。都是我以前踩过的坑。
别把备份任务的"成功"当成数据安全的证明。成功只覆盖了文件写出来这一步,数据对不对、能不能恢复,它一个字都没说。
备份恢复演练必须验数据正确性,不能只验服务能不能启动。我见过演练报告写"恢复成功",其实是数据库起来了,数据对不对没人比过,那等于没验。
最后一条是我自己搞错的。我以前对账只看行数,对上了就签字。后来才发现,金额被截断了,条数照样一条不差。现在至少加一步字段级指纹,宁可多跑一遍。
写在最后
数据可靠性是两层账。可用性的账,备份和演练能算清。正确性的账,得靠校验和、指纹,还有一次次真恢复去算。这两层账最大的不同,是前一层坏了会喊,后一层坏了不说话。它只会安安静静地错下去,等你自己发现。只算前一层,等于把后一层交给了运气。
你上次恢复演练,是只看了服务起没起,还是真比过数据?评论区聊聊。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋


