Java程序员写方法重载的时候,一定有过这种痛苦:一个方法有三个参数,你想让调用方在某些情况下可以不传那几个参数。怎么办?写三个重载方法。
// Java:用方法重载实现"可选参数"
public QueryResult query(String sql) {

  return query(sql, 100, 20);  // 默认limit=100,offset=20
}

public QueryResult query(String sql, int limit) {

  return query(sql, limit, 20);  // 默认offset=20
}

public QueryResult query(String sql, int limit, int offset) {

  // 真正的实现
}
三个重载方法,就为了让调用方可以不传某些参数。代码臃肿,维护起来烦得要死。
Scala给了你一个更优雅的方案:默认参数值。
// Scala:一行搞定
def query(sql: String, limit: Int = 100, offset: Int = 20): QueryResult = {
  // 真正的实现
}

// 调用的时候
query("SELECT * FROM users")                    // 用默认值
query("SELECT * FROM users", limit = 50)        // 只改limit
query("SELECT * FROM users", offset = 100)        // 只改offset
一行代码,三个参数,调用方想用默认值就用默认值,想改哪个就改哪个。这就是默认参数值的威力。
这篇文章不讲"默认参数是什么"这种入门废话,直接说干货:默认参数在Scala里是怎么实现的?它和方法重载比好在哪?有什么坑要注意?
先从一个痛点说起
Java里你想写一个"可配置"的函数,最常见的做法就是方法重载。
比如你写一个HTTP客户端,要让调用方可以配置超时时间、重试次数、连接池大小。Java怎么写?
// Java:N个参数,M个重载方法
public HttpClient config() {

  return config(5000, 3, 10);  // 默认值
}

public HttpClient config(int timeout) {

  return config(timeout, 3, 10);
}

public HttpClient config(int timeout, int retry) {

  return config(timeout, retry, 10);
}

public HttpClient config(int timeout, int retry, int poolSize) {

  // 真正的实现
}
四个重载方法。如果参数从3个变成5个呢?那就是32个重载方法——这就是Java的"可选参数"方案。
为什么Java要这么写?因为Java的方法参数是位置参数——你传第几个,它就是第几个。你不能说"我只想传第三个参数,前两个用默认值"。
Scala的默认参数解决了这个问题。
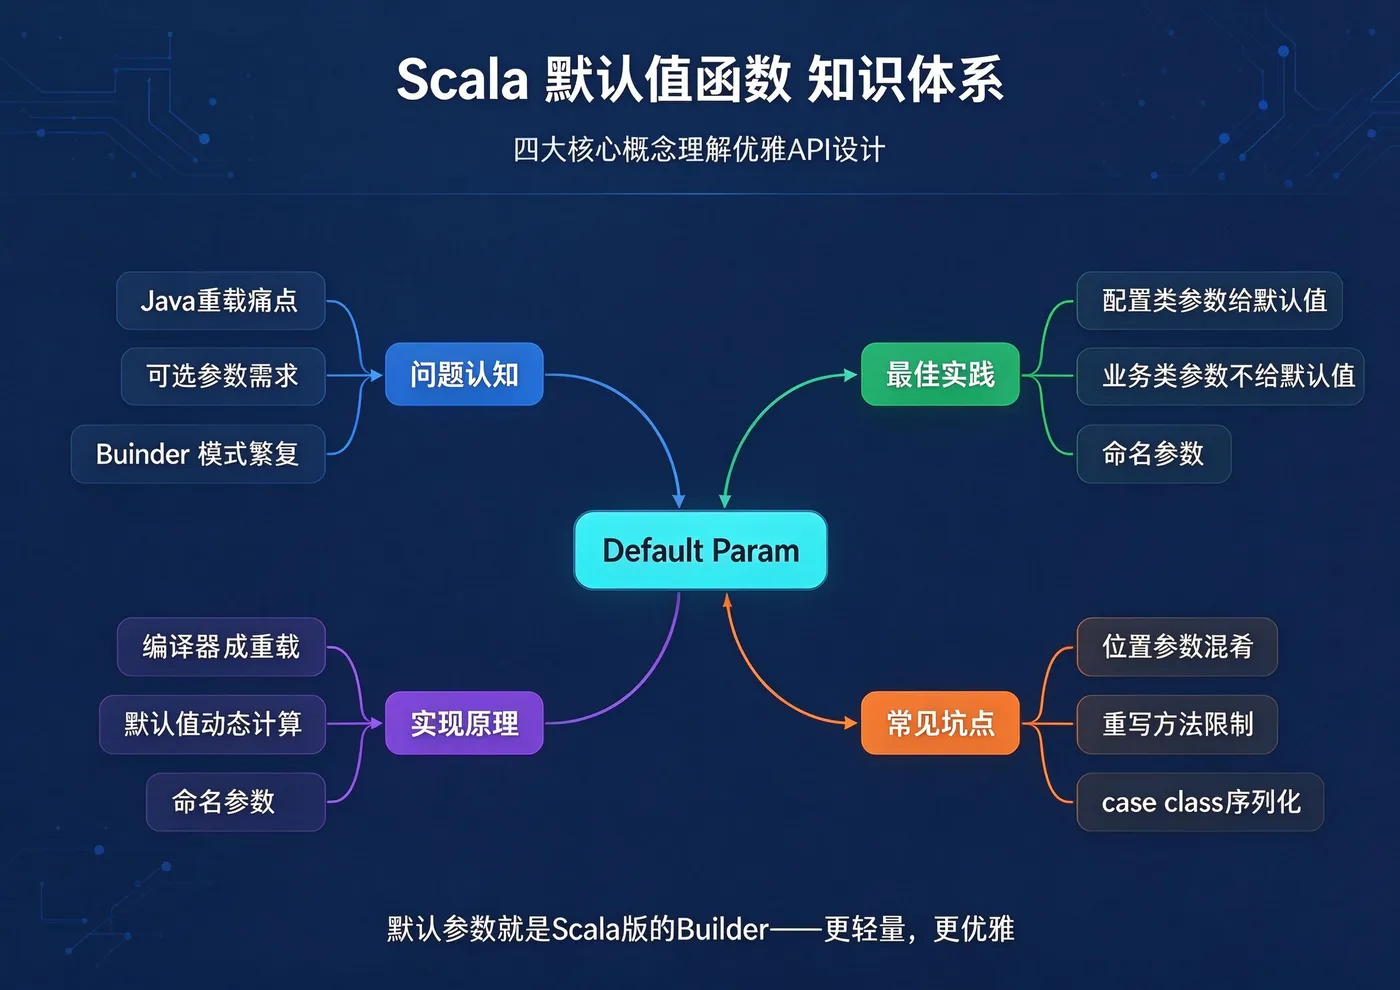
默认参数的本质:它就是方法重载的语法糖
很多人以为默认参数是个很高级的特性。其实不是——默认参数本质上就是方法重载的语法糖。
你写:
def query(sql: String, limit: Int = 100, offset: Int = 20): QueryResult = {
  // ...
}
编译器背后帮你生成了什么?——一组重载方法。
// 编译器帮你生成的重载
def query(sql: String): QueryResult = query(sql, 100, 20)
def query(sql: String, limit: Int): QueryResult = query(sql, limit, 20)
def query(sql: String, limit: Int, offset: Int): QueryResult = {
  // 真正的实现
}
看到了吗?和Java的写法一模一样——只不过是编译器帮你写了,不是你手动写。
默认参数不是新东西,它就是让编译器帮你写重载方法。
那它比Java的重载好在哪?好在调用方可以用命名参数。
命名参数:默认参数的灵魂
这是默认参数最强大的地方——你调用的时候,可以指定参数名,不用管顺序。
// 定义
def query(sql: String, limit: Int = 100, offset: Int = 20): QueryResult = {
  // ...
}

// 调用:只想改offset,不想改limit
query("SELECT *", offset = 100)

// 调用:顺序反着写也没事
query("SELECT *", offset = 0, limit = 50)

// 调用:用默认值
query("SELECT *")
Java里你想这么写?不可能——Java的参数是位置绑定的,你传第2个参数,它就是第2个。
Scala的命名参数让API变得非常灵活:
- 想用默认值就用默认值
- 想改哪个就改哪个
- 不用管参数顺序
这就是为什么Scala的API写起来这么优雅——默认参数 + 命名参数 = 非常灵活的函数签名。
默认参数能是什么?
默认参数不一定是个常量——它可以是任何表达式。
// 默认值可以是计算出来的
def log(message: String, timestamp: Long = System.currentTimeMillis()): Unit = {
  println(s"[$timestamp] $message")
}

// 每次调用,timestamp都是当前时间
log("Service started")  // [1728612345678] Service started
log("Service stopped")  // [1728612346789] Service stopped
这个特性很重要——它意味着默认值是每次调用时计算的,不是定义的时候算一次。
这和Java的方法重载不一样——Java的重载是你写死的默认值,不会每次重新计算。
默认值是动态的,每次调用都重新算。这个特性在写日志、写性能监控的时候特别有用。
几个常见的坑
坑1:默认参数和位置参数的混淆
def query(sql: String, limit: Int = 100, offset: Int = 20): QueryResult = {
  // ...
}

// 这样写是什么意思?
query("SELECT *", 50)
很多人会困惑:这第二个参数50,是传给limit还是传给offset?
答案是:按位置传的——它是limit。因为Scala的默认参数是位置优先,命名参数是可选的。
如果你想改offset但不想改limit,你必须用命名参数:
// 正确:用命名参数指定offset
query("SELECT *", offset = 100)

// 错误:这是改了limit,不是offset
query("SELECT *", 100)
这是最常见的坑——你以为你改的是第三个参数,其实改的是第二个。
坑2:重写方法时不能继承默认参数
class BaseService {
  def query(sql: String, limit: Int = 100): Unit = {
    println(s"limit = $limit")
  }
}

class UserService extends BaseService {
  // 重写的时候,不能再写默认值
  override def query(sql: String, limit: Int): Unit = {
    println(s"UserService limit = $limit")
  }
}
为什么?因为默认参数是方法签名的一部分——你重写的时候改了签名,就破坏了Liskov替换原则。
这个设计是对的——但你用的时候要注意:重写方法的时候,不要带默认参数。
坑3:Scala 3之前,构造函数的默认参数有坑
这个是历史遗留问题——在Scala 2里,case class的构造函数默认参数有时候会有问题(比如序列化的时候)。Scala 3修复了这个问题,但如果你用的是Scala 2.13,还是要注意一下。
什么时候用默认参数?
不是所有参数都该给默认值。判断标准很简单:
这个参数是不是"大多数情况下都一样,偶尔需要改"?
如果是——给个默认值,让调用方省心。
如果不是——每次调用都要传不同的值——那就别给默认值,必须显式传。
| 场景 | 用默认值吗? |
|---|---|
| 超时时间:大多数情况都是5000ms | 用 |
| 重试次数:大多数情况都是3次 | 用 |
| SQL语句:每次都不一样 | 不用 |
| 用户ID:每次都不一样 | 不用 |
| 排序字段:大多数情况都是按创建时间 | 用 |
| 分页大小:大多数情况都是20 | 用 |
简单说:"配置类"参数给默认值,"业务类"参数不给默认值。
和Java的Builder模式对比
Java里解决"可选参数"的另一个方案是Builder模式:
// Java Builder
HttpClient client = HttpClient.builder()
  .timeout(5000)
  .retry(3)
  .poolSize(10)
  .build();
Builder模式很优雅,但它有个问题:你得写一个Builder类。
Scala的默认参数不需要写Builder——它就是方法签名的一部分。
// Scala:直接用默认参数
def config(timeout: Int = 5000, retry: Int = 3, poolSize: Int = 10): HttpClient = {
  // ...
}

// 调用
config()                           // 全用默认值
config(timeout = 10000)            // 只改超时
config(retry = 5, poolSize = 20)   // 改两个
不用写Builder类,不用写重载方法——一行函数签名就搞定了。
默认参数就是Scala版的Builder——只不过更轻量,更优雅。
写在最后
我写这篇文章的时候,特意没罗列默认参数有多少种用法——因为用法很简单,谁都能写。
真正值得花时间理解的是:默认参数为什么重要?
不是因为"它让API更好用"——而是因为它解决了Java里一个长期存在的痛点:可选参数。
Java里你想要可选参数?写重载方法。想要几个?写一堆。代码臃肿,维护痛苦。
Scala的默认参数把这件事简化了——一行函数签名,编译器帮你生成所有的重载方法。调用方想用默认值就用默认值,想改哪个就改哪个,不用管顺序。
这就是函数式语言的设计哲学:把重复的事情交给编译器,让程序员专注在业务逻辑上。
你不用手写重载方法——编译器帮你写。你不用记参数顺序——命名参数帮你记。你不用写Builder类——默认参数就是Builder。
默认参数不是什么高级特性,它就是一个让你少写代码的语法糖。但就是这个语法糖,让你的API从"能用"变成了"好用"。